Poprawny plik xlsx nie musi zawierać xl/worksheets/sheet1.xml. HotXLS, natywny komponent arkusza Excel dla Delphi i C++Buildera, lokalizuje każdą część przez graf relacji OPC zamiast zgadywać nazwy, ponieważ ISO/IEC 29500-2 gwarantuje jedynie, że części są osiągalne z _rels/.rels, nigdy zaś, że znajdują się w konwencjonalnych ścieżkach
Dlaczego mój parser zawodzi na poprawnym pliku xlsx?
Ponieważ nazwy części, które zapamiętałeś, to konwencja jednego producenta, nie wymóg formatu. Każda ścieżka, którą kiedykolwiek zaszyłeś na sztywno — xl/workbook.xml, xl/sharedStrings.xml, xl/styles.xml, xl/worksheets/sheetN.xml — to po prostu to, co akurat emituje desktopowy zapisywacz Excela. Zgodny pakiet może umieścić skoroszyt pod office/book.xml, a pierwszy arkusz pod xl/custom/data-sheet.xml i wciąż być legalnym SpreadsheetML, o ile relacje tam wskazują. To najczęstszy pojedynczy powód, dla którego domowej roboty czytnik zgłasza „nie znaleziono sheet1.xml" na pliku, który Excel, LibreOffice i Numbers otwierają bez żadnych zastrzeżeń
Producenci robiący tak nie są egzotyczni. Generatory raportów po stronie serwera ponownie wykorzystują pakiet szablonu i zachowują jego oryginalny układ. Potoki eksportu łączące dwa skoroszyty przenumerowują arkusze i zostawiają luki, więc pięcioarkuszowy skoroszyt ma sheet1, sheet2, sheet4, sheet7 i sheet9. Narzędzia usuwające arkusz nie zawsze przenumerowują tych, którzy przetrwali. W każdym z tych przypadków zgadywanie oparte na indeksie, xl/worksheets/sheet + IntToStr(i + 1) + .xml, po cichu odczytuje niewłaściwy arkusz albo nie odczytuje niczego, co jest gorsze niż wyjątek, bo skoroszyt się wczytuje, a liczby są błędne. Poniższy minimalny pakiet ćwiczy cały ten problem i jest kształtem, względem którego HotXLS prowadzi testy regresyjne
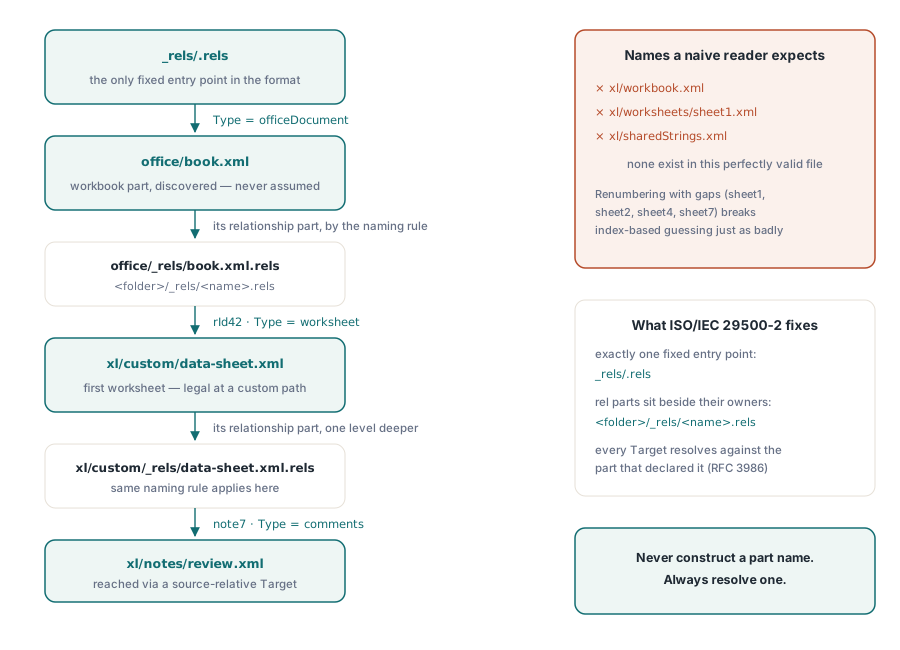
<!-- _rels/.rels -->
<Relationships xmlns="http://schemas.openxmlformats.org/package/2006/relationships">
  <Relationship Id="rId1"
      Type="http://schemas.openxmlformats.org/officeDocument/2006/relationships/officeDocument"
      Target="office/book.xml"/>
</Relationships>

<!-- office/_rels/book.xml.rels -->
<Relationships xmlns="http://schemas.openxmlformats.org/package/2006/relationships">
  <Relationship Id="rId42"
      Type="http://schemas.openxmlformats.org/officeDocument/2006/relationships/worksheet"
      Target="../xl/custom/data-sheet.xml"/>
</Relationships>

<!-- xl/custom/_rels/data-sheet.xml.rels -->
<Relationships xmlns="http://schemas.openxmlformats.org/package/2006/relationships">
  <Relationship Id="note7"
      Type="http://schemas.openxmlformats.org/officeDocument/2006/relationships/comments"
      Target="../notes/review.xml"/>
</Relationships>
Co faktycznie gwarantuje ISO/IEC 29500-2?
Gwarantuje osiągalność, nie lokalizację. ISO/IEC 29500-2 to część standardu poświęcona Open Packaging Conventions, a jej klauzula o relacjach definiuje dokładnie jeden ustalony punkt wejścia: część relacji pakietu pod _rels/.rels. Stamtąd podążasz za relacją, której Type to http://schemas.openxmlformats.org/officeDocument/2006/relationships/officeDocument, by dotrzeć do części skoroszytu, a każda kolejna część jest odkrywana przez odczytanie własnej części relacji tamtej części i podążanie za typowanymi krawędziami na zewnątrz
Dwie dalsze reguły z tego samego standardu wykonują rzeczywistą pracę. Klauzula nazewnictwa części ustala, gdzie żyje część relacji: dla części pod <folder>/<name> jej relacje znajdują się pod <folder>/_rels/<name>.rels, a dla części w korzeniu pakietu folder to po prostu _rels/. Klauzula znaczników relacji stwierdza, że Target jest odwołaniem URI rozwiązywanym względem URI części źródłowej, w zwykłym sensie RFC 3986, chyba że TargetMode="External" oznacza je jako wskazujące poza pakiet. Rozwiązywanie względem źródła to krok, który każdy pomija, i dlatego ten sam literalny ../notes/review.xml oznacza jedną rzecz wewnątrz xl/custom/_rels/data-sheet.xml.rels, a coś zupełnie innego wewnątrz pliku rels o jeden folder głębiej. Ostatnia zmarszczka leży między modelem logicznym a bajtami na dysku: nazwy części w modelu logicznym są bezwzględne i zaczynają się od ukośnika, ale klauzula fizycznego mapowania ZIP usuwa ten ukośnik, gdy zamienia nazwę części na nazwę elementu ZIP, więc resolwer, który o tym zapomni, wyszukuje w archiwum /xl/sharedStrings.xml i nic nie znajduje
Wewnątrz XlsxResolveRelationshipTarget
HotXLS koncentruje całą regułę rozwiązywania w jednej funkcji, XlsxResolveRelationshipTarget, zadeklarowanej w lxHandleX.pas jako function XlsxResolveRelationshipTarget(const OwnerPartName, Target: WideString): WideString. Przyjmuje nazwę elementu ZIP części źródłowej i surowy atrybut Target, a zwraca nazwę elementu ZIP bez wiodącego ukośnika, gotową do bezpośredniego przekazania do archiwum. Przekazanie pustego OwnerPartName rozwiązuje się względem korzenia pakietu, czego dokładnie potrzebuje część relacji pakietu. Kolejność operacji ma większe znaczenie niż poszczególne kroki: ukośniki wsteczne są najpierw normalizowane do ukośników zwykłych, ponieważ niektórzy producenci wpisują w Target separatory windowsowe; każdy fragment wprowadzony przez # jest odcinany przed obsługą ścieżki, więc ../charts/chart1.xml#Sheet1 rozwiązuje się do nazwy części, a nie do nieistniejącego wpisu archiwum; dopiero potem funkcja rozdziela odwołania bezwzględne od względnych
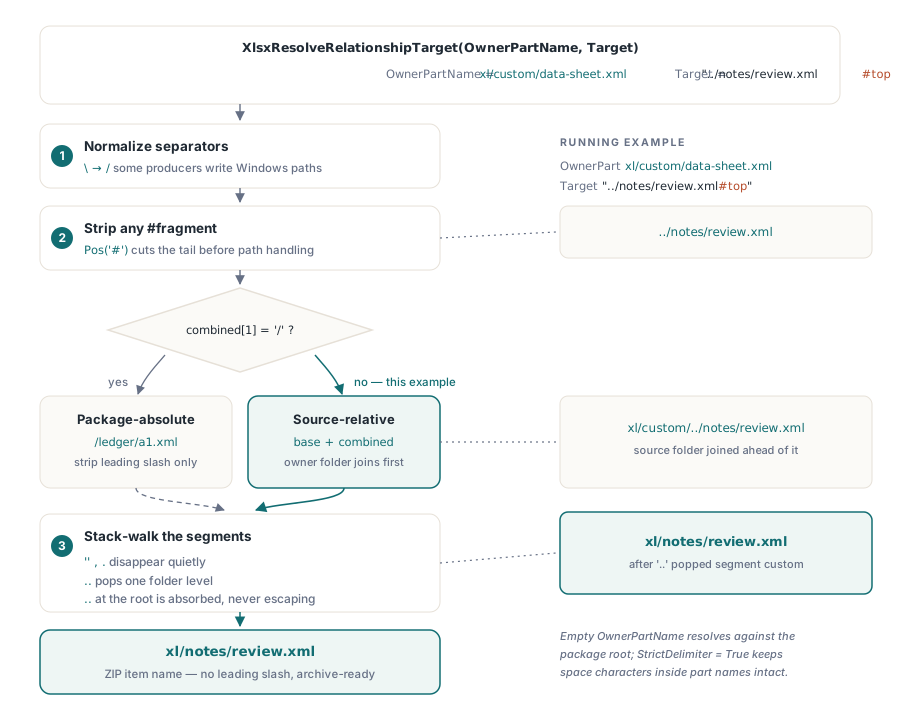
// Rdzeń normalizacji zaimplementowany w lxHandleX.pas
combined := StringReplace(Target, '\', '/', [rfReplaceAll]);
p := Pos('#', combined);
if p > 0 then
  combined := Copy(combined, 1, p - 1);
if (combined <> '') and (combined[1] = '/') then
  Delete(combined, 1, 1)              // package-absolute: usuń tylko ukośnik
else
begin
  p := LastDelimiter('/', String(OwnerPartName));
  if p > 0 then
    baseName := Copy(OwnerPartName, 1, p)
  else
    baseName := '';
  combined := baseName + combined;    // względem folderu części źródłowej
end;

source.StrictDelimiter := True;       // '/' tylko, bez obsługi cudzysłowu ani spacji
source.Delimiter := '/';
source.DelimitedText := String(combined);
for i := 0 to source.Count - 1 do
begin
  segment := WideString(source[i]);
  if (segment = '') or (segment = '.') then
    Continue;                         // puste segmenty i segmenty kropki znikają
  if segment = '..' then
  begin
    if parts.Count > 0 then
      parts.Delete(parts.Count - 1);  // pop i nigdy poniżej katalogu głównego
  end
  else
    parts.Add(String(segment));
end;
Pętla po segmentach to zwykłe przechodzenie po stosie: puste segmenty i . są odrzucane, .. zdejmuje jeden poziom, a .., który wychodziłby poza korzeń pakietu, jest po prostu pochłaniany zamiast produkować ujemny indeks lub nazwę zaczynającą się od ../. Przypisanie StrictDelimiter := True nie jest kosmetyczne. Bez niego delfiński TStringList traktuje spacje jako separatory i honoruje znaki cudzysłowu, co psuje każdą nazwę części zawierającą spację, a nazwy części ze spacjami są legalne
Podążanie za grafem: skoroszyt, arkusz, rysunek
HotXLS przechodzi przez trzy warstwy części relacji na ścieżce TXLSXWorkbook.Open. Warstwa pakietu jest obsługiwana przez XlsxFindOfficeDocumentPart, która odczytuje _rels/.rels i zwraca cel officeDocument. Warstwa skoroszytu odczytuje część relacji skoroszytu i buduje jednocześnie dwie mapy: mapę identyfikatorów do wyszukiwań r:id oraz mapę typów dla części typu singleton. Warstwy arkusza i rysunku powtarzają ten wzorzec z ParseWorksheetRelsXml i ParseDrawingRelsXml, każda przekazując własną nazwę części jako podstawę rozwiązywania, tak by rysunek odwołujący się do ../media/image3.png trafiał na właściwy blob
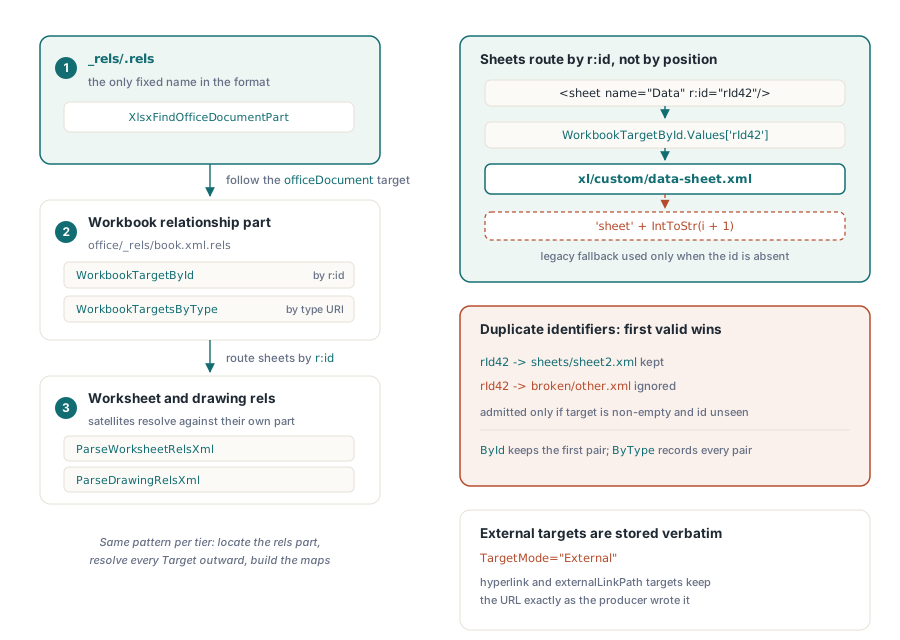
// Tier 1: jedyna stała nazwa w całym formacie
WorkbookPartName := XlsxFindOfficeDocumentPart(zip);
if WorkbookPartName = '' then
  WorkbookPartName := 'xl/workbook.xml';        // legacy fallback
if not zip.Exists(WorkbookPartName) then
  Exit;

// Tier 2: <folder>/_rels/<name>.rels dla samej części skoroszytu
relsName := XlsxRelationshipPartName(WorkbookPartName);
if zip.Exists(relsName) then
begin
  relsStream := zip.OpenFile(relsName);
  try
    ParsePartRelationshipsXml(relsStream, WorkbookPartName,
      WorkbookTargetById, WorkbookTargetsByType);
  finally
    relsStream.Free;
  end;
end;

// Typowane singletony są rozwiązywane przez URI typu relacji
PartName := WorkbookTargetsByType.Values[XlsxRtSharedStrings];
if PartName = '' then
  PartName := 'xl/sharedStrings.xml';
Arkusze w szczególności muszą przechodzić przez mapę identyfikatorów, nie przez mapę typów. Elementy <sheet> w części skoroszytu niosą atrybuty r:id, a ten identyfikator to jedyna rzecz wiążąca nazwę arkusza z częścią. HotXLS zbiera te identyfikatory podczas ParseWorkbookXml i rozwiązuje każdy z nich względem mapy relacji skoroszytu, wracając do konwencjonalnej nazwy numerowanej tylko wtedy, gdy identyfikator jest nieobecny lub nierozwiązywalny
// Tier 2b: r:id -> worksheet part, per sheet, in workbook order.
PartName := '';
if (i < SheetRelIds.Count) and (SheetRelIds[i] <> '') then
  PartName := WorkbookTargetById.Values[SheetRelIds[i]];
if PartName = '' then
  PartName := 'xl/worksheets/sheet' + IntToStr(i + 1) + '.xml';
SheetPartNames.Add(String(PartName));

// Tier 3: każdy arkusz rozwiązuje własne elementy pomocnicze względem własnej nazwy
relsName := XlsxRelationshipPartName(PartName);
if zip.Exists(relsName) then
begin
  relsStream := zip.OpenFile(relsName);
  try
    ParseWorksheetRelsXml(relsStream, PartName,
      FParRels[i], ParTableTargets[i], ParPartTargets[i]);
  finally
    relsStream.Free;
  end;
end;
Wszystko dalej opiera się na tym samym mechanizmie. Współdzielone ciągi znaków, style, motyw, projekt VBA pod typem w przestrzeni nazw Microsoftu http://schemas.microsoft.com/office/2006/relationships/vbaProject, łącza zewnętrzne, część osoby w zakresie skoroszytu, komentarze klasyczne, komentarze wątkowane, rysunek VML niosący geometrię dymków komentarzy, rysunki, obrazy, wykresy, tabele i tabele przestawne — wszystkie docierają do swoich bajtów przez rozwiązane cele. Część motywu w szczególności musi zostać zlokalizowana poprawnie, inaczej round-trip po cichu nadpisuje niestandardową paletę marki klienta domyślnym motywem Office, jeden z trybów awarii omówionych w notatkach o bezstratnym round-tripie XLSX motywu, extLst i calcChain. Odczyt relacji jest też powodem, dla którego wczytywanie jest zorganizowane etapami: cały dostęp do archiwum odbywa się na jednym wątku, zanim sparsowany zostanie XML arkusza, ponieważ stan dekompresji archiwum ZIP nie jest bezpieczny wątkowo, co jest ograniczeniem wyjaśnionym w opracowaniu o równoległym parsowaniu XLSX i alokatorze pamięci
Dlaczego zduplikowany rId psuje trasowanie oparte na typie?
Ponieważ późniejszy zniekształcony wpis może nadpisać wcześniejszy, poprawny, i przejąć wyszukiwanie. Identyfikatory relacji mają być unikalne w obrębie części relacji, ale zniekształcone pakiety je powielają, a naiwne przypisanie Values[Id] := działa na zasadzie ostatni-wygrywa. Jeśli rId3 najpierw wskazuje na prawdziwy arkusz, a drugie rId3 wskazuje na nieobsługiwany lub pusty cel, ostatni-wygrywa gubi arkusz. ParsePartRelationshipsXml stosuje więc regułę pierwszy-wygrywa z dwoma warunkami: rozwiązany cel musi być niepusty, a identyfikator nie może już być obecny. Oba warunki razem czynią to bezpiecznym, ponieważ test niepustości powstrzymuje relację z brakującym Target przed zajęciem slotu, zanim nadejdzie użyteczna
if (TargetById <> nil) and (Id <> '') and (resolvedTarget <> '') and
  (TargetById.IndexOfName(String(Id)) < 0) then
  TargetById.Values[String(Id)] := String(resolvedTarget);
if (TargetsByType <> nil) and (relType <> '') and (resolvedTarget <> '') then
  TargetsByType.Add(String(relType + '=' + resolvedTarget));
Zwróć uwagę na celową asymetrię w tym fragmencie. Mapa identyfikatorów to prawdziwa mapa z zabezpieczeniem pierwszy-wygrywa, podczas gdy kolekcja typów to lista wyłącznie dopisywana par type=target. To rozróżnienie ma znaczenie strukturalne: skoroszyt ma dokładnie jedną relację współdzielonych ciągów znaków, ale wiele relacji arkuszy i łączy zewnętrznych, więc wyszukiwanie typu przez Values[] zwraca pierwsze dopasowanie dla singletonów, a typy wielowartościowe, jak externalLink, są wyliczane przez przejście po liście
Gdzie zatrzymuje się podążanie za relacjami
Uczciwe granice liczą się bardziej niż gładka opowieść. HotXLS wraca do konwencjonalnych nazw, ilekroć relacja jest nieobecna, więc pakiet z uszkodzoną lub brakującą częścią relacji nadal się otwiera, jeśli akurat trzyma się układu Excela; ten fallback to funkcja zgodności, nie drugie źródło prawdy, i może maskować błąd producenta podczas testowania. Warto znać jeszcze trzy ograniczenia. Cele oznaczone TargetMode="External" są przechowywane dosłownie, a nie rozwiązywane, co jest poprawne dla hiperłączy i dla relacji externalLinkPath niosącej zdalny adres URL skoroszytu, ale oznacza, że otrzymana wartość jest dokładnie tym, co zapisał producent. Części wykresu odkryte przez część relacji rysunku są parowane z zakotwiczeniami rysunku pozycyjnie, a nie przez identyfikator, więc nietypowa kolejność zakotwiczeń może rozstroić powiązania wykresów. A strumieniowy czytnik bezpośredni w lxDirectRead.pas utrzymuje własną, lżejszą ścieżkę obsługi ścieżek, kluczowaną do xl/, więc pełny resolwer opisany tutaj rządzi punktami wejścia TXLSXWorkbook.Open i GetSheetNames, nie zaś ścieżką skanowania o niskiej alokacji udokumentowaną w artykule o strumieniowym czytniku bezpośrednim dla Delphi
Jeśli budujesz to samodzielnie, najkrótsze poprawne podsumowanie brzmi: nigdy nie konstruuj nazwy części, zawsze ją rozwiązuj. Odczytaj _rels/.rels, podążaj za officeDocument, rozwiąż każdy Target względem części, która go zadeklarowała, i kieruj arkusze przez r:id. Jeśli wolisz mieć to już przetestowane wobec przemianowanych części, nieciągłej numeracji arkuszy i zduplikowanych identyfikatorów relacji, opisany tu resolwer jest dostarczany w komponencie arkusza Excel HotXLS dla Delphi, wraz z mechanizmem round-tripu, który zachowuje nienaruszone części, których nie parsuje