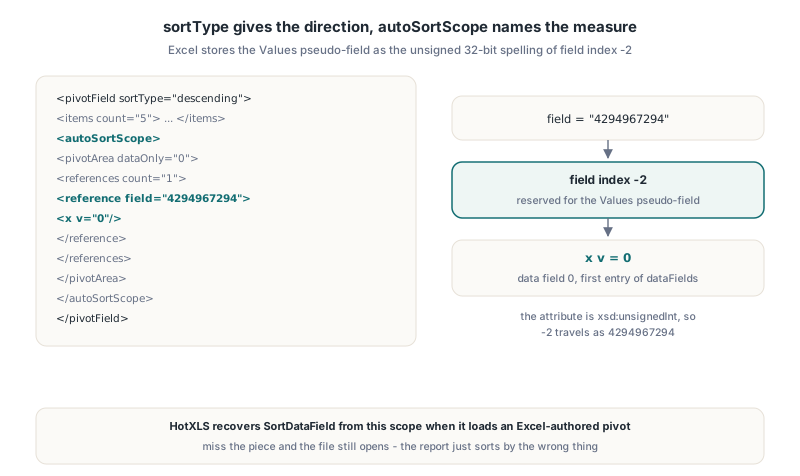
HotXLS sortuje elementy PivotTable po wartości w Delphi przez dwie własności na TXLSPivotField: SortType wybiera rosnąco albo malejąco, a SortDataField nazywa pole danych liczone od zera, którego sumy napędzają kolejność. Gdy HotXLS otwiera XLSX autorstwa Excela, odzyskuje to pole danych z elementu autoSortScope, gdzie Excel przechowuje pole Values jako field="4294967294", zapis bez znaku liczby -2
Sortowanie po wartości to żądanie, które dostaje w końcu każdy raport sprzedażowy: "pokaż regiony od największego do najmniejszego". W UI Excela to dwa kliknięcia. W formacie pliku to atrybut, zagnieżdżony obszar pivota, zarezerwowany indeks pola i numer porządkowy zaznaczonego pola danych, a czytnik, który przegapi którąkolwiek z tych części, otwiera plik bez skargi. Po prostu sortuje po złej rzeczy
Gdzie Excel przechowuje miarę sortowania po wartości?
Excel przechowuje miarę sortowania wyłącznie wewnątrz autoSortScope, nie na samym polu. Atrybut sortType na <pivotField> (wartość ST_FieldSortType z ECMA-376 Part 1: manual, ascending albo descending) mówi, w którym kierunku sortować. Po jakiej mierze sortować mieszka w dziecku <autoSortScope>, które owija <pivotArea>, którego referencja osi danych zaznacza jedno pole danych
<pivotField axis="axisRow" showAll="0" sortType="descending">
  <items count="5"> ... </items>
  <autoSortScope>
    <pivotArea dataOnly="0" outlineLevel="all" fieldPosition="0">
      <references count="1">
        <reference field="4294967294" count="1" selected="0">
          <x v="0"/>
        </reference>
      </references>
    </pivotArea>
  </autoSortScope>
</pivotField>
Element reference normalnie wskazuje pole pivota po indeksie. Indeks pola -2 jest zarezerwowany w części PivotTable ECMA-376 dla pseudopola Values, tego, które Excel pokazuje jako "Values", gdy dwie albo więcej miar siedzi na osi. Atrybut jest typowany jako 32-bitowa liczba całkowita bez znaku, więc -2 idzie po drucie jako 4294967294. <x v="0"/> pod nim zaznacza pole danych 0, pierwszy wpis w <dataFields>. Jest też atrybut rankBy na <pivotField>, ale w porównywanych przez nas plikach Excel go pominął i polegał na samym zakresie
Dlaczego miara sortu wróciła jako -1?
Czytnik HotXLS pierwotnie gubił miarę sortu, bo 4294967294 nie mieści się w 32-bitowej liczbie całkowitej ze znakiem. Pomocnik atrybutów to cienka owijka nad StrToIntDef, a wartość poza zakresem cicho zwraca domyślną, więc test osi danych nigdy nie pasował, SortDataField zostawało na -1, a pole trzymało tylko sortType="descending" bez żadnej miary
Porażka była cicha w najgorszy sposób. Pole malejące bez miary wciąż sortuje, po prostu po etykiecie elementu od tyłu, więc raport, który Excel uporządkował po sumie, wracał z HotXLS jako odwrócona kolejność elementów. Nic nie podnosiło wyjątku, a liczby w każdej komórce były poprawne. Tylko kolejność wierszy była zła, i to tylko dla plików autorstwa Excela
Poprawka w lxPivotXml.pas porównuje surowy token atrybutu jako napis przed jakąkolwiek konwersją na liczbę całkowitą. Jeśli rankBy już ustawiło miarę, ono wygrywa; inaczej referencja, której token field to dokładnie '4294967294', rozwiązuje SortDataField z jego zaznaczonej wartości x. Strona oceny nie potrzebowała zmian: komparator już kończył sumy per element na osiach wierszy i kolumn, obsługiwał kolejność malejącą i rozstrzygał remisy. Dane po prostu nigdy do niego nie dochodziły
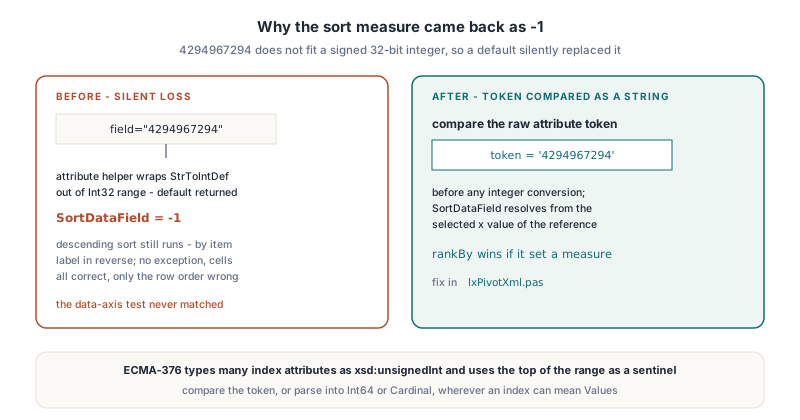
Ogólna nauka dotyczy każdego czytnika OOXML pisanego w Delphi. ECMA-376 typuje kilka atrybutów indeksów jako xsd:unsignedInt, a potem używa szczytu zakresu jako wartownika, więc czytnik ze znakiem z domyślnym fallbackiem zamienia wartość zarezerwowaną w "brak atrybutu". Porównuj token, albo parsuj do Int64 albo Cardinal, gdziekolwiek indeks pola może znaczyć Values
Sortowanie elementów pivota po mierze z kodu Delphi
Żeby posortować pole pivota HotXLS po wartości, ustaw SortType na xlpfstAscending albo xlpfstDescending i ustaw SortDataField na indeks liczony od zera miary na liście DataFields tabeli. Przy SortType = xlpfstManual, który jest domyślny, SortDataField jest ignorowane, a elementy trzymają swoją kolejność z cache albo programistyczną
uses
  SysUtils, lxHandleX, lxPivot;

var
  Book: TXLSXWorkbook;
  Data, Report: TXLSXWorksheet;
  Pivot: TXLSPivotTable;
  Region: TXLSPivotField;
begin
  Book := TXLSXWorkbook.Create;
  try
    Data := Book.Sheets.Add('Data');
    Data.Cells[1, 1].Value := 'Region';
    Data.Cells[1, 2].Value := 'Product';
    Data.Cells[1, 3].Value := 'Units';
    // ... wypełnij wiersze 2..41 ...
    Report := Book.Sheets.Add('Report');

    Pivot := Report.AddPivotTable('Data!A1:C41', 3, 1, 'UnitsByRegion');
    Region := Pivot.AddRowField('Region');
    Pivot.AddDataFieldByName('Units', xlpaSum);   // pole danych 0

    Region.SortType := xlpfstDescending;  // największy region najpierw
    Region.SortDataField := 0;            // sortuj po Sumie Units
    Region.AutoSortScope := '0';          // także emituj własne autoSortScope Excela

    if Book.MaterializeNativePivotTable(Pivot) <> 1 then
      raise Exception.Create('Pivot layout was rejected');
    Book.SaveAs('units-by-region.xlsx');
  finally
    Book.Free;
  end;
end;
Dwa detale zasługują na notatkę. Writer HotXLS emituje SortDataField jako rankBy, a gdy AutoSortScope nie jest puste, pisze też blok autoSortScope z referencją osi danych 4294967294, wkładając napis własności w slot x v. Przy wczytaniu AutoSortScope dostaje ten sam token x v, więc dla sortów po wartości własność trzyma numer porządkowy pola danych jako tekst. Ustawienie go na '0' produkuje więc plik niosący miarę w obu miejscach, czyli najbliższe dopasowanie do tego, co sam pisze Excel. MaterializeNativePivotTable przygotowuje potem posortowaną siatkę i jej metadane układu razem i zwraca 1 przy sukcesie albo -1 z diagnostyką
Wiersze elementów to nie jedyna rzecz, która jest sortowana. Pola kolumnowe przechodzą przez ten sam komparator, używając sum per kolumna zamiast per wiersz, więc pole kolumnowe z SortType = xlpfstDescending i ważnym SortDataField porządkuje swoje kolumny po wartości dokładnie tak samo
Obejrzenie sortu, który skoroszyt Excela już niesie
Dla plików autorstwa Excela HotXLS wypełnia SortType, SortDataField i AutoSortScope podczas wczytywania definicji pivota, więc możesz audytować albo zmienić sort raportu bez przebudowywania tabeli. Fragment niżej wypisuje każde pole sortujące po mierze i nazywa miarę jej DisplayName
var
  Book: TXLSXWorkbook;
  Pivot: TXLSPivotTable;
  Field: TXLSPivotField;
  I: Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Open('sales-report.xlsx');
    Pivot := Book.Sheets.SheetByName('Report').PivotTables[0];
    for I := 0 to Pivot.FieldCount - 1 do
    begin
      Field := Pivot.Fields[I];
      if (Field.SortType <> xlpfstManual) and (Field.SortDataField >= 0) then
        Writeln(Field.Name, ' sorted by ',
          Pivot.DataFields[Field.SortDataField].DisplayName);
    end;

    // przewróć sort Region na rosnące i odbuduj istniejącą siatkę
    Field := Pivot.FindFieldByName('Region');
    if Field <> nil then
      Field.SortType := xlpfstAscending;
    if Book.MaterializeNativePivotTable(Pivot, True) <> 1 then
      raise Exception.Create('Could not re-materialize the pivot');
    Book.SaveAs('sales-report-asc.xlsx');
  finally
    Book.Free;
  end;
end;
Drugi argument MaterializeNativePivotTable każe HotXLS przyjąć istniejący zakres wyjściowy pivota zamiast traktować go jako kolizję. Ten sam wzorzec pojawia się w przewodniku po Show Values As rangi i sumach narastających w HotXLS, gdzie kolejność sortu ma znaczenie, bo sumy narastające akumulują się w kolejności wyświetlania
Jak HotXLS rozstrzyga remisy, gdy dwa elementy mają tę samą wartość?
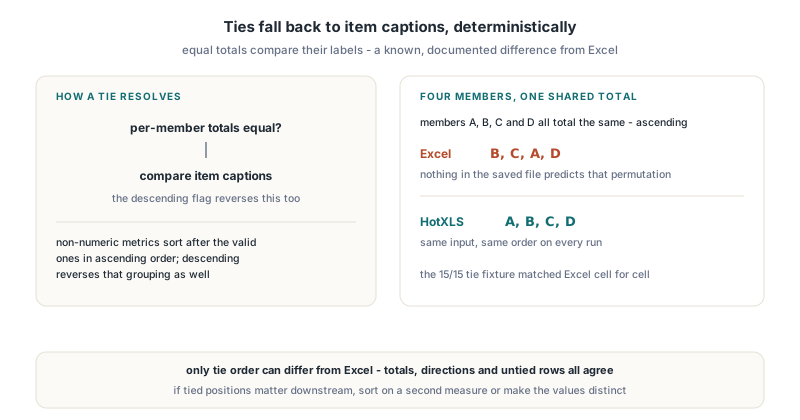
HotXLS rozstrzyga remisy po etykiecie elementu, deterministycznie, co jest znaną różnicą względem Excela. Gdy dwa elementy mają identyczne sumy, komparator cofa się do porównywania ich podpisów, a flaga malejąca odwraca też to porównanie. Elementy, których metryka nie jest ważną liczbą, sortują po ważnych w kolejności rosnącej, a flaga malejąca odwraca całe porównanie, łącznie z tym grupowaniem
Excel nie obiecuje żadnej kolejności remisów. W fixturze testowej, gdzie cztery elementy, A, B, C i D, miały wszystkie tę samą sumę, sort rosnący w Excelu wyprodukował B, C, A, D. Nic w zapisanych metadanych nie przewiduje tej permutacji; to produkt uboczny sorta niestabilnego i może się różnić między plikami. HotXLS zwraca A, B, C, D dla tego samego wejścia. Nasza weryfikacja dla tego przypadku sprawdza zbiór elementów i wartości per element, a nie sekwencję, a fixture malejący z remisem 15/15 zgadzał się z Excelem komórka w komórkę. Jeśli twój kod poniżej zależy od dokładnej pozycji wierszy remisujących, sortuj po drugiej mierze albo uczynń wartości odrębnymi
Elementy zwinięte i pole najbardziej wewnętrzne
Elementy zwinięte materializują się w HotXLS jako jeden wiersz zagregowany na zwinięty element. Gdy Excel chowa detale elementu, pisze sd="0" na tym <item>; HotXLS wystawia to jako TXLSPivotItem.IsDetailHidden. Zwinięty element renderuje się ze zwykłą etykietą, wymienia całe swoje poddrzewo, a zwinięcie dotyczy tego elementu pod każdym rodzicem, podczas gdy otaczające bloki trzymają własne sumy częściowe
var
  Category: TXLSPivotField;
begin
  // Pivot ma Category (zewnętrzne) i Product (wewnętrzne) na wierszach
  Category := Pivot.FindFieldByName('Category');
  if (Category <> nil) and (Category.ItemCount > 0) then
    Category.Items[0].IsDetailHidden := True;   // zwiń pierwszą kategorię
  if Book.MaterializeNativePivotTable(Pivot, True) <> 1 then
    raise Exception.Create('Collapse was rejected');
end;
Zwijanie współpracuje z sortowaniem przewidywalnie: zwinięty wiersz wciąż jest elementem swojego pola, więc bierze pozycję ze swojej sumy jak każdy inny element. Pole najbardziej wewnętrzne jest inne. Nie ma poziomu wewnętrznego, więc nie ma czego zwijać, a od wcześniejszej poprawki HotXLS nigdy nie renderuje też wiersza sumy częściowej dla niego, nawet gdy jego flaga defaultSubtotal jest ustawiona. Excel zachowuje się tak samo na osiach jedno- i wielopoziomowych, a przed tą zmianą HotXLS mógł emitować zjawy wiersz Total pod polem najbardziej wewnętrznym. Dla atrybutów poziomu pola, które tu grają, przewodnik HotXLS po ważności schematu CT_PivotField opisze, czego schema wymaga na <pivotField> i jego elementach
Pułapki przy sprawdzaniu względem automatyzacji Excel
Gdy krzyżowo sprawdzasz sort HotXLS względem Excela przez automatyzację COM, wołaj AutoSort z zlokalizowanym podpisem miary, zapisanym dokładnie tak, jak pokazuje go Excel. Na chińskojęzycznym Excelu domyślny podpis sumowanego pola Units to '求和项:Units'; podanie 'Sum of Units' na tej maszynie nie podnosi błędu i nic nie zmienia. Ten sam skrypt, który działa na angielskim Excelu, po cichu staje się no-opem gdzie indziej, więc czytaj podpis z pola danych zamiast pisać go na sztywno
PivotField.SortTypenie dało się odczytać z powrotem przez COM w testowanej przez nas budowie Excela, więc weryfikuj sort z zapisanego XML albo wyrenderowanych komórek- W tej budowie włożenie rodzicielskiego pola grupy ręcznej na tę samą oś poza sortowanym polem wyciszało sortowanie elementów po wartości; renderowanie sortowane pod rodzicami grup ręcznych nie jest weryfikowane
- Zapisy do
PivotField.OutlineiPivotField.LayoutFormbyły odrzucane w tej budowie też, więc ustaw układ konspektowy dla fixtury przezPivotTable.RowAxisLayout
Żaden z tych kaprysów nie zmienia formatu pliku, ale rozstrzygają, czy test regresji cokolwiek dowodzi. Test wołający AutoSort ze złym podpisem przechodzi na pivocie, który nigdy nie był sortowany
FAQ
Co znaczy pole 4294967294 w pliku XML PivotTable?
Pole 4294967294 to 32-bitowe kodowanie bez znaku indeksu pola -2, które ECMA-376 rezerwuje dla pseudopola Values. Wewnątrz autoSortScope oznacza referencję osi danych, a jego dziecko x zaznacza, po którym polu danych elementy są sortowane
Czy HotXLS sortuje elementy pivota po wartości bez zainstalowanego Excela?
Tak. HotXLS ocenia sort sam, gdy materializuje siatkę pivota, używając sum per element wybranego pola danych, i pisze sortType, rankBy i opcjonalnie autoSortScope, żeby Excel trzymał tę samą kolejność po odświeżeniu. Tylko kolejność remisów wśród równych wartości może się różnić od Excela
Dlaczego moje elementy pivota są sortowane alfabetycznie zamiast po wartości?
Zwykle dlatego, że pole ma kierunek sortu, ale nie ma miary. Sprawdź, że SortType nie jest xlpfstManual i że SortDataField mieści się między 0 a DataFieldCount - 1; przy -1 HotXLS porządkuje elementy po etykiecie w żądanym kierunku
Sortowanie po wartości, elementy zwinięte i reszta natywnego potoku pivotów są w HotXLS, komponencie arkuszy Delphi dla XLS i XLSX, który czyta, edytuje i pisze skoroszyty Excel bez zainstalowanego Excela. Jeśli dopiero budujesz pivot od zera, samouczek HotXLS o budowaniu i odświeżaniu tabel przestawnych pokrywa cache, pola i odświeżanie, zanim dojdziesz do ich porządkowania