Przejdź po komórkach świeżo otwartego szablonu raportu, a scalony tytuł zachowa się jak przeciek. Czytasz A1 i dostajesz "Quarterly Statement"; czytasz B1 do F1, które widocznie siedzą pod tym samym transparentem, i nie dostajesz nic. Wpisz wartość do C1, żeby załatać nagłówek, a ona nigdy się nie pojawi. Siatka nie zgubiła twoich danych. Robi dokładnie to, co znaczy scalenie: zarówno w XLS, jak i w XLSX scalony prostokąt renderuje treść jednej komórki, tej kotwiczącej w lewym górnym rogu, a resztę traktuje jak przykrytą przestrzeń, która trzyma wartości, ale nigdy ich nie pokazuje. Użytkownicy Excela przyswajają to metodą prób i błędów. Generator raportów musi zakodować to jako regułę, bo w generowanym kodzie objawem jest pusty obszar bez żadnego wyjątku, do którego dałoby się go prześledzić. HotXLS, natywna biblioteka Object Pascal czytająca i zapisująca oba formaty Excela z Delphi i C++Buildera, wystawia tablicę scaleń na tyle jawnie, że możesz programować wobec tej reguły, zamiast odkrywać ją ponownie w zgłoszeniu do wsparcia
Jedna wartość, jedna kotwica
Scalenie to instrukcja wyświetlania nałożona na siatkę, która nie zmienia kształtu. Każda przykryta komórka nadal istnieje w pliku jako własne miejsce; rekord scalenia mówi tylko konsumentowi, by rozmalował treść kotwicy na cały prostokąt. To rozróżnienie napędza trzy zachowania warte przyswojenia, zanim napiszesz jakikolwiek kod układu. Odczyt przykrytej komórki zwraca jej własną przechowywaną wartość, która dla transparentu zbudowanego przez ciebie jest zwykle pusta, więc każdy kod oglądający scalony tytuł musi rozwiązać i przeczytać kotwicę. Zapis do przykrytej komórki udaje się na poziomie pliku i nie pokazuje się nigdzie, czyli mamy pułapkę niewidzialnego nagłówka z otwarcia. A rozscalenie obszaru odsłania to, co siedziało pod nim przez cały czas, więc zabłąkana wartość wpisana w przykrytą przestrzeń zamienia się w widoczną usterkę w dniu, w którym ktoś rozpuści scalenie
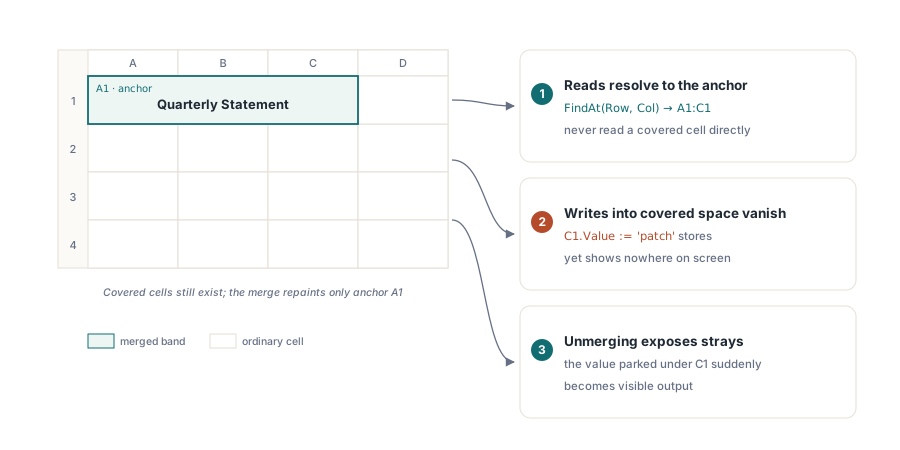
Po stronie XLSX ta tablica jest obiektem pierwszej klasy. Sheet.MergedCells niesie Add('A1:C1'), FindAt(Row, Col), DeleteAt i Items, a wywołaniem, po które sięgasz najczęściej, jest FindAt: podaj mu dowolną współrzędną, a zwróci scalony obszar przykrywający tę komórkę albo nil, gdy komórka stoi sama. To jedno wyszukanie jest fundamentem obu połówek poprawnej obsługi scaleń — bezpiecznego odczytu i strażnika zapisu — a obie pojawią się dalej
Dwie fasady, dwa idiomy scalania
HotXLS trzyma klasyczny silnik BIFF8 dla .xls i silnik OOXML dla .xlsx jako osobne modele obiektowe, a scalanie zapisują one różnie, bo wywodzą się z różnych konwencji. Fasada XLS idzie za idiomem COM Excela: bierzesz zakres z dwuargumentowej właściwości indeksowanej i wołasz Merge z OleVariant, którego wartość decyduje o geometrii, jaką dostaniesz
var
  Book: IXLSWorkbook;   // zliczany interfejsowo: bez ręcznego Free
  Sh: IXLSWorksheet;
begin
  Book := TXLSWorkbook.Create;
  Sh := Book.Sheets[1];                 // kolekcja arkuszy XLS liczy od jedynki
  Sh.Range['A1', 'F1'].Merge(False);    // False = jeden scalony blok
  Sh.Cells.Item[1, 1].Value := 'Quarterly Statement';
  Sh.Range['A3', 'F4'].Merge(True);     // True = scal wszerz: jedno scalenie na wiersz
  Book.SaveAs('layout.xls');
end;
Argument Merge jest tym, co ludzie mylą. Na zakresie dwuwierszowym Merge(True) produkuje dwa niezależne jednowierszowe scalenia, czyli excelowe "Scal wszerz" i dokładnie to, czego chcesz przy piętrowym pasie nagłówka, którego wiersze mają zostać rozdzielne. Merge(False) zlewa cały prostokąt w jeden blok. Zakres raportuje też MergeCells jako flagę stanu, zwraca obejmujący obszar przez MergeArea i rozpuszcza się przez Unmerge. Fasada XLSX wystawia te same operacje pod innymi nazwami: Sheet.MergeCells(Row1, Col1, Row2, Col2) bierze granice całkowite, TXLSXRange.Merge przyjmuje równoważny wariant Across, a kolekcja MergedCells trzyma wynik
Szablon, który rośnie razem ze swoimi danymi
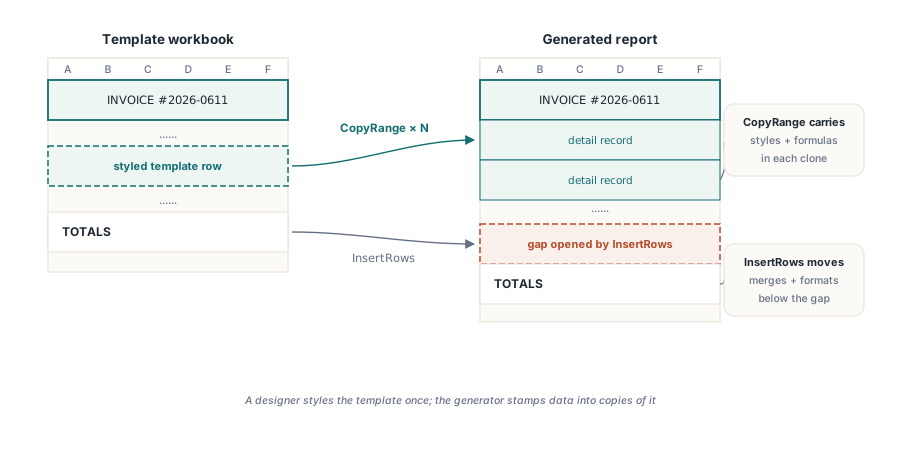
Prawdziwy szablon raportu nie jest stałą siatką. Nagłówek i sumy są stałe, ale sekcja szczegółów między nimi rozciąga się do tego, co zwróci zapytanie. Wzorzec, który się broni, trzyma w szablonie jeden w pełni ostylowany wiersz szczegółu, klonuje go raz na rekord, a potem otwiera przerwę przed blokiem sum, żeby wszystko zakotwiczone poniżej zjechało w dół, nie tracąc formatowania
Sheet.Range['A1:F1'].Merge;
Sheet.Cells[1, 1].Value := 'INVOICE #2026-0611';    // wartość idzie do kotwicy, A1
Sheet.RowHeight[1] := 28;
TitleFont := Book.Fonts.Add('Calibri', 16, True, False);
Sheet.Cells[1, 1].FontIndex := TitleFont + 1;        // indeks puli od zera, strona komórki od jedynki

// wiersz 5 to ostylowana linia szablonu szczegółu
for I := 0 to ItemCount - 1 do
  Sheet.CopyRange(5, 1, 5, 6, 6 + I, 1);             // style i formuły jadą razem z nim

// otwórz przerwę nad blokiem sum; treść poniżej zjeżdża w dół
Sheet.InsertRows(6 + ItemCount, 1);
Sheet.Range['A1:F1'].SetBorders(xlsxEdgeOutline, xlsxBorderMedium);
Dwie linie zasługują na drugie spojrzenie. Przypisanie czcionki niesie błąd o jeden, który gryzie po cichu: Fonts.Add oddaje pozycję w puli liczoną od zera, podczas gdy komórka przechowuje referencję czcionki liczoną od jedynki, gdzie 0 znaczy czcionkę domyślną, więc pominięcie + 1 niczego nie podnosi, tylko styluje twój tytuł niewłaściwym krojem. Drugą linią jest CopyRange, które przenosi formatowanie i formuły razem z wartościami. To cały powód, by klonować ręcznie zbudowany wiersz szablonu, zamiast odtwarzać jego wygląd w kodzie. Projektant jest właścicielem wyglądu raz, w szablonie; generator tylko wlewa dane do jego kopii
Ten podział skaluje się dalej, gdy układ wielokrotnego użytku mieszka we własnym skoroszycie, powiedzmy jako arkusz pasów nagłówka i stopki współdzielonych przez raporty. CopyRangeTo wykonuje ten sam klon przez granice arkuszy, biorąc arkusz docelowy plus współrzędne miejsca docelowego, więc generator może trzymać jeden nieskazitelny arkusz szablonu i odbijać jego obszary w tylu arkuszach wyjściowych, ile zadanie potrzebuje. Alternatywa, czyli mutowanie szablonu w miejscu i próba przywrócenia go potem, jest z gatunku rzeczy, które działają aż do dnia, w którym przebieg przerwie się w połowie
Co InsertRows przenosi, a czego nie
Wzorzec rosnącego szablonu działa tylko dlatego, że InsertRows w XLSX jest edycją strukturalną, a nie przetasowaniem komórek. Kiedy otwiera przerwę, przenosi scalone obszary, wysokości wierszy, hiperłącza, komentarze, zamrożone panele, zakresy autofiltru, formaty warunkowe, walidacje danych, tabele, nazwy zdefiniowane, kotwice obrazów i kotwice wykresów, które siedzą poniżej punktu wstawienia, nie tylko wartości komórek. To właśnie pozwala blokowi sum przybyć do nowego wiersza z nietkniętymi scaleniami i formatami liczbowymi zamiast przybyć obdartym
Jego dwa udokumentowane ograniczenia to te, wokół których warto projektować. Dostosowanie formuł ma zasięg edytowanego arkusza: referencje wewnątrz tego arkusza są przepisywane, a formuła na innym arkuszu wskazująca w przesunięty obszar też jest przepisywana, ale dostosowanie idzie tylko za referencjami celującymi w edytowany arkusz, więc każdy schemat referencji międzyskoroszytowych zasługuje na własny audyt, a nie na ślepe zaufanie. Drugie ograniczenie jest ostrzejsze i leży po stronie XLS. Tabele przestawne przeżywają cykle otwarcia i zapisu jako surowe zachowane rekordy, a nie jako modelowane obiekty, które HotXLS może przesunąć, więc wstawianie wierszy nie przenosi śladu tabeli przestawnej. Każdy szablon, który budujesz dla formatu .xls, powinien parkować swoje obszary przestawne z dala od jakiegokolwiek rosnącego pasa
Odmowa zapisu danych w przestrzeń układu
Awaria scalonych komórek, która naprawdę dociera na produkcję, nie jest tą kosmetyczną. Jest strukturalna: wiersz szczegółu dryfuje w scalony pas układu, jego wartości lądują w przykrytych komórkach i stają się niewidoczne, a sumy kolumn po cichu przestają zgadzać się z tym, co widzi każdy czytający arkusz. Ponieważ FindAt odpowiada na pytanie o obszar przykrywający dla dowolnej współrzędnej, generator może odmówić takiego zapisu w chwili, w której by nastąpił, zamiast wysyłać raport, który po cichu zaniża wyniki
// odmów zapisu danych szczegółowych w scalony obszar układu
if Sheet.MergedCells.FindAt(Row, 1) <> nil then
  raise Exception.CreateFmt('row %d overlaps a merged layout region', [Row]);
Sheet.Cells[Row, 1].Value := Detail.Description;
Ta sama kontrola granic należy się wszędzie tam, gdzie użytkownik będzie później sortował albo filtrował wyjście. Zakres ze scaleniami w środku nie da się czysto posortować, bo sortowanie przesuwa wiersze niezależnie, a scalenie rozpięte na wierszach nie ma jednego wiersza, z którym mogłoby podróżować; Excel odpowiada błędem albo pogmatwanym układem. Dyscyplina, która utrzymuje raporty poprawnymi, jest geograficzna. Zamknij scalenia w pasach tytułowych, przekładkach sekcji i blokach podpisu, a tabelaryczny środek arkusza trzymaj płaski. Artykuł o generowaniu raportów z szablonów rozwija ten podział na układ i dane w pełny przepływ oparty na symbolach zastępczych, a artykuł o formatowaniu warunkowym i tekście formatowanym omawia stylowanie tego płaskiego pasa danych
Jak scalenia degradują się w drodze na zewnątrz
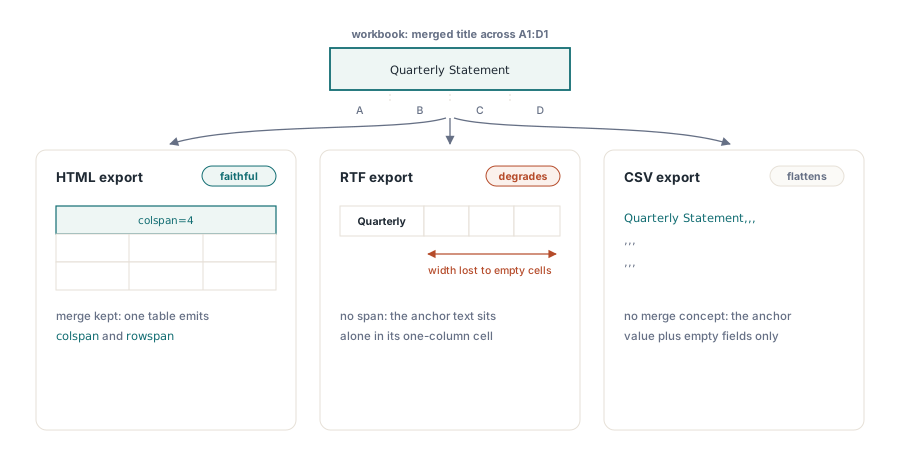
Scalenie to pojęcie skoroszytowe, a każdy format eksportu zorientowany na tekst honoruje je w innym stopniu. Znajomość tych trzech zachowań z góry oszczędza jeden cykl QA. Eksport HTML odtwarza scalenia wiernie, emitując colspan i rowspan w jednej tabeli, więc raport przeznaczony do przeglądarki zachowuje swój pasiasty wygląd. Eksport RTF w ogóle nie rozciąga kolumn: tekst kotwicy ląduje we własnej komórce, a pozostała szerokość scalenia wychodzi jako puste komórki, przez co szeroki tytuł wygląda w edytorze tekstu na wepchnięty do lewej. CSV nie ma pojęcia scalenia, więc wartość kotwicy zajmuje jedno pole, a każda przykryta komórka wychodzi jako pole puste. Wniosek dla skoroszytu, który zasila też eksporty z separatorami, brzmi: trzymaj wszystko nośne poza scaloną geometrią; artykuł o eksporcie CSV, TSV i HTML przechodzi przez każdy format szczegółowo
Jedno zapewnienie dla każdego, kto waży to wobec rozmiaru pliku: scalenia kosztują w skali raportu prawie nic. Tablica scaleń jest maleńka przy danych komórek, a odczyt przykrytej komórki nadal idzie przez FindAt, a nie przez skanowanie. Presja wydajnościowa na dużych skoroszytach bierze się skądinąd, głównie z rozrostu puli stylów i pamięci trzymanej przez ścieżkę zapisu, czym wprost zajmuje się artykuł o wydajności dużych skoroszytów. Oba API scaleń, operacje edycji strukturalnej i dema szablonów przychodzą z pakietem HotXLS Delphi Component