Pasek miniatur dla partii faktur od dostawców wygląda dobrze na pierwszy rzut oka: linie tabeli na miejscu, logo ostre, kolumny wyrównane. Przybliż jedną, a nazwa klienta to rząd pustych kratek, podczas gdy kolumna sum trzyma litery, które nie układają się w nic. Każda zepsuta faktura używa tej samej czcionki, ABCDEF+Arial, i każda czyta się dobrze w desktopowej przeglądarce PDF na tej samej maszynie. Kod miniatur wziął nazwę czcionki, rzucił sześcioliterowy tag podzbioru, poprosił Windows o Arial i podał mu surowe kody znaków ze strony. Te kody nigdy nie były kodami Ariala. Wierna bitmapa ze strony PDF wymaga dwóch rzeczy: uruchomienia strumienia treści strony jako programu i rysowania tekstu z obrysów glifów zapisanych w pliku, zamiast z czcionek, które maszyna renderująca akurat ma zainstalowane
Strona PDF to coś, co się wykonuje
ISO 32000-1 §8 opisuje stronę jako strumień treści: operatory zmieniające macierz transformacji przez cm, zapisujące i przywracające stan grafiki przez q i Q, budujące ścieżki, wybierające czcionki przez Tf, kładące glify przez Tj i malujące obrazy oraz formy przez Do. Nic w pliku nie rejestruje, jakikolwiek piksel wygląda. Żeby dostać bitmapę, coś musi uruchomić ten strumień względem bieżącej macierzy transformacji, stosu stanów, ścieżki przycinania i pary przestrzeni kolorów wypełnienia i kreski, po czym zrastrować to, co z tego wyjdzie
RenderLoadedPageToBitmap HotPDF to właśnie ten interpreter. Przechodzi operatory wczytanej strony, trzyma macierz i stan grafiki tak, jak definiuje je specyfikacja, rozwiązuje przestrzenie kolorów, zamienia ścieżki PDF w ścieżki GDI i bierze przyrosty glifów z tablicy /Widths czcionki, a nie z GDI. Obrazowe XObject-y idą przez te same dekodery, których biblioteka używa do ekstrakcji, więc każdy filtr obrazów, który HotPDF potrafi zdekodować przy ekstrakcji, w tym obrazy JPEG 2000 kompresowane JPXDecode, pokazuje się też na wyrenderowanej stronie
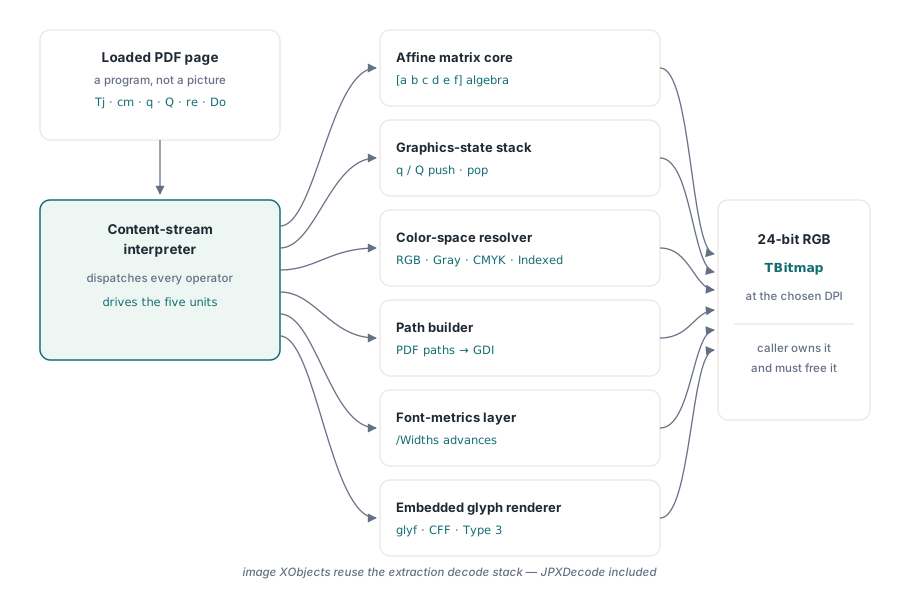
Renderowanie wczytanej strony do TBitmap w Delphi
THotPDF.RenderLoadedPageToBitmap(PageIndex, DPI) bierze indeks strony od zera i rozdzielczość w punktach na cal, gdzie 72 DPI mapuje jedną jednostkę PDF na jeden piksel, i zwraca nową 24-bitową TBitmap RGB. Indeks poza zakresem albo strona, której nie da się zbudować, zwraca nil zamiast podnosić. To pasuje przeglądarce, która powinna pominąć jedną uszkodzoną stronę i ciągnąć z resztą. Bitmapa należy do wywołującego
var
  Pdf: THotPDF;
  Bmp: TBitmap;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('report.pdf') > 0 then
    begin
      Bmp := Pdf.RenderLoadedPageToBitmap(0, 144);  // pierwsza strona przy 144 DPI
      if Bmp <> nil then
      try
        Image1.Picture.Assign(Bmp);
      finally
        Bmp.Free;  // wywołujący posiada zwróconą bitmapę
      end;
    end;
  finally
    Pdf.Free;
  end;
end;
Wymiary pikselowe wynikają z widocznego obszaru strony. Renderer bierze /CropBox przycięty do /MediaBox — tak ISO 32000-1 §14.11.2 definiuje region widoczny — używa /MediaBox, gdy używalnego pudła przycinania brak, skaluje przez DPI/72 i zaokrągla w górę. Strona US Letter bez osobnego pudła przycinania wraca więc dokładnie jako 612×792 pikseli przy 72 DPI. Strona A4 (595.28×841.89 punktu) przy 96 DPI wychodzi jako 794×1123, bo 793.7 i 1122.5 oba zaokrąglają się w górę. /Rotate równy 90 albo 270 zamienia szerokość z wysokością, a odbicie od początkowego układu PDF w lewym dolnym rogu do układu GDI w lewym górnym dzieje się wewnątrz macierzy strony, więc obraz przychodzi postawiony prosto, bez postprocessingu
DPI to jedyne pokrętło skalowania i pokrywa typowe zadania. Miniatury przy 36 albo 48 DPI są małe i szybkie. Podgląd ekranowy przy 96 albo 144 DPI odpowiada typowej gęstości wyświetlania. Eksport przy 300 DPI daje wyjście klasy drukarskiej — w cenie bitmapy 2550×3300 dla każdej strony Letter, w przybliżeniu 24 MiB każda przy trzech bajtach na piksel
Dlaczego podstawione czcionki rysują złe glify?
Złe glify na wyrenderowanym PDF prawie zawsze znaczą, że rasteryzator podstawił zainstalowaną czcionkę w miejsce tej wbudowanej w plik. Skrót z przykładu z fakturami jest kuszący, bo często działa: zerwij prefiks podzbioru z /BaseFont, poproś o czcionkę GDI po pozostałej nazwie, narysuj string. Dla zwykłego tekstu Arial albo Times New Roman ze standardowym kodowaniem nikt się nie czepia
Czcionki podzbiorów łamią to pierwsze. Podzbiór może nieść wyłącznie czterdzieści glifów, których używa dokument, numerowane w kolejności prywatnej dla tego pliku, więc kod 1 może znaczyć „T”, a kod 2 „h”. Zainstalowana czcionka nie może tego wiedzieć. Własne kodowania, czcionki symboli i kodów kreskowych i każdy krój nieobecny na maszynie renderującej zawodzą z tego samego powodu. A nawet gdy zamiennik ma każdy znak, jego szerokości przyrostu różnią się od wbudowanego kroju, więc linie rosną albo kurczą się, a kolumny wyrównane do prawej przestają się układać
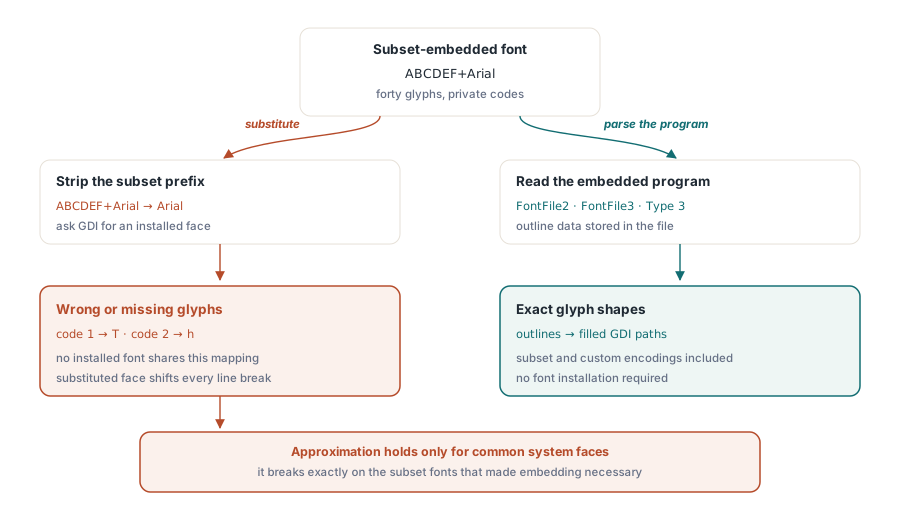
Rysowanie tekstu z wbudowanego programu czcionki
HotPDF rysuje tekst z programów czcionek zapisanych w PDF. Gdy czcionka niesie wbudowany program TrueType (/FontFile2) albo program CFF (/FontFile3), każdy glif jest kreślony z tych danych i wypełniany jako ścieżka GDI, z rozmiarem czcionki, macierzą tekstu i bieżącą macierzą transformacji złożonymi w jedną transformację. Czcionki podzbiorów, prywatne kodowania i kroje, których maszyna nigdy nie widziała, wychodzą ze swoimi prawdziwymi kształtami. Jak kod znaku dochodzi do glifu, zależy od typu czcionki, a każdy typ ma własną pułapkę:
- Obrysy TrueType: kontury pochodzą z tabel
glyfiloca. Segmenty kwadratowe są podnoszone do sześciennych Bézierów, które rysuje GDI — to dokładna konwersja, domniemany punkt na krzywej między dwoma kolejnymi punktami poza krzywą jest odtwarzany, a glify złożone wchodzą rekurencyjnie w swoje komponenty z nałożoną transformacją każdego komponentu - TrueType z kluczem CID: czcionki
Type0nadCIDFontType2dochodzą do identyfikatorów glifów przez/CIDToGIDMap—Identity(też domyślny, gdy wpisu brak) albo jawny strumień mapy — i biorą przyrosty z/Wi/DW, więc dwubajtowy tekstIdentity-Hstepuje o właściwą ilość. Predefiniowane CMap CJK i wbudowane strumienie CMap dekodują kody o zmiennej długości przed wyszukaniem - Programy CFF:
Type1C,CIDFontType0Ci CFF owinięte w kontener OpenType przechodzą przez interpreter charstringów Type 2, który ogarnia linie, krzywe, rodzinę flex, maski hintów oraz wywołania podprogramów lokalnych i globalnych z nałożonym biasem podprogramów. Programy z kluczem CID mapują każdy kod przez charset czcionki — co gra rolę przy podzbiorach, których kolejność glifów różni się od kolejności CID — i wybierają słownik prywatny per glif przezFDArrayiFDSelect - Proste czcionki TrueType: jednobajtowe kody przechodzą przez wbudowany
cmap, najpierw próbując podtabel Unicode (3,1) i (3,10), potem podtabeli symboli (3,0) i wprost, i na lustrzanym U+F000, którego używają czcionki symboli, a na końcu starej tabeli Makintosha (1,0)
Dwie reguły siedzą na wierzchu tego. Słownik /Encoding prostej czcionki jest rozwiązywany w kolejności, jaką nakazuje ISO 32000-1 §9.6.6: /Differences nadpisują kodowanie bazowe, a to nadpisuje mapowanie wbudowane w program. TeX i inne łańcuchy narzędzi wywodzące się z PostScriptu mocno się na tym opierają, więc pomyłka kolejności miesza dokładnie ten tekst matematyczny i symbolowy, w którym zły glif najtrudniej wychwycić. Czcionki Type3, których glify to małe strumienie treści, są odtwarzane przez ten sam interpreter ze złożonymi macierzą czcionki, rozmiarem czcionki i macierzą tekstu; glifowe /Widths przechodzą przez /FontMatrix, jak wymaga §9.6.5, a procedura glifu deklarująca pudło d1 jest przycinana do niego, więc zdeformowany glif kodu kreskowego nie pomaluje poza swoją komórkę
Gdy pojedynczy kod nie da się zmapować — bo program jest uszkodzony albo podzbiór nie ma tego glifu — ten jeden znak jest rysowany zainstalowaną czcionką o tej samej nazwie, a reszta biegu nadal używa wbudowanych obrysów. Upuszczenie całego biegu ukryłoby problem; jedna dziwna litera łatwiej rzuci się w oczy. Czcionki bez używalnego wbudowanego programu idą ścieżką czcionki zainstalowanej, opisaną w renderowaniu czcionek niewbudowanych krojami systemowymi
Jak utrzymać powtarzane rendery w szybkim tempie?
Do czegokolwiek interaktywnego wołaj RenderLoadedPageToBitmapCached zamiast zwykłej metody. Trzyma niedawno wyrenderowane strony w cache MRU kluczowanym indeksem strony, DPI i bieżącymi ustawieniami renderowania (intencja koloru, podgląd overprintu, polityka fallbacku i to, które warstwy zawartości opcjonalnej są widoczne), a trafienie oddaje świeżą kopię należącą do wywołującego bez ponownej interpretacji strumienia treści. Przeskakiwanie między dwiema stronami albo zmiana rozmiaru, która ponawia żądanie tej samej strony w tym samym DPI, trafia w cache za każdym razem. Dla jednorazowego eksportu odwiedzającego każdą stronę raz lepszym wywołaniem jest zwykłe RenderLoadedPageToBitmap, bo wariant z cache kopiuje każdą zwracaną bitmapę i trzymałby strony, o które nikt nie zapyta ponownie
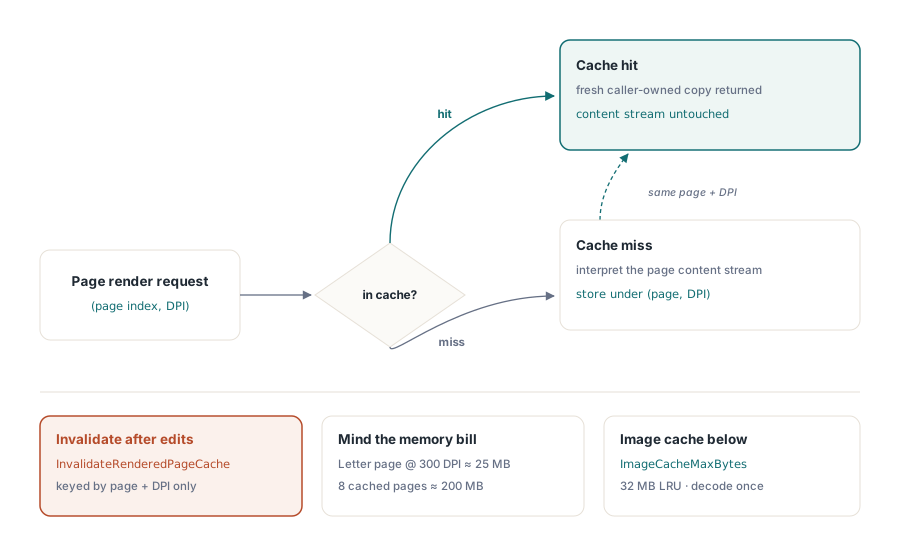
// Pasek miniatur: pierwszy przebieg renderuje, przewijanie w tył trafia w cache
Pdf.RenderCacheCapacity := 32;   // limit wpisów; domyślnie 8
for I := 0 to Pdf.LoadedPageCount - 1 do
begin
  Bmp := Pdf.RenderLoadedPageToBitmapCached(I, 48);
  if Bmp <> nil then
  try
    ThumbList.AddThumbnail(I, Bmp);  // twój własny kod UI
  finally
    Bmp.Free;
  end;
end;

// Trzymasz w cache też strony 300 DPI? Daj cache rastrowy z większym budżetem bajtów
// (Policy: THPDFCacheAdmissionPolicy)
if Pdf.GetCacheAdmissionPolicy(clkRaster, Policy) then
begin
  Policy.MaxTotalBytes := Int64(512) * 1024 * 1024;
  Pdf.SetCacheAdmissionPolicy(clkRaster, Policy);
end;

// Po bezpośredniej zmianie treści strony:
Pdf.InvalidateRenderedPageCache;  // następny render odzwierciedla edycję
RenderCacheCapacity to tylko jeden z dwóch limitów. Cache rastrowy ma też budżet bajtowy — domyślnie 128 MiB, z sufitem 64 MiB na wpis — i liczy cztery bajty na piksel przy budżetowaniu. Załóż przeglądarkę trzymającą strony Letter przy 300 DPI w cache: każdy wpis jest liczony jako około 32 MiB, więc mieszczą się trzy, cokolwiek mówi RenderCacheCapacity. Przy 48 DPI ta sama strona jest liczona jako około 0.82 MiB, i do 32 miniatur z powyższej pętli zostaje rezydentnie pod 27 MiB. Gdy cache jest pełny, strona żądana raz może nie przepchnąć strony żądanej często; nadal jest renderowana i zwracana, po prostu nie zostaje. Jeśli przeglądarka przewraca strony w przewidywalnej kolejności, PrefetchLoadedPages wypełnia ten sam cache na wątku roboczym, zanim użytkownik zażąda
Wczytanie nowego dokumentu czyści cache. Kilka własnych wywołań edycji stron biblioteki, takich jak FlattenLoadedFormFields, zrzuca dotknięte strony same; po każdej zmianie, którą sam robisz w obiektach strony albo strumieniach treści, wołaj InvalidateRenderedPageCache, bo cache nie umie dociec, że bajty za stroną się zmieniły. Pod spodem siedzi drugi magazyn dla zdekodowanych obrazowych XObject-ów, ograniczony przez ImageCacheMaxBytes (domyślnie 32 MiB), więc logo albo nagłówek firmowy powtarzany na każdej stronie dekoduje się raz na wczytanie dokumentu, zamiast raz na operator Do. InvalidateRenderedPageCache czyści też ten magazyn. Jeśli miniatury mają przeżyć restart aplikacji, warstwa dyskowa cache renderowania pokrywa ten przypadek
Wykrywanie, kiedy strona została przybliżona
Większość stron nigdy nie trafia w fallback, bo renderer pokrywa znacznie więcej niż tekst i obrazy. Przestrzenie kolorów CalGray, CalRGB, Lab i oparte na ICC są przeliczane z obowiązującą intencją renderowania, którą może nadpisać RenderColourIntent, a ConfigureRenderICCWorkflow przyjmuje profile ICC proof i wyjściowe do soft-proofingu. Palety indeksowane, tinta Separation i DeviceN oraz wyszukiwania koloru próbkowaną funkcją Type 0 są pokryte. Cieniowania oparte na funkcjach, osiowe, promieniste i siatkowe renderują się i przez operator sh, i przez wzorce cieniowania, a grupy przezroczystości, grupy knockout i miękkie maski alfa albo luminancji składają się z trybami mieszania, jak opisano w grupach trybów mieszania i maskach luminancji
Prawdziwe pliki wciąż zawierają rzeczy, których nie da się narysować dokładnie: zasób, który strona nazywa, ale nigdy nie definiuje; obraz, którego dane nie chcą się zdekodować; Form XObject malujący samego siebie. RenderFallbackPolicy rozstrzyga, co wtedy. Domyślny rfpIgnore rysuje najbliższe przybliżenie i idzie dalej. rfpReport robi to samo, ale rejestruje diagnostykę dla każdego fallbacku, do RenderFallbackDiagnosticLimit wpisów (domyślnie 256). rfpStrict podnosi wyjątek zamiast zwracać przybliżoną bitmapę. Zagnieżdżanie form zatrzymuje się na 32 poziomach, a forma odwołująca się do samej siebie jest pomijana, więc zepsuty albo wrogi plik nie urekursuje się bez granic
// rfpReport i THPDFRenderFallbackDiagnostics są zadeklarowane w HPDFPageRenderer
var
  Diags: THPDFRenderFallbackDiagnostics;
  J: Integer;
begin
  Pdf.RenderFallbackPolicy := rfpReport;
  Bmp := Pdf.RenderLoadedPageToBitmap(PageIndex, 150);
  try
    Diags := Pdf.GetLastRenderFallbackDiagnostics;
    for J := 0 to High(Diags) do
      Log.Add(Format('page %d: %s %s - %s', [PageIndex + 1,
        string(Diags[J].OperatorName), string(Diags[J].ObjectName),
        string(Diags[J].Reason)]));
    if Pdf.LastRenderFallbackDroppedCount > 0 then
      Log.Add(Format('%d more fallbacks not recorded',
        [Pdf.LastRenderFallbackDroppedCount]));
  finally
    Bmp.Free;  // Free jest bezpieczne na nil
  end;
end;
Buildy QA i ingestii puść z rfpReport. Bitmapa jest identyczna z tym, co produkuje rfpIgnore, a log pokazuje, które strony zostały przybliżone i dlaczego, zanim klient zgłosi, że strona 14 wygląda dziwnie. rfpStrict zostaw dla konwersji archiwalnej, gdzie po cichu przybliżona strona jest gorsza niż nieudana. Trafienie w cache odtwarza diagnostykę zarejestrowaną, gdy ta strona była renderowana pierwszy raz, więc GetLastRenderFallbackDiagnostics daje tę samą odpowiedź niezależnie od tego, czy wariant z cache zrobił jakąkolwiek robotę
RenderLoadedPageToBitmap, wariant z cache i ścieżka tekstu z wbudowanych glifów są częścią HotPDF Delphi Component, natywnej biblioteki VCL dla Delphi i C++Buildera bez zewnętrznych DLL-i, która także tworzy, edytuje i wyciąga tekst z tych samych wczytanych dokumentów, które renderujesz