Enkoder Reed-Solomon, który przechowuje wyraz wolny wielomianu generatorowego na początku, a potem dzieli od wyrazu wiodącego, w ogóle nie liczy korekcji błędów. HotPDF dostarczył dokładnie to w czterech enkoderach kodów 2D — QR, Data Matrix, PDF417 i Aztec — a każdy wyprodukowany przez nie symbol niósł blok kontrolny, którego żaden zgodny skaner nie mógł użyć
Ciekawa część to nie pomyłka w arytmetyce, tylko propagacja. Najpierw napisano jeden enkoder, jego pętlę dzielenia skopiowano do trzech następnych, a każdy nowy format dziedziczył defekt, którego nigdy nie zweryfikowano wobec ani jednego opublikowanego wektora testowego. Symbole nadal się renderowały, wzorce kotwiczące siedziały w dobrych miejscach, rozmiary były poprawne. Garbem były tylko te bajty, które pozwalają kodowi 2D przeżyć zabrudzenie
Jeden odwrócony wielomian, skopiowany do czterech enkoderów
Sednem jest niezgodność kolejności przechowywania w pętli dzielenia syntetycznego. Wszystkie cztery enkodery HotPDF budują wielomian generatorowy ze współczynnikami od najniższego do najwyższego, więc Gen[0] trzyma wyraz wolny, a Gen[High(Gen)] wiodący współczynnik moniczny. Pętla dzielenia indeksowała Gen[J] w przód, idąc wzdłuż wiadomości, co arytmetycznie jest identyczne z dzieleniem przez odwrócony wielomian. Była też druga konsekwencja, która maskowała pierwszą: skoro współczynnik wiodący nigdy nie lądował na pozycji I, to Work[I] nigdy nie było czyszczone, więc dzielenie tak naprawdę niczego nie redukowało. Pętla mimo to kończyła się i mimo to wypełniała ogon tablicą o dokładnie właściwej długości
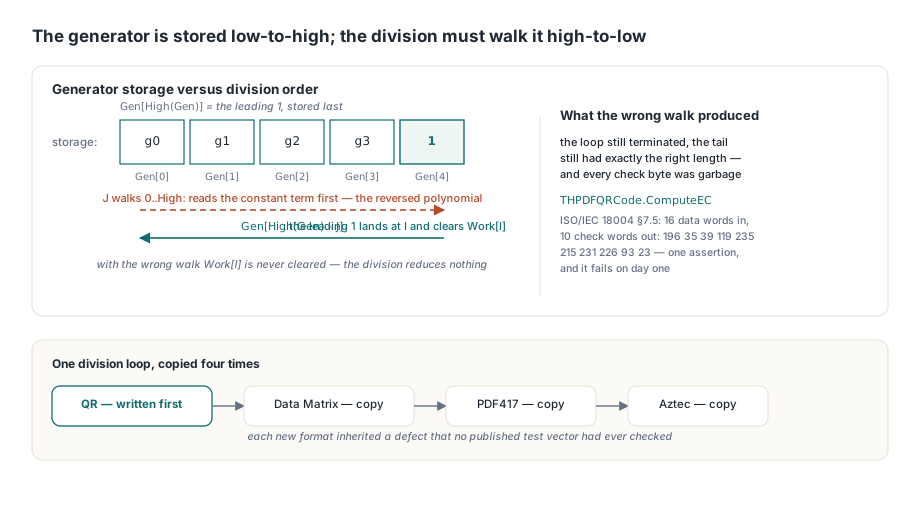
// THPDFQRCode.ComputeEC w HPDFQRCode.pas
Gen := GeneratorPoly(ECCount);            // Gen[0] to wyraz stały
SetLength(Work, Length(Data) + ECCount);
for I := 0 to High(Data) do
  Work[I] := Data[I];
for I := Length(Data) to High(Work) do
  Work[I] := 0;
for I := 0 to High(Data) do
begin
  Factor := Work[I];
  if Factor = 0 then
    Continue;
  // Gen[High(Gen)] to wiodąca jedynka, która zeruje Work[I]; przechodzenie po Gen
  // do przodu dzieli przez odwrócony wielomian zamiast tego
  for J := 0 to High(Gen) do
    Work[I + J] := Work[I + J] xor GFMul(Gen[High(Gen) - J], Factor);
end;
Poprawka to pojedyncze wyrażenie indeksu Gen[High(Gen) - J]. Po niej THPDFQRCode.ComputeEC odtwarza przepracowany przykład z §7.5 normy ISO/IEC 18004: blok w trybie bajtowym wersji 1-M 32 91 11 120 209 114 220 77 67 64 236 17 236 17 236 17 daje dziesięć słów kontrolnych 196 35 39 119 235 215 231 226 93 23. To jedna asercja i zawiodłaby pierwszego dnia
Dlaczego symbol Aztec tracił też payload?
Aztec niósł cięższą wersję tego samego buga, bo TAztecGF.Encode dzieli w miejscu. Procedura dostaje Words z wiadomością i wyzerowanymi slotami słów kontrolnych, a wywołujący emituje całą tę tablicę do symbolu. Dzielenie wielomianów niszczy dzielną w trakcie redukcji, więc gdy pętla została poprawiona tak, żeby faktycznie redukować, słowa wiadomości były nadpisywane po drodze. Payload i wiadomość trybu oba wychodziły uszkodzone — porażka, której zepsuta wersja przypadkiem unikała, bo nigdy niczego nie redukowała
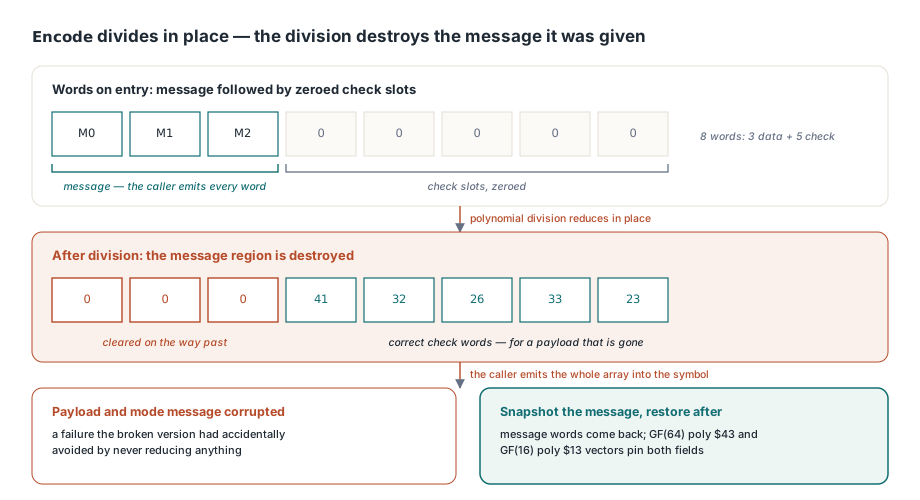
// TAztecGF.Encode w HPDFAztec.pas
SetLength(Message, DataCount);
for I := 0 to DataCount - 1 do
  Message[I] := Words[I];
for I := 0 to DataCount - 1 do
begin
  Factor := Words[I];
  if Factor = 0 then
    Continue;
  for J := 0 to ECCount do
    Words[I + J] := Words[I + J] xor Multiply(Gen[ECCount - J], Factor);
end;
// Dzielenie zeruje obszar wiadomości, ale wywołujący emituje całą
// tablicę do symbolu, więc słowa danych muszą wrócić
for I := 0 to DataCount - 1 do
  Words[I] := Message[I];
Aztec używa dwóch różnych ciał, a fixture regresyjny ćwiczy oba. W GF(64), ciele sześciobitowego symbolu zbudowanym z wielomianu pierwotnego $43, słowa 12 45 3 z pięcioma słowami kontrolnymi dają 41 32 26 33 23, a trzy wiodące zostają nietknięte. W GF(16), ciele wiadomości trybu z wielomianem pierwotnym $13, słowa 5 9 dają 11 15 6 8. Obie ścieżki biegną przez hook HPDFAztecTestEncode wobec normy ISO/IEC 24778
Dlaczego Data Matrix potrzebuje dwóch poprawek zamiast jednej?
THPDFDataMatrix.ComputeEC ułożył drugi, niezależny błąd na wierzchu wspólnego: budował wielomian generatorowy z pierwiastkami startującymi od α^0, podczas gdy załącznik E normy ISO/IEC 16022 wymaga pierwiastków od α^1. Poprawienie samego indeksu dzielenia daje dla standardowego przykładu słowa kontrolne 146 107 90 179 128, które wyglądają równie wiarygodnie jak poprawne, a mimo to są nieczytelne. Oba defekty musiały zniknąć, zanim liczby się zgodziły
// THPDFDataMatrix.ComputeEC w HPDFDataMatrix.pas
Gen[0] := 1;
for I := 0 to ECCount - 1 do
begin
  // DMExp[I + 1]: pierwiastki biegną od alpha^1 do alpha^ECCount, a nie od alpha^0
  for J := ECCount downto 1 do
    Gen[J] := GFMul(Gen[J], DMExp[I + 1]) xor Gen[J - 1];
  Gen[0] := GFMul(Gen[0], DMExp[I + 1]);
end;
Punkt odniesienia jest na tyle mały, że mieści się w komentarzu. String '123456' koduje się do słów kodowych ASCII 142 164 186, symbol 10x10 niesie pięć słów kontrolnych, a poprawny blok to 114 25 5 88 102. HPDFDataMatrixTestComputeEC wystawia funkcję klasy za bramką {$IFDEF HPDF_TESTING}, więc fixture asertuje te pięć wartości bez instancjonowania enkodera i bez renderowania strony. Sama struktura ciała Galois, zbudowanego przez InitDMTables nad wielomianem pierwotnym $12D w tablice DMExp i DMLog, była poprawna przez cały czas, i właśnie dlatego bug tak dobrze się ukrywał
PDF417 dzieli nad ciałem pierwszym, gdzie znaki mają znaczenie
PDF417 wymagał czterech zmian zamiast jednej, bo GF(929) to ciało pierwsze, nie binarne ciało rozszerzone: dodawanie to nie xor, odejmowanie to nie dodawanie, a znak każdego czynnika generatora to prawdziwa arytmetyka, nie notacja. Każdy czynnik musi być (x - 3^i), co w kodzie oznacza mnożenie przez 929 - GF929Pow(3, I); krok redukcji musi odejmować; pierwiastki biegną od 3^1 zgodnie z §5.5 normy ISO/IEC 15438; a Factor musi być złapany do lokalnej zmiennej, zanim ruszy pętla wewnętrzna, bo przebieg J = 0 zapisuje Work[I] i inaczej zmieniłby mnożnik pod własnymi nogami. HPDFPDF417TestComputeEC przypina poprawiony wynik: słowa kodowe 5 453 178 121 239 z czterema słowami korekcji dają 452 327 657 619
// THPDFPDF417.ComputeEC w HPDFPDF417.pas
for I := 1 to ECCount do
begin
  Root := (929 - GF929Pow(3, I)) mod 929;   // czynnik to (x - 3^i)
  for J := ECCount downto 1 do
    Gen[J] := (GF929Mul(Gen[J], Root) + Gen[J - 1]) mod 929;
  Gen[0] := GF929Mul(Gen[0], Root);
end;
// ...
Factor := Work[I];                          // latch: J = 0 rewrites Work[I]
if Factor = 0 then
  Continue;
for J := 0 to ECCount do
  Work[I + J] := (Work[I + J] + 929 - GF929Mul(Gen[ECCount - J], Factor)) mod 929;
Wzorzec kotwiczący Data Matrix był zainstalowany na opak
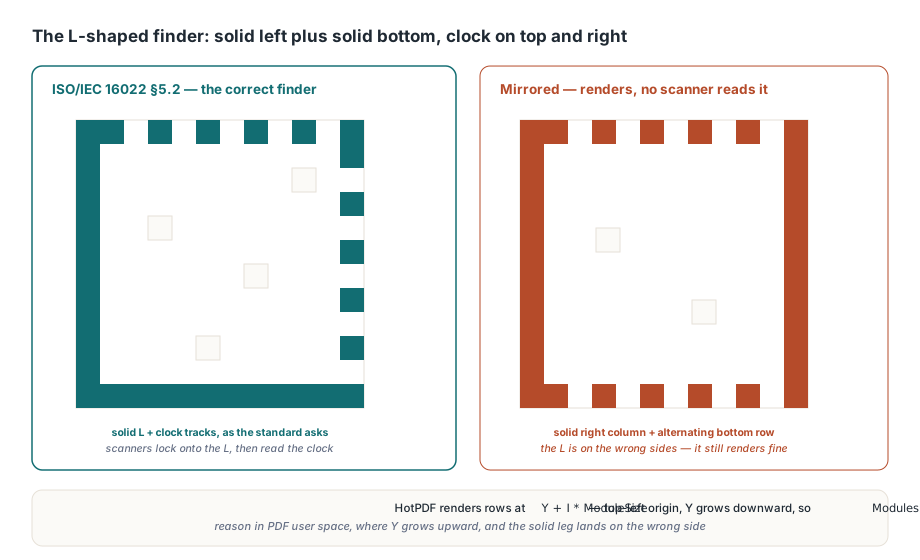
Poprawne słowa kontrolne nie uratują symbolu, którego wzorzec kotwiczący jest odbity, i ten sam release musiał naprawić też to. Kod rozmieszczający rysował pełną lewą kolumnę, pełną prawą kolumnę i naprzemienne moduły wzdłuż górnego i dolnego wiersza, podczas gdy §5.2 normy ISO/IEC 16022 wymaga pełnej lewej kolumny plus pełnego dolnego wiersza — kotwicy w kształcie L — z naprzemiennym torem zegara biegnącym wzdłuż górnego wiersza i prawej kolumny. To, co ułatwia odwrócenie tego, to konwencja współrzędnych: HotPDF renderuje wiersze modułów na Y + I * ModuleSize, czyli z semantyką początku w lewym górnym rogu, więc Modules[Size - 1, *] to dolny wiersz wydrukowanego symbolu. Każdy, kto rozumuje w przestrzeni użytkownika PDF, gdzie Y rośnie w górę, stawia pełną nogę po złej stronie i nie widzi na ekranie niczego podejrzanego
Dlaczego cztery zepsute enkodery przechodziły testy przez lata?
Bo testy asertowały strukturę, a defekty siedziały w arytmetyce. Dotychczasowe przypadki QR, Data Matrix i Aztec sprawdzały moduły kotwic, wzorce taktowania i wymiary symboli, a wszystko to było faktycznie poprawne; żaden test nigdy nie porównał słowa kontrolnego z opublikowanym wektorem. Drugi powód uogólnia się dalej. HotPDF ma wbudowany dekoder QR, a użycie go do walidacji enkodera brzmi jak oczywisty round trip, z tym że ten dekoder czyta słowa kodowe danych i nie wykonuje żadnej korekcji Reed-Solomon, więc czytał z powrotem dokładnie to, co napisał enkoder, i raportował sukces. Gdy enkoder i dekoder dzielą jakieś założenie, test round trip dowodzi, że się ze sobą zgadzają, nie że którykolwiek ma rację. Kod korekcji błędów trzeba walidować przeciw wektorom wydrukowanym w standardzie, nigdy przeciw własnemu dekoderowi. Fixture THPDFBarcodeECCTests trzyma teraz jeden test na format, każdy nazwany od tego, co przypina, i każdy sięgający arytmetyki przez hook kompilowany tylko pod {$IFDEF HPDF_TESTING}:
QRCheckWordsMatchISO18004Exampleasertuje dziesięć słów kontrolnych przykładu w trybie bajtowym wersji 1-MDataMatrixCheckWordsMatchISO16022Exampleasertuje 114 25 5 88 102 dla słów kodowych 142 164 186PDF417CheckWordsMatchGF929Referenceasertuje 452 327 657 619 nad GF(929) z pierwiastkami 3^1 do 3^4AztecCheckWordsKeepMessageAndMatchReferenceasertuje słowa kontrolne i to, że słowa wiadomości przeżywają dzielenie w miejscu
Cztery pytania łapią większość tej rodziny w każdym enkoderze, który utrzymujesz. Czy kolejność przechowywania generatora zgadza się z kolejnością indeksowania w dzieleniu i czy potrafisz wskazać linię, która to udowadnia? Czy pierwiastki startują tam, gdzie mówi standard, α^1 dla Data Matrix i 3^1 dla PDF417? Czy dzielenie w miejscu przywraca potem obszar wiadomości? Czy co najmniej jeden test porównuje słowa kontrolne, nie liczbę modułów, z liczbą wydrukowaną w specyfikacji? Zakres ma też znaczenie, gdy decydujesz, co zrobić z istniejącymi artefaktami. Symbole wygenerowane przed v2.748.0 renderują się i często skanują w idealnych warunkach, bo czysty obraz nie potrzebuje korekcji, żeby zostać odczytany; to, co straciły, to tolerancja uszkodzeń — cały powód, dla którego wybiera się te formaty. Długożyjące etykiety i zarchiwizowane dokumenty niosące dotknięte symbole warto wygenerować ponownie, zamiast kontrolować je punktowo kamerą telefonu. Enkodery mieszkają w wsparciu kodów kreskowych w HotPDF, obok ścieżki dekodowania QR z jej obsługą orientacji i warstwy wyjścia raportów, która umieszcza symbole na stronie; pełna referencja API kodów kreskowych trafia z HotPDF Delphi Component dla Delphi i C++Builder