PDF, który z lokalnego dysku otwiera się natychmiast, może potrzebować kilku sekund na pokazanie pierwszej strony, gdy te same bajty przychodzą z serwera HTTP odpowiadającego na żądania zakresów — choćby plik miał ledwie kilka megabajtów, a łącze było szybkie. Pasmo nie jest problemem. Liczba żądań jest, a lekarstwo polega na zamianie setek drobnych rozproszonych odczytów w kilkanaście buforowanych bloków, po czym czytaniu z wyprzedzeniem tylko dopóty, dopóki wzorzec dostępu pozostaje sekwencyjny
Dlaczego ten sam plik PDF wczytuje się natychmiast lokalnie, a pełznie przez sieć?
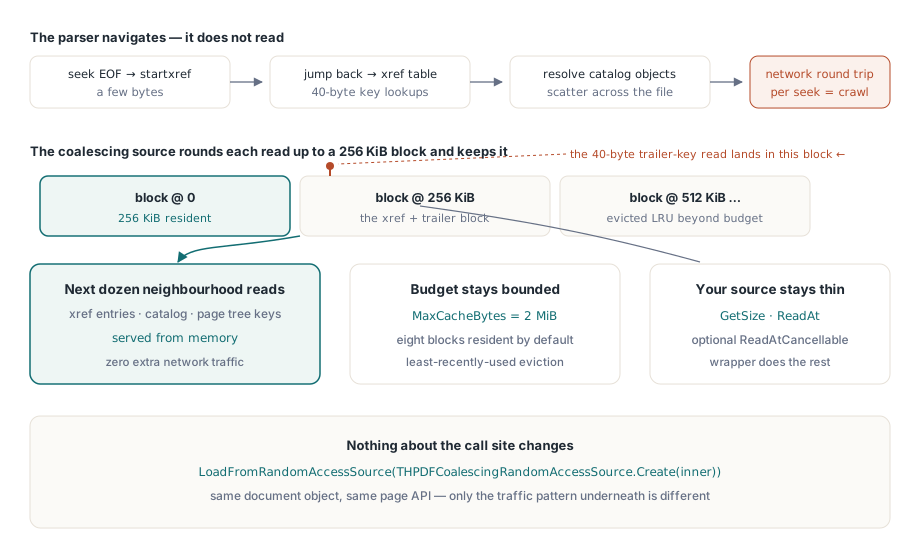
Parser PDF nie czyta pliku od frontu do tyłu. On po nim nawiguje. Struktura z ISO 32000-1 §7.5 kładzie punkt wejścia na końcu: parser skacze do ostatniego kilobajta po startxref, wraca do tablicy odniesień krzyżowych, rozwiązuje słownik trailer, podąża za referencją do katalogu, potem do korzenia drzewa stron, potem do węzła strony, potem do słownika zasobów tej strony. Każdy skok czyta dziesiątki bajtów z innego offsetu, a przyrostowo aktualizowany plik powtarza ten spacer raz na rewizję przez łańcuch /Prev
Na lokalnym pliku ten wzorzec jest niemal darmowy, bo system operacyjny już trzyma otaczającą stronę 4 KiB w swoim cache plikowym, a drugi odczyt kosztuje kopię w pamięci. Transport sieciowy nie ma takiej lokalności. Każdy odczyt staje się żądaniem z własnym opóźnieniem, a arytmetyka jest brutalna: przy 40 ms na podróż w obie strony 300 małych odczytów sumuje się do dwunastu sekund czekania, przy czym łącze siedzi w większości bezczynnie. Czytanie mniej nie wchodzi w grę, bo parser potrzebuje dokładnie bajtów, o które prosi. Zmienić może to, ile każde fizyczne żądanie przywozi z powrotem
Opakowanie transportu w THPDFCoalescingRandomAccessSource
HotPDF wczytuje dokumenty z dowolnej klasy zstępującej z THPDFRandomAccessSource, a THPDFCoalescingRandomAccessSource siedzi między tą klasą a parserem. Każdy odczyt jest zaokrąglany do wyrównanego bloku, a blok jest trzymany w pamięci. BlockSize domyślnie wynosi 262 144 bajty, a MaxCacheBytes 2 097 152, więc osiem bloków pozostaje rezydentnych, a najdawniej używany odchodzi, gdy budżet się zapełni. 40-bajtowe poszukiwanie klucza trailer przez parser ściąga 256 KiB wokół niego, a kolejny tuzin odczytów w tym sąsiedztwie (wpisy odniesień krzyżowych, katalog, klucze drzewa stron) wychodzi z pamięci
Twoja własna klasa pozostaje chuda. Dwie metody są obowiązkowe: GetSize i ReadAt. Nadpisz ReadAtCancellable, gdy twój klient HTTP potrafi przerwać żądanie w locie, i nadpisz IsRangeAvailable, gdy źródłem jest pobieranie jeszcze w toku. Opakowanie zadaje to pytanie przed każdym pobraniem: jeśli całego bloku jeszcze nie ma, ponawia z samymi żądanymi bajtami, a jeśli i ich brak, odczyt wraca krótki zamiast blokować
type
  // TMyHttpClient reprezentuje twoją własną klasę klienta HTTP
  THttpRangeSource = class(THPDFRandomAccessSource)
  private
    FClient: TMyHttpClient;
    FUrl: string;
    FSize: Int64;
  public
    constructor Create(const AUrl: string);
    function GetSize: Int64; override;
    function ReadAt(Offset: Int64; var Buffer; Count: Longint): Longint; override;
    function ReadAtCancellable(Offset: Int64; var Buffer; Count: Longint;
      CancellationToken: THPDFCancellationToken): Longint; override;
  end;

var
  Raw: THttpRangeSource;
  Cached: THPDFCoalescingRandomAccessSource;
  Pdf: THotPDF;
begin
  Raw := THttpRangeSource.Create('https://files.example.com/contract.pdf');
  // OwnsSource=True: opakowanie zwalnia Raw; bloki 256 KiB, budżet 8 MiB
  Cached := THPDFCoalescingRandomAccessSource.Create(Raw, True, 262144, 8388608);
  Cached.MaxReadAheadBlocks := 8;   // dozwolony zakres 1..32
  Pdf := THotPDF.Create(nil);
  try
    // OwnsSource=True ponownie: Pdf zwalnia Cached, który zwalnia Raw
    if Pdf.LoadFromRandomAccessSource(Cached, True) > 0 then
      RenderFirstPage(Pdf);   // twój własny kod
  finally
    Pdf.Free;
  end;
end;
Asynchroniczny prefetch i adaptacyjny odczyt wyprzedzający są oba włączone od chwili skonstruowania opakowania, więc przykład dotyka tylko sufitu okna. Konstruktor waliduje argumenty z góry: BlockSize musi leżeć między 4 096 a 16 777 216 bajtów, a MaxCacheBytes musi pomieścić co najmniej jeden blok, inaczej dostajesz ERangeError, zanim ruszy choć bajt
Jawnego opakowania ściśle nie potrzebujesz. Podaj LoadFromRandomAccessSource zwykłe źródło, a HotPDF opakuje je za ciebie, używając polityki cache surowca, którą przeczytasz i zmienisz przez GetCacheAdmissionPolicy i SetCacheAdmissionPolicy z warstwą clkRawCompressed: osiem wpisów, 2 MiB łącznie, 256 KiB na wpis. Podaj własny THPDFCoalescingRandomAccessSource, a zostanie użyty dokładnie tak, jak skonfigurowałeś. Dla czegokolwiek, co przekracza sieć, buduj opakowanie sam; dostajesz gałki odczytu wyprzedzającego i pełny rekord statystyk, podczas gdy ścieżka automatyczna raportuje tylko liczniki trafień, chybień, przyjęć i eksmisji przez GetCacheAdmissionStatistics
Jak daleko powinien sięgać odczyt wyprzedzający?
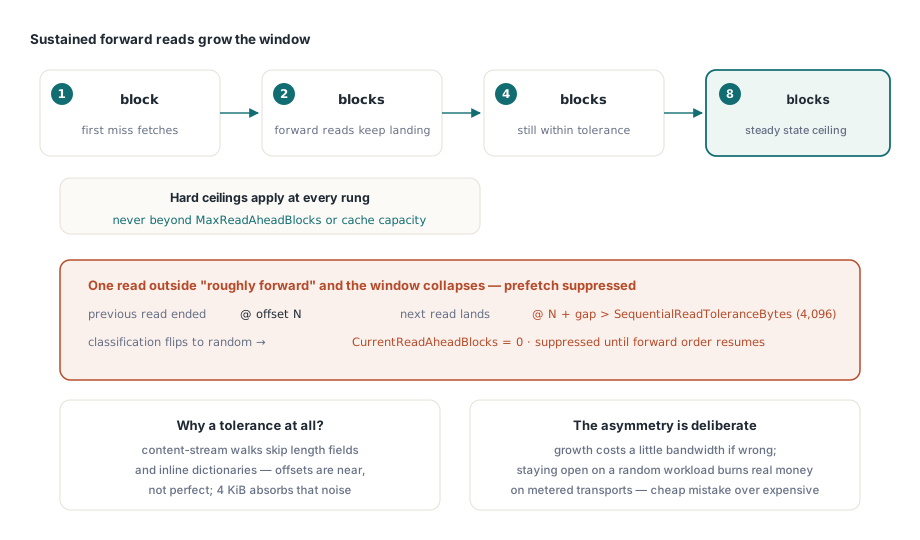
Adaptacyjny odczyt wyprzedzający rozstrzyga per dokument. Z ustawionym AdaptiveReadAheadEnabled każdy odczyt, jaki parser robi przez wczytany dokument, jest klasyfikowany jako sekwencyjny albo losowy, a okno prefetchu podąża za punktacją. Dwa z rzędu odczyty w przód otwierają okno na dwa bloki, cztery otwierają na cztery, sześć otwierają na osiem. Okno nigdy nie przekracza MaxReadAheadBlocks i nigdy nie przekracza liczby bloków, które mieszczą się w MaxCacheBytes, więc mały cache nie może zostać zatopiony przez własny prefetch
Odczyt skaczący do tyłu albo lądujący zbyt daleko za końcem poprzedniego zrzuca punktację poniżej zera. Okno się zamyka, każdy prefetch kierujący gdzie indziej jest anulowany, a SuppressedPrefetchCount idzie w górę. Dwa odczyty w przód później okno otwiera się ponownie na jednym bloku. Ta zwłoka jest sednem: jeden szczęśliwy ciągły odczyt w środku pogoni za odniesieniami krzyżowymi nie restartuje spekulacji
SequentialReadToleranceBytes, domyślnie 4 096, definiuje „zbyt daleko". Parser przechodzący strumień treści nie produkuje idealnie ciągłych offsetów; tu pomija pole długości, tam słownik obrazu osadzonego. Odczyty lądujące w granicach tolerancji od poprzedniego końca nadal liczą się jako w przód. Ustaw za nisko, a normalny skan w przód zostanie zaklasyfikowany jako losowy, więc odczyt wyprzedzający nigdy się nie włączy. Ustaw za wysoko, a prawdziwy dostęp losowy wygląda na sekwencyjny i ściągasz megabajty, których nikt nie czyta. Setter przyjmuje dowolną wartość od zera do BlockSize i resetuje punktację, gdy się zmienia
Wzrost jest stopniowy, zapaść natychmiastowa, i ta asymetria jest celowa. Nadmierne pobieranie przy losowym obciążeniu pali prawdziwe pasmo, a na transporcie taryfowanym prawdziwe pieniądze; niedobór przy sekwencyjnym kosztuje kilka podróży w obie strony nadliczbowych. Zostaw AdaptiveReadAheadEnabled włączone. Wyłączone, opakowanie prefetchuje jeden blok po każdym odczycie niezależnie od wzorca — dokładnie złe zachowanie, póki parser skacze między sekcjami odniesień krzyżowych
Klasyfikacją steruje strumień, z którego HotPDF czyta w trakcie wczytywania. Jeśli twój własny kod też ciągnie bajty przez opakowanie — na przykład żeby zhaszować plik albo wyciągnąć załącznik — wołaj ObserveReadPattern z offsetem i długością po każdym odczycie, żeby okno reagowało też na ten ruch. Gdy już wiesz, które bajty będą potrzebne następne, PrefetchRange startuje pobranie w tle wprost; IsPrefetchActive raportuje, czy jakieś jeszcze biegnie
Trzymanie gorących bloków, gdy cache jest pełny
Zwykła eksmisja najdawniej używanych ma znaną słabość. Jeden długi przebieg w przód — powiedzmy przez duży obraz osadzony — wypycha każdy blok, do którego parser wciąż wraca, łącznie z blokami odniesień krzyżowych i katalogu, które będą znowu potrzebne na następnej stronie. THPDFCoalescingRandomAccessSource liczy, jak często o każdy blok proszono, i gdy budżet jest pełny, nowy blok wchodzi do cache tylko, jeśli proszono o niego co najmniej tyle samo razy co o blok, który miałby zastąpić. Inaczej odczyt idzie wprost do twojego źródła po dokładnie żądane bajty, a RejectionCount i FrequencyRejectionCount to odnotowują
Ta reguła jest domyślnie włączona (argument konstruktorowy AdaptiveAdmission). ConfigureCacheAdmission zmienia budżet bajtowy, sufit per wpis, opcjonalny limit liczby wpisów i regułę przyjęć na żywym opakowaniu; anuluje każdy biegnący prefetch i przycina cache do nowych limitów na miejscu
Anulowanie, które faktycznie zatrzymuje transfer
Prefetch chodzi na jednym wątku tła, a opakowanie anuluje go, jak tylko przestaje wart dokończenia. Pierwszoplanowy odczyt bajtów poza prefetchowanym zakresem go anuluje, więc strona, o którą prosił użytkownik, nigdy nie czeka za spekulacyjnym ruchem. Losowy odczyt go anuluje. Zniszczenie opakowania albo wołanie CancelPrefetch czy ClearCache anuluje go i czeka na wyjście wątku. Każde z tych zdarzeń ustawia THPDFCancellationToken, który wątek prefetchu przekazuje do twojego ReadAtCancellable
Czy bajty faktycznie przestaną płynąć, zależy od twojego nadpisania. Domyślny ReadAtCancellable na THPDFRandomAccessSource sprawdza token przed i po zwykłym ReadAt — wystarcza to dla udziału plikowego, ale pozwala półskończonej odpowiedzi HTTP 256 KiB dobiec do końca. Klient czytający ciało odpowiedzi w kawałkach może sprawdzać token między kawałkami i przerywać:
function THttpRangeSource.ReadAt(Offset: Int64; var Buffer;
  Count: Longint): Longint;
begin
  Result := ReadAtCancellable(Offset, Buffer, Count, nil);
end;

function THttpRangeSource.ReadAtCancellable(Offset: Int64; var Buffer;
  Count: Longint; CancellationToken: THPDFCancellationToken): Longint;
var
  Status: Integer;
begin
  if CancellationToken <> nil then
    CancellationToken.ThrowIfCancellationRequested('http range read');
  // GetRange i jego callback to API twojego klienta: wysyła
  // "Range: bytes=Offset-(Offset+Count-1)" i woła callback między kawałkami ciała
  Result := FClient.GetRange(FUrl, Offset, Count, Buffer, Status,
    function: Boolean
    begin
      Result := (CancellationToken <> nil) and
        CancellationToken.IsCancellationRequested;
    end);
  // 200 zamiast 206 znaczy, że serwer zignorował Range i wysłał cały plik
  if Status <> 206 then
    raise EStreamError.CreateFmt('Range request not honored (HTTP %d)', [Status]);
  if CancellationToken <> nil then
    CancellationToken.ThrowIfCancellationRequested('http range read');
end;
Sprawdzian statusu pokrywa pułapkę, w którą wpada najpierw większość źródeł HTTP. RFC 9110 §14 pozwala serwerowi zignorować nagłówek Range i odpowiedzieć 200 z pełną reprezentacją, a niektóre konfiguracje CDN i proxy robią dokładnie to dla pewnych plików. Źródło kopiujące pierwsze Count bajtów odpowiedzi 200 wręcza parserowi bajty z offsetu zero, niezależnie od tego, o który offset prosiło. Wartości zwracane też się liczą: opakowanie podnosi EStreamError, gdy ReadAt raportuje ujemną liczbę albo więcej bajtów niż żądano, a zero traktuje jako koniec danych
Jedyny niepusty token, jaki twoje źródło dostaje, należy do wątku prefetchu. Odczyty parsera w trakcie wczytywania docierają do twojego ReadAtCancellable z tokenem nil, więc zatrzymanie samego wczytywania to osobny przełącznik: przypisz token do THotPDF.OperationCancellationToken, a wczytywanie dokumentu sprawdza go w trakcie. Ten sam model tokenów napędza kolejkę opisaną w renderowaniu w tle z kolejką żądań, więc przeglądarka może anulować wczytywanie, jego rendery i jego spekulacyjny ruch sieciowy z jednego handlera zamykania
Odczytywanie statystyk pamięci podręcznej zakresów
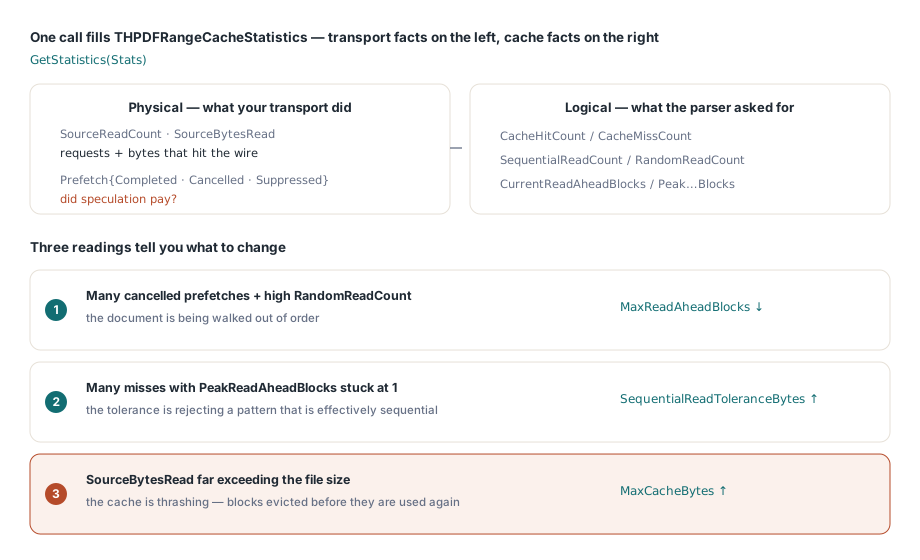
GetStatistics wypełnia rekord THPDFRangeCacheStatistics, który oddziela to, co zrobił twój transport, od tego, co zrobiła pamięć podręczna. SourceReadCount i SourceBytesRead to ruch fizyczny. CacheHitCount i CacheMissCount to ruch logiczny. SequentialReadCount i RandomReadCount pokazują, jak sklasyfikowano wzorzec dostępu, CurrentReadAheadBlocks i PeakReadAheadBlocks pokazują, jak szeroko otworzyło się okno, a cztery liczniki prefetchu pokazują, czy spekulacja się opłaciła. CachedRangeCount, CachedBytes, EvictionCount i RejectionCount opisują samą pamięć podręczną
var
  S: THPDFRangeCacheStatistics;
begin
  Cached.GetStatistics(S);
  Log(Format('physical %d reads / %d bytes, hits %d, misses %d',
    [S.SourceReadCount, S.SourceBytesRead, S.CacheHitCount, S.CacheMissCount]));
  Log(Format('pattern: %d sequential, %d random, peak window %d blocks',
    [S.SequentialReadCount, S.RandomReadCount, S.PeakReadAheadBlocks]));
  Log(Format('prefetch: %d issued, %d completed, %d canceled, %d suppressed',
    [S.PrefetchRequestCount, S.PrefetchCompletedCount,
     S.PrefetchCancelledCount, S.SuppressedPrefetchCount]));
  Log(Format('cache: %d blocks / %d bytes, %d evicted, %d rejected',
    [S.CachedRangeCount, S.CachedBytes, S.EvictionCount, S.RejectionCount]));

  // Odrzuty piętrzące się na dokumencie w większości sekwencyjnym: daj mu więcej miejsca
  if S.RejectionCount > S.CacheHitCount then
    Cached.ConfigureCacheAdmission(16 * 1024 * 1024, Cached.BlockSize, 0);
end;
Trzy odczyty mówią ci, co zmienić. Wiele anulowanych prefetchów przy wysokiej liczbie odczytów losowych znaczy, że dokument jest chodzony nie po kolei, więc obniż MaxReadAheadBlocks i przestań płacić za pasmo, które i tak wyrzucasz. Wiele chybień przy piku okna utkniętym na 1 znaczy, że tolerancja odrzuca wzorzec, który w praktyce jest sekwencyjny, więc podnieś SequentialReadToleranceBytes. SourceBytesRead daleko powyżej rozmiaru pliku znaczy, że bloki są eksmitowane, zanim zostaną użyte ponownie; podnieś MaxCacheBytes, zanim ruszysz cokolwiek innego. Próg odrzutów w przykładzie to nasza własna heurystyka startowa, więc dostrojenie jej do twojego ruchu należy do ciebie
Zlinearyzowane pliki zmieniają arytmetykę
Jeśli kontrolujesz producenta, linearyzacja dokumentu zmienia problem, zamiast go dostrajować. Aneks F ISO 32000-1 kładzie obiekty pierwszej strony i tabelę wskazówek na początku pliku, więc przeglądarka może wyrenderować stronę pierwszą z otwierających bajtów, nie dotykając reszty. HotPDF wystawia tę ścieżkę przez GetProgressiveLinearizedLoadInfo i ReadProgressiveLinearizedFirstPageSection, oba biorące ten sam THPDFRandomAccessSource, który opakowałbyś do scalania; stronę zapisu omawia artykuł o generowaniu zlinearyzowanych PDF-ów z tablicami wskazówek
Obie techniki się składają. Scalanie czyni dowolny dokument znośnym przez wolne łącze — łącznie z plikami od osób trzecich, których nie zapiszesz ponownie; linearyzacja sprawia, że pierwsza strona szybko przybywa w dokumentach, które sam produkujesz. Pliki na lokalnym dysku zbyt duże, by trzymać je w pamięci, to inny problem, bez opóźnienia podróży w obie strony do zamortyzowania, i ścieżki mapowanego pliku oraz leniwego strumienia w przepływie pracy bezpośredniego API plikowego pasują do nich lepiej
Klasy źródeł o dostępie swobodnym, opakowanie scalające, polityki przyjęć do cache i wywołania progresywnego wczytywania zlinearyzowanego przychodzą wszystkie z HotPDF — natywnego komponentu PDF dla Delphi i C++Buildera z pełnym źródłem. Licencjonowanie i pełna referencja API są na stronie komponentu HotPDF dla Delphi