Fragment strumienia treści [(Reference)-333(Manual)] TJ maluje dwa wyrazy z wyraźną przerwą między nimi, a nie zawiera w ogóle znaku spacji. Przerwa to ruch pióra: ISO 32000-1 §9.4.3 każe czytnikowi przesunąć następny glif w prawo o 333 tysięczne rozmiaru fontu, zanim narysuje Manual. Ekstraktor kopiujący znaki i ignorujący geometrię zwraca ReferenceManual, a indeks wyszukiwania karmiony z niego nigdy nie dopasuje frazy “Reference Manual”. Wyjście TeX-a, wiele plików Distillera i większość layoutów justowanych rozdzielają wyrazy tak właśnie
Końce linii zawodzą z drugiej strony. Podniesiony indeks górny rozbija swój wiersz na dwie, ukośny znak wodny DRAFT przychodzi znak na linię, a przycięty proof zaczyna się od linii slug drukarni, której żadna przeglądarka nie pokazuje. Żaden z tych plików nie jest zepsuty. Każdy używa legalnego sposobu pozycjonowania tekstu, który ekstraktor kopiujący znaki czyta źle
Spacje wyrazów odbudowane z geometrii glifów
THotPDF.ExtractLoadedPageText w HotPDF Delphi Component rozstrzyga końce wyrazów z pozycji glifów, a znak spacji w strumieniu to tylko jeden z sygnałów, które czyta. Wzdłuż kierunku pisania poprzedniego glifu mierzy odległość od końca własnej szerokości tego glifu do początku bieżącego glifu i wstawia jedną spację, gdy odległość przekracza 0.15 wysokości pudełka bieżącego glifu, mierzonej od ascendentu do descendentu w przestrzeni użytkownika. Dla fragmentu TJ wyżej jedna trzecia em siedzi wygodnie poza tą linią dla każdego zwykłego kroju tekstowego, więc tekst strony czyta Reference Manual
Dwa warunki wstrzymują spację. Nic nie jest dodawane, gdy tekst dotychczasowy kończy się już pustką albo następnym glifem jest pustka (spacja, tabulator, spacja bez łamania, spacja ideograficzna), więc producenci, którzy faktycznie pokazują spacje, nigdy nie dostają podwojonych. Nic nie jest dodawane też między dwoma znakami CJK. Ideografy, kana, hangul i formy pełnej szerokości wszystkie się liczą, bo justowanie rozciąga chińską albo japońską linię bez tego, by to rozciągnięcie znaczyło granicę wyrazu. Niezależnie od obu, pudełko glifu o zerowej wysokości schodzi na rozmiar Tf jako swoją wysokość. Każda liczba, której reguła używa, jest zapisana na rekordach glifów, więc plik, którego odstępy wyglądają źle, da się odtworzyć glif po glifie
uses
  SysUtils, HPDFDoc, HPDFContentStream;

// Wypisuje przerwy, które ExtractLoadedPageText zamieniłby na spacje.
// Tylko tekst poziomy; ExtractLoadedPageGlyphs zwraca strumień
// treści strony bez tekstu Form XObject i bez filtra crop
procedure DumpWordGaps(Pdf: THotPDF; PageIndex: Integer);
var
  Glyphs: THPDFGlyphArray;
  I: Integer;
  Height, Gap: Double;
begin
  if not Pdf.ExtractLoadedPageGlyphs(PageIndex, Glyphs) then
    Exit;
  for I := 1 to High(Glyphs) do
  begin
    if Glyphs[I].Vertical or Glyphs[I - 1].Vertical then
      Continue;
    // wysokość pudełka glifu od ascendentu do descendentu, w przestrzeni użytkownika
    Height := Sqrt(Sqr(Glyphs[I].QuadX[3] - Glyphs[I].QuadX[0]) +
      Sqr(Glyphs[I].QuadY[3] - Glyphs[I].QuadY[0]));
    if Height <= 0 then
      Height := Abs(Glyphs[I].FontSize);
    // przerwa od końca własnej szerokości poprzedniego glifu
    Gap := Glyphs[I].BaselineStartX - Glyphs[I - 1].GlyphEndX;
    if (Height > 0) and (Gap > 0.15 * Height) then
      Writeln(Format('U+%.4x gap %.2f height %.2f: space',
        [Glyphs[I].Unicode, Gap, Height]));
  end;
end;
Czemu mierzyć od własnej szerokości glifu, a nie od pozycji pióra?
Bo pozycja pióra po glifie zawiera już odstępy, które z końcami wyrazów nie mają nic wspólnego. ISO 32000-1 §9.4.4 definiuje przesunięcie poziome jako szerokość glifu razy rozmiar fontu, plus odstęp znakowy Tc, plus odstęp wyrazowy Tw, wszystko przeskalowane przez skalowanie poziome Tz. Każdy rekord glifu niesie oba końce: BaselineEndX / BaselineEndY trzymają to pełne przesunięcie, podczas gdy GlyphEndX / GlyphEndY trzymają tylko posuw fontu przy bieżącym rozmiarze i Tz. Oba rozjeżdżają się na plikach, które ściskają tracking ujemnym Tc i oddają miejsce korektą TJ po każdym glifie. Mierzone od pióra każde oddawanie wygląda jak przerwa, a chiński termin taki jak “95后” wychodzi jako “9 5 后”. Mierzone od własnej szerokości glifu korekta oddaje tylko to, co Tc zabrało, i termin pozostaje w całości
Próg jest przywiązany do wysokości pudełka glifu zamiast do rozmiaru Tf z pokrewnego powodu. Eksporty Worda często piszą 1 Tf i niosą prawdziwy rozmiar w przeskalowanym Tm, więc operand rozmiaru fontu czyta 1, podczas gdy tekst ma 10 punktów wysokości. Reguła kluczowana do tego operandu postawiłaby próg na 0.15 punktu na takiej stronie, i zwykłe pary kerningowe zaczęłyby czytać się jako końce wyrazów. Wysokość pudełka jest mierzona po zastosowaniu każdej macierzy, więc 1 Tf z przeskalowaną macierzą i zwykłe 10 Tf produkują ten sam tekst
Dwa przypadki brzegowe wynikają prosto z geometrii. Nagłówek złożony z bardzo luźnym odstępem literowym, gdzie samo Tc otwiera więcej niż 0.15 wysokości tekstu między literami, ekstrahuje się jako S P A C E D. Tak wygląda strona, a wolelibyśmy to zwrócić, niż dodać heurystykę zgadującą, które szerokie przerwy to tracking, a które to wyrazy; zgadywanka tego gatunku zaczyna połykać prawdziwe końce wyrazów w ciasno justowanych kolumnach, co dla wyszukiwania jest gorszą awarią. Kawałki rysowane poza kolejnością na jednej linii bazowej dają ujemną przerwę i sklejają się bez spacji. W biegnącym tekście głównym ten przypadek jest rzadki
Kiedy w wyekstrahowanym tekście zaczyna się nowa linia?
ExtractLoadedPageText zaczyna nową linię, gdy przesunięcie od początku poprzedniego glifu do bieżącego, rzutowane na normalną poprzedniego kierunku pisania, przekracza połowę większej wysokości pudełka z dwóch glifów. Ruch wzdłuż linii bazowej nigdy nie liczy się do końca linii, jakiekolwiek skoki robi pióro
Reguła porównująca surowy ruch Y z połową rozmiaru Tf zawodzi w dwóch kierunkach. Przy 1 Tf i przeskalowanym Tm przymka do pół jednostki, więc indeks górny podniesiony text rise 0.4 łamie linię. I drobne drganie linii bazowej, które część silników layoutu zostawia między ciągami, też. Ta sama reguła ignoruje całkiem X. Tekst pod obróconym Tm, jak ten ukośny znak wodny, schodzi po stronie z każdym glifem i wychodzi znak na linię, podczas gdy rzutowanie trzyma ciąg 45-stopniowy dokładnie jak poziomy
Branie większej z dwóch wysokości ma znaczenie, gdy rozmiary mieszają się w jednej linii. Słowo wyróżnione 36 punktów, za którym idzie podpis 8 punktów kilka punktów niżej, jest sądzone względem połowy wysokości dużego glifu, więc para zostaje razem; sądzone względem samego małego glifu podpis wylądowałby na własnej linii. Text rise jest częścią początku glifu, dlatego podniesiona linia bazowa indeksu górnego jest mierzona względem tej samej połowy wysokości
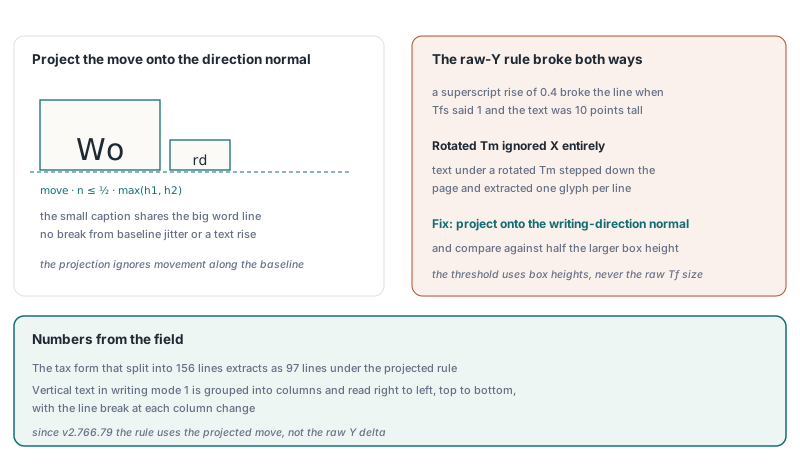
Tekst pionowy w trybie pisania 1 (§9.7.4.3) idzie osobną ścieżką. Te glify są grupowane w kolumny po swoim początku X, z połową rozmiaru fontu jako tolerancją kolumny, potem czytane z prawej do lewej i z góry na dół, z końcem linii przy każdej zmianie kolumny. Strona mieszająca pionową japońską treść z poziomym biegnącym nagłówkiem dostaje też koniec linii przy każdym przełączeniu między tymi dwoma kierunkami
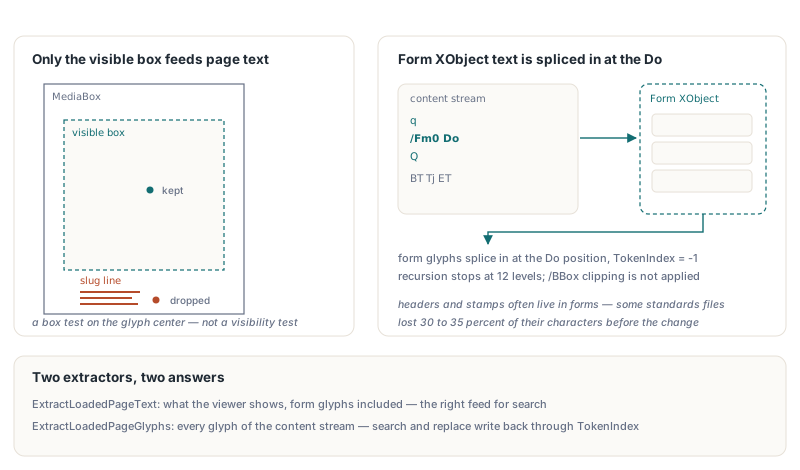
Które glify trafiają do tekstu strony
ExtractLoadedPageText zwraca tekst, jaki pokazuje przeglądarka. Zatrzymuje tylko glify, których środek pudełka wypada wewnątrz GetLoadedPageVisibleBox, czyli CropBoxa przyciętego do MediaBoxa (§14.11.2), więc linie slug i inne znaczniki drukarskie złożone jako tekst poza obszarem cięcia wypadają. ExtractLoadedPageGlyphs dalej zwraca każdy glif strumienia treści strony, linia slug wliczona, dla zadań, które go potrzebują. Filtr to test geometryczny na jednym punkcie na glif. Tekst ukryty ścieżką przycinającą, namalowany na biało albo przykryty obrazem nadal wychodzi, bo rozstrzyganie prawdziwej widoczności znaczyłoby renderowanie strony
uses
  SysUtils, HPDFDoc, HPDFContentStream;

var
  Pdf: THotPDF;
  Raw, Merged: THPDFGlyphArray;
  PageText: UnicodeString;
  L, B, R, T: Single;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('trimmed-proof.pdf');
    if Pdf.GetLoadedPageVisibleBox(0, L, B, R, T) then
      Writeln(Format('Visible box: %.1f %.1f %.1f %.1f', [L, B, R, T]));
    // każdy glif strumienia treści strony, linia slug wliczona
    if Pdf.ExtractLoadedPageGlyphs(0, Raw) then
      Writeln(Length(Raw), ' glyphs in the page content stream');
    // strumień strony plus tekst Form XObject, w kolejności malowania, przed cięciem
    if Pdf.ExtractLoadedPageGlyphsWithForms(0, Merged) then
      Writeln(Length(Merged), ' glyphs including forms');
    // to, co strona pokazuje: formy wklejone, glify poza cięciem wyrzucone
    if Pdf.ExtractLoadedPageText(0, PageText) then
      Writeln(PageText);
    // te same reguły odstępów na niefiltrowanym strumieniu, dla porównania
    Writeln(HPDFAssemblePageText(Raw));
  finally
    Pdf.Free;
  end;
end.
Tekst malowany przez Form XObjects jest częścią tekstu strony. Nagłówki, pieczątki i znaki wodne bardzo często mieszkają w formach, a ekstraktor czytający tylko strumień treści strony nigdy ich nie widzi. HotPDF zapamiętuje każde Do razem z obowiązującym CTM, interpretuje formę przy jej /Matrix razy to CTM (§8.10.1) i wkleja glify formy w miejscu Do, rekurencyjnie zchodząc do form zagnieżdżonych. Forma bez własnych /Resources pożycza te od strumienia, który ją maluje, starszego układu, który opisuje §7.8.3. Glify, których środek wypada poza /BBox formy, są zostawiane na uboczu, bo to pudełko przycina formę w chwili malowania. Forma malująca samą siebie, bezpośrednio albo przez inną formę, nie jest odwiedzana drugi raz, a zagnieżdżanie stopuje na 12 poziomach
Glify form niosą TokenIndex = -1 i ItemIndex = -1. Ten sam powód trzyma ExtractLoadedPageGlyphs przy glifach strumienia strony: szukanie, zamiana i redakcja zapisują zmiany z powrotem przez TokenIndex, a glif formy w tej tablicy wskazałby im bajty w innym strumieniu. Gdy potrzebujesz listy scalonej na poziomie glifów, ExtractLoadedPageGlyphsWithForms zwraca ją w kolejności malowania, zanim ruszy filtr widocznego pudełka
Jeszcze jedno przejście rusza przed regułami odstępów. Logotypy nadrukowane i pogrubienia udawane przez pomalowanie tego samego tekstu dwa razy z małym przesunięciem ekstraktowałyby się inaczej z każdą literą podwojoną. Gdy glif maluje ten sam znak w tym samym rozmiarze w granicach dziesiątej części tego rozmiaru wzdłuż linii bazowej i piątej w poprzek wcześniejszego glifu, zostaje tylko jedna kopia; spacje nie są nigdy usuwane tym sposobem. Ten przypadek przechodzi krok po kroku artykuł o udawanym pogrubieniu i zduplikowanych glifach w ekstrakcji tekstu
Stan tekstu przez q i Q
Tekst po Q dekoduje się źle w każdym ekstraktorze, który na q zapamiętuje tylko CTM. Parametry stanu tekstu, a więc font, rozmiar, Tc, Tw, Tz, TL, tryb renderowania i podniesienie, należą do stanu grafiki (§9.3.1), więc Q musi je przywrócić razem ze wszystkim innym na stosie (§8.4.2). Jeden wzorzec wyprowadza pomyłkę szybko: dwubajtowy font Identity-H jest wybrany wewnątrz q … Q dla pojedynczej komórki tabeli, a tekst po Q pokazuje jednobajtowe łańcuchy WinAnsi bez własnego Tf. Interpreter trzymający wewnętrzny font czyta te bajty parami, i kropki wiodące spisu treści zamieniają się w ciąg niespokrewnionych znaków CJK. Interpreter HotPDF odpycha wszystkie osiem wartości stanu tekstu razem z CTM na każdym q i zdejmuje je na każdym Q
Wszystko powyżej dotyczy każdej strony, więc cały dokument może pójść do pliku UTF-8 jednym wywołaniem. ExtractLoadedPagesTextToStream przyjmuje zakres stron liczony od 1 (pusty łańcuch znaczy każdą stronę), separator zapisywany między stronami i flagę dla znacznika kolejności bajtów, a zwraca liczbę wyekstrahowanych stron. Wyjście jest doklejane na bieżącej pozycji strumienia, więc nic większego niż tekst jednej strony nie jest trzymane w pamięci
uses
  SysUtils, Classes, HPDFDoc;

var
  Pdf: THotPDF;
  Output: TFileStream;
  Pages: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('report.pdf');
    Output := TFileStream.Create('report.txt', fmCreate);
    try
      // pusty zakres = wszystkie strony; form feed między stronami; BOM UTF-8
      Pages := Pdf.ExtractLoadedPagesTextToStream(Output, '', #12, True);
      Writeln(Pages, ' pages extracted');
    finally
      Output.Free;
    end;
  finally
    Pdf.Free;
  end;
end.
Wybór API tekstowego pod zadanie
Do szukania i indeksowania właściwym źródłem jest ExtractLoadedPageText: trzyma kolejność strumienia treści i odzwierciedla to, co strona pokazuje. Łańcuch dekodowania pod spodem, od map /ToUnicode do czcionek CID, omawia ekstrakcja tekstu z wczytanych PDF-ów w HotPDF. Kolejność strumienia treści jest najsłabsza na dokumentach otagowanych, których producent napisał biegnący nagłówek na końcu albo przeplatał dwie kolumny; dla tych ekstrakcja tekstu w kolejności struktury idzie drzewem struktury w kolejności autorstwa zamiast wnioskować ją z geometrii. Dane uwięzione w tabelach lepiej obsługuje typowana ekstrakcja tabel przez łamania stron, która zwraca komórki z ich wartościami. Kod edytujący stronę należy na ExtractLoadedPageGlyphs, którego indeksy tokenów wskazują bajty, które przepisze
Pola rekordu glifu użyte w tych przykładach, razem z resztą API ekstrakcji tekstu i buildem próbnym, są udokumentowane na stronie produktu HotPDF Delphi PDF Component