Projektant wybiera czcionkę z jednopiętrowym a do nagłówków, przekreślone zero do tabel albo zestaw kapitalików ze zdobnymi wąsami na okładkę. Te glify są już w czcionce. Po prostu nie są domyślne. Domyślne a odwzorowuje się ze znaku przez tabelę cmap na jeden glif, a wariant siedzi kilka identyfikatorów glifów dalej, osiągalny wyłącznie przez regułę podstawienia. Wyprodukowanie tego wariantu w pliku PDF oznacza odczytanie tej reguły i wyemitowanie glifu zastępczego w strumieniu treści. Ten artykuł jest o czytaniu takich reguł, tych rodzaju pojedynczego podstawienia, w Object Pascalu bez natywnej biblioteki kształtującej pod spodem
Zakres jest celowo wąski. Zestawy stylistyczne i warianty to podstawienia jeden glif na wejściu, jeden glif na wyjściu. Są tą częścią układu OpenType, którą da się rozwiązać niewielkim, deterministycznym obchodem tabel, co czyni je dobrym dopasowaniem do silnika w Pascalu, który chce pozostać wolny od zależności w C
Dlaczego czyste Delphi zamiast HarfBuzz
HarfBuzz jest oczywistą odpowiedzią na „ukształtuj ten tekst”, a dla pełnego kształtowania dwukierunkowego, indyjskiego czy arabskiego jest odpowiedzią właściwą. Jest też biblioteką w C. Wpięcie go w produkt w Delphi albo C++Builder oznacza dostarczanie natywnego pliku dla każdej platformy i architektury docelowej, dopasowanie jego konwencji wywołań, pilnowanie jego rytmu wydań i czytanie jego warunków licencji względem własnych. Żadna z tych rzeczy nie jest trudna z osobna. Wszystkie razem to tarcie, które nigdy nie znika, i nie daje niczego, gdy faktycznym wymaganiem jest „daj mi formę ss01 tej litery”
Pojedyncze podstawienie nie potrzebuje silnika kształtującego. Potrzebuje parsera garści formatów podtabel GSUB i jednego czy dwóch wyszukiwań binarnych. Napisanie tego w Pascalu trzyma cały łańcuch narzędziowy wewnątrz jednego kompilatora. Uczciwym ograniczeniem jest to, że takie podejście obsługuje wyszukiwania podstawień glifów i nic więcej. To nie jest rozstrzyganie bidi, to nie jest zmiana kolejności w pismach indyjskich i to nie jest automatyczne kształtowanie kontekstowe. Tam, gdzie te rzeczy są potrzebne, są potrzebne, a zapytanie o pojedyncze podstawienie ich nie zastąpi
Hierarchia GSUB od góry do dołu
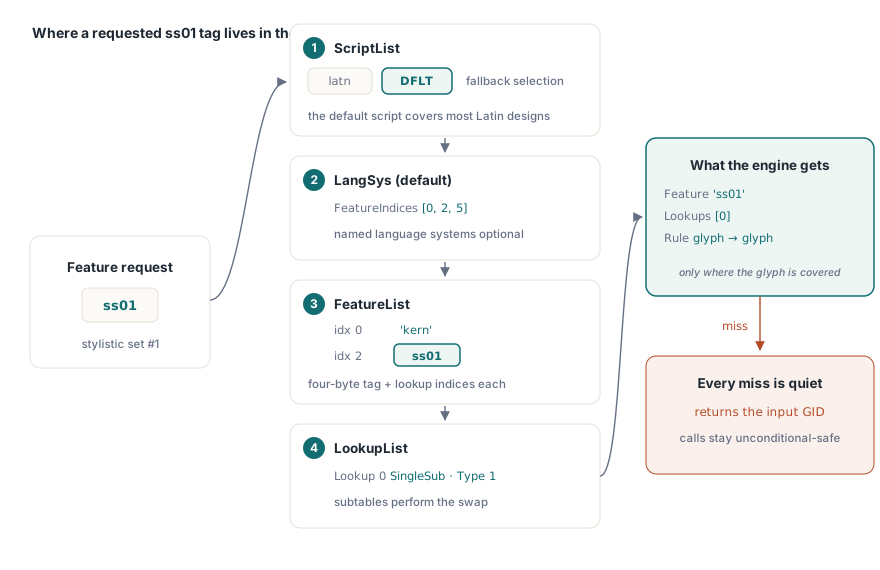
Tabela podstawień glifów jest zorganizowana jako łańcuch pośrednictw, a zapytanie o podstawienie idzie tym łańcuchem od góry. Na szczycie jest ScriptList. Znacznik pisma taki jak latn wybiera wpis, a specjalny znacznik DFLT to pismo domyślne stosowane, gdy nic bardziej szczegółowego nie pasuje. Wpis pisma wskazuje LangSys, czyli system językowy, z domyślnym LangSys na przypadek powszechny i opcjonalnymi nazwanymi dla języków wymagających innego zachowania. Turecki jest typowym przykładem, gdzie i z kropką i bez kropki domagają się własnej obsługi
LangSys nazywa zbiór indeksów funkcji. Każdy indeks wskazuje do FeatureList, gdzie rekord funkcji niesie czterobajtowy znacznik, w tym ss01, oraz listę indeksów wyszukiwań. Te indeksy wskazują wreszcie do LookupList, gdzie mieszkają właściwe podtabele podstawień. Rozwiązanie ss01 oznacza więc: znajdź pismo, znajdź jego LangSys, znajdź funkcję o znaczniku ss01, zbierz nazwane przez nią wyszukiwania i zastosuj je. HotPDF domyślnie bierze pismo DFLT i domyślny LangSys, czyli to, co dostarcza zdecydowana większość projektów tekstu łacińskiego, i udostępnia sposób nadpisania znacznika pisma, gdy czcionka wpina swoje funkcje pod konkretne pismo
O tym, kto bierze udział, decydują tabele pokrycia
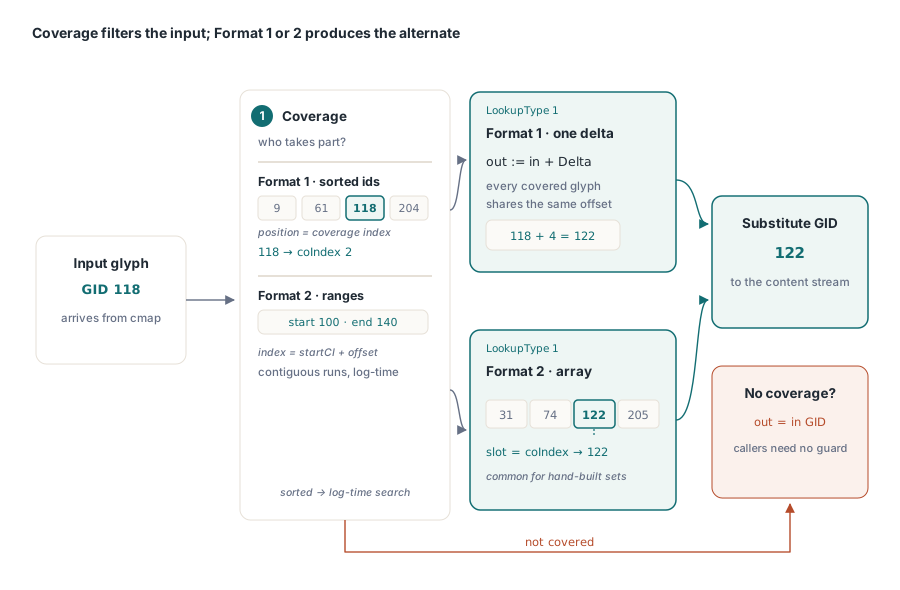
Każda podtabela podstawienia zaczyna się tym samym pytaniem: czy ten glif wejściowy bierze udział w tej regule, a jeśli tak, gdzie siedzi we własnym indeksowaniu tej reguły. Na to pytanie odpowiada tabela pokrycia, a odpowiedzią jest indeks pokrycia, mała liczba porządkowa, której reszta podtabeli używa, by sprawdzić, w co glif się zamienia
Pokrycie występuje w dwóch formatach. Format 1 to lista identyfikatorów glifów posortowana rosnąco. Glif znajdujesz wyszukiwaniem binarnym, a jego pozycja na liście jest jego indeksem pokrycia. Format 2 to lista rekordów zakresów, każdy z glifem początkowym, glifem końcowym i indeksem pokrycia, na który odwzorowuje się glif początkowy. Glif wewnątrz zakresu dostaje swój indeks pokrycia przez odsunięcie od początku zakresu. Format 1 jest zwarty, gdy uczestniczące glify są rozproszone, a Format 2, gdy układają się w ciągłe pasma. Oba są posortowane, więc oba przeszukuje się w czasie logarytmicznym i oba zwracają albo indeks pokrycia, albo czyste „bez pokrycia”, które pozwala silnikowi zostawić glif w spokoju
Pojedyncze podstawienie, dwa formaty
Pojedyncze podstawienie to LookupType 1 i odwzorowuje jeden glif na dokładnie jeden zamiennik. Ono też ma dwa formaty, a ten podział jest optymalizacją miejsca. Format 1 przechowuje pojedynczą deltę ze znakiem. Identyfikator glifu wyjściowego to identyfikator glifu wejściowego plus ta delta, modulo 65536. Tak czcionka koduje podstawienie, w którym każdy uczestniczący glif siedzi w tym samym stałym odstępie od swojego wariantu, na przykład blok cyfr wersalikowych umieszczony w stałej odległości od odpowiadających im cyfr mediewalowych. Tabela pokrycia mówi, które glify się kwalifikują, a jedna delta obsługuje je wszystkie
Format 2 przechowuje jawną tablicę identyfikatorów glifów zastępczych. Indeks pokrycia z tabeli pokrycia jest indeksem do tej tablicy, więc glif o indeksie pokrycia 0 staje się pierwszym wpisem tablicy, indeks pokrycia 1 drugim i tak dalej. Formatu 2 używa się, gdy warianty nie leżą w jednolitym odstępie, co jest powszechnym przypadkiem ręcznie budowanych zestawów stylistycznych. Z punktu widzenia wywołującego zapytanie jest tak czy inaczej takie samo. Weź glif wejściowy, przepuść go przez pokrycie, a jeśli jest pokryty, zastosuj deltę albo odczytaj gniazdo tablicy
var
  Pdf: THotPDF;
  BaseGID, AltGID: Word;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.BeginDoc;
    Pdf.RegisterUnicodeTTF('C:\Fonts\MyStylisticFace.ttf');
    Pdf.SetFont('My Stylistic Face', 12, []);

    // Domyślny glif dla 'a' przez tabelę cmap czcionki.
    BaseGID := Pdf.GetUnicodeGlyphForCodepoint(Ord('a'));

    // Zestaw stylistyczny 1: rozwiąż wariant przez GSUB LookupType 1.
    AltGID := Pdf.GetSingleSubstituteGlyph(BaseGID, 'ss01');

    // AltGID = BaseGID oznacza, że funkcja nie dotknęła tego glifu.
    if AltGID <> BaseGID then
      { wyemituj AltGID w strumieniu treści };
  finally
    Pdf.Free;
  end;
end;
Kontraktem wartym zauważenia jest przepuszczanie. GetSingleSubstituteGlyph zwraca niezmieniony identyfikator glifu wejściowego przy każdym chybieniu: brak czcionki, brak tabeli GSUB, brak pasującej funkcji, brak trafienia w pokrycie. Oznacza to, że wywołanie jest bezpieczne bezwarunkowo. Prosisz o wariant, a jeśli go nie ma, dostajesz z powrotem dokładnie to, co włożyłeś, więc kod wywołujący nigdy nie musi obsługiwać osobnego przypadku czcionki bez tej funkcji
Co znaczą znaczniki funkcji stylistycznych
Znacznik funkcji to całe słownictwo tego, o który wariant prosisz, a znaczniki istotne dla pracy stylistycznej to krótka lista. Para wiodąca to salt, czyli warianty stylistyczne, uniwersalny dostęp do alternatywnych form glifu, oraz ss01 do ss20, czyli dwadzieścia numerowanych zestawów stylistycznych, które czcionka może zdefiniować, każdy jako nazwana wiązka podstawień zgrupowana przez projektanta. Czcionka może na przykład umieścić jednopiętrowe a i R z prostą nogą pod ss03, więc włączenie tego jednego zestawu przestylizuje oba
Wokół nich siedzi jeszcze kilka znaczników pojedynczego podstawienia. aalt to dostęp do wszystkich wariantów, suma każdego wariantu, jaki glif posiada, zwykle przedstawiana jako funkcja palety glifów. titl wybiera wersaliki tytułowe cięte pod duże stopnie pisma. subs i sups podmieniają prawdziwe cyfry w indeksie dolnym i górnym zamiast pomniejszonych domyślnych. ordn produkuje formy porządkowe, czyli podniesione litery w 1st i 2nd. frac buduje ułamki, choć pełne ułamki ukośne opierają się też na logice ligatur i kontekstu wykraczającej poza zwykłe pojedyncze podstawienie. Dla przypadków jednoglifowych mechanizm jest identyczny jak przy ss01: podaj znacznik do zapytania o podstawienie i odczytaj wariant glifu
// Spróbuj funkcji zestawu stylistycznego, potem przejdź na zwykłe warianty.
function ResolveAlternate(Pdf: THotPDF; BaseGID: Word;
  const PreferredTag: AnsiString): Word;
begin
  Result := Pdf.GetSingleSubstituteGlyph(BaseGID, PreferredTag);
  if Result = BaseGID then
    Result := Pdf.GetSingleSubstituteGlyph(BaseGID, 'salt');
  // Nadal BaseGID, jeśli żadna z funkcji nie pokrywa tego glifu.
end;
cmap w formacie 12 i płaszczyzny uzupełniające
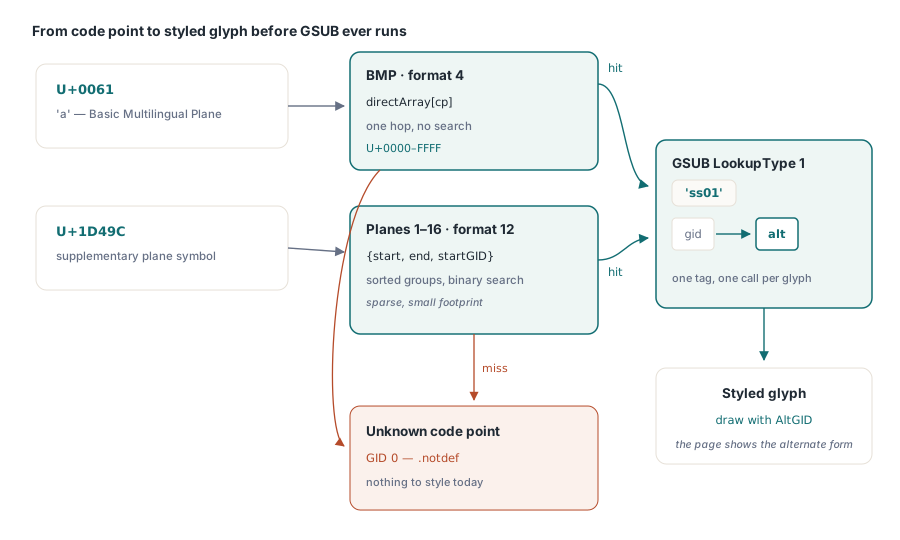
Zanim jakiekolwiek podstawienie ruszy, znak musi stać się glifem, a to zadanie tabeli cmap. Zapytanie o podstawienie startuje od identyfikatora glifu, więc droga zawsze biegnie od znaku do glifu przez cmap, a potem od glifu do wariantu przez GSUB. Ciekawy w cmap jest jej zasięg. Podtabela w formacie 4 pokrywa podstawową płaszczyznę wielojęzyczną, czyli pierwsze 65536 punktów kodowych, i to wystarcza dla większości tekstu łacińskiego. Nie wystarcza dla punktów kodowych od U+10000 w górę, czyli płaszczyzn uzupełniających, gdzie mieszkają dziś matematyczne znaki alfanumeryczne, wiele symboli i kilka żywych pism
Format 12 to podtabela pokrywająca pełny zakres od U+0000 do U+10FFFF. To posortowana lista grup, z których każda ma początkowy punkt kodowy, końcowy punkt kodowy i początkowy identyfikator glifu, więc ciągłe pasmo punktów kodowych odwzorowuje się na ciągłe pasmo glifów. HotPDF rozwiązuje punkty kodowe strategią hybrydową dopasowaną do kształtu tych danych. Punkty kodowe w BMP obsługuje bezpośrednia tablica indeksowana punktem kodowym, jedno sprawdzenie bez żadnego wyszukiwania. Punkty kodowe w płaszczyznach uzupełniających obsługuje rzadka tabela posortowana po punkcie kodowym i przeszukiwana binarnie. W efekcie GetUnicodeGlyphForCodepoint przyjmuje pełny Cardinal i odpowiada poprawnie w całym zakresie, zwracając identyfikator glifu 0, czyli glif .notdef, dla każdego punktu kodowego, którego czcionka nie odwzorowuje
var
  Pdf: THotPDF;
  Cp: Cardinal;
  GID, StyledGID: Word;
begin
  // Punkt kodowy z płaszczyzny uzupełniającej: U+1D49C MATHEMATICAL SCRIPT CAPITAL A.
  Cp := $1D49C;
  GID := Pdf.GetUnicodeGlyphForCodepoint(Cp);  // wyszukiwanie w formacie 12
  if GID <> 0 then
    StyledGID := Pdf.GetSingleSubstituteGlyph(GID, 'ss01')
  else
    StyledGID := 0;  // czcionka nie ma glifu dla tego punktu kodowego
end;
Gdzie te zapytania się kończą
API pojedynczego podstawienia odpowiada na jeden kształt pytania, a warto jasno powiedzieć, na co nie odpowiada. LookupType 1 jest jednym z ośmiu typów podstawień. Zapytanie nie obsługuje LookupType 2, czyli podstawienia wielokrotnego, gdzie jeden glif staje się kilkoma, ani LookupType 4, czyli podstawienia ligaturowego, gdzie kilka glifów staje się jednym. Nie obsługuje typów kontekstowych i kontekstowo-łańcuchowych, LookupType 5 i 6, które odpalają wyłącznie wtedy, gdy glif pojawia się w konkretnym sąsiedztwie, ani typów rozszerzeniowych i odwrotnie łańcuchowych. Ułamek ukośny, zbitka spółgłoskowa w dewanagari albo arabska kaskada początkowa-środkowa-końcowa to problemy sekwencji, a wyszukiwanie pojedynczego podstawienia glif po glifie nie potrafi ich wyrazić
Nie wykonuje też automatycznego kształtowania. Nic tutaj nie ogląda przebiegu tekstu, nie decyduje, które funkcje włączyć, ani nie stosuje ich w kolejności wymaganej przez pismo. To wywołujący wybiera znacznik funkcji i stosuje go glif po glifie. To dokładnie właściwe narzędzie dla zestawów stylistycznych i wariantów, które są opcjonalne i lokalne, i dokładnie niewłaściwe narzędzie dla pisma wymagającego zmiany kolejności. Trzymanie tej granicy ostro jest tym, co pozwala ścieżce podstawień pozostać małą i przewidywalną
Dla przypadków, które naprawdę wymagają pracy na poziomie sekwencji, opowieść o pismach złożonych podejmuje nasz artykuł o kształtowaniu tekstu pism złożonych w Delphi. Jeśli twoje podstawienia są częścią większego zadania raportowego, które umieszcza na stronie także obrazy i inne czcionki, przewodnik po wyjściu raportów z czcionkami i obrazami opisuje, jak te elementy do siebie pasują. Wszystko to działa na tym samym silniku, komponencie HotPDF dla Delphi oraz C++Builder, który niesie zapytania o podstawienia GSUB obok API osadzania czcionek, tworzenia podzbiorów i tekstu omawianych gdzie indziej na tym blogu