Warstwy tekstu OCR, granice kodów kreskowych i boxy zacierania twarzy dryfują na przyciętych stronach PDF, gdy piksele bitmapy są mapowane z powrotem przez MediaBox zamiast przez box, który renderer faktycznie zrastryzował: CropBox przycięty do MediaBoxa (ISO 32000-1 §14.11.2). HotPDF mapuje wyniki ApplyLoadedOCRTextLayer, DecodeLoadedPageBarcodes i DetectLoadedRedactionFindings przez ten widoczny box, i każdy własny engine czy detektor, którego napiszesz, musi zrobić to samo
Symptom łatwo rozpoznać, gdy raz go widziałeś. Zeskanowane archiwum umów przechodzi przez potok OCR, wyjście jest przeszukiwalne, a trafienie wyszukiwania dla numeru paragrafu podświetla się pół cala poniżej i na lewo od wydrukowanego numeru. Większość plików w partii jest w porządku. Te przesunięte wszystkie przyszły z jednej stacji skanującej, która zapisuje /CropBox, żeby ściąć margines płyty. Ten jeden szczegół rozdziela obraz, który widział engine OCR, od ramki, w której osadzono warstwę tekstu, a ta sama niezgodność przesuwa granice kodów kreskowych i, poważniej, boxy zacierania twarzy
Dlaczego warstwa tekstu OCR odjeżdża od zeskanowanych słów?
Warstwa tekstu odjeżdża, gdy dwie połówki potoku nie zgadzają się, który prostokąt pokrywa bitmapa. Renderowanie HotPDF, eksport SVG, przeglądarka i drukowanie honorują wszystkie CropBox: strona jest wyświetlana przez swój CropBox przycięty do MediaBoxa, co nakazuje ISO 32000-1 §14.11.2, i GetLoadedPageVisibleBox zwraca ten widoczny box. Transformacja urządzenie–strona zbudowana z GetLoadedPageBox(PageIndex, pbMediaBox, ...) zakłada zamiast tego, że raster pokrywa MediaBox, więc raster i transformacja opisują różne prostokąty, a każda rozpoznana pozycja wraca przesunięta o szczelinę między nimi
Dobranie tego do siebie oznacza utrzymywanie w zgodzie trzech rzeczy dla każdej funkcji rozpoznawania: transformacji, szacunku budżetu pikseli i boxa strony wręczanego własnemu engine'owi w rekordzie żądania. HotPDF wyprowadza wszystkie trzy z widocznego boxa, co przy okazji oznacza, że rozpoznawanie widzi tylko treść, którą przeglądarki faktycznie pokazują
Kilka przypadków jest odpornych na tę niezgodność:
- Strony bez
/CropBoxalbo o CropBoxie równym MediaBoxowi mapują się identycznie przez oba boxy DecodeLoadedPageBarcodesz ustawionymHasRegionrenderuje dokładnie region, który podasz, i mapuje przez ten sam region; sprawdzenie, że region leży wewnątrz strony, używa MediaBoxa- Wyniki zacierania oparte na wzorcach (e-maile, numery kart i tak dalej) pochodzą z ekstrakcji tekstu w przestrzeni użytkownika, nie z rastra, więc od mapowania rastra zależą tylko wyniki detekcji twarzy
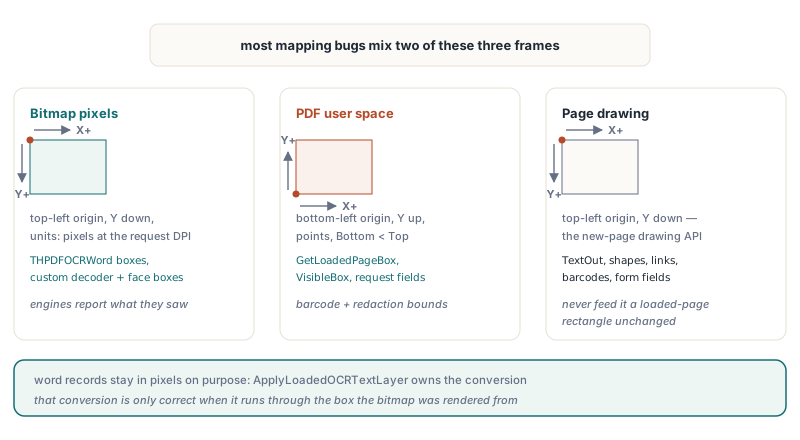
Trzy układy współrzędnych i których API HotPDF używa każdego
Kod dotykający rozpoznawania w HotPDF operuje na trzech układach, a większość błędów mapowania bierze się ze zmieszania dwóch z nich
- Piksele bitmapy: początek lewy górny, Y rośnie w dół, jednostką są piksele przy żądanym DPI.
THPDFOCRWord.Left,Top,RightiBottomsą w tym układzie, tak samo opcjonalne punkty linii bazowej, wyniki, które zwraca własnyIHPDFBarcodeDecoder, i boxy od własnegoIHPDFFaceDetector - Przestrzeń użytkownika PDF wczytanej strony: początek lewy dolny, Y rośnie w górę, jednostką są punkty, z
Bottom < Top.GetLoadedPageBoxiGetLoadedPageVisibleBoxzwracają Left, Bottom, Right, Top w tym układzie, podobnie polaPageLeft,PageBottom,PageRightiPageTopwTHPDFOCRRequest, granice wTHPDFDecodedBarcodei prostokąty wTHPDFRedactionFinding - Współrzędne rysowania stron HotPDF: API, którym budujesz nowe strony (tekst, kształty, kody kreskowe, linki, pola formularzy), pracuje z początkiem lewym górnym i Y rosnącym w dół. Ten układ należy do generowania dokumentów i nie ma nic wspólnego z powyższymi API dokumentów wczytanych, więc nigdy nie podawaj mu prostokąta w przestrzeni użytkownika strony wczytanej bez zmian
Rekord słowa OCR jest celowo pikselowy: engine raportuje to, co widział na obrazie, a konwersją rządzi ApplyLoadedOCRTextLayer. Ten podział działa tylko wtedy, gdy konwersja używa właściwego boxa — dlatego HotPDF buduje go z widocznego boxa
Transformacja urządzenie–strona stojąca za OCR, kodami i twarzami
HotPDF mapuje piksele bitmapy na stronę jedną macierzą afiniczną zbudowaną z pięciu wejść: obrotu, skali DPI / 72, wysokości bitmapy oraz Left, Bottom, Right i Top wyrenderowanego boxa. OCR, dekodowanie kodów kreskowych i detekcja twarzy dzielą na to jedną rutynę, więc wejście boxa rozstrzyga naraz o dokładności wszystkich trzech. Dla strony bez obrotu macierz strona–urządzenie [A B C D E F] to:
A = ScaleiD = -Scale, gdzieScale = DPI / 72; ujemneDprzewraca przestrzeń użytkownika (Y w górę) w przestrzeń bitmapy (Y w dół)B = C = 0, bo strona bez obrotu nie ma ścinania ani zamiany osiE = -Left * Scale, co przenosi lewą krawędź boxa na kolumnę pikseli 0F = BitmapHeight + Bottom * Scale, co mapuje dolną krawędź boxa na y = BitmapHeight, dolną krawędź bitmapy, więc górna krawędź ląduje na wierszu 0
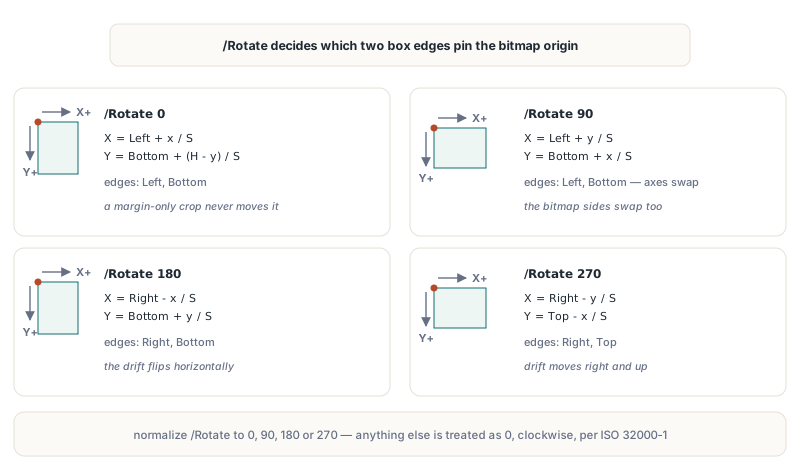
Piksele wracają na stronę przez odwrotność tej macierzy. Request.PageRotation niesie /Rotate strony znormalizowane do 0, 90, 180 albo 270 (każda wartość niebędąca wielokrotnością 90 jest traktowana jako 0), a renderer obraca stronę zgodnie z ruchem wskazówek zegara, jak wymaga ISO 32000-1 §7.7.3.3. Przy obrocie osie się zamieniają i inna para krawędzi boxa jest przypięta do początku bitmapy. Zapisane jako formuły odwrotne, przy S = DPI / 72, x i y w pikselach i H wysokości bitmapy:
| /Rotate | X strony | Y strony | Krawędzie boxa, od których zależy mapowanie |
|---|---|---|---|
| 0 | Left + x / S | Bottom + (H - y) / S | Left, Bottom |
| 90 | Left + y / S | Bottom + x / S | Left, Bottom |
| 180 | Right - x / S | Bottom + y / S | Right, Bottom |
| 270 | Right - y / S | Top - x / S | Right, Top |
Ostatnia kolumna wyjaśnia, dlaczego mapowanie oparte na MediaBoxie wygląda na losowe w produkcji. CropBox ścinający tylko górę strony zostawia Left i Bottom nietknięte, więc strony w pionie wychodzą idealnie, a dryfują tylko strony niosące /Rotate 270. Obrót przy okazji zamienia wymiary bitmapy: przy 90 i 270 bitmapa jest szeroka na (Top - Bottom) * S pikseli i wysoka na (Right - Left) * S pikseli
Co się psuje przy MediaBox [0 0 612 792] i CropBox [36 36 576 756]?
Przy półcalowym ścinaniu z każdej strony warstwa tekstu strony bez obrotu ląduje dokładnie 36 punktów na lewo i 36 punktów poniżej zeskanowanych słów, gdy użyto MediaBoxa. Weźmy stronę US Letter, której CropBox ścina 36 punktów (0,5 cala) z każdej krawędzi. Widoczny box to 540 na 720 punktów, więc przy domyślnej rozdzielczości OCR 300 DPI skala wynosi 300 / 72 ≈ 4,1667, a bitmapa 2250 na 3000 pikseli
Załóżmy, że engine raportuje słowo z pikselowym boxem Left 450, Top 600, Right 900, Bottom 660 i bez linii bazowej. HotPDF kładzie potem linię bazową 20 procent wysokości słowa nad dolną krawędzią, w wierszu pikseli 648, i mapuje punkt startowy (450, 648):
- Przez widoczny box: x = 36 + 450 / 4,1667 = 144,0 i y = 36 + (3000 - 648) / 4,1667 = 600,48, czyli tam, gdzie słowo jest wydrukowane
- Przez MediaBox: x = 0 + 108,0 = 108,0 i y = 0 + 564,48 = 564,48 — równomierne przesunięcie o (-36, -36) punktu
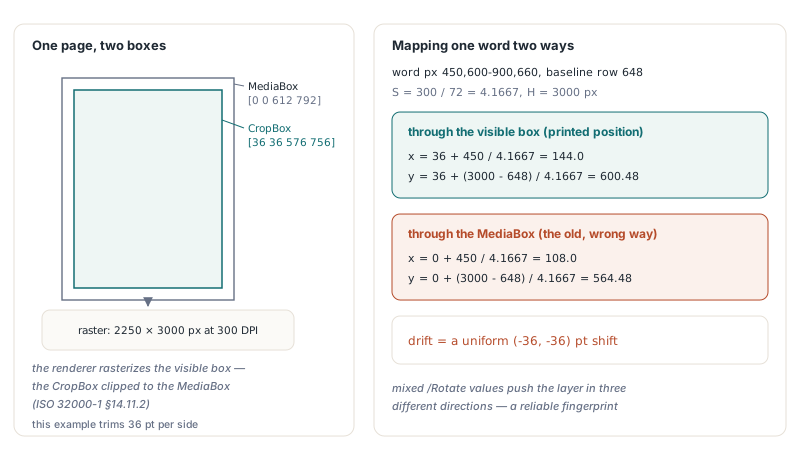
Obróć tę samą stronę, a kierunek błędu się zmienia, bo w grę wchodzą inne krawędzie. Przy /Rotate 180 składnik X używa Right, a 612 zamiast 576 pcha warstwę 36 punktów w prawo, podczas gdy Bottom wciąż ciągnie ją 36 punktów w dół. Przy /Rotate 270 i Right, i Top są za duże, więc warstwa przesuwa się 36 punktów w prawo i 36 punktów w górę. Dokument o mieszanych orientacjach potrafi pokazać dryf w trzech kierunkach — pewny odcisk palca tej pomyłki. Kod pisany ręcznie, który wyprowadza skalę z boxa, jak Bitmap.Width / (Right - Left), rozciąga przy okazji każdą współrzędną o 612 / 540, czyli grubo 13 procent, do tego przesunięcia
Które strony PDF potrzebują mapowania świadomego CropBoxa?
Dokument PDF wymaga uwagi, gdy przynajmniej jedna strona ma widoczny box różny od swojego MediaBoxa, a HotPDF powie ci to w kilku liniach. Porównaj GetLoadedPageBox z pbMediaBox względem GetLoadedPageVisibleBox dla każdej strony i wypisz obok GetLoadedPageRotation, żebyś mógł przewidzieć kierunek dryfu z tabeli powyżej. THPDFPageBoundary oferuje też pbCropBox, pbBleedBox, pbTrimBox i pbArtBox, ale GetLoadedPageBox(pbCropBox) cofa się do MediaBoxa, gdy crop boxa nie ma, i nie przycina, więc widoczny box to właściwy punkt odniesienia
uses
  System.SysUtils, HPDFDoc;

procedure ReportCroppedPages(const FileName: string);
var
  Pdf: THotPDF;
  I: Integer;
  ML, MB, MR, MT, VL, VB, VR, VT, Tmp: Single;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile(FileName) < 1 then
      raise Exception.Create('Cannot load ' + FileName);
    for I := 0 to Pdf.LoadedPageCount - 1 do
    begin
      if not Pdf.GetLoadedPageBox(I, pbMediaBox, ML, MB, MR, MT) then
        Continue;
      // zapisana tablica może wypisać swoje narożniki w dowolnej kolejności
      if MR < ML then begin Tmp := ML; ML := MR; MR := Tmp; end;
      if MT < MB then begin Tmp := MB; MB := MT; MT := Tmp; end;
      // już znormalizowany i przycięty do MediaBoxa
      if not Pdf.GetLoadedPageVisibleBox(I, VL, VB, VR, VT) then
        Continue;
      if (Abs(VL - ML) > 0.01) or (Abs(VB - MB) > 0.01) or
         (Abs(VR - MR) > 0.01) or (Abs(VT - MT) > 0.01) then
        Writeln(Format('Page %d  MediaBox [%g %g %g %g]  visible [%g %g %g %g]  /Rotate %d',
          [I + 1, ML, MB, MR, MT, VL, VB, VR, VT,
           Pdf.GetLoadedPageRotation(I)]));
    end;
  finally
    Pdf.Free;
  end;
end;
Dwa szczegóły GetLoadedPageVisibleBox mają znaczenie dla skryptów takich jak ten. Funkcja zostawia swoje parametry out nietknięte, gdy zawodzi, więc wcześniejsze ustawienie domyślnego rozmiaru strony przed wywołaniem to bezpieczny wzorzec. A gdy zniekształcony CropBox w ogóle nie przecina MediaBoxa, funkcja zwraca MediaBox zamiast pustego prostokąta. Jeśli raport wypisze strony, które wcześniejszy potok przepuścił przez OCR z mapowaniem opartym na MediaBoxie, pamiętaj, że zapisana warstwa tekstu zostaje w zapisanym pliku: domyślna opcja SkipPagesWithText pominie te strony przy drugim przebiegu, dopóki jej nie wyłączysz albo nie usuniesz najpierw starej warstwy
Jak własny IHPDFOCREngine powinien mapować piksele z powrotem do przestrzeni PDF?
Własny IHPDFOCREngine powinien zwracać boxy słów w pikselach bitmapy i zostawić mapowanie HotPDF; przeliczaj do przestrzeni użytkownika tylko na własne decyzje, a wtedy używaj boxa z żądania, nigdy MediaBoxa. Pola żądania PageLeft, PageBottom, PageRight i PageTop opisują wyrenderowany widoczny box, więc pasują do Request.Bitmap dokładnie. Helper poniżej to odwrotność transformacji biblioteki, łącznie z użyciem rzeczywistej wysokości bitmapy dla stron w pionie, więc zgadza się z HotPDF co do piksela
uses
  System.SysUtils, System.Math, Vcl.Graphics, HPDFDoc;

// Piksel bitmapy (początek lewy górny, Y w dół) do przestrzeni użytkownika PDF
// (początek lewy dolny, Y w górę), przez box, z którego bitmapa została wyrenderowana
procedure HotPixelToPage(Rotation, DPI, BitmapHeight: Integer;
  Left, Bottom, Right, Top: Single; X, Y: Double;
  out PageX, PageY: Double);
var
  S: Double;
begin
  S := DPI / 72.0;
  case Rotation of
    90:  begin PageX := Left + Y / S;  PageY := Bottom + X / S; end;
    180: begin PageX := Right - X / S; PageY := Bottom + Y / S; end;
    270: begin PageX := Right - Y / S; PageY := Top - X / S; end;
  else
    PageX := Left + X / S;
    PageY := Bottom + (BitmapHeight - Y) / S;
  end;
end;
Realistyczny powód, by potrzebować przestrzeni użytkownika wewnątrz engine'a, to reguła stref: faktury, których papieru firmowego nigdy nie chcesz przeszukiwalnego, albo pole pieczątki, które myli rozpoznawacz. Engine poniżej, napisany na TInterfacedObject, żeby licznikiem referencji zajął się jego czas życia, filtruje słowa według tego, gdzie padają ich środki na stronie, po czym zwraca ocalałe nietknięte we współrzędnych pikselowych. RunRecognizer zastępuje wywołanie twojego własnego rozpoznawacza
type
  TZoneFilterOCREngine = class(TInterfacedObject, IHPDFOCREngine)
  private
    FSkipLeft, FSkipBottom, FSkipRight, FSkipTop: Single;  // przestrzeń użytkownika
    function RunRecognizer(Bitmap: TBitmap; MaxWords: Integer;
      out Words: THPDFOCRWords): boolean;  // twój rozpoznawacz, boxy pikselowe
  public
    constructor Create(SkipLeft, SkipBottom, SkipRight, SkipTop: Single);
    function GetName: AnsiString;
    function Recognize(const Request: THPDFOCRRequest;
      out Words: THPDFOCRWords; out Diagnostic: AnsiString): boolean;
  end;

function TZoneFilterOCREngine.Recognize(const Request: THPDFOCRRequest;
  out Words: THPDFOCRWords; out Diagnostic: AnsiString): boolean;
var
  Raw: THPDFOCRWords;
  I, Count: Integer;
  CX, CY: Double;
begin
  Diagnostic := '';
  SetLength(Words, 0);
  if not RunRecognizer(Request.Bitmap, Request.MaxWords, Raw) then
  begin
    Diagnostic := 'recognizer failed';
    Exit(False);
  end;
  SetLength(Words, Length(Raw));
  Count := 0;
  for I := 0 to High(Raw) do
  begin
    HotPixelToPage(Request.PageRotation, Request.DPI,
      Request.Bitmap.Height, Request.PageLeft, Request.PageBottom,
      Request.PageRight, Request.PageTop,
      (Raw[I].Left + Raw[I].Right) / 2, (Raw[I].Top + Raw[I].Bottom) / 2,
      CX, CY);
    if (CX >= FSkipLeft) and (CX <= FSkipRight) and
       (CY >= FSkipBottom) and (CY <= FSkipTop) then
      Continue;
    Words[Count] := Raw[I];  // wciąż piksele: HotPDF mapuje je sam
    Inc(Count);
  end;
  SetLength(Words, Count);
  Result := True;
end;
Przekaż engine do ApplyLoadedOCRTextLayer(PageIndices, Engine, Options, Info) jak każdy inny. Biblioteka waliduje to, co wraca, zanim jej zaufa: słowo jest upuszczane i liczone w Info.DroppedWordCount, gdy jego box wychodzi z bitmapy, gdy Right <= Left albo Bottom <= Top, albo gdy Confidence jest poza 0..1 albo poniżej MinimumConfidence. Zwrócenie więcej słów niż MaxWordsPerPage albo przepchnięcie biejącej sumy poza MaxTotalWords wywala całe wywołanie błędem budżetu, więc respektuj Request.MaxWords w engine'ie. Nie przeliczaj boxów słów do przestrzeni użytkownika przed ich zwróceniem; HotPDF wziąłby wartości punktowe za piksele i warstwa zapadłaby się w stronę początku bitmapy
Mapowanie wyjścia własnego detektora
Ten sam helper obsłuży domowy potok zbudowany na RenderLoadedPageToBitmap, który renderuje widoczny box i stosuje /Rotate dokładnie tak jak funkcje rozpoznawania. Przeczytaj box przez GetLoadedPageVisibleBox, znormalizuj obrót tak samo jak HotPDF i zmapuj dwa przeciwległe narożniki każdego pikselowego boxa. Oś Y się odwraca, a przy 90 i 270 stopniach osie się zamieniają, więc zmapowane narożniki wychodzą w żadnej stałej kolejności; weź minimum i maksimum zmapowanych punktów — tak samo HotPDF buduje granice kodów kreskowych
const
  DPI = 200;
var
  Pdf: THotPDF;
  Bmp: TBitmap;
  VL, VB, VR, VT: Single;
  Rotation: Integer;
  PxL, PxT, PxR, PxB, X1, Y1, X2, Y2: Double;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('scanned-ids.pdf');
    if not Pdf.GetLoadedPageVisibleBox(0, VL, VB, VR, VT) then Exit;
    Rotation := Pdf.GetLoadedPageRotation(0) mod 360;
    if Rotation < 0 then Inc(Rotation, 360);
    if (Rotation <> 90) and (Rotation <> 180) and (Rotation <> 270) then
      Rotation := 0;
    Bmp := Pdf.RenderLoadedPageToBitmap(0, DPI);
    if Bmp = nil then Exit;
    try
      MyDetector(Bmp, PxL, PxT, PxR, PxB);  // twój kod, box pikselowy
      HotPixelToPage(Rotation, DPI, Bmp.Height, VL, VB, VR, VT,
        PxL, PxT, X1, Y1);
      HotPixelToPage(Rotation, DPI, Bmp.Height, VL, VB, VR, VT,
        PxR, PxB, X2, Y2);
      Writeln(Format('User-space box [%.2f %.2f %.2f %.2f]',
        [Min(X1, X2), Min(Y1, Y2), Max(X1, X2), Max(Y1, Y2)]));
    finally
      Bmp.Free;
    end;
  finally
    Pdf.Free;
  end;
end;
Zachowanie przy obrocie jest opisane głębiej w spłaszczaniu obrotu strony bez psucia boxów stron, a potok dekodowania kodów kreskowych, który zjada tę samą transformację, w dekodowaniu obróconych kodów QR ze stron PDF. Jeśli twój engine opakowuje zewnętrzny rozpoznawacz, adapter Tesseract OCR dla przeszukiwalnego PDF pokazuje stronę izolacji procesów i anulowania tego samego interfejsu
Ściąga: mapowanie współrzędnych bezpieczne względem CropBoxa
- Renderer rasteryzuje widoczny box, czyli CropBox przycięty do MediaBoxa (ISO 32000-1 §14.11.2); każde mapowanie piksel–strona musi używać tego boxa, czytanego przez
GetLoadedPageVisibleBox ApplyLoadedOCRTextLayer, całostronicoweDecodeLoadedPageBarcodesi wyniki twarzy zDetectLoadedRedactionFindingsmapują wszystkie przez widoczny box, i każdy własny engine czy detektor musi zrobić to samo- Boxy
THPDFOCRWordto piksele bitmapy z początkiem lewym górnym;GetLoadedPageBoxiGetLoadedPageVisibleBoxzwracają przestrzeń użytkownika PDF z początkiem lewym dolnym iBottom < Top - Skala to
DPI / 72; wyprowadzaj ją z DPI, nigdy z boxa strony dzielonego w szerokość bitmapy - /Rotate rozstrzyga, które krawędzie się liczą: Left i Bottom przy 0 i 90, Right i Bottom przy 180, Right i Top przy 270
- Zwracaj słowa OCR w pikselach i pozwól mapować HotPDF; przeliczaj tylko na własną logikę filtrowania
- Przy ponownym OCR stron, które już niosą warstwę tekstu, pamiętaj, że
SkipPagesWithTextje pominie, dopóki nie wyłączysz tej opcji albo nie usuniesz najpierw starej warstwy
Funkcje rozpoznawania, zapytania o boxy stron i renderowanie dokumentów wczytanych użyte tutaj jadą wszystkie w komponencie HotPDF dla Delphi i C++Buildera; licencjonowanie, wersje próbne i pełną listę funkcji znajdziesz na stronie komponentu HotPDF Delphi PDF