Kiedy HotPDF Delphi Component wczytuje plik PDF 1.5 przez LoadFromFile, nie parsuje obiektów spakowanych w kontenerach /Type /ObjStm. Zapisuje, gdzie mieszka każda skompresowana składowa, i parsuje ją dopiero wtedy, gdy coś o nią poprosi. Ten leniwy niezmiennik sprawia, że czas wczytywania jest proporcjonalny do tego, czego naprawdę dotykasz, i jest też powodem, dla którego pełne przepisanie musi wykonać jedną dodatkową pracę, zanim wyjdzie jakikolwiek bajt: rozwinąć każdą składową, która wciąż jest niesparsowana, bo przepisanie zaraz wyrzuci kontenery, w których te składowe żyją
Objaw, który skłonił do tych notatek, łatwo opisać i nieprzyjemnie się go diagnozuje. Wczytaj plik, którego fonty, przestrzenie kolorów i drzewo struktury siedzą w strumieniach obiektów, przeprowadź go przez parę generowania BeginDoc i EndDoc, a wynik otworzy się bez skargi. Liczba stron się zgadza, tekst jest widoczny na stronach, które wyrywkowo sprawdzisz. Potem kolega otwiera stronę 40 i tekst ciała renderuje się podstawionym fontem albo polecenie Extract Text zwraca śmieci tam, gdzie kiedyś było zastąpienie ActualText. Nic się nie wywaliło. Writer po prostu zserializował obiekt, który nigdy nie został wczytany, a niewczytany obiekt serializuje się jako nic
Co LoadFromFile właściwie trzyma dla skompresowanego obiektu?
Dla każdego wpisu odsyłacza typu 2 LoadFromFile trzyma mały rekord w FCompactObjects: numer obiektu, indeks strumienia zawierającego w tabeli kontenerów, pozycję składowej wewnątrz tego strumienia oraz wskaźnik ParsedObject, który startuje jako nil. Sam kontener jest lokalizowany, odszyfrowywany, jeśli dokument jest zaszyfrowany, i rozpakowywany, ale ciała składowych zostają jako bajty. ISO 32000-1 §7.5.7 definiuje układ kontenera, który to umożliwia: nagłówek z parami numer obiektu i przesunięcie, a potem ciała składowych sklejone po /First, więc każdą pojedynczą składową można wyciąć bez dotykania sąsiadów
EnsureCompressedObjectLoaded to jedyna ścieżka, która zamienia rekord w obiekt. Znajduje rekord po numerze obiektu i jeśli ParsedObject jest już ustawione, zwraca ten zbuforowany obiekt i zalicza trafienie w cache. W przeciwnym razie przeładowuje kontener, jeśli został wyrzucony, liczy zakres bajtów składowej z tabeli przesunięć, podaje parserowi widok tego wycinka bez kopiowania i zapisuje wynik z powrotem do rekordu. Od tego momentu obiekt jest pośredni, niesie swój prawdziwy numer obiektu i jest zarejestrowany w indeksie obiektów dokumentu jak każdy obiekt sparsowany z ciała pliku. Katalog, słownik informacji, korzeń drzewa stron i obiekty stron przechodzą tędy w czasie wczytywania, bo nawigacja ich potrzebuje. Fonty, przestrzenie kolorów, słowniki ExtGState i elementy struktury nie, i zostają rekordami, dopóki nie dotknie ich renderowanie strony albo przepisanie
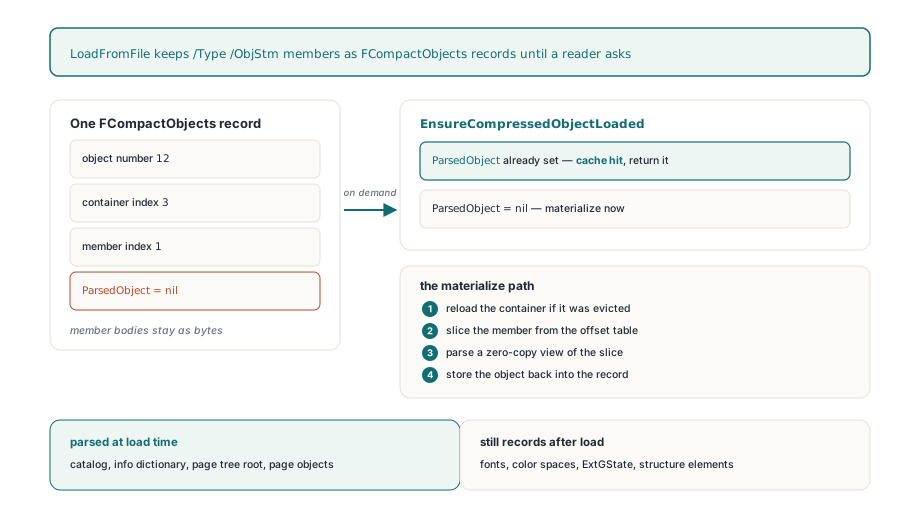
Możesz to obserwować z zewnątrz. GetLoadedObjectStreamCacheInfo raportuje, ile istnieje kontenerów, ile składowych zostało zaindeksowanych i ile z nich zostało dotąd sparsowanych:
var
  Pdf: THotPDF;
  Info: THPDFObjectStreamCacheInfo;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('tagged-report.pdf');
    if Pdf.GetLoadedObjectStreamCacheInfo(Info) then
      Writeln(Format('%d containers, %d members indexed, %d parsed so far',
        [Info.ContainerCount, Info.IndexedObjectCount,
         Info.MaterializedObjectCount]));
  finally
    Pdf.Free;
  end;
end;
Na pliku ciężkim strukturalnie trzecia liczba jest zaraz po wczytaniu małym ułamkiem drugiej. Ta różnica to cała istota leniwego wczytywania i dokładnie ten zbiór obiektów, po który pełne przepisanie musi wrócić
Dlaczego pełne przepisanie gubi fonty, które zapis przyrostowy zachowuje?
Pełne przepisanie wyrzuca kontenery /ObjStm i /XRef pliku źródłowego i serializuje graf obiektów od nowa, więc każda składowa, której ParsedObject jest wciąż nil, nie ma już żadnej reprezentacji w wyniku. Aktualizacja przyrostowa nigdy nie ma tego problemu, bo dopisuje nowe obiekty po oryginalnych bajtach i zostawia stare kontenery na miejscu, żeby adresowała je poprzednia sekcja odsyłaczy. Różnica nie leży w tym, jak oba tryby traktują fonty. Leży w tym, czy oryginalne kontenery przeżyją do odczytu przez następnego czytelnika
Poprawka siedzi w SaveToStream, serializerze, który EndDoc uruchamia niezależnie od tego, czy ustawisz FileName, czy OutputStream. Zanim rozdzieli pracę do którejkolwiek gałęzi writera, przechodzi FCompactObjects i woła EnsureCompressedObjectLoaded na każdym wpisie. Jeśli składowej nie da się wczytać, zapis rzuca wyjątek, zamiast kontynuować, bo przepisanie, które po cichu gubi słownik fontu, jest gorsze od takiego, które się zatrzymuje. Rozwijanie musi siedzieć na tym poziomie, ponad gałęziami klasyczną, pakowaną i linearyzowaną oraz ponad przycinaniem przeładowanych strumieni strukturalnych w ścieżce linearyzowanej. Wcześniejsza wersja rozwijała składowe tylko wewnątrz SaveLoadedDocument, co pokrywało słownik wczytanego dokumentu, a słownik generowania mijało całkowicie. LoadFromFile, po którym następowały BeginDoc, edycje stron i EndDoc, szło prosto do writera z każdą nietkniętą składową wciąż niesparsowaną
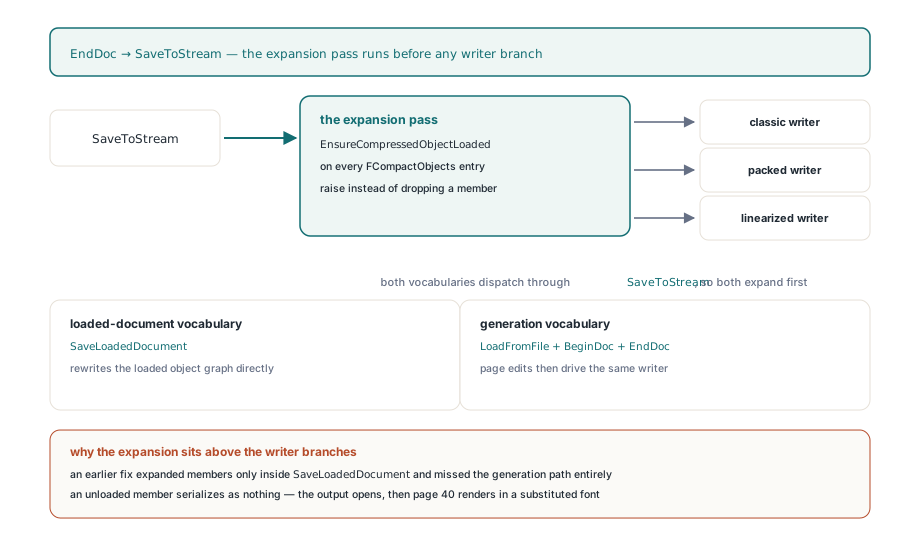
// Oba słowniki przepisywania rozwijają teraz kompaktowe składowe, zanim ruszy jakikolwiek writer.
// Ścieżka wczytanego dokumentu:
Pdf.LoadFromFile('quarterly.pdf');
Pdf.SaveLoadedDocument('quarterly-rewritten.pdf');

// Ścieżka generowania na wczytanym pliku:
Pdf.LoadFromFile('quarterly.pdf');
Pdf.FileName := 'quarterly-stamped.pdf';
Pdf.BeginDoc;
Pdf.CurrentPage.SetFont('Arial', [], 9);
Pdf.CurrentPage.TextOut(40, 20, 0, 'Reviewed 2026-09-11');
Pdf.EndDoc;   // SaveToStream najpierw materializuje każdy wpis FCompactObjects
Zbuforowane składowe zachowują to, co im zrobiłeś. Obiekt, który został sparsowany, wyedytowany i oznaczony jako brudny przed zapisem, wraca z cache wraz ze swoimi zmianami, a składowa, którą usunąłeś, zachowuje stan usunięcia przy kolejnych zapisach. Przebieg rozwijania jest idempotentny z konstrukcji: wypełnia wyłącznie sloty nil
Dlaczego sprawdzanie pikseli na trzech stronach nie zauważa przypadku ActualText
Elementy struktury to miejsce, w którym ten błąd ukrywa się najdłużej. Wpis ActualText na sekwencji treści oznaczonej, zdefiniowany w ISO 32000-1 §14.9.4, zastępuje glify na potrzeby ekstrakcji i dostępności, ale nie wpływa na renderowanie. Jeśli element struktury żyje w strumieniu obiektów, a przepisanie go gubi, strona nadal rysuje się poprawnie, pierwsza, środkowa i ostatnia strona porównują się piksel w piksel ze źródłem, a regresja wychodzi dopiero wtedy, gdy ktoś uruchomi ekstrakcję tekstu albo czytnik ekranu. Test przepisywania, który tylko renderuje strony, nie jest testem przepisywania dla otagowanego PDF-a. Porównuj także wyciągnięty tekst i drzewo struktury
Jak puste hasło użytkownika zmienia wczytywanie?
Puste hasło użytkownika nadal oznacza, że plik jest zaszyfrowany, a strumienie obiektów w takim pliku są szyfrogramem, dopóki nie zostanie odzyskany klucz pliku. ISO 32000-1 §7.6.3.4 Algorytm 2 wyprowadza ten klucz z hasła, wpisu /O, /P i pierwszego identyfikatora dokumentu, a HotPDF musi go uruchomić na pustym łańcuchu, zanim przebieg typu 2 rozpakuje choćby jeden kontener. Dlatego BeginDoc na wczytanym zaszyfrowanym dokumencie woła DecryptLoadedDocument z pustym hasłem przed czymkolwiek innym: graf obiektów musi zostać uwierzytelniony i odszyfrowany, zanim przepisanie może się zacząć, niezależnie od tego, czy wywołujący zamierza chronić wynik. Szyfrowanie wyjścia to osobna decyzja, sterowana ustawieniami ochrony wywołującego, a BeginDoc przywraca te ustawienia po przebiegu odszyfrowania, żeby zaszyfrowane wejście nie zamieniło się po cichu w zaszyfrowane wyjście
Politykę kontenerów odczytuje się ze słownika /Encrypt, zanim zostanie wypróbowane jakiekolwiek hasło. Dla /V 1 i 2 każdy strumień jest szyfrowany kluczem pliku. Przy crypt filtrach HotPDF rozwiązuje /StmF przez /CF: filtr Identity albo /CFM równe None oznacza kontenery jawne, a V2 i AESV2 zaszyfrowane. Odpowiedź ląduje w FReloadObjectStreamsEncrypted i ma znaczenie dla jednego konkretnego przypadku. Gdy kontenery są jawne, ale łańcuchy nie, składowe niosą zaszyfrowane łańcuchy, które trzeba odszyfrować pojedynczo, więc MaterializeMembersOfPlaintextObjectStreams rozwija każdą kompaktową składową przed przebiegiem odszyfrowania obiekt po obiekcie. Nie robi nic, gdy polityka nie jest jeszcze znana, ani nic, gdy same kontenery były zaszyfrowane, bo składowe zaszyfrowanego kontenera zostały już odszyfrowane razem z nim i nigdy nie wolno odszyfrowywać ich drugi raz
Co się dzieje, gdy kontenera nie da się odszyfrować?
Kontener, którego odszyfrowanie się nie uda, idzie do kwarantanny, a nie wywala wszystkiego. Przebieg typu 2 zapisuje wpis THPDFObjStmQuarantineInfo w FObjStmQuarantine z numerem obiektu kontenera, wartością THPDFObjStmQuarantineReason, łańcuchem diagnostycznym i listą numerów obiektów składowych, które odsyłacze skierowały do tego kontenera. osqrDecryptFailed jest zgłaszane w czterech różnych sytuacjach: nie udało się rozwiązać żadnego crypt filtra, odszyfrowanie AES-256 albo AES-GCM rzuciło wyjątek, odszyfrowanie odziedziczonego RC4 albo AES-128 rzuciło wyjątek, albo nie istnieje żaden użyteczny klucz pliku. Niezależne kontenery wczytują się dalej, więc dokument z jednym uszkodzonym kontenerem nadal się otwiera i nadal renderuje każdą stronę, która od niego nie zależy
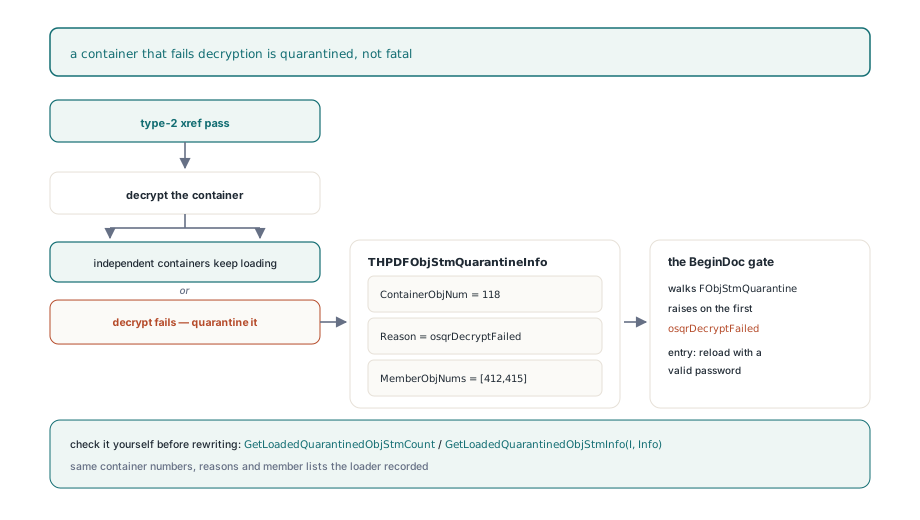
Lista kwarantanny przeżywa awaryjne odtwarzanie parsera. Jeśli podstawowe wczytanie odsyłaczy się nie uda i HotPDF odtworzy tablicę obiektów, skanując plik, flaga szyfrowania z pierwszej próby może tej rekonstrukcji nie przeżyć, ale rekordy kwarantanny tak. Dlatego BeginDoc sprawdza listę kwarantanny, a nie flagę szyfrowania: na wczytanym dokumencie przechodzi FObjStmQuarantine i rzuca wyjątek na pierwszym wpisie osqrDecryptFailed, nazywając kontener i prosząc o ponowne wczytanie z poprawnym hasłem. Przepisanie, które poszłoby dalej, zapisałoby składowe, które kontener miał trzymać, jako puste obiekty i zaraportowałoby sukces. Ten sam test możesz przeprowadzić sam, wcześniej i według własnej polityki, przez publiczne akcesory:
var
  Info: THPDFObjStmQuarantineInfo;
  I: Integer;
begin
  Pdf.LoadFromFile('vendor-form.pdf');   // puste hasło użytkownika
  for I := 0 to Pdf.GetLoadedQuarantinedObjStmCount - 1 do
    if Pdf.GetLoadedQuarantinedObjStmInfo(I, Info) and
       (Info.Reason = osqrDecryptFailed) then
      raise Exception.CreateFmt(
        'Object stream %d is unreadable (%s); %d members unresolved',
        [Info.ContainerObjNum, String(Info.Diagnostic),
         Length(Info.MemberObjNums)]);
  // od tego miejsca można bezpiecznie przepisywać
end;
Pozostałe powody kwarantanny obejmują awarie niekryptograficzne: kontener, który nie jest strumieniem, brakujący słownik, niepoprawne /N albo /First, rozmiar strumienia poza przyjętym zakresem, nieudane rozpakowanie, /First wskazujące poza dane albo ciało składowej, które się zdekodowało, ale nie sparsowało. Warto je logować przy przyjmowaniu pliku, bo każdy z nich nazywa dokładnie te składowe, których później będzie brakować
Po co przepisaniu oryginalny token liczbowy?
HotPDF przechowuje każdy obiekt numeryczny jako Single, a Single nie potrafi odtworzyć tekstu źródłowego liczby rzeczywistej. ISO 32000-1 §7.3.3 pozwala writerowi wypisać 0.750000, .75 albo 0.75 dla tej samej wartości i żadna z tych postaci nie przechodzi bez zmian przez podróż w obie strony przez 24-bitową binarkę i ogólny formatter. Co gorsza, wartości takiej jak 0.7 nie da się w ogóle przedstawić jako Single; parsuje się do najbliższego floatu, a przeformatowanie tego floatu potrafi dać 0.69999999 albo zaokrąglonego sąsiada, zależnie od pętli cyfr. Na kolorze wypełnienia albo stałej przezroczystości /CA to różnica jednego oczka w 8-bitowym kanale, wystarczająca, żeby oblać porównanie pikseli ze źródłem, a na granicach gradientu wystarczająca, żeby to zobaczyć
THPDFNumericObject.RememberSourceToken rozwiązuje to dla przypadku niezmodyfikowanego. Parser woła je z surowym tokenem zaraz po przypisaniu Value; metoda przyjmuje wyłącznie tokeny złożone z cyfr, co najwyżej jednej kropki dziesiętnej i opcjonalnego znaku wiodącego, i zapisuje token razem z wartością, której odpowiadał, w FSourceValue. Właściwość SourceToken zwraca zapisany tekst tylko dopóki Value wciąż równa się FSourceValue. Zmień liczbę, a token wyparuje, więc zmodyfikowana wartość zawsze idzie istniejącą ścieżką formatowania i nigdy nie wypisuje nieaktualnego tekstu. SaveNumericObject sprawdza najpierw SourceToken i zapisuje go dosłownie, gdy jest obecny, a do gałęzi całkowitej, odwołania do przestrzeni kolorów i ułamkowej schodzi tylko dla liczb utworzonych albo wyedytowanych w pamięci
Niezmiennik jest niewielki i wart wypowiedzenia wprost: liczba, której nie tknąłeś, jest zapisywana tymi bajtami, którymi została odczytana, a liczba, którą tknąłeś, jest zapisywana formatterem HotPDF. Kompaktowe składowe korzystają z tego tak samo jak obiekty z ciała pliku, bo EnsureCompressedObjectLoaded uruchamia ten sam parser na wycinku składowej. Samo formatowanie liczb i jego niezależność od locale procesu omawia artykuł o niezależnym od locale formatowaniu liczb PDF w HotPDF
Testowanie ścieżki przepisywania na strumieniach obiektów
Trzy sprawdzenia łapią każdą z opisanych awarii i żadne z nich nie wymaga Acrobata. Po pierwsze, porównaj IndexedObjectCount z MaterializedObjectCount po zapisie; przy pełnym przepisaniu muszą być równe, a każda różnica to składowa, która wypadła. Po drugie, wyciągnij tekst i wylicz drzewo struktury w obu plikach, a nie tylko je renderuj, żeby zgubiony ActualText albo zgubiony element struktury wyszedł jako diff. Po trzecie, wczytaj wynik świeżą instancją i sprawdź, że GetLoadedQuarantinedObjStmCount wynosi zero, co dowodzi też, że writer nie wyprodukował kontenera, którego czytelnik nie potrafi otworzyć. Kombinacje crypt filtrów, które decydują o FReloadObjectStreamsEncrypted, są rozpisane w artykule o politykach StmF, StrF i EFF. Strona pisząca tej historii, czyli jak wypisywać strumienie obiektów i kiedy woleć aktualizację przyrostową od przepisania, jest w przewodniku po strumieniach obiektów i aktualizacjach przyrostowych
Leniwe wczytywanie składowych, przebieg rozwijania przed writerem, kwarantanna odszyfrowania i zachowanie tokenów źródłowych są w HotPDF Delphi Component dla Delphi i C++Buildera. Strona produktu linkuje dokumentację API, jeśli chcesz prześledzić GetLoadedObjectStreamCacheInfo i akcesory kwarantanny na własnym potoku przyjmowania plików