Akapit, który zaczyna się na dole strony 4 i kończy u góry strony 5, dla czytelnika jest jednym akapitem. W otagowanym PDF-ie żyje jednak w dwóch strumieniach treści, a każda strona numeruje swoje sekwencje marked content niezależnie, więc drzewo struktury potrzebuje jednego elementu P, którego tablica /K wskazuje, powiedzmy, MCID 7 na stronie 4 i MCID 3 na stronie 5. Jeśli narysujesz strony kodem opartym na współrzędnych i dokleisz tagowanie później, drzewo tagów w walidatorze dostępności zwykle pokaże dwa akapity tam, gdzie był jeden, plus komplet tytułów kolumn powtórzony wewnątrz danych każdej kontynuowanej tabeli
Podejście oparte na współrzędnych ma też drugi koszt, który pojawia się wcześniej. Pierwsza wersja raportu działa. Potem adres klienta rozrasta się do trzech linii, zlokalizowany nagłówek się zawija, tabela zyskuje czterdzieści wierszy i każda pozycja y poniżej tego punktu jest już błędna. Sprawdzenia podziału strony rozłażą się po logice biznesowej, a kod, który zawsze znał tylko x i y, nie ma pojęcia, gdzie zaczyna się akapit, kiedy dwa lata później pojawia się wymóg dostępności
Budowanie drzewa układu HotPDF w Delphi
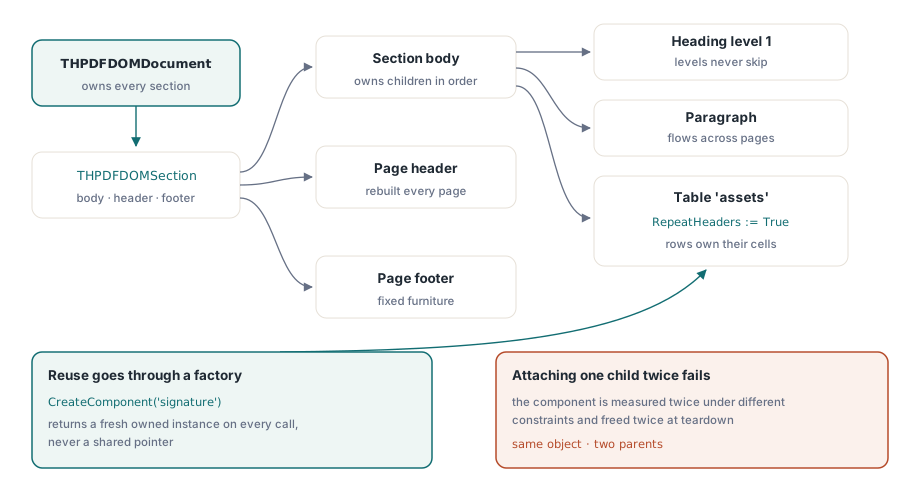
HotPDF odpowiada na oba problemy deklaratywnym drzewem układu w module HPDFLayoutDOM. THPDFDOMDocument przechowuje sekcje; każda THPDFDOMSection ma rozmiar strony, marginesy, opcjonalny nagłówek i stopkę oraz stos Body, do którego dodajesz tekst, nagłówki, odstępy, listy, obrazy, kontenery i tabele. Nic w drzewie nie niesie współrzędnej y. THPDFDOMRenderer mierzy drzewo, decyduje o podziałach stron, rysuje nagłówek i stopkę na każdej stronie, a ponieważ GenerateStructure domyślnie ma wartość True, po drodze zapisuje drzewo struktury
Własność w drzewie jest ścisła. Dokument jest właścicielem swoich sekcji, sekcja swojego body, nagłówka i stopki, a stosy, kontenery i tabele swoich dzieci, więc Section.Body.Add(Table) oddaje tabelę na dobre. Komponent podpięty pod dwóch rodziców byłby mierzony dwa razy pod różnymi ograniczeniami i zwalniany dwa razy przy sprzątaniu. Powtarzalne fragmenty, takie jak blok podpisu, pochodzą więc z Clone, z SetHeaderClone / SetFooterClone albo z fabryki zarejestrowanej przez RegisterComponent, po czym każde wywołanie CreateComponent('signature') zwraca świeżą instancję
uses
  SysUtils, HPDFDoc, HPDFLayoutDOM;

type
  TAssetRow = record                    // własny typ danych
    Name, ServiceDate, Status: WideString;
  end;

function BuildMaintenanceReport(const Assets: array of TAssetRow): THPDFDOMDocument;
var
  Doc: THPDFDOMDocument;
  Section: THPDFDOMSection;
  Heading: THPDFDOMText;
  Table: THPDFDOMTable;
  Row: THPDFDOMTableRow;
  I: Integer;
begin
  Doc := THPDFDOMDocument.Create;       // GenerateStructure = True, Language = 'en-US'
  try
    Section := Doc.AddSection;          // A4 pionowo, domyślnie marginesy 36 pt
    Section.MarginLeft := 56;
    Section.MarginRight := 56;
    Section.Style.FontName := 'Helvetica';
    Section.Style.FontSize := 10;
    Section.Style.LineHeight := 13;
    Section.Body.Style.Spacing := 6;    // odstęp między dziećmi body
    Section.Footer := THPDFDOMText.Create('Plant maintenance - internal');

    Heading := Section.Body.AddHeading('Annual maintenance report', 1);
    Heading.Style.FontSize := 18;
    Heading.Style.LineHeight := 22;     // LineHeight nie podąża za FontSize
    Section.Body.AddText('Every asset inspected during the reporting ' +
      'period is listed below, grouped by site.');

    Table := THPDFDOMTable.Create('assets');  // RepeatHeaders domyślnie ma wartość True
    Table.AddColumn(3);                 // wagi, nie szerokości w punktach
    Table.AddColumn(1);
    Table.AddColumn(1);
    Row := Table.AddRow(18, True);      // wiersze nagłówka muszą być pierwsze
    Row[0].Text := 'Asset';
    Row[1].Text := 'Last service';
    Row[2].Text := 'Status';
    for I := 0 to High(Assets) do
    begin
      Row := Table.AddRow(16);
      Row[0].Text := Assets[I].Name;
      Row[1].Text := Assets[I].ServiceDate;
      Row[2].Text := Assets[I].Status;
    end;
    Section.Body.Add(Table);            // od tej chwili tabela należy do body
    Result := Doc;
  except
    Doc.Free;
    raise;
  end;
end;
Dwa domyślne ustawienia z tego listingu łapią ludzi. LineHeight rozwiązuje się do 12 punktów, dopóki jakiś styl w łańcuchu go nie ustawi, niezależnie od tego, co mówi FontSize, więc nagłówek 18 pt bez własnego LineHeight dostaje linie 12 pt i nachodzi na następny. A wiersz tabeli jest dokładnie tak wysoki, jak wysokość przekazana do AddRow: tekst komórki wychodzi w jednej linii, więc dobierz wysokość wierszy do wybranego fontu
Render sam otwiera i zamyka dokument
THPDFDOMRenderer.Render(Doc, Pdf) wywołuje BeginDoc na obiekcie docelowym, renderuje każdą sekcję i przed powrotem wywołuje EndDoc. Nie opakowuj go własną parą BeginDoc / EndDoc. Wszystko, co trzeba ustawić przed startem dokumentu, idzie najpierw na instancję THotPDF: FileName, Title oraz PDFUACompliance, jeśli wynik ma deklarować zgodność z PDF/UA. Przy włączonym generowaniu struktury Render włącza też EnableTaggedPDF i kopiuje Doc.Language do Pdf.Lang, jeśli zostawiłeś je puste
var
  Doc: THPDFDOMDocument;
  Pdf: THotPDF;
  Renderer: THPDFDOMRenderer;
  Stats: THPDFDOMRenderStatistics;
begin
  Doc := BuildMaintenanceReport(Assets);
  Pdf := THotPDF.Create(nil);
  Renderer := THPDFDOMRenderer.Create;
  try
    Pdf.FileName := 'maintenance-report.pdf';
    Pdf.Title := 'Annual maintenance report';
    Pdf.PDFUACompliance := True;        // włącza też sprawdzanie tekstu alternatywnego figur
    // Bez BeginDoc / EndDoc: Render sam otwiera i zamyka dokument
    Stats := Renderer.Render(Doc, Pdf);

    Writeln(Format('%d page(s), %d placement(s), %d split(s)',
      [Stats.PageCount, Stats.PlacementCount, Stats.SplitCount]));
    Writeln(Format('structure elements=%d marked content=%d artifacts=%d',
      [Stats.StructureElementCount, Stats.MarkedContentCount,
       Stats.ArtifactCount]));
    Writeln(Format('header draws=%d footer draws=%d deepest chain=%d',
      [Stats.HeaderDrawCount, Stats.FooterDrawCount,
       Stats.MaximumContinuationDepth]));
  finally
    Renderer.Free;
    Doc.Free;
    Pdf.Free;
  end;
end;
Loguj rekord statystyk przy każdym uruchomieniu, bo pokazuje regresje szablonu, które nigdy nie rzucą wyjątku. Skok SplitCount po zmianie szablonu zwykle oznacza, że jakiś komponent mierzy się teraz wyżej niż przestrzeń, w której wcześniej się mieścił. Pełznący w górę MaximumContinuationDepth wskazuje komponent, którego Split przenosi za mało treści na stronę. ArtifactCount obejmuje nagłówki i stopki stron, ozdobne obramowania, takie jak domyślna ramka tabeli 0,5 pt, oraz powtarzane wiersze nagłówka, więc porównuj go między uruchomieniami tego samego szablonu, a nie z ręcznie wyliczoną wartością
Jak długa tabela dzieli się na strony bez kopiowania samej siebie na każdej stronie?
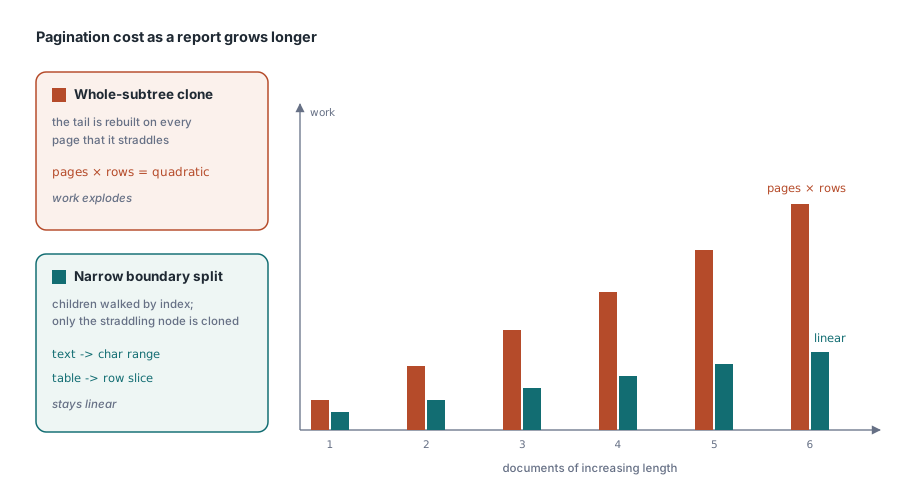
Renderer dzieli tylko to, co leży na granicy strony. Naiwny sposób stronicowania drzewa to sklonowanie tego, co się nie zmieściło, i przeniesienie kopii na następną stronę; dla tabeli z 10 000 wierszy klonuje to pozostałe wiersze raz na stronę i zamienia zadanie liniowe w kwadratowe. HotPDF przechodzi po dzieciach body według indeksu i nigdy nie klonuje całej sekcji ani body. Zagnieżdżony stos lub kontener przecinający granicę strony dostaje sklonowane tylko dotknięte poddrzewo, a dwa ciężkie typy liści niosą kursor zamiast kopii
Kontynuowany akapit to referencja do oryginalnego tekstu plus zakres znaków, który jeszcze jest winien, i korzysta z podziałów na linie już wyliczonych dla tej szerokości. Kontynuowana tabela to referencja do oryginalnej tabeli plus wycinek wierszy, które jeszcze trzeba umieścić. Akapit na 300 linii kosztuje tyle samo niezależnie od tego, czy łamie się raz, czy pięć razy
Samo umieszczanie przechodzi przez publiczną metodę THotPDF.PlaceLayoutElement. Mierzy ona element względem pozostałej wysokości body, rysuje go w całości, jeśli się mieści, a w przeciwnym razie prosi go o Split, mierzy ponownie umieszczoną połowę, rysuje ją i zwraca resztę jako obiekt nadmiaru, który renderer przenosi na świeżą stronę. Measure nie może nigdy niczego rysować; może zostać uruchomione kilka razy dla jednego umieszczenia. Renderer DOM dokłada do tej procedury elementy strony, odstępy między dziećmi i decyzje o nowej stronie
Dlaczego jeden wiersz nagłówka może zatrzymać cały render?
Powtarzane nagłówki tabeli rządzą się dwiema regułami i obie istnieją po to, by raport nie produkował stron bez danych. Wiersze nagłówka muszą tworzyć pierwszy ciąg wierszy: AddRow(Height, True) po jakimkolwiek wierszu body rzuca EInvalidOpException z komunikatem "Table header rows must precede body rows". A pierwszy podział tabeli musi zmieścić każdy wiersz nagłówka plus co najmniej jeden wiersz body. Tabela, która zostawiłaby nagłówek osierocony u dołu strony, przenosi się zamiast tego na następną stronę
Druga reguła ma twardą krawędź. Jeśli wiersze nagłówka plus jeden wiersz body nie mieszczą się nawet na pustej stronie, nie ma strony, na której tabela mogłaby się zacząć, i Render rzuca "Layout component ... cannot fit an empty body page" ze ścieżką komponentu, na przykład Sections[0]/Body/Items[2]/assets. I dobrze, że tak się zachowuje. Silnik układu, który dokładałby kolejne strony w nadziei, że następna będzie bardziej pojemna, zamieniłby jeden za duży nagłówek w pętlę zapełniającą dysk
Niestandardowe komponenty dostają tę samą ochronę. Wyprowadź klasę z THPDFDOMComponent, zaimplementuj Clone, Measure, Draw i Split, a renderer liczy, ile kontynuacji produkuje każde dziecko body. Powyżej THPDFDOMRenderer.MaximumContinuationDepth (domyślnie 100 000) render zatrzymuje się z komunikatem "exceeded the continuation depth limit". Split, który wciąż zwraca równoważny ogon i nigdy nie robi postępu, kończy się błędem ze ścieżką komponentu zamiast kręcić się do zapełnienia dysku
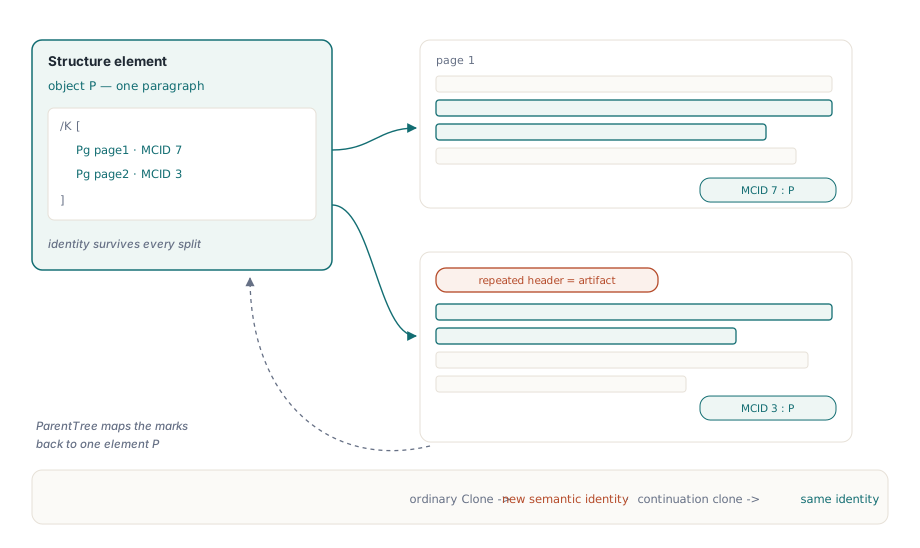
Na stronach kontynuacji wiersze nagłówka są rysowane ponownie wewnątrz sekwencji marked content /Artifact, a drzewo struktury zachowuje oryginalny TR tylko raz. Ekstrakcja tekstu nie wstawia więc zdublowanego wiersza nagłówka między wiersze danych, a technologie wspomagające nie czytają tytułów kolumn jeszcze raz w środku tabeli. Każda komórka nagłówka jest otagowana jako TH z atrybutem /Scope /Column
Jeden logiczny akapit, kilka fragmentów na stronach
Podzielony akapit pozostaje jednym elementem struktury P. Każdy widoczny fragment otwiera nową sekwencję marked content na swojej stronie, a HotPDF dokleja słownik referencji marked content, << /Type /MCR /Pg page /MCID n >>, do tablicy /K tego elementu i rejestruje MCID we wpisie ParentTree strony wskazującym z powrotem na ten sam element. Dokładnie taki układ opisuje ISO 32000-1 §14.7.4 dla elementów treści rozciągniętych na kilka stron i to on pozwala widokowi drzewa tagów pokazać jeden akapit tam, gdzie strony pokazują dwa kawałki
Tożsamość semantyczna to powód, dla którego kopie kontynuacji zachowują się inaczej niż twoje własne klony. Wywołanie Clone oznacza "nowa treść logiczna" i wynik dostaje nowy element struktury, gdy zostanie narysowany. Kopie tworzone podczas stronicowania dziedziczą tożsamość komponentu, który kontynuują, więc stos podzielony na trzy strony nadal daje jeden Div, a lista podzielona na dwie nadal daje jedno L. Nagłówki i stopki stron idą inną drogą: na każdej stronie są opakowane jako /Artifact << /Type /Pagination /Subtype /Header >> (lub /Footer) i nigdy nie trafiają do drzewa struktury
Reguły struktury sprawdzane w trakcie renderowania drzewa
Przy włączonym GenerateStructure renderer odrzuca strukturę, którą walidacja PDF/UA odrzuciłaby później. Pierwszy nagłówek musi być H1, a kolejne nie mogą przeskoczyć poziomu, więc H3 zaraz po H1 rzuca "Semantic heading levels cannot skip an intermediate level". LI wymaga rodzica L, Lbl i LBody wymagają LI, TR wymaga tabeli lub grupy wierszy, a TH / TD wymagają TR. Gdy obiekt docelowy ma ustawione PDFUACompliance, odrzucany jest również Figure bez tekstu alternatywnego. Każde naruszenie zatrzymuje Render wyjątkiem
var
  List: THPDFDOMList;
  Bmp: TBitmap;                         // Vcl.Graphics
begin
  Section.Body.AddHeading('Findings', 2);     // H1 był pierwszy, więc H2 jest dozwolony

  List := THPDFDOMList.Create('Decimal');     // otagowane jako L, ListNumbering /Decimal
  List.AddItem('1.', 'Replace the intake filter on pump P-14');
  List.AddItem('2.', 'Re-torque the flange bolts on line 3');
  Section.Body.Add(List);                     // AddItem buduje LI, Lbl i LBody

  Bmp := TBitmap.Create;
  try
    Bmp.LoadFromFile('site-plan.bmp');
    // Obraz kopiuje grafikę; pusty tekst alternatywny nie przejdzie przy PDFUACompliance
    Section.Body.Add(THPDFDOMImage.Create(Bmp, 240, 160,
      'Site plan of plant 3 with the inspected pumps circled'));
  finally
    Bmp.Free;
  end;
end;
Sprawdzanie w trakcie renderowania to właściwe miejsce na te reguły. Chodzi o moment. Walidator, który zgłasza brak tekstu alternatywnego po zapisaniu pliku, mówi ci, że partię 10 000 wyciągów trzeba wygenerować od nowa; wyjątek podczas Render nazywa regułę, która nie przeszła, gdy rekord, który ją wywołał, wciąż jest w zasięgu. Formalne sprawdzanie zgodności nadal ma swoje miejsce w procesie, a ponieważ obiekty dokumentu pozostają czytelne po powrocie z Render, może ruszyć od razu. Walidacja PDF/A, PDF/X i PDF/UA opisuje ten krok, a kolejność struktury i ekstrakcja tekstu pokazuje, jak drzewo tagów steruje tym, co odczytują narzędzia do ekstrakcji
Kiedy zostać przy rysowaniu ręcznym
Drzewo rysuje na tych samych obiektach THPDFPage co bezpośrednie API. Ponieważ Render jest właścicielem dokumentu od BeginDoc do EndDoc, ręcznie pozycjonowana grafika, taka jak obraz podpisu, powinna trafić do drzewa: Draw niestandardowego komponentu dostaje stronę i jej granice i może tam wywoływać zwykłe metody strony. Zamykanie stron zostaje przy AddPage i EndDoc, więc przy ustawionym ImmediateFlushLayout na instancji THotPDF gotowe strony są zapisywane w miarę postępu renderowania, a renderer nie trzyma ukończonych stron; pamięć zależy wtedy od otwartych kontynuacji, zasobów fontów i grafu obiektów dokumentu
Komponent tekstowy DOM łamie linie na podstawie szacowanej średniej szerokości znaku 0,55 × rozmiar fontu i daje każdej linii rozwiązany LineHeight. Dzięki temu pomiar jest tani i taki sam na każdej maszynie, a do raportów sterowanych danymi w zupełności wystarcza. Tekst z szerokimi glifami, na przykład same wersaliki, pogrubione fragmenty czy CJK, wychodzi szerzej niż szacunek, więc zostaw luz w szerokościach kolumn i przetestuj układ raz z najdłuższym prawdziwym ciągiem. Składane strony z dokładnymi metrykami glifów, mieszanymi fontami w jednej linii czy justowanymi akapitami lepiej obsłuży bezpośrednie API tekstowe; justowanie tekstu przechodzi przez tę ścieżkę, a jeśli boli tylko stronicowanie tabel, generowanie tabel w PDF to mniejsza zmiana
Drzewo układu, jego renderer, opisane tu tagowanie i bezpośrednie API rysowania są dostarczane w jednym komponencie dla Delphi i C++Builder; edycje i pełna lista funkcji są na stronie komponentu HotPDF Delphi PDF