HotPDF konwertuje HTML na strony PDF za pomocą THPDFHTMLImporter.RenderHTML5 — wersjonowanego profilu mediów stronicowanych z prawdziwym DOM, prawdziwą kaskadą CSS, tabelami, podziałami stron oraz opcjonalnym generowaniem AcroForm z formularzowych kontrolek HTML. Działa całkowicie w ramach procesu: bez silnika przeglądarki, bez Chromium, bez zewnętrznego konwertera, a domyślnie bez jakiegokolwiek dostępu do plików czy sieci
Powodem istnienia osobnego punktu wejścia zamiast ulepszonej metody RenderHTML jest zgodność wsteczna. Starsza metoda od lat renderuje faktury i pisma w aplikacjach produkcyjnych, a wyrozumiały DOM z pełną kaskadą zmienia wynik dokumentów dostrojonych do starego zachowania. Dlatego stara metoda zachowuje dokładnie swoją semantykę, a wszystko nowe znajduje się za RenderHTML5, którego wersję profilu zgłasza HTML5ProfileVersion, a obsługiwane kamienie milowe wylicza HTML5ProfileMilestones
Co właściwie dodaje profil HTML5?
W praktyce liczą się cztery możliwości. Strukturalny DOM, w którym html i body są kontenerami, a nie węzłami tekstowymi. Kaskada CSS z poprawnym pierwszeństwem. Układ tabel. Oraz jawna kontrola podziału stron, czyli to, co oznaczają „media stronicowane”: HTML zaprojektowano z myślą o przewijanym widoku, a zamiana go w strony wymaga decyzji, gdzie treść może się dzielić
Kwestia kontenerów brzmi jak szczegół implementacyjny, a w rzeczywistości jest różnicą między działaniem a jego brakiem. Jeśli elementy główne są traktowane jako kontenery tekstowe, cały DOM zapada się w jeden blok tekstu już na etapie parsowania, a każda reguła arkusza stylów, podział strony, tabela i poddrzewo formularza są potem stosowane donikąd. Każdy renderer HTML, który ze strukturalnego dokumentu tworzy jedną niezróżnicowaną ścianę tekstu, popełnił dokładnie ten błąd
Kolejność kaskady, krok po kroku
Pierwszeństwo w CSS to nie jedno sortowanie. HotPDF stosuje zwykłe deklaracje z pasujących reguł w kolejności specyficzności, a następnie kolejności występowania w źródle, na to nakłada zwykłe deklaracje wbudowane (inline), następnie deklaracje !important z pasujących reguł, a na końcu wbudowane !important. Cztery przebiegi, w tej właśnie kolejności
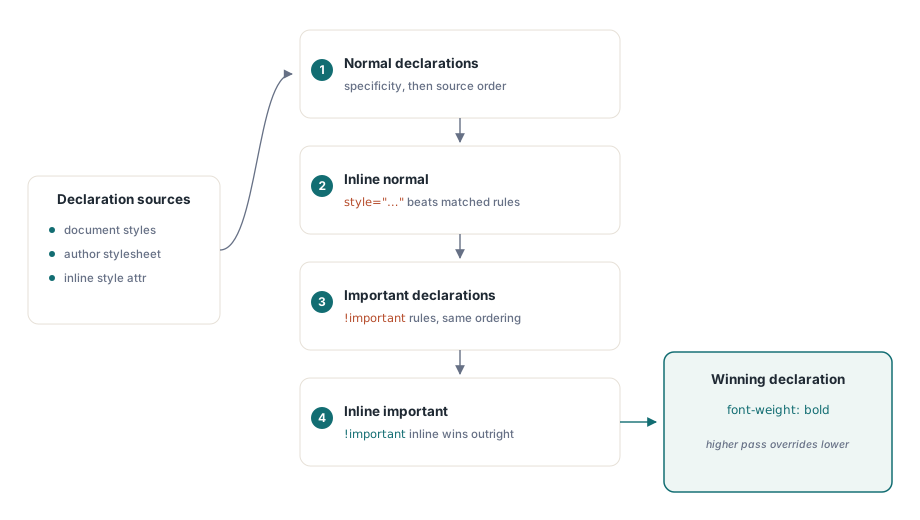
Implementacje, które sprowadzają to do zasady „wygrywa ostatni”, poprawnie obsługują typowe przypadki, a błędnie te ciekawsze, co jest gorsze niż jednolite błędne działanie, ponieważ błąd ujawnia się tylko w szablonach używających !important do nadpisania bazowego arkusza stylów — czyli właśnie w szablonach pisanych przez osoby, które oczekują, że kaskada zadziała:
uses
  HPDFDoc, HPDFHTMLImport;

var
  Pdf: THotPDF;
  Importer: THPDFHTMLImporter;
  Html, Css: WideString;
begin
  Pdf := THotPDF.Create(nil);
  Importer := THPDFHTMLImporter.Create(Pdf);
  try
    Pdf.FileName := 'statement.pdf';
    Pdf.BeginDoc;

    Importer.Margin := 56;              // punkty
    Importer.BaseFontName := 'Arial';
    Importer.BaseFontSize := 10;
    Importer.CreateAcroForms := False;  // renderuj kontrolki, nie twórz pól formularza

    Css := '@page { margin: 56pt } ' +
           'table { border-collapse: collapse } ' +
           'tr.total { page-break-inside: avoid; font-weight: bold }';
    Html := LoadTemplate('statement.html');

    if not Importer.RenderHTML5(Html, Css) then
      raise Exception.Create('nothing was emitted - check the markup');

    Pdf.EndDoc;

    Writeln(Format('profile=%d nodes=%d rules=%d layout ops=%d',
      [Importer.Statistics.ProfileVersion,
       Importer.Statistics.ParsedNodeCount,
       Importer.Statistics.CSSRuleCount,
       Importer.Statistics.LayoutOperationCount]));
  finally
    Importer.Free;
    Pdf.Free;
  end;
end;
Drugi argument to arkusz stylów autora, stosowany obok tego, co niesie sam dokument, co jest czystym sposobem na wymuszenie zasad firmowych, takich jak marginesy strony czy kontrola sierotek, bez edytowania każdego szablonu
Dlaczego importer nigdy niczego nie pobiera?
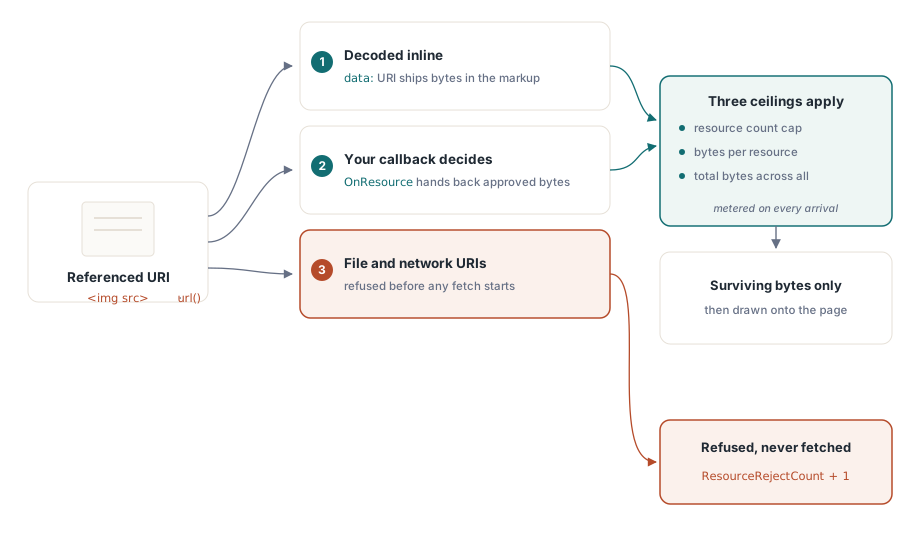
Konwerter HTML do PDF, który rozwiązuje odwołania zewnętrzne, to w istocie silnik ataków server-side request forgery przebrany za generator dokumentów. Skieruj go na znaczniki dostarczone przez użytkownika, a chętnie pobierze http://169.254.169.254/ albo adres URL pliku z serwera twojej aplikacji i osadzi wynik w PDF, który ktoś później pobierze
Dlatego HotPDF domyślnie nie czyta ani plików, ani sieci. Obrazy i inne zasoby docierają dokładnie na dwa sposoby: jako identyfikatory URI data: wewnątrz znaczników albo przez wywołanie zwrotne OnResource, w którym twój kod decyduje, co oznacza dany URI, i dostarcza bajty:
procedure TReportForm.SupplyResource(Sender: TObject;
  const URI: WideString; ResourceKind: THPDFHTMLResourceKind;
  var Data: TBytes; var ContentType: string; var Handled: boolean);
begin
  Handled := False;
  // Udostępniaj wyłącznie z lokalnego katalogu zasobów z listy dozwolonych. Nigdy
  // nie przekazuj URI do klienta HTTP i nigdy nie łącz go w ścieżkę
  // bez wcześniejszej walidacji
  if StartsText('asset:', URI) then
  begin
    Data := LoadAssetBytes(Copy(URI, 7, MaxInt));
    ContentType := 'image/png';
    Handled := Length(Data) > 0;
  end;
end;
Każdy zasób, który rzeczywiście dotrze, jest nadal liczony wobec trzech odrębnych limitów: liczby zasobów, liczby bajtów każdego z nich oraz łącznej liczby bajtów. Wywołania zwrotnego, które wiernie zwraca to, o co jest proszone, nie da się nakłonić do wyczerpania pamięci przez dokument odwołujący się dwieście razy do tego samego obrazu o rozmiarze 50 MB
Cztery limity, jeden tryb awarii
Węzły parsera, reguły CSS, operacje układu i zasoby są mierzone niezależnie od siebie, ponieważ zawodzą niezależnie. Dokument może być mały, a przy tym patologicznie kosztowny w układzie; inny może być płytki, ale z arkuszem stylów zaprojektowanym tak, by eksplodować dopasowywanie selektorów. Wyczerpanie któregokolwiek z limitów zgłasza EHPDFHTMLImportBudget — dedykowaną klasę wyjątku, dzięki której wyczerpanie limitu można przechwycić osobno od błędnie sformułowanego wejścia
Statystyki resetują się na początku każdego wywołania RenderHTML5, więc liczby opisują jeden import, a nie cały cykl życia obiektu importera. W usłudze renderującej niezaufane szablony loguj dla każdego dokumentu ParsedNodeCount, LayoutOperationCount i ResourceRejectCount: rosnąca liczba odrzuceń zwykle oznacza, że autor szablonu odwołuje się do zasobów nierozpoznawanych przez twoje wywołanie zwrotne, a liczba operacji układu bliska limitowi oznacza, że kolejny, nieco większy dokument zawiedzie
Wybór między importem HTML a API układu
Import HTML wygrywa, gdy treść jest tworzona jako HTML przez osoby niebędące programistami Delphi, gdy szablony zmieniają się częściej niż kod, albo gdy ta sama treść musi być też wysyłana jako e-mail. Deklaratywne drzewo układu opisane w deklaratywnym układzie PDF ze znakowanym wyjściem wygrywa, gdy dokument jest generowany z danych przez twój własny kod, gdy potrzebujesz automatycznie emitowanej struktury PDF/UA, albo gdy precyzyjna kontrola nad paginacją liczy się bardziej niż wygoda tworzenia szablonów
Nie wykluczają się wzajemnie. Częstym układem jest import HTML dla treści głównej raportu, z nagłówkiem, stopką i blokami podpisów rysowanymi bezpośrednio, ponieważ mają one stałą geometrię, którą nie powinien zarządzać żaden szablon. Tabele to jeden obszar, w którym warto zmierzyć oba podejścia: złożone tabele finansowe czasem paginują się lepiej przez dedykowaną ścieżkę tabel opisaną w generowaniu tabel w PDF
Ustawiaj CreateAcroForms świadomie. Wyłączone sprawia, że kontrolki formularza HTML renderują się jako statyczna grafika, czego potrzebuje drukowany wyciąg. Włączone zamienia je w prawdziwe, interaktywne pola AcroForm, czego potrzebuje formularz do wypełniania, a wynikające z tego zachowanie pól opisano w dodawaniu pól formularza do wczytanego PDF
Import HTML, układ deklaratywny i bezpośrednie API rysowania operują na tym samym obiekcie dokumentu w Delphi i C++Builder; pełną listę funkcji znajdziesz na stronie komponentu HotPDF PDF dla Delphi