Dwa chińskie znaki złożone SimSunem i przepuszczone przez zwykły subsetter TrueType nadal zostawiają około 25 KB osadzonych danych fontu w PDF. Kontury tych dwóch ideogramów to ułamek tej kwoty. Reszta to bookkeeping slotów: subset zachował oryginalną numerację glifów, więc nadal niesie wpis lokalizacji i wpis szerokości dla każdego identyfikatora glifu aż po najwyższy zachowany, a w fachu CJK ideogramy siedzą głęboko w bardzo dużej tabeli. Przenumeruj ocalałych od zera, pozwij strumień /CIDToGIDMap do tłumaczenia, i te same dwa znaki mieszczą się w około 3 KB
Dokąd idą bajty w rzadkim podzbiorze fontu
Rzadki subset zostaje ciężki, bo odmawia przesunięcia jakiegokolwiek glifu. HotPDF zapisuje tekst Unicode jako font Type 0 nad potomkiem CIDFontType2, a strumień treści pokazuje każdy glif po jego oryginalnym identyfikatorze glifu użytym jako CID. Przy /CIDToGIDMap /Identity ISO 32000-1 §9.7.4.2 każe przeglądarce traktować ten CID wprost jako indeks glifu. Przenumeruj glify wewnątrz programu fontu i zostaw wszystko inne w spokoju, a każdy znak na stronie wskazuje zły kontur. Zachowanie numeracji to tania, bezpieczna odpowiedź. Jej ceną jest to, że loca i hmtx muszą pokryć każdy slot aż po najwyższy zachowany GID, pusty albo nie
Załóżmy, że fach CJK deklaruje 28 000 glifów, a jeden z twoich dwóch znaków siedzi blisko końca. Tabela loca w formacie długim wyda 4 bajty na slot, czyli z grubsza 112 KB, a pełne metryki poziome kolejne 4 bajty na slot. To ponad 200 KB tabel przed kompresją, prawie w całości zer i powtarzających się offsetów. Flate świetnie ściska takie ciągi, ale nie umie ich sprawić, by zniknęły, i stąd bierze się większość tych 25 KB. Fach łaciński z kilkoma tysiącami glifów niesie tę samą strukturę w skali jednej dziesiątej, więc koszt naprawdę ląduje na dokumentach, które mieszają tekst chiński, japoński albo koreański
Które glify w ogóle przeżyją (składniki kompozytów, alternatywy wciągnięte przez shaping), rozstrzyga się wcześniej, przez reguły domknięcia podzbioru fontu dla kształtowanych glifów. Kompaktyzacja zmienia tylko to, ile kosztują ocaleni, gdy ten zbiór jest już zamknięty
Kompaktowe podzbiory fontów za strumieniem CIDToGIDMap
THotPDF.CompactFontSubsetting przenumerowuje zachowane glify w gęsty zakres zaczynający się od zera, przebudowuje tablice glifów tylko dla tych glifów i zapisuje jawny strumień /CIDToGIDMap na CIDFoncie. ISO 32000-1 §9.7.4.2 definiuje ten strumień jako tablicę dwubajtowych, big-endian identyfikatorów glifów indeksowanych CID-em: GID dla CID n siedzi na bajtowym offsecie 2n. Strumienie treści, tablica szerokości /W i CMap ToUnicode wszystkie trzymają oryginalne numery jako CID-y. Tylko krok od CID-u do glifu przenosi się do mapy, więc niczego już zapisanego na stronie nie trzeba ruszać
Właściwość działa sama. Nie potrzebujesz reszty maszynerii kompresji, żeby dostać mniejsze fonty, a dla raportu złożonego głównie z tekstu CJK ta para ustawień robi większość roboty:
Pdf.EnableFontSubsetting := True;
Pdf.CompactFontSubsetting := True;   // działa bez CompressDocument
Pdf.BeginDoc;
Pdf.CurrentPage.SetFont('SimSun', [], 12);
Pdf.CurrentPage.TextOut(40, 40, 0, WideString('Total: '#$4E2D#$6587));
Pdf.EndDoc;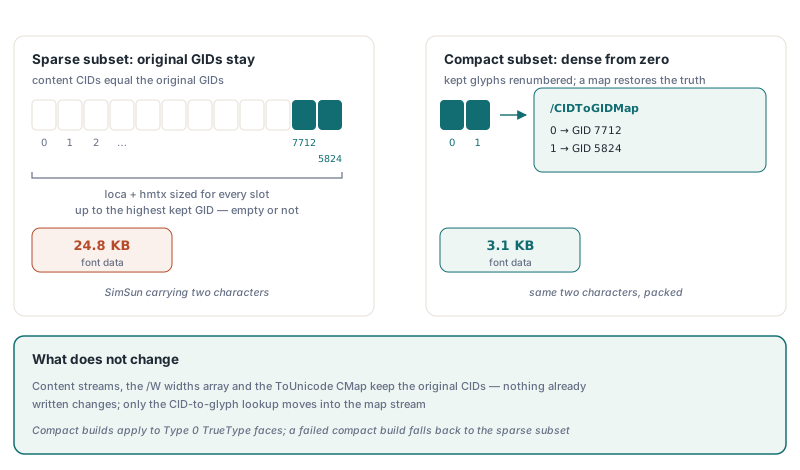
Kompaktyzacja dotyczy konkretnego rodzaju fontu. HotPDF buduje kompaktowe podzbiory dla fachów TrueType Type 0: tych ustawianych przez SetFont przy włączonym EnableFontSubsetting oraz faczu rejestrowanym przez RegisterUnicodeTTF. Prosty font TrueType jest lokalizowany przez cmap wewnątrz własnego programu fontu, a przenumerowanie zostawiłoby tę cmap wskazującą złe glify, więc proste fonty trzymają rzadki subset. Fachy OpenType-CFF też go trzymają. Jeśli kompaktowy build zawiedzie dla konkretnego fontu, HotPDF zapisuje dla niego rzadki subset i jedzie dalej z dokumentem. Właściwość jest domyślnie wyłączona, więc istniejące wyjście pozostaje identyczne bajt po bajcie, dopóki się nie zdecydujesz; pod PDF/A zarejestrowany fach Unicode zawsze dostaje kompaktowy subset
Jedna pułapka siedzi po stronie czytającej. Strumień /CIDToGIDMap wygląda, jakby należał obok CMapów, ale to surowe binarium bez bloków begincidchar, a podanie go tokenizerowi CMapów daje puste mapowanie bez żadnego błędu. Jeśli twoje własne narzędzia wyciągają tekst albo mierzą glify z takich plików, czytaj mapę jako zwykłe pary 16-bitowe
Co CompressDocument zmienia dla jednego dokumentu
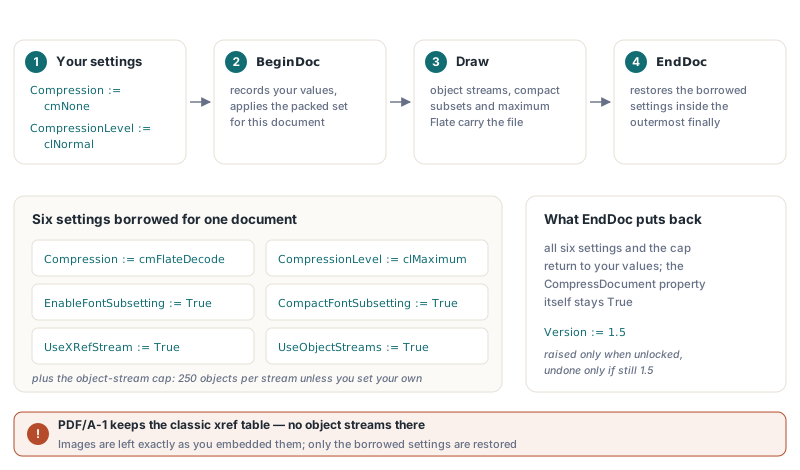
THotPDF.CompressDocument pożycza sześć ustawień writera plus limit strumieni obiektów przy BeginDoc i oddaje każde z nich przy EndDoc. Zanim wersja PDF zostanie ustalona, HotPDF zapamiętuje twoje wartości, po czym ustawia:
CompressionnacmFlateDecodeiCompressionLevelnaclMaximumEnableFontSubsettingiCompactFontSubsettingnaTrueUseXRefStreamiUseObjectStreamsnaTrue, zgodnie z ISO 32000-1 §7.5.7 i §7.5.8- Limit obiektów na kontener na 250 zamiast zwykłych 100, chyba że już ustawiłeś własny przez
ConfigureAdaptiveObjectStreamPacking
Strumienie obiektów potrzebują PDF 1.5, więc starszy Version jest podnoszony do 1.5, gdy wersja nie jest zablokowana. PDF/A-1 zakazuje strumieni odwołań krzyżowych i obiektów wprost, więc dokument PDF/A-1 trzyma klasyczną tabelę odwołań krzyżowych i dostaje tylko robotę Flate i fontów. Obrazy są zapisywane dokładnie tak, jak je osadziłeś; nic nie jest przepróbkowane ani rekompresowane ze stratą
var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.AutoLaunch := False;
    Pdf.FileName := 'invoice-2026-1042.pdf';
    Pdf.CompressDocument := True;    // aplikowane przez BeginDoc, cofane przez EndDoc
    Pdf.BeginDoc;
    Pdf.CurrentPage.SetFont('Arial', [], 12);
    Pdf.CurrentPage.TextOut(40, 40, 0, 'Invoice 2026-1042');
    Pdf.CurrentPage.SetFont('SimSun', [], 12);
    Pdf.CurrentPage.TextOut(40, 60, 0, WideString(#$5408#$8BA1));
    Pdf.EndDoc;
  finally
    Pdf.Free;
  end;
end;
Przywracanie biegnie w najbardziej zewnętrznym finally EndDoc. To ma znaczenie dla komponentu, który mieszka w module danych i pisze setki raportów dziennie: wyjątek w połowie jednego raportu nie zostawia następnego zadania biegnącego przy maksymalnej kompresji z wymuszonym subsetowaniem. Sama właściwość CompressDocument zostaje True, więc następny dokument dostaje to samo traktowanie, a wracają tylko pożyczone ustawienia
Wersja dostaje ostrożniejszą obsługę. HotPDF cofa własne podniesienie do 1.5 tylko, jeśli dokument nadal kończy na 1.5. Gdy inna funkcja wepchnie plik wyżej w trakcie biegu (osadzony font OpenType potrzebujący 1.6, powiedzmy), wyższa wersja zostaje, czyli dokładnie ten wynik, jaki byłby bez kompresji. Dla długowiecznego komponentu to bezpieczniejszy projekt niż ustawianie sześciu właściwości ręcznie raz przy starcie, bo ręcznie ustawione wartości zostają przy każdym późniejszym zadaniu, także przy edytowalnych
Przycinanie składni, offsetów i pakowania strumieni obiektów
Gdy fonty i strumienie są małe, słowniki i dane odwołań krzyżowych stają się największym pozostałym kosztem, a pisarz strumieni obiektów używany przez CompressDocument przycina też je. Format kontenera sam w sobie jest omówiony w przewodniku po strumieniach obiektów i zapisach inkrementalnych. Na nim ścieżka kompresji dodaje cztery udoskonalenia:
- Kompaktowa składnia wg ISO 32000-1 §7.2.2: spacja jest zapisywana tylko tam, gdzie dwa tokeny zlałyby się jako zwykłe znaki, więc
/Type /Pagestaje się/Type/Page - Pola strumienia odwołań krzyżowych używają dowolnej szerokości, na jaką pozwala §7.5.8.2, więc plik poniżej 16 MB trzyma każdy offset w 3 bajtach zamiast 4
- Aż 250 obiektów wchodzi do każdego strumienia obiektów; mniej, większych kontenerów daje Flate'owi więcej powtórzeń do roboty
- W niezaszyfrowanym pliku Catalog i słownik Info też są pakowane do strumieni obiektów, a szyfrowane wyjście trzyma je na poziomie najwyższym
Kompaktowa składnia spotyka się z czymkolwiek, co łata plik przez przeszukiwanie jego tekstu. Podpisywanie to oczywisty przypadek. Wartość podpisu jest wpisywana po zapisaniu pliku, przez odnalezienie literalnych placeholderów /ByteRange ( i /Contents < w bajtach wyjścia. Zapisane kompaktowo stają się /ByteRange( i /Contents<, a literalne szukanie nigdy ich nie znajdzie. HotPDF pisze więc słowniki podpisów (Type Sig albo DocTimeStamp, albo FT Sig) i słownik szyfrowania z układem ze spacjami. Każdy własny skrypt po zapisie, który grepuje za /Type /Page albo podobnymi tokenami ze spacjami, potrzebuje wzorca tolerującego brakującą spację
Czy da się skompresować PDF już załadowany
Tak. Wariant z opcjami, CompressLoadedDocument(Options, AInfo), puszcza te same bezstratne kroki na istniejącym pliku. Przy THPDFLoadedDocumentCompressionOptions.Default usuwa nieużywane zasoby stron, scala identyczne fonty i form XObjecty, subsetuje osadzone fonty z kompaktowymi podzbiorami, rekompresuje strumienie nieprzefiltrowane, Flate, LZW, ASCII85, ASCIIHex i RunLength Flate'em, gdy tylko wynik jest mniejszy, i przełącza następny zapis na strumienie obiektów. HighRatioFlate jest domyślnie wyłączony, a strumienie obiektów są pomijane dla PDF/A-1 i dla zapisów inkrementalnych. Bezparametrowy wariant CompressLoadedDocument to węższe wywołanie: tylko kompresuje Flate'em strumienie składowane bez kompresji
var
  Doc: THotPDF;
  Options: THPDFLoadedDocumentCompressionOptions;
  Info: THPDFLoadedDocumentCompressionInfo;
begin
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    Doc.LoadFromFile('quarterly-report.pdf');
    Options := THPDFLoadedDocumentCompressionOptions.Default;
    // Options.AllowSignatureInvalidation := True;  // tylko jeśli utrata podpisów jest do przyjęcia
    Doc.CompressLoadedDocument(Options, Info);
    if Info.RefusedBySignaturePolicy then
      Writeln(Format('Left untouched: %d signature fields', [Info.SignatureCount]))
    else
    begin
      Writeln(Format('Compact fonts: %d, bytes saved before object streams: %d',
        [Info.Fonts.CompactSubsetFontCount, Info.BytesSaved]));
      Doc.SaveLoadedDocument('quarterly-report-compact.pdf');
    end;
  finally
    Doc.Free;
  end;
end;
Podpisane pliki są obsługiwane jako jedna decyzja. Każdy krok przepisuje bajty, które podpis obejmuje, więc dokument z polami podpisów jest odrzucany w całości: wywołanie zwraca 0, ustawia RefusedBySignaturePolicy i niczego nie zmienia. Ustawienie AllowSignatureInvalidation pozwala robocie biec dalej, a Info.SignaturesInvalidated rejestruje wtedy, że podpisy już się nie weryfikują. Zostaw tę opcję wyłączoną w zadaniach wsadowych. Folder kontraktów kompresowany nocą to złe miejsce, by odkryć, że połowa z nich niesie podpisy
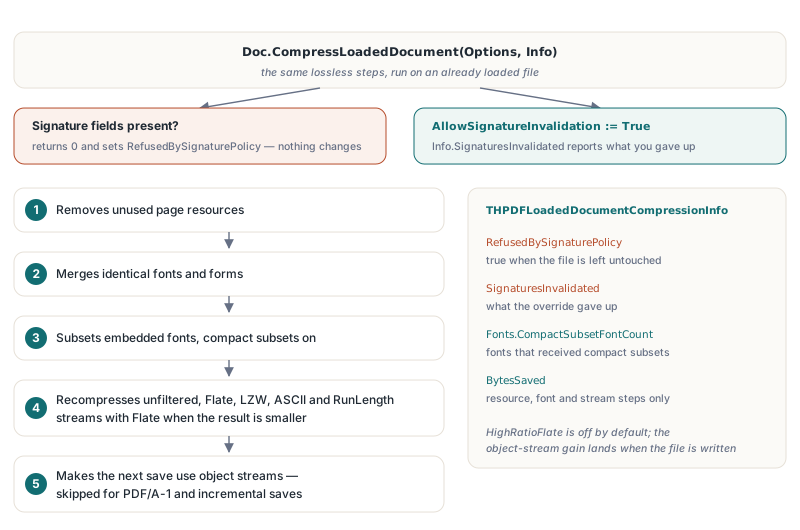
Kompaktyzacja na ścieżce ładowania jest ostrzejsza niż na ścieżce tworzenia, z powodu, która wychodzi prosto z formatu pliku. Do czasu subsetowania fontów dekoder już zamienił każdy CID w GID przez to, jakie /CIDToGIDMap niesie plik, ale nowa kompaktowa mapa musi być indeksowana CID-em. Obie układają się tylko wtedy, gdy CID równa się GID. HotPDF kompaktuje więc program fontu tylko, gdy każdy font go używający to CIDFontType2 z Identity /CIDToGIDMap. Programy, które mają już strumień mapy, proste fonty TrueType i fonty z /CIDSet dostają rzadki subset. Fachy z tabelami kolorowych glifów (COLR, sbix, CBDT albo SVG) też, bo kompaktowa przebudowa trzyma tylko tablice konturów i wyrzuciłaby warstwy koloru
Czytaj Info.BytesSaved za to, czym jest. Sumuje kroki zasobów, fontów i strumieni, podczas gdy zysk strumieni obiektów wychodzi dopiero, gdy SaveLoadedDocument zapisuje plik, więc porównuj rozmiary plików na dysku po pełną liczbę
Kopie ostateczne kontra dokumenty, które jeszcze się zmieniają
Zyski nadążają za tym, ile pliku to nieskompresowana struktura i przewymiarowane dane fontów, a liczba stron ma tu mało do rzeczy. Dla trójstronicowego dokumentu z mieszanym tekstem angielskim i chińskim w Arialu i SimSun z oboma fontami w pełni osadzonymi nieskompresowany plik sięga około 10 MB; wygenerowany z CompressDocument wychodzi z grubsza 20 KB, z większością spadku z subsetowania fontów, a CompressLoadedDocument ląduje w tym samym przedziale dla nieskompresowanego oryginału. PDF już kompaktowy ledwo drgnie. Pliki pełne fotografii zyskują niewiele, bo żadna ze ścieżek nie rusza danych obrazów
Kosztem jest edytowalność. Font podzbioru potrafi pokazać tylko znaki, których dokument już używa, więc AcroForm, który ktoś wypełni później, albo inkrementalna edycja dodająca nowy tekst tym samym fontem może trafić w brakujące glify. Spakowane strumienie obiektów przestają być też czytelne w edytorze tekstu, co spowalnia każdą sesję debugowania zaczynającą się od otwarcia PDF-a w Notatniku. Włącz CompressDocument dla kopii ostatecznych: zarchiwizowane faktury, wyciągi, wszystko, co jest generowane raz i potem tylko czytane. Dla szablonów i formularzy, które ktoś niżej w potoku będzie wypełniał, zostaw wyłączone i trzymaj pełne fonty
Jeśli generujesz te same raporty CJK co noc, sparuj kompaktowe podzbiory z trwałym cache podzbiorów fontów na dysku, żeby robota subsetowania nie była odkręcana przy każdym biegu. A gdy porównujesz dwa nocne wyjścia, diffuj je po zawartości obiektów. Jedno zmienione pole prze-Flate'owuje cały swój strumień obiektów, więc diff bajtowy pokazuje znacznie więcej zmiany niż faktycznie zaszło
Szczegóły właściwości, rekordów i opcji dla wszystkiego powyżej są w referencji na stronie produktu HotPDF Delphi PDF component