Dodajesz nowy zakres etykiet do instrukcji dostawcy, żeby aneks czytał się App-a, App-b zamiast A-1, A-2, zapisujesz i otwierasz plik ponownie. Pole strony nadal mówi A-1. Otwórz katalog w edytorze tekstu, a słownik /PageLabels pokaże powód: niesie tablicę /Kids odziedziczoną od producenta i tuż obok świeżą tablicę /Nums z twoim zakresem. ISO 32000-1 pozwala korzeniowi drzewa numerycznego mieć jeden z tych kluczy albo drugi, a czytnik, który znajdzie /Kids na korzeniu, schodzi w nie i dalej nie patrzy
Jak PDF przechowuje zakresy etykiet stron
Etykiety stron to łańcuchy, które przeglądarka pokazuje w swoim polu strony zamiast fizycznego indeksu strony, a ISO 32000-1 §12.4.2 trzyma je w drzewie numerycznym pod kluczem katalogu /PageLabels. Każdy klucz to liczony od zera indeks strony, gdzie zaczyna się zakres etykietowania. Każda wartość to słownik etykiety z co najwyżej trzema wpisami: /S dla stylu numeracji (D, R, r, A albo a), /P dla łańcucha prefiksu i /St dla numeru pierwszej strony w zakresie, domyślnie 1. Zakres biegnie do następnego klucza. Specyfikacja wymaga też wpisu dla indeksu strony 0, więc każda strona w dokumencie wpada do jakiegoś zakresu
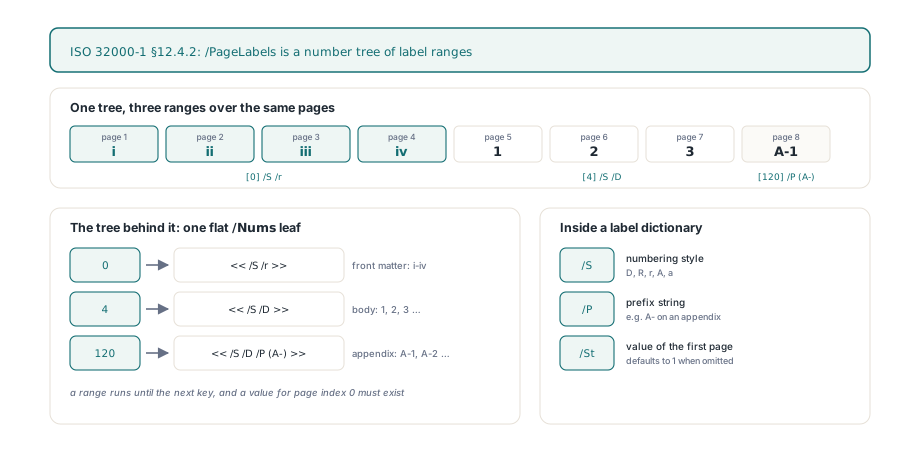
W PDF Library for Delphi piszącym jest TPDFlib.AddPageLabels(Start, Style, Offset, Prefix) i mapuje się on na ten słownik trzema regułami wartymi zapamiętania. Start jest liczony od 1 jak każdy inny argument strony w tej bibliotece i trafia do drzewa jako Start - 1. Style biegnie od 0 do 5: 0 nie zapisuje żadnego /S, więc etykieta to sam prefiks (wygodne dla pojedynczej strony oznaczonej Cover), a 1 do 5 stają się D, R, r, A i a. Styl poza 0..5 każe wywołaniu zwrócić 0 i zostawia dokument nietknięty. Offset staje się /St tylko, gdy jest większy od zera; podaj 0, a klucz jest pomijany, co każdy czytnik interpretuje jako 1
Typowa książka z programu składu potrzebuje trzech zakresów: małych liczb rzymskich dla przedmowy, liczb arabskich dla korpusu i opatrzonego prefiksem aneksu
uses
  PDFlibrary;

var
  Lib: TPDFlib;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('handbook.pdf', '') <> 1 then
      Exit;
    // Strony 1-4: i, ii, iii, iv (rzymskie małe)
    Lib.AddPageLabels(1, 3, 1, '');
    // Strony 5-120: 1, 2, 3 ... (dziesiętne, od nowa od 1)
    Lib.AddPageLabels(5, 1, 1, '');
    // Strony 121 wzwyż: A-1, A-2 ... (dziesiętne z prefiksem)
    Lib.AddPageLabels(121, 1, 1, 'A-');
    WriteLn(Lib.GetPageLabel(5));    // 1
    WriteLn(Lib.GetPageLabel(122));  // A-2
    Lib.SaveToFile('handbook-labeled.pdf');
  finally
    Lib.Free;
  end;
end;
Etykiety stron przyszły z PDF 1.3, więc każde wywołanie prosi też dokument o podniesienie wersji wyjściowej co najmniej do 1.3. Jeśli przypiąłeś wersję przez LockSaveVersion, ta prośba jest ignorowana i blokada trzyma, bo biblioteka nie unieważnia wersji, którą wybrałeś celowo. Jeśli już blokujesz, blokuj na 1.3 lub wyższej w każdym zadaniu, które pisze etykiety
Dlaczego nowy zakres znika, gdy korzeń ma /Kids?
Zakres znika, bo ISO 32000-1 §7.9.7 (Tabela 37) daje korzeniowi drzewa numerycznego /Kids albo /Nums, nigdy oba, a czytniki wybierają /Kids, gdy jest obecne. Producenci piszący długie dokumenty często rozdzielają drzewo na węzły pośrednie, każdy z parą /Limits, i wieszają je na korzeniu, który ma tylko /Kids. Rutyna wstawiania, która zna tylko /Nums, patrzy na ten korzeń, nie znajduje tablicy, tworzy jedną obok istniejących /Kids i wrzuca tam nowy zakres. Zapis się udaje. Plik daje się nadal sparsować. Każda przeglądarka schodzi potem przez /Kids, widzi oryginalne trzy zakresy producenta i nigdy nie dotyka obcej tablicy — to dokładnie objaw instrukcji dostawcy z akapitu otwierającego
Wyjście polega na tym, by przestać traktować korzeń jako pojemnik, który mógłby wyrastać w drugi punkt wejścia. Gdy AddPageLabels znajduje /Kids na korzeniu, najpierw obchodzi każdy liść istniejącego drzewa od lewej do prawej i zbiera każdy klucz z jego słownikiem etykiety, potem buduje z tej listy jedną płaską tablicę /Nums. /Kids, /Limits i ewentualne pozostałe /Nums są usuwane z korzenia, zanim płaska tablica zostanie przyczepiona, i dopiero wtedy nowy zakres wchodzi zwykłym sortowanym wstawieniem. Usuwanie /Limits też ma znaczenie: Tabela 37 dopuszcza ten wpis tylko na węzłach pośrednich i liściach, a korzeń, który go trzyma, jest zniekształcony, nawet jeśli teraz niesie /Nums
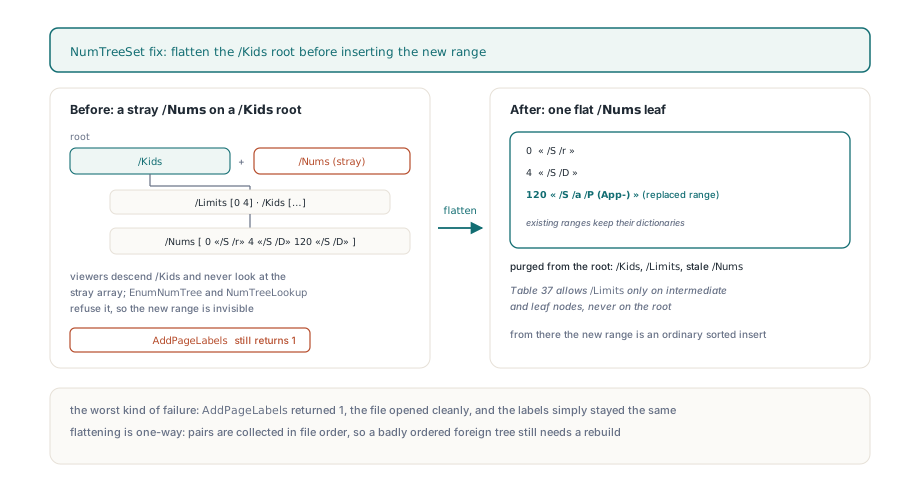
Jeden efekt uboczny łatwo przeoczyć. Jeśli plik dociera do ciebie już zepsuty, z oboma kluczami na korzeniu, bo jakieś wcześniejsze narzędzie zrobiło naiwne wstawienie, obchód liści podąża za /Kids dokładnie tak jak przeglądarka, więc zakresy z obcej tablicy nie są przenoszone. Przeglądarka nigdy tych zakresów nie pokazała, więc etykiety po edycji zgadzają się z tym, co czytniki już widziały
Spłaszczone drzewo nie jest potem przebudowywane na zbalansowane węzły /Kids i uważamy to za właściwy wybór dla tego konkretnego drzewa. Balansowanie opłaca się w drzewach nazw z tysiącami celów albo osadzonych plików. Drzewo etykiet stron ma jeden wpis na zakres etykietowania, a nawet duży podręcznik referencyjny rzadko potrzebuje więcej niż kilkudziesięciu; pojedynczy liść pisze też większość producentów, gdy nie rozdzielają dla samego rozdzielania. Przebieg rebalansowania dodałby kod, który może zapaść przy każdym zapisie, za zysk w wyszukiwaniu, którego nikt nie zmierzy na tak małym drzewie
// Przemianowanie aneksu w pliku, którego korzeń /PageLabels używa /Kids
if Lib.LoadFromFile('vendor-manual.pdf', '') = 1 then
begin
  WriteLn('Before: ', Lib.GetPageLabel(121));  // np. A-1
  // Ta sama strona startowa co istniejący zakres, więc jego wartość jest zastępowana
  if Lib.AddPageLabels(121, 5, 1, 'App-') = 1 then
  begin
    WriteLn('After: ', Lib.GetPageLabel(121));  // App-a
    WriteLn('Front: ', Lib.GetPageLabel(2));    // ii, bez zmian
    Lib.SaveToFile('vendor-manual-relabeled.pdf');
  end;
end;
Bo nowy zakres startuje na tym samym indeksie strony co istniejący klucz, wstawienie zastępuje słownik tego klucza zamiast dodawać drugi wpis dla indeksu strony 120. Zakresy rzymskie i dziesiętne z liści producenta przechodzą ze swoimi oryginalnymi słownikami, łącznie z wartościami /St
Obchód liści musi też przetrwać zniekształcone drzewa. Wpis /Kids wskazujący z powrotem na własnego przodka albo dwie gałęzie dzielące liść wypada w plikach z uszkodzonych potoków. Przejście pamięta, które węzły już odwiedziło, więc cykl jest obchodzony raz i potem zostawiany, a wspólny liść wnosi swoje zakresy raz. Te same troski dla drzew nazw opisuje obsługa cykli drzew nazw, złych /Limits i dużych liści
Obchodzenie tablicy /Nums parami
Tablica /Nums to płaski bieg naprzemiennych wpisów, [key0 value0 key1 value1 ...], i tylko parzyste pozycje są kluczami. Ten układ zaprasza klasyczny błąd. Pętla, która stępuje po jednym elemencie i pyta "czy to liczba?", będzie porównywać wartości tak, jakby były kluczami, kiedy tylko któraś wartość akurat jest liczbowa. Jeśli to porównanie wygra test na mniej niż, punkt wstawienia ląduje na nieparzystym indeksie, nowa para wchodzi w środek istniejącej, a każdy późniejszy klucz i wartość zamieniają się miejscami
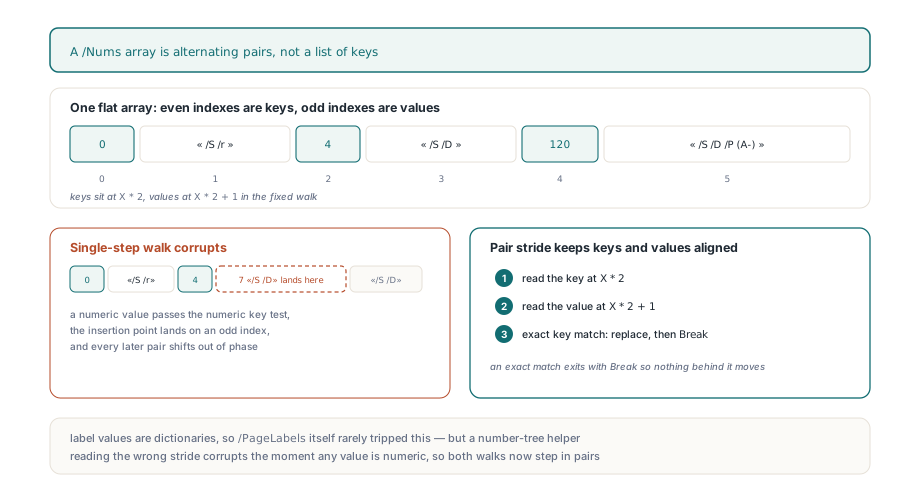
Wartości etykiet stron to słowniki, więc błąd chowa się na samym /PageLabels. Wychodzi na jaw dnia, gdy ten sam helper zostaje ponownie użyty dla drzewa numerycznego, którego wartościami są zwykłe liczby, a nic w składni tablicy nie ostrzega cię, który rodzaj trzymasz. PDF Library for Delphi czyta klucze na indeksie X * 2 i wartości na X * 2 + 1 i w obchodzie liści, i we wstawianiu, a dokładne trafienie klucza zastępuje wartość i zatrzymuje skan. Jeśli piszesz własny kod drzewa numerycznego na surowych obiektach, skopiuj ten krok, zanim cokolwiek innego
Odczyt etykiet z powrotem przez GetPageLabel
TPDFlib.GetPageLabel(Page) zwraca etykietę dla strony liczonej od 1, a jego dwa fallbacki zachowują się różnie celowo. Dokument bez jakiegokolwiek wpisu /PageLabels zwraca dziesiętny numer strony, więc wołający może używać funkcji bezwarunkowo do wyświetlania. Dokument, który ma drzewo, ale żaden zakres nie pokrywa żądanej strony, zwraca pusty łańcuch. Ten drugi przypadek produkuje plik, który pomija obowiązkowy wpis dla indeksu strony 0: pierwsze strony nie mają etykiety w sensie specyfikacji, a pusty łańcuch zgłasza to uczciwiej niż zmyślony numer. Zawsze zaczynaj swój zestaw etykiet na stronie 1
Style literowe podążają za specyfikacją PDF, a nie za kolumnami arkusza kalkulacyjnego. Po Z przychodzi AA, potem BB, potem CC; litera się powtarza zamiast przenosić, więc strona 53 zakresu A to AAA. Liczby rzymskie są generowane wielkimi literami dla R i małymi dla r, a prefiks jest dodawany z przodu bez zmian w obu przypadkach
var
  P: Integer;
  Data: WideString;
begin
  // Szybki audyt tego, co przeglądarka pokaże w swoim polu strony
  for P := 1 to Lib.PageCount do
    WriteLn(P, ' -> ', Lib.GetPageLabel(P));

  // Wartość opcji 4 eksportuje tylko zakresy etykiet, jeden blok PageLabelBegin
  // na zakres
  Data := Lib.ExportDocumentData(4);
  // ... edytuj tekst albo przenieś go do innego pliku ...
  // Pierwszy rekord etykiety czyści istniejące zakresy, potem każdy rekord
  // jest odtwarzany przez AddPageLabels; zwraca liczbę zastosowanych rekordów
  WriteLn(Lib.ImportDocumentData(Data, 4), ' label ranges applied');
end;
Przy edycjach hurtowych ExportDocumentData z wartością opcji 4 zapisuje każdy zakres jako blok PageLabelBegin, po którym następują wiersze PageLabelNewIndex (startowa strona liczona od 1), PageLabelStart, opcjonalny PageLabelPrefix i PageLabelNumStyle, z nazwami takimi jak LowercaseRomanNumerals i DecimalArabicNumerals. ImportDocumentData traktuje pierwszy napotkany rekord etykiety jako pełne zastąpienie: woła raz ClearPageLabels, co usuwa cały wpis /PageLabels z katalogu, a potem podaje każdy rekord do AddPageLabels. Przebudowane drzewo od początku jest pojedynczym liściem, więc tekstowa podróż w obie strony przez oryginał w kształcie /Kids wraca w tej samej płaskiej formie, którą produkuje droga przemianowania
Kolejność liści i przesunięcia stron po przemianowaniu
Spłaszczanie trzyma zakresy w kolejności, w jakiej je znajduje. §7.9.7 wymaga kluczy w kolejności rosnącej, ale pliki z liśćmi poza kolejnością krążą, a GetPageLabel stosuje ostatni zakres w tej kolejności, którego klucz jest na indeksie strony lub poniżej. Dla pliku, który deklaruje swoje zakresy jako [0 roman, 120 A-, 4 decimal], z zakresem dziesiętnym startującym na 1, strona 122 rozwiązuje się do zakresu dziesiętnego i czyta 118 tam, gdzie oczekiwałeś A-2. Jeśli audyt strona po stronie powyżej pokazuje takie etykiety, nie łataj ich dookoła kolejnym wywołaniem AddPageLabels. Wołaj ClearPageLabels i zapisz pełny zestaw od nowa w kolejności rosnącej; cztery wywołania są tańsze niż rozmyślanie, który zakres wygra
Etykiety są też związane z indeksami stron, nie z obiektami stron. Cokolwiek zmienia liczbę albo kolejność stron, zostawia zakresy dokładnie tam, gdzie były, wskazujące na cokolwiek, co teraz siedzi na tych indeksach. Podmiana w miejscu, jak zastępowanie stron z zachowaniem numerów obiektów, trzyma liczbę, więc etykiety zostają wyrównane. Scalanie jak kolacjonowanie przeplatanych skanów dwustronnych produkuje nową sekwencję stron, a jej wynik powinien dostać świeżo wypisany zestaw zakresów po scaleniu, startujący na stronie 1
Wywołania etykiet, spłaszczanie /Kids oraz pokazany tu eksport i import danych dokumentu są częścią PDF Library for Delphi, celującej w Delphi, C++Builder i Lazarus; jej wpis referencyjny dla AddPageLabels wylicza wartości stylów i kody zwrotne w jednej tabeli