Zbuduj PDF, którego drzewo nazw /Dests ma korzeń z dwoma dziećmi. Pierwsze dziecko deklaruje /Limits [(a) (z)], a jego tablica /Kids wskazuje wprost z powrotem na korzeń. Drugie dziecko trzyma prawdziwy wpis dla (chapter7), ale jego limity są zapisane na odwrót: [(z) (a)]. Zapytaj podręcznikowy lookup drzewa nazw o chapter7, a on albo rekursuje się, aż stack się skończy, albo zwraca „nie znaleziono” dla celu, do którego przeglądarka potrafi skoczyć. Cały plik mieści się w około dwóch kilobajtach i każdy obiekt w nim parsuje się czysto
Ten plik pakuje trzy osobne pułapki w jedną strukturę: cykl /Kids, zakres obiecujący klucz, którego nie trzyma, i zakres, który nie może niczego dopasować nigdy. Czwarta pułapka potrzebuje dużo większego pliku. Gdy pojedynczy liść niesie ponad 32 768 par nazwa/wartość, każdy kod, który wciśnie „który liść” i „który wpis” w jeden integer 32-bitowy, zaczyna wskazywać na złą parę. Reszta artykułu przechodzi przez każdą pułapkę, to, co czytelnik powinien z nią zrobić, i jak wywołania Delphi zachowują się na plikach zbudowanych tak jak tu
Cztery funkcje PDF, które siedzą na drzewach nazw i drzewach liczb
Drzewa nazw i drzewa liczb podpierają każdą funkcję PDF, która mapuje duży zbiór kluczy na obiekty, a PDFlibPas, biblioteka losLab PDF Library for Delphi, wystawia cztery z nich przez publiczne metody TPDFlib. ISO 32000-1 §7.9.6 definiuje drzewo nazw (klucze stringowe, Tabela 36), a §7.9.7 drzewo liczb (klucze integerowe, Tabela 37). Korzeń i węzły pośrednie niosą /Kids; liście niosą posortowane pary klucz/wartość w /Names albo /Nums; każdy węzeł nie-korzeń ma rzekomo nieść dwuelementową tablicę /Limits z najmniejszym i największym kluczem pod spodem
| Drzewo | Gdzie mieszka | Specyfikacja | API odczytu w PDFlibPas |
|---|---|---|---|
| Nazwane cele | /Dests w słowniku nazw | §12.3.2.3 | GetNamedDestination, potem GetDestPage / GetDestType |
| Etykiety stron | /PageLabels w katalogu (drzewo liczb) | §12.4.2 | GetPageLabel |
| Załączniki | /EmbeddedFiles w słowniku nazw | §7.7.4, §7.11.4 | EmbeddedFileCount, GetEmbeddedFileStrProperty |
| JavaScript na poziomie dokumentu | /JavaScript w słowniku nazw | §7.7.4 | GlobalJavaScriptCount, GlobalJavaScriptPackageName |
Dwa wiersze kryją haczyk. Nazwane cele istnieją też w starszej formie z PDF 1.1 — zwykły słownik /Dests w katalogu kluczowany obiektami nazw — a GetNamedDestination sprawdza najpierw ten słownik i dopiero potem schodzi po drzewie nazw z PDF 1.2. Wiersz JavaScript ma imiennika, który czyta coś zupełnie innego: GetDocJavaScript zwraca skrypty przypięte do wyzwalaczy dokumentu w słowniku /AA katalogu (WS, DS, WP, DP, DC), podczas gdy nazwane pakiety odpalane przy otwarciu dokumentu mieszkają w drzewie nazw /JavaScript i są wypisywane przez GlobalJavaScriptPackageName
Wszystkie te struktury pochodzą z pliku. Specyfikacja mówi piszącemu, co ma wyprodukować, a czytelnik i tak dostaje to, co koder, zepsuty zapis przyrostowy albo fuzzer faktycznie tam zostawili. To ta sama lekcja co hartowanie pascalowego parsera PDF przeciw złośliwym plikom, zastosowana do kształtu drzewa zamiast długości buforów
Dlaczego cykliczna tablica /Kids wywala rekurencyjnego obchodziacza drzewa?
Rekurencyjny obchodziacz wywala się na cyklicznej tablicy /Kids, bo nic w rekursji nie pamięta, które węzły już odwiedziła, więc jedna referencja dziecka na przodka zamienia skończony plik w bezkońcowy zstęp. Legalne drzewo potrafi narobić tych samych szkód bez żadnego cyklu: łańcuch 4096 poziomów węzłów z pojedynczym dzieckiem to poprawna składnia, która kosztuje rekurencyjnego czytelnika 4096 ramek stacka
Łagodniejszy wariant w ogóle nie wywala. Gdy dwa wpisy /Kids wskazują ten sam liść, naiwna enumeracja odwiedza go dwa razy, więc licznik załączników wraca wyższy niż liczba plików w dokumencie, a lista skryptów pokazuje ten sam pakiet podwójnie
PDFlibPas obchodzi oba rodzaje drzew jawnym stackiem LIFO na heapie plus zbiorem odwiedzonych kluczowanym tożsamością słownika. Węzeł jest znacznikowany w chwili zdjęcia ze stacka. Cykliczna referencja może posiedzieć na stacku chwilę, ale jest wyrzucana, jak tylko wraca na wierzch, a każdy odrębny węzeł rozwija swoje dzieci dokładnie raz. Cała praca jest ograniczona przez liczbę odrębnych słowników plus łączną długość ich tablic /Kids; łańcuch 4096 poziomów staje się 4096 iteracjami pętli i 4096 wpisami hash-setu
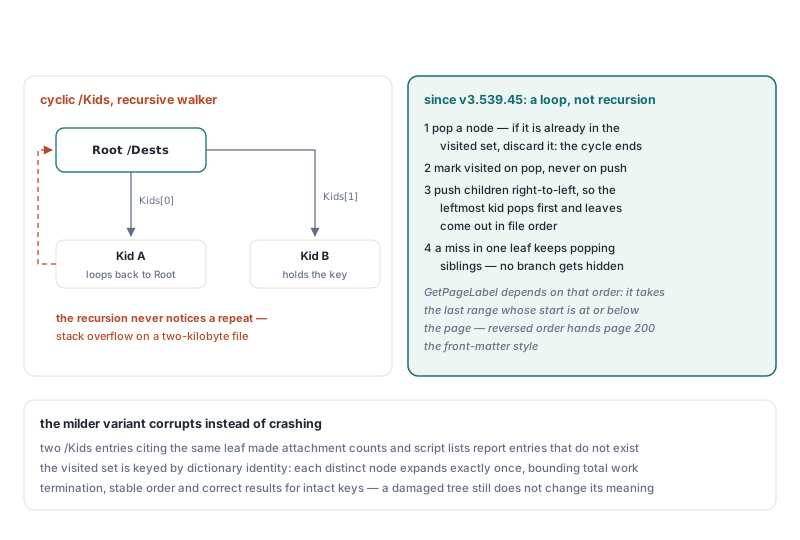
Kolejność to część, którą ludzie gubią przy zamianie rekursji w pętlę. Stack odwraca cokolwiek mu podasz, więc dzieci trzeba pchać od ostatniego indeksu do pierwszego; wtedy lewe dziecko zdjęte zostaje pierwsze, a liście wychodzą w kolejności od lewej do prawej, którą zapisał producent. Znacznikowanie przy zdjęciu zamiast przy pchnięciu ma znaczenie z tego samego powodu. Przy znacznikach na pchnięciu i pchnięciach od prawej do lewej liść wspólny dla pozycji 0 i 2 zostałby zapisany na pozycję 2, a jego wpisy pojawiłyby się później, niż mówi plik. Etykiety stron zależą od tej kolejności, jak pokazuje ostatnia sekcja
Jeśli piszesz własny kod drzewa przeciw innemu modelowi obiektów, to jest kształt, który rekomendujemy. Typ węzła poniżej jest celowo abstrakcyjny, a obie funkcje to kod po stronie czytelnika, nie wywołania biblioteki
uses
  System.Generics.Collections;

type
  TTreeNode = class
  public
    Kids: TArray<TTreeNode>;   // pusta w liściu
    Keys: TArray<string>;      // klucze liścia, posortowane przez grzecznego producenta
    Values: TArray<Integer>;   // równoległe do Keys
    HasLimits: Boolean;
    LoKey, HiKey: string;
  end;

// Twój własny helper: /Limits może przycinać tylko, gdy jest dobrze uformowaną, uporządkowaną parą
function LimitsExclude(Node: TTreeNode; const Key: string): Boolean;
begin
  Result := Node.HasLimits and (Node.LoKey <= Node.HiKey) and
    ((Key < Node.LoKey) or (Key > Node.HiKey));
end;

// Twój własny lookup: jawny stack, zbiór odwiedzonych, znacznik przy zdjęciu
function FindValue(Root: TTreeNode; const Key: string;
  out Value: Integer): Boolean;
var
  Pending: TList<TTreeNode>;
  Visited: TDictionary<TTreeNode, Byte>;
  Node: TTreeNode;
  I: Integer;
begin
  Result := False;
  Value := 0;
  if Root = nil then
    Exit;
  Pending := TList<TTreeNode>.Create;
  Visited := TDictionary<TTreeNode, Byte>.Create;
  try
    Pending.Add(Root);
    while Pending.Count > 0 do
    begin
      Node := Pending[Pending.Count - 1];
      Pending.Delete(Pending.Count - 1);
      if Visited.ContainsKey(Node) then
        Continue;                      // cykl albo wspólne dziecko: już widziane
      Visited.Add(Node, 0);
      if Length(Node.Kids) > 0 then
      begin
        // Pchaj od prawej do lewej, żeby lewe dziecko zdjęte było pierwsze
        for I := High(Node.Kids) downto 0 do
          if (Node.Kids[I] <> nil) and not LimitsExclude(Node.Kids[I], Key) then
            Pending.Add(Node.Kids[I]);
      end
      else
        for I := 0 to High(Node.Keys) do
          if (Node.Keys[I] = Key) and (I <= High(Node.Values)) then
          begin
            Value := Node.Values[I];
            Exit(True);
          end;
      // Pudło w tym liściu: dalej zdejmuje rodzeństwo
    end;
  finally
    Visited.Free;
    Pending.Free;
  end;
end;
Pudło w jednej gałęzi nie znaczy nic o drzewie
Najczęstszy skrót lookupa bierze pierwsze dziecko, którego /Limits pokrywa klucz, schodzi w nie i nigdy więcej nie patrzy na rodzeństwo. Na czystym drzewie to poprawne i szybkie. Na pliku z akapitu otwierającego pada: pierwsze dziecko obiecujące chapter7 prowadzi z powrotem do korzenia, a szukanie kończy z pustymi rękami, podczas gdy następne rodzeństwo trzyma wpis
PDFlibPas nie staje przy pierwszej wiarygodnej gałęzi. Keyed lookup za GetNamedDestination pcha każde dziecko, którego zakres nie wyklucza klucza, i zdejmuje dalej ze stacka, aż znajdzie dopasowanie albo stack się opróżni. Na dobrze uformowanym drzewie z rozłącznymi zakresami co najwyżej jedno dziecko przeżywa kontrolę zakresu na każdym poziomie, więc dodatkowy koszt to zero. Na uszkodzonym to garść dodatkowych odwiedzin węzłów, a odpowiedź wraca właściwa
Liście dostają to samo traktowanie. ISO 32000-1 wymaga, by klucze w tablicy /Names były posortowane po wartości bajtów, więc biblioteka próbuje najpierw wyszukiwania binarnego. Gdy ono pudłuje, spada na liniowe przemiatanie par, bo liść w złej kolejności uczyniłby obecnym klucz niewidzialnym. Płacenie za przemiatanie liniowe przy każdym prawdziwym pudle to koszt, który akceptujemy: lookupy po nazwach naprawdę nieobecnych są rzadkie, a fałszywe „nie znaleziono” na działającym łączu kosztuje daleko więcej niż jeden dodatkowy przebieg po liściu
Jedną sprzeczność strukturalną załatwia odmowa. Tabela 36 pozwala węzłowi nieść albo /Kids, albo /Names, nigdy oba. Keyed lookup traktuje węzeł niosący oba jako zniekształcony i go pomija, zamiast zgadywać, którą połowę producent miał na myśli. Enumeracja drzew liczb, jak obchód za GetPageLabel, jest łagodniejsza i przy obecności oba idzie za /Kids, bo zrzucenie całego zakresu błędnie oetykietowałoby każdą stronę po nim
Do czego czytelnik może ufać /Limits?
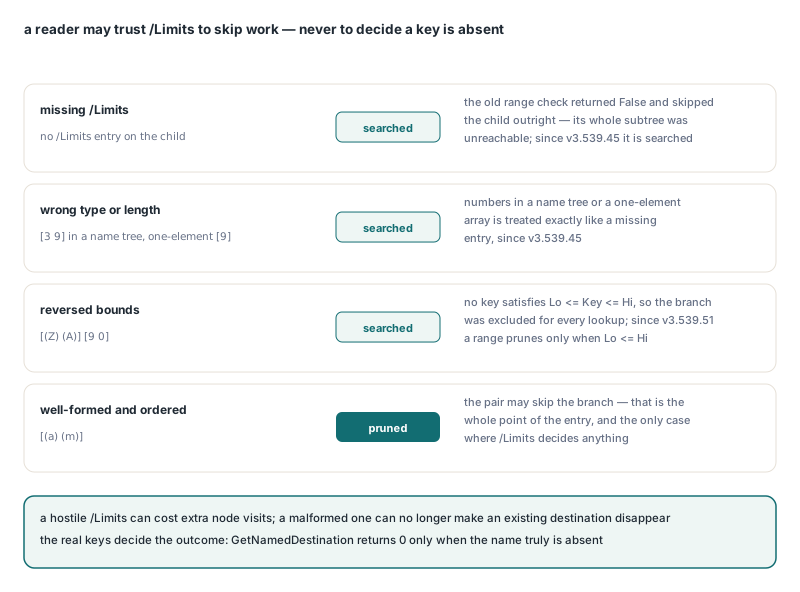
Czytelnik może ufać /Limits do pomijania pracy i tylko, gdy para jest dobrze uformowana; nigdy nie może użyć wpisu do wniosku, że klucz jest nieobecny. Tabela 36 mówi, że węzły pośrednie i liście mają go nieść, ale w praktyce wpis znika po ręcznych edycjach, trzyma liczby wewnątrz drzewa nazw albo przychodzi z zamienionymi granicami. PDFlibPas rozwiązuje każdy z tych przypadków tak samo: dziecko pozostaje przeszukiwalne
- Brakujące
/Limits: kontrola zakresu pomijająca takie dziecko czyniłaby całe jego poddrzewo nieosiągalnym, gdy tylko producent zapomni wpisu, więc dziecko jest przeszukiwane - Zły typ albo zła długość, jak liczby w drzewie nazw albo tablica jednoelementowa: obsługiwane dokładnie jak brakujący wpis
- Odwrócone granice jak
[(Z) (A)]albo[9 0]: żaden klucz nie spełniaLo <= Key <= HiprzyLo > Hi, więc ufaj tej parze a wykluczysz gałąź dla każdego lookupa; zakres przycina tylko, gdy jego dolna granica nie przekracza górnej - Dobrze uformowana i uporządkowana: używana do pomijania gałęzi — po to wpis istnieje
Ze strony wołającego są dwa zera do rozróżnienia. GetNamedDestination zwraca 0, gdy nazwy naprawdę nie ma, a inaczej ID celu. GetDestPage zwracające 0 przy ważnym ID znaczy, że nazwa istnieje, ale jej cel nie rozwiązuje się do strony w tym dokumencie — to inne zgłoszenie błędu. GetDestType donosi widok jako 1 dla XYZ, 2 dla Fit i tak dalej po 8 dla FitBV
uses
  PDFlibrary;

procedure LookUpDestination(const FileName, DestName: string);
var
  Lib: TPDFlib;
  DestID, Page: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(FileName, '') <> 1 then
    begin
      WriteLn('Load failed, error ', Lib.LastErrorCode);
      Exit;
    end;
    // Najpierw katalogowy /Dests (PDF 1.1), potem drzewo nazw /Dests
    DestID := Lib.GetNamedDestination(DestName);
    if DestID = 0 then
    begin
      WriteLn('No destination named ', DestName);
      Exit;
    end;
    Page := Lib.GetDestPage(DestID);
    if Page = 0 then
      WriteLn(DestName, ' exists but does not resolve to a page')
    else
      WriteLn(DestName, ' -> page ', Page,
        ', view type ', Lib.GetDestType(DestID));  // 1 = XYZ, 2 = Fit ...
  finally
    Lib.Free;
  end;
end;
To składa się w zwarty test regresyjny. Zbuduj plik z dwoma dziećmi z akapitu otwierającego, skieruj prawdziwy wpis chapter7 na stronę 2 z widokiem /Fit, a procedura powinna wydrukować stronę 2 z typem widoku 2. Lookup pierwszego dopasowania wydrukuje „No destination”, bo zapętlone dziecko wygrywa wyścig; lookup ufający odwróconym zakresom wydrukuje to samo z odwrotnego powodu. Gdy cele się rozwiązują, wpisy konspektu wskazujące na nie są omówione w czytaniu akcji zakładek i adnotacji PDF w Delphi
Liście ponad 32 768 wpisów i pułapka pakowanego indeksu
Gdy kod potrzebuje jednego integerowego uchwytu dla „wpis N w liściu M”, kuszące kodowanie pakuje pozycję liścia w górne 16 bitów Integer, a offset wewnątrz tablicy /Names tego liścia w dolne 16 bitów. Każda para bierze dwa sloty tablicy. Para o indeksie 32 768 — trzydziesta dwie tysiące siedemdziesiąta dziewiąta — zaczyna więc na offsecie 65 536, czyli $10000. Ten bit przenosi się do górnej połowy, a dekoder czyta go z powrotem jako offset 0 następnego liścia
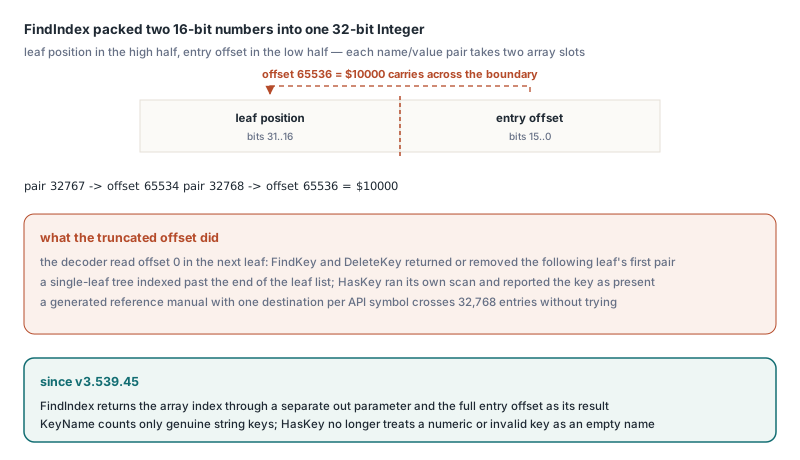
Objawy zależą od kształtu drzewa. Przy pojedynczym liściu nie ma następnego liścia, więc zdekodowany uchwyt indeksuje za koniec listy liści. Przy kilku liściach find albo delete ląduje na pierwszej parze następnego liścia, podczas gdy gołe skanowanie kluczy nadal donosi żądany klucz jako obecny. Pliki tego rozmiaru nie są egzotyczne. Generowana referencja API z jednym nazwanym celem na symbol przekracza 32 768 wpisów szybko, a niektórzy producenci zapisują wszystkie do jednego płaskiego liścia zamiast balansować drzewo
PDFlibPas trzyma pozycję liścia i offset wpisu w dwóch integerach pełnej szerokości, więc żadne nie może się przelewać do drugiego przy jakimkolwiek rozmiarze liścia. Ten sam czytelnik liczy wyłącznie prawdziwe klucze stringowe. Dla liścia takiego jak [(Valid) 42 123 456] EmbeddedFileCount donosi 1, klucz numeryczny 123 nigdy nie zostaje wzięty za pustą nazwę, a indeks 0 albo niższy zwraca pusty string z GetEmbeddedFileStrProperty zamiast cokolwiek obiektu, który akurat idzie dalej. Tag 1 tej funkcji to nazwa pliku, a tag 2 podtyp MIME
procedure AuditTrees(const FileName: string);
var
  Lib: TPDFlib;
  I: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(FileName, '') <> 1 then
      Exit;
    // drzewo liczb /PageLabels; pliki bez niego zwracają gołe numery stron
    for I := 1 to Lib.PageCount do
      WriteLn('Page ', I, ' label: ', Lib.GetPageLabel(I));
    // drzewo nazw /EmbeddedFiles; indeksy od 1, klucze nie-stringowe pomijane
    for I := 1 to Lib.EmbeddedFileCount do
      WriteLn('Attachment ', I, ': ', Lib.GetEmbeddedFileStrProperty(I, 1),
        ' (', Lib.GetEmbeddedFileStrProperty(I, 2), ')');  // nazwa, podtyp MIME
    // drzewo nazw /JavaScript: wypisz nazwy pakietów, nic nie wykonuj
    for I := 1 to Lib.GlobalJavaScriptCount do
      WriteLn('Script package: ', Lib.GlobalJavaScriptPackageName(I));
  finally
    Lib.Free;
  end;
end;
Testowy plik dwustronicowy pokazuje oczekiwane wyjście dobrze. Daj jego korzeniowi /PageLabels tablicę /Kids, która wypisuje jeden liść dwa razy i wskazuje też sam korzeń, z zakresami dla małych rzymskich od strony 1 i dziesiętnych z prefiksem A- od strony 2. Audyt powinien wydrukować i i A-1, każdy zakres nałożony raz. Zapisywanie etykiet stron do takiego drzewa ma własne haczyki, omówione w naprawianiu etykiet stron PDF przechowanych w drzewach liczb /Kids; AddPageLabels spłaszcza korzeń /Kids do pojedynczego liścia /Nums przed wstawieniem, używając tej samej enumeracji bezpiecznej wobec cykli
Gdzie przejście wytycza swoje granice
Przejście gwarantuje zakończenie, stabilną kolejność i poprawne odpowiedzi dla każdego drzewa, którego prawdziwe klucze są nietknięte. Czyta uszkodzone drzewo tak, jak zapisano, i nie próbuje rekonstruować intencji autora, a z tego wyboru płynie pięć konsekwencji
- Tożsamość, nie treść, definiuje węzeł. Dwa odrębne słowniki o identycznych wpisach to dwa węzły, więc producent kopiujący liść zamiast go referencjonować dostaje te wpisy dwa razy
- Dobrze uformowana, uporządkowana para
/Limitsprzycina nawet, gdy jest zła. Zakres kłamiący wiarygodnie, powiedzmy[(a) (m)]nad liściem, który trzyma też(q), ukrywaq. Jedyną obroną byłoby ignorowanie/Limitswszędzie i przemiatanie każdego liścia, a na drzewie celów z dziesiątkami tysięcy wpisów to wyrzuca powód istnienia wpisu. Przycinamy dalej - Enumeracja zachowuje kolejność z pliku.
GetPageLabelobchodzi każdy enumerowany zakres i nakłada ostatni, którego indeks startowy jest na poziomie strony albo poniżej, więc producent zapisujący zakresy w złej kolejności dostaje semantykę kolejności z pliku, a odwrócenie obchodu wręczyłoby stronie 200 styl przedmowy - Pamięć rośnie z liczbą odrębnych węzłów i wpisów. Przejście dokłada jedną listę i jeden hash set ponad sparsowane obiekty
- Zdublowane klucze wewnątrz jednego liścia rozwiązują się deterministycznie: wyszukiwanie binarne zwraca tę pasującą parę, na którą najpierw trafi, a liniowy fallback zatrzymuje ostatnie dopasowanie, które przemiatą
Narzędzia preflight, archiwizery i przeglądarki dokumentów czytają te drzewa, zanim zostanie wyrenderowana choć jedna strona, co stawia je pierwsze w kolejce na cokolwiek przyjdzie z uploadu. Czytniki drzew opisane tu są dostarczane z PDFlibPas, biblioteką PDF Library for Delphi, która buduje i z Delphi, i z Free Pascal