Przełącz testową maszynę Windows na niemieckie ustawienia regionalne, uruchom procedurę, która dokleja macierz skali i przesunięcia do strony, i zrzuć strumień treści. Zamiast 0.5 0 0 0.25 0.00001 12.75 cm dostajesz 0,5 0 0 0,25 1E-5 12,75 cm. Parser treści czyta to jako liczbę 0, potem token ,5, którego nie rozpoznaje, potem kolejne liczby, które już nie pasują do sześciu operandów, jakich oczekuje cm, i strona rysuje się z transformacją, o którą nigdy nie prosiłeś. Liczby, które maszyna będzie parsować, potrzebują stałej kropki, żadnego wykładnika i żadnej zależności od FormatSettings, po stronie zapisu i po stronie odczytu
Dlaczego locale z przecinkiem dziesiętnym łamie liczby PDF?
Locale z przecinkiem dziesiętnym łamie liczby PDF, bo domyślne formatowanie zmiennoprzecinkowe Delphi podąża za pulpitem, podczas gdy składnia liczb PDF jest stała. FloatToStr używa FormatSettings.DecimalSeparator, więc na maszynie de-DE, fr-FR albo pt-BR każdy ułamek wychodzi z przecinkiem. ISO 32000-1 §7.3.3 dopuszcza w liczbie cyfry, jedną kropkę i znak na początku. Nic więcej. Przecinek dzieli więc jedną liczbę na poprawną liczbę całkowitą plus śmieci, a wynikiem jest strona, która się renderuje, tylko źle
Za pierwszą kryje się druga pułapka, i ta kąsa też na maszynach amerykańskich. FloatToStr używa formatu ffGeneral, który przeskakuje na notację wykładniczą, gdy tylko rząd wielkości spadnie poniżej 1E-4, więc malutki offset zostaje zapisany jako 1E-5. Ten sam §7.3.3 mówi, że PDF nie obsługuje formy wykładniczej. Wyśledzenie któregoś z tych problemów od wyjścia renderowanego jest nędzne, bo rozjechana macierz wygląda dokładnie jak błąd układu w twoim własnym kodzie i nic na stronie nie wskazuje na ustawienia regionalne
PDFlibPas, losLab PDF Developer Library for Delphi, zapisuje operandy AddPageMatrix przez PLDoubleToStrConst z sześcioma miejscami dziesiętnymi, i wywołania, które generują treść strony w twoim imieniu, trzymają tę samą regułę. Najtańszy test regresji, jaki znamy, przełącza separator na przecinek wewnątrz procesu, woła API i skanuje wynik pod kątem przecinków i wykładników:
uses
  System.SysUtils, PDFlibrary;

// Twoja własna kontrola, nie część biblioteki. Celowo prymitywna:
// łańcuchy tekstowe, jak (Hello, world) Tj, też zawierają przecinki, więc uruchamiaj ją
// na stronie testowej rysującej tylko kształty
function HasLocaleDamage(const Content: AnsiString): Boolean;
var
  I: Integer;
begin
  Result := False;
  for I := 1 to Length(Content) do
  begin
    if Content[I] = ',' then
      Exit(True);
    if (Content[I] in ['E', 'e']) and (I > 1) and (I < Length(Content)) and
       (Content[I - 1] in ['0'..'9']) and (Content[I + 1] in ['0'..'9', '-', '+']) then
      Exit(True);
  end;
end;

var
  Lib: TPDFlib;
  OldSeparator: Char;
  Content: AnsiString;
begin
  Lib := TPDFlib.Create;
  try
    Lib.SetPageDimensions(300, 200);
    Lib.DrawBox(10, 10, 20, 20, 1);
    OldSeparator := FormatSettings.DecimalSeparator;
    try
      FormatSettings.DecimalSeparator := ',';   // zachowuj się jak pulpit de-DE
      Lib.AddPageMatrix(0.5, 0.25, 1E-5, 12.75);
      Content := Lib.GetPageContentToString;
      // Oczekiwane: 0.5 0 0 0.25 0.00001 12.75 cm
      // FloatToStr wyprodukowałby: 0,5 0 0 0,25 1E-5 12,75 cm
      Writeln(Content);
      if HasLocaleDamage(Content) then
        Writeln('Locale leaked into the content stream');
    finally
      FormatSettings.DecimalSeparator := OldSeparator;
    end;
  finally
    Lib.Free;
  end;
end;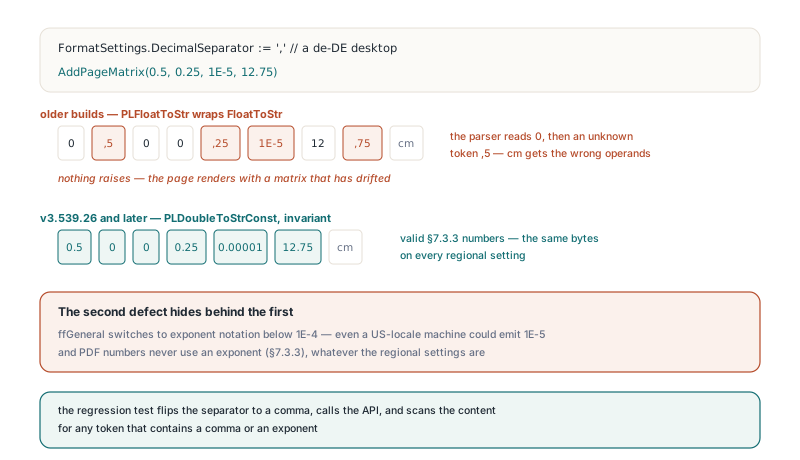
Zmiana FormatSettings.DecimalSeparator w procesie to skrót. Nie ćwiczy kodu, który buduje własny TFormatSettings z systemu operacyjnego, więc jeśli twoja aplikacja tak robi, uczciwszym testem jest agent CI z prawdziwymi niemieckimi ustawieniami regionalnymi
Dwa rodzaje liczb, dwie rodziny helperów
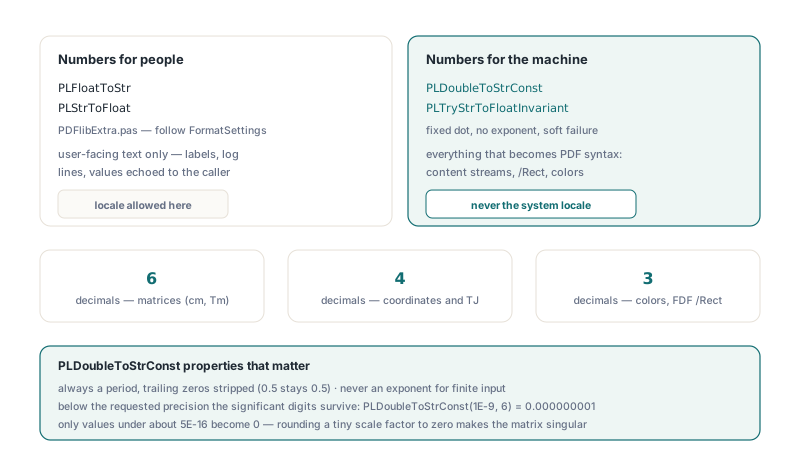
PDFlibPas dzieli swoje helpery liczb według odbiorcy: tekst pokazywany ludziom może podążać za locale, a cokolwiek pisanego dla maszyny nigdy nie podąża. PLFloatToStr i PLStrToFloat w PDFlibExtra.pas to cienkie wrappery nad FloatToStr i StrToFloat, a komentarz przy ich deklaracji mówi wprost, że są tylko do tekstu czytelnego dla człowieka. Wyjście maszynowe (PDF, FDF, XFDF, JSON, XML, CSV) idzie przez niezmienną rodzinę: PLDoubleToStrConst do zapisu, PLTryStrToFloatInvariant do odczytu i PLInvariantFormatSettings, gdy potrzebujesz rekordu TFormatSettings z kropką dziesiętną do własnych wywołań TryStrToFloat
Precyzja jest dobierana per zadanie, nie globalnie. Macierze dostają sześć miejsc, współrzędne i korekty TJ cztery, kolory i prostokąty FDF trzy. Strona zwrócona ku maszynie pokrywa więcej miejsc, niż sugeruje powierzchnia API:
AddPageMatrix,ScalePageiDeskewPage, które wszystkie doklejącmdo istniejącej treści strony- Zerowania
Tm, przesunięciaTJi transformacjecmzapisywane przy generowaniu elementów strony - Matryce pozycjonowania glifów i punkty konturów produkowane przy konwersji tekstu na ścieżki
- Czarna skrzynka wypełnienia, którą dokleja
RedactRegion, wartości/Rectw eksporcie FDF i operandy kolorów, które zapisuje przemalowywanie
PLDoubleToStrConst to formatter pisany ręcznie, i uważamy, że to był dobry wybór wobec opakowania FloatToStrF stałym TFormatSettings. ffFixed wciąż wraca do notacji naukowej, gdy część całkowita przerośnie precyzję, i zostawiłby 0.500000 tam, gdzie 0.5 jest krótsze i identyczne. Własna procedura zawsze pisze kropkę, obcina końcowe zera i nigdy nie pisze wykładnika dla skończonego wejścia. Zachowuje też cyfry znaczące niezerowej wartości mniejszej niż żądana precyzja: PLDoubleToStrConst(1E-9, 6) zwraca 0.000000001, a dopiero wartości poniżej około 5E-16 stają się 0. Zaokrąglenie malutkiego współczynnika skali do zera zamieniłoby poprawną macierz w osobliwą, co jest gorszym niepowodzeniem niż jakikolwiek omyłkowy przecinek dziesiętny
Jeśli piszesz testy jednostkowe wobec formattera, wybieraj wartości przykładowe z myślą o arytmetyce binarnej zmiennoprzecinkowej. Oczywisty wybór dla "czterech cyfr znaczących" to 0.000012345, ale pomnożone przez 1E8 ten double daje 1234.4999…, więc wynikiem jest 0.00001234 i asercja zawodzi z powodu niezwiązanego z locale. Wartość wyraźnie poza punktem środkowym, jak 0.000012346, omija cały spór:
uses
  PDFlibExtra;

// Wywołania Assert to kontrole, które dodajesz we własnym projekcie testowym
procedure CheckNumberHelpers;
var
  V: Double;
begin
  // Wyjście maszynowe: kropka dziesiętna, bez wykładnika, końcowe zera obcięte
  Assert(PLDoubleToStrConst(1E-5, 6) = '0.00001');
  Assert(PLDoubleToStrConst(-0.5, 6) = '-0.5');
  Assert(PLDoubleToStrConst(0.000012346, 4) = '0.00001235');  // 4 cyfry znaczące zachowane
  Assert(PLDoubleToStrConst(12345.25, 4) = '12345.25');

  // Wejście maszynowe: False zamiast EConvertError
  Assert(PLTryStrToFloatInvariant('0.5', V) and (V = 0.5));
  Assert(PLTryStrToFloatInvariant('  12.75 ', V) and (V = 12.75)); // wejście jest przycinane
  Assert(not PLTryStrToFloatInvariant('0,5', V));   // liczby treści nigdy nie używają przecinka
end;
Dlaczego strona parsowania jest groźniejsza niż strona zapisu?
Strona parsowania jest groźniejsza, bo parser związany z locale nie produkuje lekko złej liczby; on rzuca. StrToFloat rzuca EConvertError za każdym razem, gdy tekst nie pasuje do separatora systemu. Przebieg przemalowywania zbudowany na nim abortowałby w chwili, gdy dosięgnie zwykłego operatora 0.5 g na maszynie z przecinkiem, czyli zawodzi na praktycznie każdej prawdziwej stronie. Łańcuch clip taki jak "10.5,20.5,50.5,40.5" byłby odrzucony wprost, a długości i kolory SVG, listy wierzchołków adnotacji i wartości output intent byłyby odrzucane albo po cichu zastępowane domyślnymi. To kod, który przechodzi każdy test na maszynie programisty i zawodzi u pierwszego klienta w Monachium, ta sama rodzina problemów co przypadki z artykułu o kodzie Delphi działającym przez przypadek
Każde wywołanie w stylu StrToFloat w bibliotece jest posegregowane według źródła wejścia. Operandy strumienia treści, atrybuty SVG, łańcuchy kolorów malarza i rozdzielane przecinkiem listy clip oraz wierzchołków mają stałą składnię z kropką, więc przechodzą przez PLTryStrToFloatInvariant. Ten helper przycina tekst, parsuje przez PLInvariantFormatSettings i zwraca False (z wartością ustawioną na 0) dla pustego, zniekształconego, NaN lub nieskończonego wejścia. Listy rozdzielane przecinkiem nie potrzebowały żadnej debaty: przecinek nie może być jednocześnie separatorem listy i znakiem dziesiętnym, więc nie ma starej formy, z którą trzeba zachować zgodność
Dla potoku przemalowywania opisanego w przewodniku po konwersji PDF do jednej przestrzeni kolorów wynik jest taki, że RecolorPage i RecolorDocument parsują treść strony identycznie na każdym locale. Wartości reguł, które wywołujący wpisuje do CheckDocumentPolicy, to jedyny przypadek parsowania idący drogą pobłażliwą, bo ten ciąg wpisał człowiek i mógł równie dobrze użyć lokalnego znaku dziesiętnego
Liczba przepuszczona przez ciąg potrzebuje zgodności obu końców
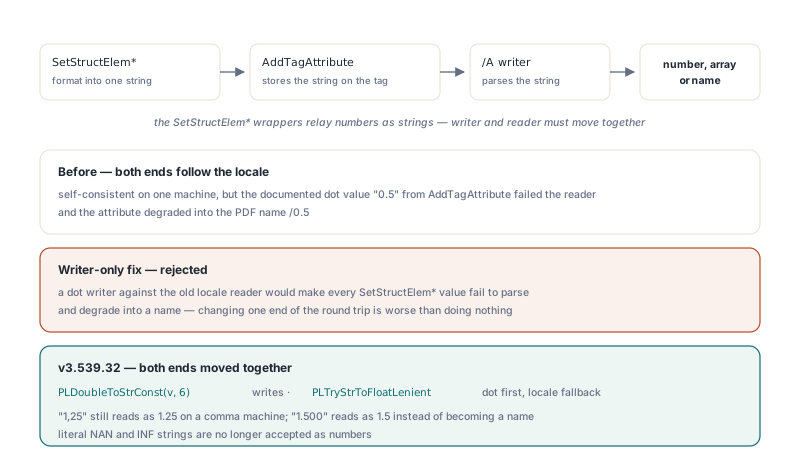
Gdy jedna część kodu zapisuje liczbę do ciągu, a druga parsuje ją z powrotem, zapisujący i czytający muszą trzymać tę samą konwencję, a zmiana tylko jednego z nich łamie podróż w obie strony. Atrybuty struktury oznaczonego PDF działają dokładnie tak. SetStructElemBBox formatuje cztery wartości do jednego ciągu i przechowuje go przez AddTagAttribute. Gdy słownik atrybutów /A jest zapisywany, ten ciąg jest parsowany ponownie, by zdecydować, czy staje się liczbą, tablicą czy nazwą
Gdyby oba końce trzymały się systemowego locale, podróż byłaby samospójna na niemieckiej maszynie. Kłopoty zaczynają się od wywołującego, który podąża za dokumentacją i przekazuje "0.5" do AddTagAttribute: czytający związany z locale nie umie tego sparsować i emituje nazwę PDF /0.5. Placeholdery PDF/VCR trafiają w lustrzane odbicie, bo ich GTS_BBox jest generowany z kropką, a związany z locale krok walidacji przed zapisem odrzuciłby go. A przełączenie tylko zapisującego na kropkę pogarsza sprawę, bo każda wartość SetStructElem* zamieniałaby się w nazwę na systemach z przecinkiem
Dlatego zapisujący używają PLDoubleToStrConst(v, 6), a czytający PLTryStrToFloatLenient, który najpierw próbuje formy z kropką, a potem wraca do systemowego locale. Wywołujący z locale przecinkowym, który przekazuje "1,25", dostaje liczbę 1.25. Jest koszt i przyjęliśmy go świadomie: na niemieckim systemie "1.500" jest czytane jako 1.5, a nie jeden tysiąc pięćset, bo forma z kropką wygrywa. API dokumentuje kropkę jako separator, więc niemieckie grupowanie tysięcy w ciągu atrybutu to wejście, na które postanowiliśmy nie zezwalać. Literały NAN i INF nie są traktowane jako liczby
uses
  System.SysUtils, PDFlibrary;

var
  Lib: TPDFlib;
begin
  FormatSettings.DecimalSeparator := ',';   // wywołujący z przecinkiem dziesiętnym
  Lib := TPDFlib.Create;
  try
    Lib.BeginTag('Figure', 'Sales chart', '');
    Lib.SetStructElemBBox(10.5, 20.25, 200.5, 100.75); // /BBox [ 10.5 20.25 200.5 100.75 ]
    Lib.AddTagAttribute('Layout', 'SpaceAfter', '0.5');   // /SpaceAfter 0.5 zamiast /0.5
    Lib.AddTagAttribute('Layout', 'StartIndent', '1,25'); // /StartIndent 1.25 przez fallback na locale
    Lib.DrawText(20, 20, 'figure');
    Lib.EndTag;
    Lib.SaveToFile('tagged.pdf');
  finally
    Lib.Free;
  end;
end;
Nasza rekomendacja dla twojego własnego kodu: przekazuj do AddTagAttribute ciągi z kropką dziesiętną i zostaw fallback na przecinek dla wartości, których nie kontrolujesz, jak ciągi wczytane ze starszego pliku konfiguracyjnego. Jak zbudowane jest drzewo struktury wokół tych atrybutów, opisuje przewodnik po strukturze oznaczonego PDF
Gdzie NaN i nieskończoność zostają zatrzymane
AddPageMatrix, ScalePage i RedactRegion odrzucają argumenty NaN i nieskończone od razu i zwracają 0, bo żadna liczba PDF nie umie ich przedstawić. Kontrola musi być jawna. NaN wymyka się testowi <= 0, więc sama kontrola zakresu na współczynniku skali przepuściłaby skalę NaN aż do formattera, a wywołanie Round na NaN rzuca EInvalidOp na Win32, gdzie jednostka x87 domyślnie nie maskuje operacji niepoprawnych. PLDoubleToStrConst zapisuje 0 dla NaN jako ostatnią linię obrony, ale zero wewnątrz macierzy to transformacja osobliwa, więc kontrola na poziomie API jest tą, która faktycznie chroni stronę. We własnym kodzie testuj wartość zwrotną: gdy ScalePage zwróci 0 dla współczynnika, który wyliczyłeś, wypisz współczynnik, zanim cokolwiek innego, bo 0/0 gdzieś wyżej produkuje dokładnie takie NaN
Dwie granice są przemyślane. Łańcuchy stanu metaplików są zapisywane i czytane z locale wewnątrz pojedynczego procesu i nigdy nie trafiają do pliku, więc pozostają związane z locale. A jeśli testujesz małe wartości przez ścieżkę generowania strony, czytaj treść zaraz po wywołaniu: operacja, która później ponownie emituje treść strony z precyzją współrzędnych dokumentu, uczciwie zamieni 1E-5 w 0, a to zaokrąglenie, nie wyciek locale
Nawyk wart przyjęcia jest krótki. Uruchom raz ścieżki aplikacji produkujące PDF z separatorem przecinkowym, przeskanuj wynik pod kątem przecinków i wykładników i trzymaj FloatToStr z dala od wszystkiego, co parser będzie czytał. Liczby czytane z istniejącego pliku podlegają pokrewnej regule, omówionej w artykule o zachowaniu precyzji sparsowanych liczb dziesiętnych, gdzie dokładny tekst źródłowy przeżywa zapis. Buildy próbne, referencja API i szczegóły licencjonowania są na stronie produktu PDFlibPas Delphi PDF library