Oto błąd, który ręcznie pisany czytnik JBIG2 robi na pierwszym nietypowym pliku, jaki spotka. Parsuje nagłówek pliku, parsuje pierwszy nagłówek segmentu, czyta czterobajtową długość danych i bierze tyle bajtów jako ciało segmentu. Na większości plików .jb2 to dokładnie dobre. Na pliku, którego bajt flag ma wyzerowany bit 0, te "ciała" to naprawdę drugi, trzeci i czwarty nagłówek segmentu, a dekoder arytmetyczny zamienia je w bitmapę szumu albo ucieka za koniec bufora. Plik nie jest zepsuty. Używa organizacji random-access z ITU-T T.88 Annex D.2, gdzie każdy nagłówek segmentu idzie najpierw, a wszystkie dane segmentów następują potem, w tej samej kolejności
Pliki random-access są rzadkie. Wychodzą z systemów archiwizacyjnych i dokumentowego imagingu, które chcą, żeby czytnik zobaczył każdą stronę i każdą zależność słowników, zanim dotknie skompresowanego bajta. Jeśli zadanie konwersji miesza pliki z takiego źródła ze zwykłymi skanami, jeden plik random-access może siedzieć w środku partii, w której reszta jest sekwencyjna. Dekoder, który je czyta, to ten sam natywny dekoder Pascala, który ogarnia własne tabele Huffmana i kanoniczne kody prefiksowe JBIG2, więc strona kodowania się nie zmienia; różni się tylko kolejność, w jakiej znajduje się segmenty
Trzy układy pliku za jednym bajtem flag
PDF Library for Delphi czyta samodzielne pliki JBIG2 przez TPLJBIG2Decoder w module PDFlibJBIG2, a dekoder wylicza układ z nagłówka pliku sam. T.88 Annex D pozwala ułożyć te same segmenty na trzy sposoby: sequential (D.1) stawia każdy nagłówek bezpośrednio przed jego danymi, random-access (D.2) stawia wszystkie nagłówki najpierw i wszystkie dane za nimi, a embedded (D.3) to forma bez nagłówka używana wewnątrz innych kontenerów. Samodzielny plik zaczyna się od ośmiobajtowego identyfikatora 97 4A 42 32 0D 0A 1A 0A, potem idzie jeden bajt flag, a potem czterobajtowa liczba stron, chyba że flagi mówią, że licznik jest nieznany
Bit 0 tego bajta flag wybiera organizację: 1 znaczy sequential, 0 znaczy random-access. Ustawiony bit 1 znaczy, że liczba stron jest nieznana, a czterobajtowy licznik nie występuje, więc pierwszy nagłówek segmentu zaczyna się na bajcie 9 zamiast na bajcie 13. Bity od 2 do 7 są zarezerwowane; dekoder przyjmuje pliki, które je ustawiają, zamiast je odrzucać, bo zbłąkany zarezerwowany bit nie mówi nic o tym, czy same segmenty są czytelne
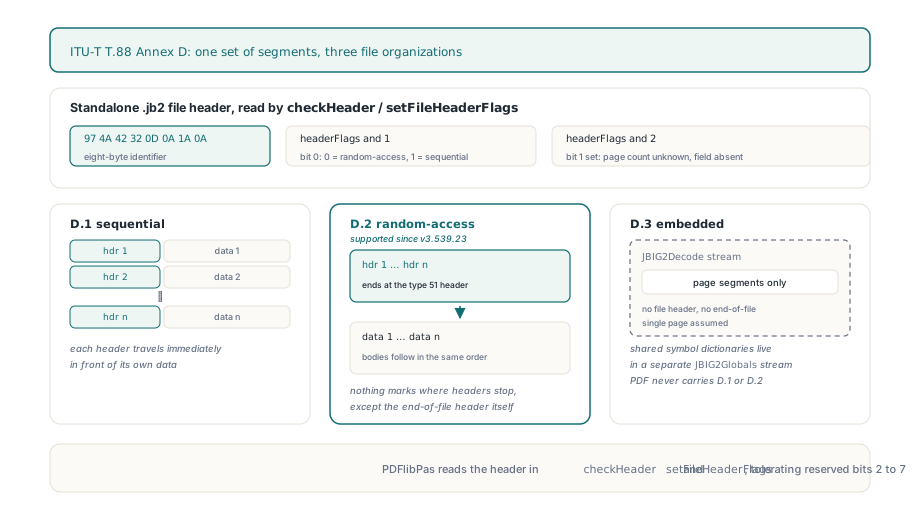
Sam PDF nigdy nie niesie układu random-access. Strumień obrazu JBIG2Decode, opisany w ISO 32000-1 §7.4.7, trzyma tylko segmenty stron w formie embedded, ze wspólnymi słownikami symboli przeniesionymi do osobnego strumienia JBIG2Globals i bez nagłówka pliku oraz segmentów końca strony i końca pliku. Gdy dekoder nie znajduje ośmiobajtowego identyfikatora, traktuje wejście dokładnie jako taki strumień: sequential, jedna strona. W drugą stronę, gdy PDF Library for Delphi eksportuje obraz JBIG2Decode jako natywny plik .jb2, pisze bajt flag $03 (sequential, liczba stron nieznana) i dopisuje nagłówek końca pliku. Random access przychodzi więc wyłącznie z zewnątrz, jako samodzielny plik podany wprost do TPLJBIG2Decoder, zwykle w drodze do konwersji albo rekompresji pod PDF z backendami enkodera JBIG2 w PDFlibPas
Dlaczego pliku random-access nie da się czytać w kolejności pliku?
Bo nic w strumieniu bajtów nie zaznacza, gdzie blok nagłówków się kończy, a blok danych zaczyna — poza samym nagłówkiem segmentu końca pliku (typ 51). Nagłówki segmentów JBIG2 nie mają stałego rozmiaru. Liczba wskazywanych segmentów to albo trzybitowa forma krótka, albo forma długa z bitmapą retencji; każdy wskazywany numer segmentu zajmuje jeden, dwa albo cztery bajty, zależnie od tego, jak duży jest numer samego bieżącego segmentu; pole skojarzenia strony to jeden albo cztery bajty. Czytnik musi sparsować każde pole nagłówka, żeby dowiedzieć się, gdzie zaczyna się następny
Sekwencyjny czytnik, który chodzi po pliku po kolei, dostaje pierwszy nagłówek dobrze i wszystko po nim źle. Gorzej: może przez chwilę nie zauważyć. Dekoder ogólnego regionu karmiony bajtami nagłówków produkuje piksele, nie błąd, dopóki jakaś późniejsza kontrola długości albo referencji w końcu nie zadziała. Naszym zdaniem dekoder, który nie indeksuje najpierw nagłówków, powinien odrzucać pliki random-access w całości. Jasna odmowa kosztuje jeden plik w partii; wiarygodnie wyglądająca, ale zła bitmapa może wylądować w archiwum i tam zostać
Indeksowanie każdego nagłówka przed pierwszym ciałem
Gdy bajt flag mówi random-access, PDF Library for Delphi robi jeden przebieg po bloku nagłówków, zanim cokolwiek zdekoduje. Każdy nagłówek jest parsowany w całości i potem wyrzucany; trzymywany jest wyłącznie jego offset bajtowy w pliku. Dane skompresowane nie są nigdy kopiowane do przetasowanego drugiego bufora, co ma znaczenie na dużych skanach archiwalnych, gdzie blok danych może być większością pliku. Przebieg zatrzymuje się na pierwszym nagłówku końca pliku, a w tym momencie pozycja czytania siedzi na pierwszym bajcie danych pierwszego segmentu
Plik random-access ma mniej redundancji niż sekwencyjny, więc preskan jest rygorystyczny. Odrzuca plik, gdy:
- nagłówek jest urwany przez koniec bufora, raportowany jako
JBIG2 truncated random-access header at byte Nz przesunięciem, od którego ten nagłówek się zaczął - numery segmentów nie rosną ściśle (porównywane jako wartości bez znaku), bo dwa nagłówki roszczące sobie ten sam numer czynią listę wskazywanych późniejszego regionu niejednoznaczną
- długość danych ma ustawiony najwyższy bit, co obejmuje znacznik "nieznanej długości"
0xFFFFFFFF; w tym układzie nie ma innego sposobu, by znaleźć, gdzie zaczyna się następne ciało, więc dekoder odmawia natychmiast, zamiast skanować w poszukiwaniu znacznika końca - nagłówek końca pliku deklaruje jakiekolwiek dane albo w ogóle się nie pojawia (
JBIG2 random-access file is missing its end-of-file header) - zadeklarowane długości sumują się do więcej niż pozostałe bajty albo do mniej
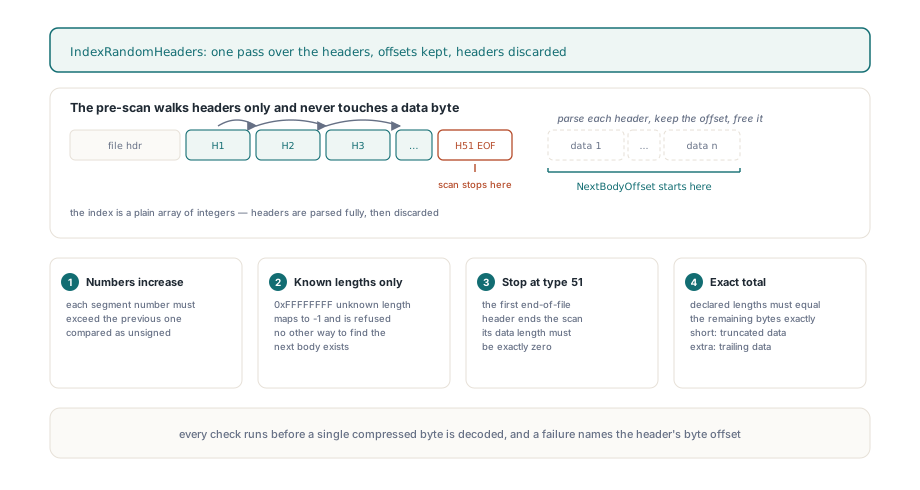
Ostatnia reguła to ta, na której ludzie się potykają. Pojedynczy nadmiarowy bajt po ostatnim ciele zawodzi z JBIG2 trailing random-access data. Obok ścieżki sekwencyjnej, gdzie dekodowanie po prostu zatrzymuje się na segmencie końca pliku, a cokolwiek po nim jest ignorowane, to wygląda ostro. Asymetria ma powód. W układzie sekwencyjnym każdy nagłówek siedzi tuż przy własnych danych, więc śmieci na końcu nie mogły niczego przesunąć. W układzie random-access nagłówki są jedyną mapą bloku danych, a jeśli długości się nie sumują, dekoder nie odróżni nieszkodliwego wypełnienia od bajta zgubionego albo dokleczonego dużo wcześniej, który przesunął każde ciało po nim
Dlaczego pętla licząca bajty gubi ostatni segment końca strony?
Pętla biegnąca "dopóki zostały bajty" kończy się za wcześnie na pliku random-access, bo dane kończą się, zanim skończy się indeks nagłówków. Segmenty końca strony (typ 49) i końca pliku niosą zero bajtów danych i normalnie przychodzą ostatnie. Gdy ciało ostatniego regionu zostało skonsumowane, pozycja czytania jest dokładnie na końcu bufora; pętla licząca bajty wychodzi tam, a segment końca strony o zerowej długości nigdy nie dostaje swojej kolejki, co zostawia stronę niedokończoną
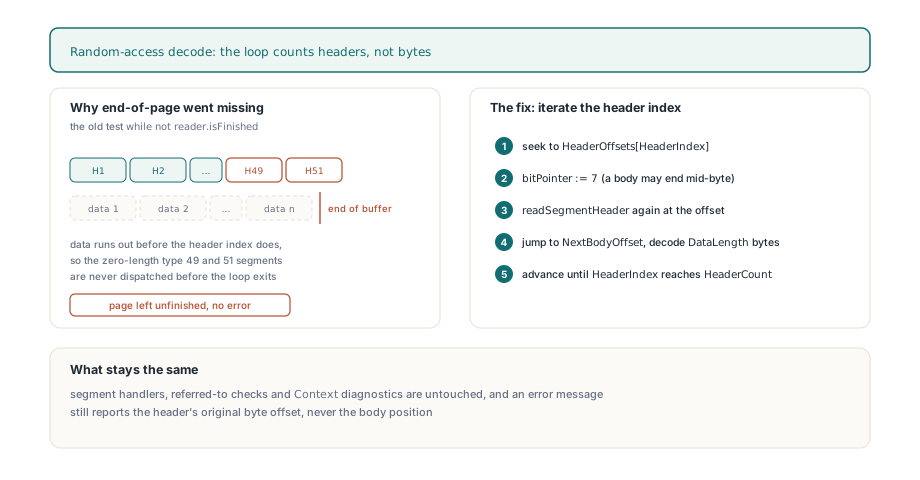
Dla plików random-access dekoder liczy więc nagłówki, nie bajty. Każdy krok skacze z powrotem do następnego zaindeksowanego nagłówka, wyrównuje do granicy bajtu (ciało kodowane arytmetycznie może skończyć się w połowie bajta), parsuje nagłówek ponownie, potem skacze naprzód tam, gdzie zaczyna się następne ciało, i przechodzi za nie o zadeklarowaną długość. Ciało, którego dekoder skończył wcześniej, jest przeskakiwane do zadeklarowanego końca; takie, które czyta poza niego, jest odrzucane. Stamtąd segment idzie przez te same handlery i kontrole referencji co w pliku sekwencyjnym. Błędy podniesione przy dekodowaniu ciała niosą pierwotną pozycję nagłówka, w formie JBIG2 segment N (type T) at byte B: ..., więc przesunięcie w LastError wskazuje coś, co znajdziesz w edytorze szesnastkowym
Wczytywanie pliku .jb2 random-access w Delphi
Kod aplikacji nie zmienia się wraz z organizacją. TPLJBIG2Decoder.LoadFromByteArray wykrywa nagłówek pliku i układ, zwraca False na każdym odrzuconym wejściu z powodem w LastError i wystawia zdekodowaną stronę przez Width, Height i GetScanline, które wypełnia jeden bajt na piksel, 1 dla czerni
uses
  SysUtils, Classes, PDFlibJBIG2;

function ReadJb2(const FileName: string): TJBIG2ByteArray;
var
  FS: TFileStream;
begin
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    SetLength(Result, FS.Size);
    if Length(Result) > 0 then
      FS.ReadBuffer(Result[0], Length(Result));
  finally
    FS.Free;
  end;
end;

function CountBlackPixels(const FileName: string): Integer;
var
  Decoder: TPLJBIG2Decoder;
  Row: TJBIG2ByteArray;
  X, Y: Integer;
begin
  Result := 0;
  Decoder := TPLJBIG2Decoder.Create;
  try
    // Samodzielne pliki sekwencyjne i random-access przyjmują to samo wywołanie
    if not Decoder.LoadFromByteArray(ReadJb2(FileName)) then
      raise Exception.Create('JBIG2 rejected: ' + Decoder.LastError);
    for Y := 0 to Decoder.Height - 1 do
      if Decoder.GetScanline(Y, Row) then
        for X := 0 to Decoder.Width - 1 do
          if Row[X] = 1 then
            Inc(Result);
  finally
    Decoder.Free;
  end;
end;
Jeśli chcesz wiedzieć, którego układu używa plik — do logowania albo do segregacji korpusu przed przebiegiem konwersji — przeczytaj bajt flag sam. Biblioteka nie wystawia wykrytej organizacji, a dziewięć bajtów to wszystko, czego potrzebujesz. Helper poniżej to coś do dopisania we własnym kodzie; po prostu odtwarza reguły nagłówka T.88:
type
  TJb2Layout = (jlNoFileHeader, jlSequential, jlRandomAccess);

// Własny helper, nie część PDFlibJBIG2: klasyfikuje bufor po jego nagłówku pliku T.88
function DetectJb2Layout(const Data: TJBIG2ByteArray;
  out PageCountKnown: Boolean): TJb2Layout;
const
  Signature: array[0..7] of Byte = ($97, $4A, $42, $32, $0D, $0A, $1A, $0A);
var
  I: Integer;
begin
  Result := jlNoFileHeader;          // np. strumień embedded wyciągnięty z PDF
  PageCountKnown := False;
  if Length(Data) < 9 then
    Exit;
  for I := 0 to 7 do
    if Data[I] <> Signature[I] then
      Exit;
  PageCountKnown := (Data[8] and 2) = 0;   // bit 1 ustawiony: brak czterobajtowej liczby stron
  if (Data[8] and 1) = 0 then
    Result := jlRandomAccess
  else
    Result := jlSequential;
end;
Zadania seryjne: wypełnione bufory i odrzucone pliki
Reguła danych końcowych to miejsce, gdzie kod seryjny zwykle się gubi, a gdy plik otwierający się gdzie indziej jest odrzucany w ten sposób, spójrz na bufor, zanim oskarżysz plik. .jb2 wyciągnięty z kolumny BLOB w bazie, z odczytu sieciowego o stałym rozmiarze albo z formatu kontenera z wypełnieniem do wyrównania może przyjść z kilkoma zerami po prawdziwym końcu. Plik sekwencyjny macha na to ręką. Plik random-access z tym samym wypełnieniem zawodzi z JBIG2 trailing random-access data, a bufor urwany o kilka bajtów za wcześnie zawodzi jako ucięty. Podawaj dokładnie bajty pliku, wymiarowane z rzeczywistej długości źródła, nigdy z rozmiaru chunka albo pojemności
Odrzucony plik nie zostawia też niczego po sobie. LoadFromByteArray resetuje Width, Height i skanlinie, zanim zacznie dekodować, więc nieudane wywołanie raportuje wymiary zerowe zamiast strony poprzedniego pliku, a ta sama instancja dekodera może prosto przejść do następnego pliku:
procedure DecodeBatch(const Files, Log, Quarantine: TStrings);
var
  Decoder: TPLJBIG2Decoder;
  I: Integer;
begin
  Decoder := TPLJBIG2Decoder.Create;
  try
    for I := 0 to Files.Count - 1 do
      if Decoder.LoadFromByteArray(ReadJb2(Files[I])) then
        Log.Add(Format('%s: %d x %d', [Files[I], Decoder.Width, Decoder.Height]))
      else
      begin
        // Width i Height są tu 0; nic z poprzedniego pliku nie przeżywa
        Log.Add(Files[I] + ': ' + Decoder.LastError);
        if Pos('trailing random-access data', Decoder.LastError) > 0 then
          Quarantine.Add(Files[I]);   // sprawdź, jak bajty były przechowywane, zanim obwinisz plik
      end;
  finally
    Decoder.Free;
  end;
end;
Sprawdzenie tego we własnym potoku nie potrzebuje rzadkich plików próbkowych. Przeorganizuj sekwencyjny .jb2 w układ random-access, zachowując każdy nagłówek i każdy skompresowany bajt, przenieś nagłówki końca strony i końca pliku na koniec bloku nagłówków, a zdekodowane piksele muszą zgadzać się z sekwencyjnym oryginałem dokładnie, i z polem liczby stron, i bez. Potem podaj mu każdy ucięty prefiks, zdublowany numer segmentu, jeden nadmiarowy bajt końcowy i długość 0xFFFFFFFF; każde powinno zwrócić False z Width i Height na zerze
Co zwraca dekoder i czego oczekuje
Random access to tu własność układu pliku. TPLJBIG2Decoder zwraca bitmapę pierwszej strony niezależnie od organizacji pliku, a Width i Height opisują tę stronę. Każdy segment musi deklarować długość danych; T.88 pozwala regionowi ogólnemu typu immediate używać znacznika 0xFFFFFFFF, a dekoder odrzuca ten znacznik w obu układach z unknown or oversized segment length is not supported. Długości prefiksów własnych tablic Huffmana i liczby wpisów tabel są ograniczone tak samo jak w plikach sekwencyjnych
Dekodowanie JBIG2 to jeden etap dłuższej ścieżki obrazowej, która obejmuje też ekstrakcję obrazów z PDF, rekompresję i kodowanie JBIG2; strona produktu PDF Library for Delphi opisuje resztę tego potoku i wspierane formaty obrazów