Zrzuć segment JBIG2 Tables (typ 53) bajt po bajcie, a pierwszą niespodzianką jest to, czego w nim nie ma: samych kodów Huffmana. Dostajesz bajt flag, dwie granice i ciąg małych liczb, a te liczby to długości kodów. Koder i dekoder obaj przebudowują właściwe wzorce bitów z długości procedurą z ITU-T T.88 Annex B.3. Przebuduj je w lekko innej kolejności i wciąż dostaniesz poprawny kod prefiksowy, każdy wzorzec się dekoduje, i każda wartość wychodzi przypięta do złego wzorca
Na stronie kodowanej identyfikatorami symboli Huffmana z tabelami dostarczonymi przez kodera taka niezgodność wygląda jak zły skan: glify o kilka pikseli obok, znaki złożone ze złych symboli albo wiarygodne liczby do chwili, gdy szerokość wychodzi poza zakres kilka segmentów później. Większość JBIG2 w plikach PDF jest kodowana arytmetycznie, a większość JBIG2 kodowanego Huffmanem trzyma się standardowych tabel B.1 do B.15. Pliki z własnymi tabelami są rzadkie i mają w zwyczaju ćwiczyć naraz parser tabel, refinement kodowany Huffmanem i nieskompresowane zbiorcze bitmapy
Co segment Tables faktycznie niesie
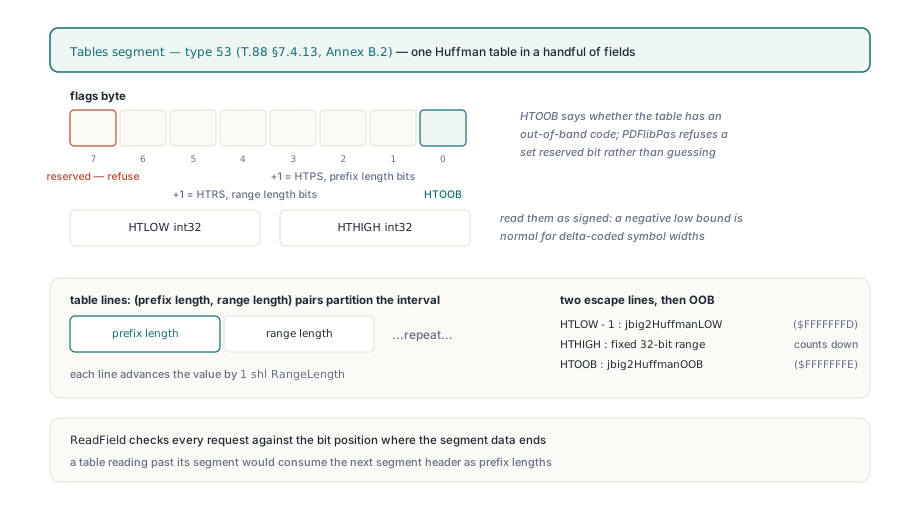
Segment Tables opisuje dokładnie jedną tabelę Huffmana. T.88 §7.4.13 i Annex B.2 układają go jako jeden bajt flag, 32-bitowe ze znakiem HTLOW, 32-bitowe ze znakiem HTHIGH, po czym pary (długość prefiksu, długość zakresu), które pokrywają przedział od HTLOW do HTHIGH. Bit 0 flag to HTOOB, który mówi, czy tabela ma kod poza pasmem. Bity od 1 do 3 plus jeden dają HTPS, szerokość każdego pola długości prefiksu. Bity od 4 do 6 plus jeden dają HTRS, szerokość każdego pola długości zakresu. Bit 7 jest zarezerwowany
Na granicach ręcznie pisany parser zwykle potyka się najpierw. Czytaj HTLOW jako bez znaku i tabela startująca od -2, co jest zwyczajne przy delta-kodowanych szerokościach i wysokościach symboli, nagle twierdzi, że startuje tuż pod 4,3 miliarda. PDF Library for Delphi czyta obie granice jako wartości ze znakiem, odmawia tabeli, której HTLOW nie jest poniżej HTHIGH albo której długość zakresu przekracza 32, i sprawdza każde czytane pole względem bitu, w którym kończą się zadeklarowane dane segmentu. Ta ostatnia kontrola znaczy więcej, niż brzmi: tabela czytająca poza swój segment konsumuje nagłówek następnego segmentu jako długości prefiksów i parsuje się w kompletny bezsens. Ustawiony bit 7 wywala z reserved custom Huffman table flag. Wolimy taką odmowę niż zgadywanie, bo zgadywana tabela produkuje złe piksele, których nikt nie wywodzi do przyczyny
Po zwykłych liniach przychodzą linie ucieczki z Annex B.2. Dolna linia zakresu startuje na HTLOW minus jeden i liczy w dół 32-bitowym offsetem, górna linia zakresu startuje na HTHIGH z 32-bitowym zakresem, a linia poza pasmem istnieje tylko przy ustawionym HTOOB. Te linie niosą te same znaczniki, których używają wbudowane tabele standardowe, więc własna tabela i Tabela B.6 przechodzą przez jedną pętlę dekodowania. Własna tabela może pomieścić do 65 536 linii
Dlaczego kody prefiksowe trzeba nadawać w kolejności wierszy tabeli?
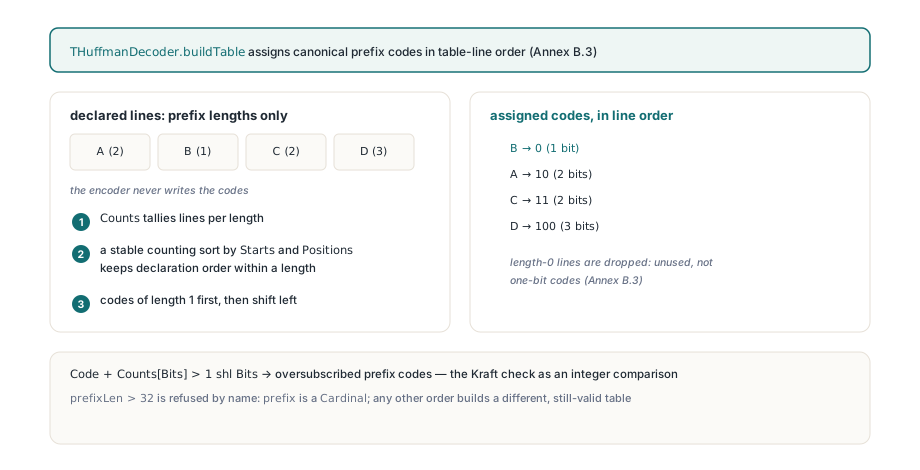
Bo kolejność deklaracji to jedyna rzecz, która wiąże wzorzec bitów z zakresem wartości. Annex B.3 liczy, ile linii używa każdej długości prefiksu, rozdaje najpierw kody długości 1, przesuwa w lewo, by przejść do długości 2, i tak dalej; w obrębie jednej długości kody idą do linii w kolejności z segmentu. Mała tabela robi to konkretnym. Sześć linii, oznaczonych A do F w kolejności z pliku, z tymi długościami prefiksów:
| Linia | Długość prefiksu | Kod (kolejność z pliku) | Kod przy zamianie B z D |
|---|---|---|---|
| A | 2 | 00 | 00 |
| B | 3 | 100 | 101 |
| C | 2 | 01 | 01 |
| D | 3 | 101 | 100 |
| E | 3 | 110 | 110 |
| F | 0 | nieużywany | nieużywany |
Obie kolumny to poprawne kody prefiksowe. Tylko lewa jest tym, co koder miał na myśli: przy zamienionych B i D wzorzec 100 daje zakres wartości D, a dekoder jedzie dalej z liczbą ze złego przedziału. Linia F ma długość 0, co B.3 definiuje jako nieużywaną; daj jej jednobitowy kod i każde późniejsze przypisanie się przesunie
Łatwy sposób na dostanie prawej kolumny to uniwersalne sortowanie po długości prefiksu. Delphijskie TArray.Sort i TList<T>.Sort nie są stabilne, więc równe długości mogą wrócić w dowolnej kolejności. Dla kanonicznych kodów we własnym narzędziu przejdź linie w kolejności z pliku raz na każdą długość:
uses
  System.SysUtils;

type
  TCodeLine = record
    PrefixLen: Integer;   // prosto z segmentu Tables
    Code: Cardinal;       // przypisywany niżej
  end;

// Kanoniczne przypisanie z Annex B.3, napisane pod własne narzędzia.
// Równe długości trzymają kolejność z pliku; długość 0 nie dostaje kodu.
procedure AssignCanonicalCodes(var Lines: array of TCodeLine);
var
  LenCount: array[0..32] of UInt64;
  FirstCode: array[0..32] of UInt64;
  NextCode: UInt64;
  CurLen, I: Integer;
begin
  FillChar(LenCount, SizeOf(LenCount), 0);
  for I := 0 to High(Lines) do
  begin
    if (Lines[I].PrefixLen < 0) or (Lines[I].PrefixLen > 32) then
      raise Exception.Create('prefix length out of range');
    Inc(LenCount[Lines[I].PrefixLen]);
  end;
  LenCount[0] := 0;
  FirstCode[0] := 0;
  for CurLen := 1 to 32 do
  begin
    FirstCode[CurLen] := (FirstCode[CurLen - 1] + LenCount[CurLen - 1]) shl 1;
    // Kontrola Krafta: więcej kodów, niż ta długość pomieści
    if FirstCode[CurLen] + LenCount[CurLen] > (UInt64(1) shl CurLen) then
      raise Exception.Create('oversubscribed prefix lengths');
    NextCode := FirstCode[CurLen];
    for I := 0 to High(Lines) do       // kolejność z pliku jest tie-breakiem
      if Lines[I].PrefixLen = CurLen then
      begin
        Lines[I].Code := Cardinal(NextCode);
        Inc(NextCode);
      end;
  end;
end;
Karm go sześcioma liniami z góry i A dostaje 00, C dostaje 01, B dostaje 100, D dostaje 101, a E dostaje 110; F nie dostaje kodu. PDF Library for Delphi robi tę samą robotę przebiegiem zliczania, który jest stabilny z konstrukcji i unika przemiatania tabeli 32 razy, i nakłada te same dwa strażniki. Przepasane długości wywalają z oversubscribed Huffman prefix codes; przepuść je i jeden wzorzec może pasować do dwóch linii. Prefiksy dłuższe niż 32 bity też wywalają z nazwy, choć T.88 pozwala na nie na papierze. Uważamy, że ten sufit to właściwy kompromis: każdy kod mieści się w jednym słowie maszynowym, a plik, który potrzebuje więcej, jest daleko bardziej prawdopodobnie uszkodzony niż sprytny
Wartości potrzebują tej samej pieczołości. Dolna linia zakresu dekoduje się jako HTLOW minus jeden minus 32-bitowy offset bez znaku, a przy 32-bitowym Integer jako kroku pośrednim to odejmowanie może zawinąć się w wyglądający zwyczajnie dodatni zakres. Dekoder robi to na 64 bitach i podnosi Huffman value exceeds signed integer range, gdy prawdziwy wynik się nie mieści
Kolejność selektorów i dwie pułapki, które kręją się nawzajem
Region tekstu albo słownik symboli nie wymienia swoich tabel. Niesie dwubitowe selektory, a każdy selektor ustawiony na własny bierze następny segment Tables z listy wskazywanych, w kolejności wskazań. T.88 §7.4.3.1.2 porządkuje selektory regionu tekstu jako FS, DS, DT, RDW, RDH, RDX, RDY i RSIZE; §7.4.2.1.1 porządkuje selektory słownika symboli jako DH, DW, BMSIZE i AGGINST. Wartości 0 i 1 biorą tabele standardowe, 3 bierze własną, a 2 jest zarezerwowane na polach z tylko dwoma tabelami standardowymi. PDF Library for Delphi odrzuca zarezerwowane wartości selektorów i wywala z missing custom Huffman table reference, gdy selektory chcą więcej własnych tabel, niż region wskazuje
Jeśli piszesz własny dekoder, dwie pomyłki są tu łatwe i każda kryje drugą. Pierwsza ugryzie w Delphi albo FPC w trybie Delphi (tryb objfpc odrzuca ten kod jako zdublowany identyfikator): setter flag, którego parametr ma tę samą nazwę co pole. Parametr zasłania pole, Flags := Flags przypisuje go sam do siebie, a pole zostaje zerem. Każdy selektor czyta potem zero, region tekstu używa standardowych tabel B.6, B.8 i B.11 dla FS, DS i DT, cokolwiek plik prosił, a ścieżka własna nigdy nie rusza
Druga siedzi w słowniku symboli. Słownik Huffmana może trzymać symbole jako nieskompresowaną zbiorczą bitmapę (BMSIZE równe zero), gdzie każdy wiersz kończy się częściowym bajtem. Wartość dopełnienia to liczba ważnych bitów w tym bajcie, a kusi, by czytać ją jako najniższą ważną pozycję bitu:
// Ostatni bajt jednego wiersza zbiorczej bitmapy, bity czytane MSB najpierw.
// Padding := TotalWidth mod 8  -> liczba WAŻNYCH bitów w tym bajcie

// Źle: traktuje Padding jako najniższy indeks bitu do skopiowania
for BitPos := 7 downto Padding do
  CopyPixel((LastByte shr BitPos) and 1);

// Dobrze: najniższy ważny indeks bitu to 8 - Padding (0 przy Padding = 0)
for BitPos := 7 downto ((8 - Padding) and 7) do
  CopyPixel((LastByte shr BitPos) and 1);

// CopyPixel oznacza cokolwiek, co zapisuje piksel w Twoim własnym dekoderze
Sprawdź szerokości brzegowe. Wiersz 63 piksele ma dopełnienie 7: zła pętla kopiuje jeden bit ostatniego bajtu, dobra siedem. Wiersz 9 pikseli ma dopełnienie 1: zła pętla kopiuje siedem, dobra kopiuje jeden. Przy 64 pikselach obie kopiują wszystkie osiem, więc wielokrotności 8 nigdy jej nie ujawniają. Sztuczne zbiorcze bitmapy o szerokości 7 i 9 pikseli przybijają obie strony granicy bajtu. I szkoda wędruje dalej, bo refinement używa tych symboli jako referencji
Jeśli Twój własny dekoder ma obie pułapki, debugowanie robi się rozpaczliwe. Napraw sam setter i ścieżka własna w końcu ruszy — prosto w połamane zbiorcze bitmapy, więc strona nadal wygląda źle. Napraw samo dopełnienie i nic widocznego się nie zmienia, bo ścieżka własna jest nadal nieosiągalna. Testuj oba na sztucznych wejściach, zanim zaufasz którejkolwiek zmianie. Powiązany szczegół: słownik symboli Huffmana, którego wejście i nowe symbole sumują się do jedynki, dostaje ze wzoru log2 długość kodu symbolu 0, a wariant Huffmana zapisuje każdy identyfikator symbolu co najmniej jednym bitem. PDF Library for Delphi podnosi tę długość do 1 w trybie Huffmana
Skąd refinement w trybie Huffmana czyta rozmiar swojej bitmapy?
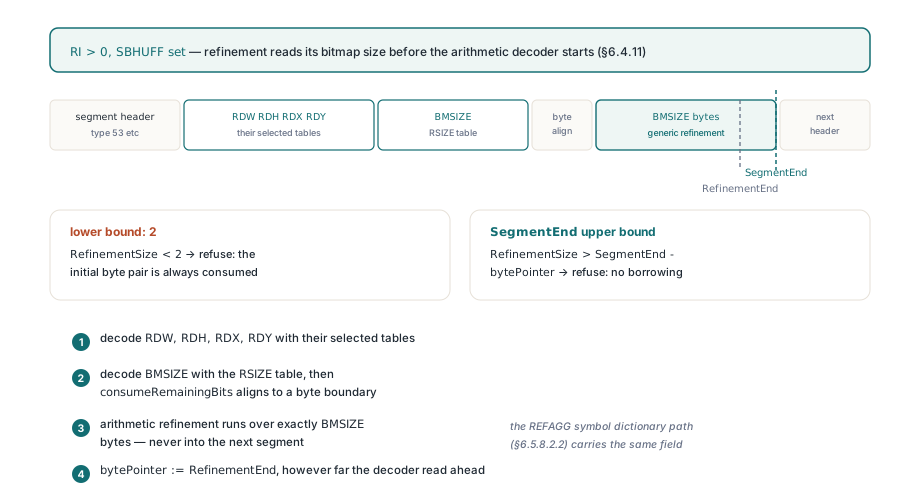
Z pola BMSIZE, które istnieje tylko w trybie Huffmana, dekodowanego przed danymi refinementu arytmetycznego. Gdy instancja regionu tekstu ma refinement (RI różne od zera) i ustawione SBHUFF, T.88 §6.4.11 każe dekoderowi czytać RDW, RDH, RDX i RDY swoimi wybranymi tabelami, potem BMSIZE tabelą RSIZE, potem przeskoczyć na granicę bajtu i dopiero wtedy puszczać ogólne dekodowanie refinementu na dokładnie BMSIZE bajtach. Regiony tekstu w trybie arytmetycznym nie mają takiego pola, więc dekoder dzielący jedną ścieżkę kodu między trybami je pomija, startuje dekoder arytmetyczny za wcześnie i refiniuje każdy symbol przeciwko szumowi. Ścieżka słownika symboli z REFAGG i pojedynczą instancją refinementu (§6.5.8.2.2) ma to samo pole
PDF Library for Delphi ogranicza BMSIZE z obu stron. Minimum to 2, początkowa para bajtów, którą dekoder arytmetyczny zawsze zjada. Maksimum to to, co zostaje z bieżącego segmentu, celowo nie z całego strumienia: BMSIZE, które mieści się tylko pożyczając bajty z następnego segmentu, jest zniekształcone, a kontrola długości strumienia pozwoliłaby dekoderowi arytmetycznemu czytać w następujący nagłówek. Rozmiary poza zakresem wywalają z invalid refinement bitmap size. Potem czytnik Huffmana wraca dokładnie BMSIZE bajtów za polem, cokolwiek dekoder arytmetyczny wyprzedzająco przeczytał
Zadeklarowana długość segmentu jest granicą
Każdy nagłówek segmentu podaje, ile bajtów danych za nim idzie, i dekoder trzyma segment przy tej liczbie w obie strony: czytanie za koniec to błąd, wcześniejsze skończenie jest normalne, a następny nagłówek jest zawsze czytany stamtąd, gdzie plik mówi, że się zaczyna. Mniejsze reguły idą za tym. Nieznana długość danych z T.88 §7.2.7 jest odrzucana z góry zamiast skanowania w poszukiwaniu terminatora. Wskazywane segmenty muszą nieść mniejsze numery niż bieżący i muszą już istnieć. END_OF_PAGE i END_OF_FILE muszą deklarować zero bajtów danych. Segment Profiles (typ 52) musi mieć dokładnie 4 plus 4 razy liczba identyfikatorów; jest potem pomijany, ale zachowywany, więc późniejsze segmenty mogą na niego wskazywać, a nieznany identyfikator profilu nie zatrzymuje dekodowania
Klasyczny przypadek wcześniejszego kończenia to MMR. Dekoder MMR jest skończony, jak tylko wyprodukuje ostatni piksel ostatniego wiersza, co może zdarzyć się przed terminatorem EOFB, który T.88 §6.2.5.7 kładzie na końcu danych. Czytnik zakładający, że siedzi teraz przy następnym nagłówku, parsuje resztki bajtów EOFB jako numer segmentu i wywala kilka bajtów dalej, daleko od prawdziwej przyczyny. Przeskok na zadeklarowany koniec zdejmuje pytanie. Ten sam nawyk biegnie przez to, jak PDF Library for Delphi parsuje niezaufane struktury PDF ogółem
Dekodowanie strumienia obrazu JBIG2 z Delphi
Dekoder mieszka w jednostce PDFlibJBIG2 jako TPLJBIG2Decoder. LoadFromByteArray bierze osadzone dane JBIG2 obrazu /JBIG2Decode i, opcjonalnie, dane jego streama /JBIG2Globals, gdzie zwykle mieszkają własne tabele i współdzielone słowniki symboli. Zwraca False przy każdej odmowie i zostawia powód w LastError; wyjście z wcześniejszego wywołania jest czyszczone na starcie każdego wywołania, więc nieudane dekodowanie nigdy nie zostawia starych pikseli, które wołający wziąłby za wynik
uses
  System.SysUtils, PDFlibJBIG2;

// ImageBytes: dane streama obrazu z ewentualnymi filtrami przed
//   JBIG2Decode już usuniętymi
// GlobalBytes: dane streama /JBIG2Globals albo pusta tablica
function DecodeAndCountBlack(const ImageBytes, GlobalBytes: TJBIG2ByteArray;
  out BlackPixels: Int64): Boolean;
var
  Decoder: TPLJBIG2Decoder;
  Line: TJBIG2ByteArray;
  Row, Col: Integer;
begin
  BlackPixels := 0;
  Decoder := TPLJBIG2Decoder.Create;
  try
    Result := Decoder.LoadFromByteArray(ImageBytes, GlobalBytes);
    if not Result then
    begin
      // Format: 'JBIG2 segment <n> (type <t>) at byte <offset>: <reason>'
      Writeln('JBIG2 refused: ', Decoder.LastError);
      Exit;
    end;
    for Row := 0 to Decoder.Height - 1 do
    begin
      Decoder.GetScanline(Row, Line);   // jeden bajt na piksel, 0 albo 1
      for Col := 0 to Decoder.Width - 1 do
        Inc(BlackPixels, Line[Col]);    // 1 = czarny w JBIG2
    end;
  finally
    Decoder.Free;
  end;
end;
Liczba czarnych pikseli to Twoja własna kontrola, tani odcisk palca do porównania z drugim rendererem. Porażki na poziomie segmentu przychodzą z prefiksem numeru segmentu, typu i offsetu bajtu, więc (type 53) przed oversubscribed Huffman prefix codes wskazuje prosto na segment Tables. Trzymaj oba kanały błędów osobno: TPLJBIG2Decoder.LastError to tekst diagnostyczny tego dekodera, a TPDFlib.LastErrorCode to numeryczny kod API na poziomie biblioteki. Wybór strony podąża za streamem: dekoder zwraca bitmapę pierwszego segmentu informacyjnego strony, jaki spotka, i nie sięga po skojarzenie strony 0, bo JBIG2 osadzony w PDF niesie jedną stronę, a kodery zwyczajnie numerują ją 1
Porównywanie rendererów na tych plikach wymaga trochę pokory, bo niezależne dekodery JBIG2 nie zawsze zgadzają się na plikach z własnymi tabelami i refinementem Huffmana. Dwa dekodery, które się różnią, niczego nie rozstrzygają. Pola formatu tak: które tabele wybrały selektory, co deklarowało BMSIZE, gdzie kończy się każdy segment
Kodowanie opisuje artykuł o backendach enkodera JBIG2 i sposobach ich linkowania. Ścieżka czytania musi przyjąć, co wypuścił cudzy koder, i dzieli swoje reguły z wbudowanym dekoderem TIFF i jego kontrolami BigTIFF oraz układu kafelkowego: odmawiaj z nazwy, nigdy nie pożyczaj bajtów przez zadeklarowaną granicę, trzymaj arytmetykę pośrednią szeroką. Jeśli folder zeskanowanych PDF-ów wciąż wywraca inne toolkity, sprawdź, czy obrazy to JBIG2 kodowany Huffmanem z własnymi tabelami, a potem zestaw je z natywną ścieżką czytania Delphi i C++Builder opisaną na stronie produktu PDF Library for Delphi