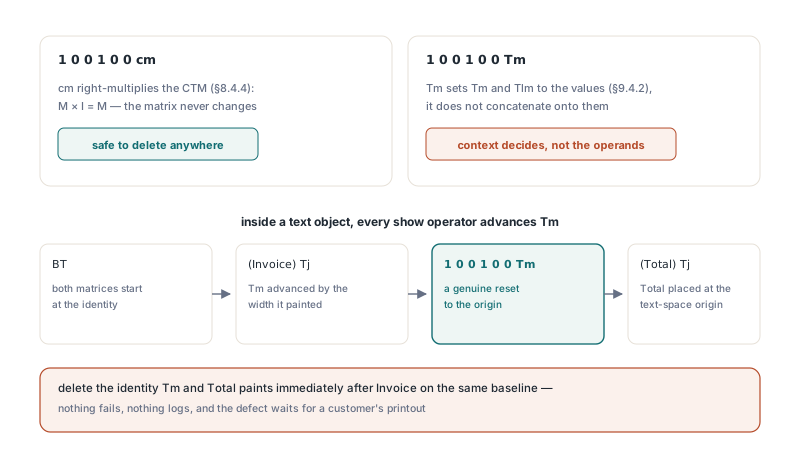
Weź strumień treści, jaki mógłby napisać generator raportów — BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET — i wytnij 1 0 0 1 0 0 Tm, bo jego sześć liczb układa się w macierz jednostkową. Wyrenderuj wynik, a "Total" już nie startuje z początku przestrzeni tekstu. Startuje tam, gdzie skończyło się "Invoice", na tej samej linii bazowej. Jednostkowe Tm jest zbędne tylko dopóki macierz tekstu i macierz linii tekstu już trzymają jednostkową: bezpośrednio po BT albo bezpośrednio po innym jednostkowym Tm
Usunięcie kusi, bo te same sześć liczb naprawdę jest martwym ciężarem przed cm. Optymalizator strumieni treści, który traktuje oba operatory jednakowo, skurczy poprawnie niemało strumieni. Potem spotyka generator, który używa jednostkowego Tm jako powrotu wozu, i tekst się rusza
Dlaczego 1 0 0 1 0 0 Tm nie zawsze jest no-opem?
Te dwa operatory robią inną arytmetykę. ISO 32000-1 §8.4.4 definiuje cm jako doklejenie swojego operandu do bieżącej macierzy transformacji; pomnóż dowolną macierz przez jednostkową, a dostaniesz tę samą macierz z powrotem, więc 1 0 0 1 0 0 cm można usuwać wszędzie, gdzie się pojawia. Tm to przypisanie. Pod §9.4.2 ustawia i macierz tekstu, i macierz linii tekstu na swoje operandy i wyrzuca cokolwiek trzymały, więc to, czy coś zmienia, zależy całkowicie od operatorów przed nim
§9.4.1 mówi, że BT startuje obie macierze na jednostkowej. Stamtąd prawie wszystko wewnątrz obiektu tekstu rusza przynajmniej jedną z nich. Td, TD, T* i niejednostkowe Tm przestawiają macierz linii tekstu. Każdy operator pokazujący tekst (Tj, TJ, ' i ") posuwa macierz tekstu o szerokość glifów, które właśnie namalował, a ostatnie dwa najpierw zaczynają nową linię. Skoro którykolwiek z nich zadziałał, jednostkowe Tm to prawdziwy skok z powrotem do początku. Strumień faktury powyżej polega na tym skoku
Śledzenie strumienia ręcznie rozstrzyga to szybko. Przepuść przykład faktury przez tracker stanu CTM i macierzy tekstu strumienia treści, a zapis pokaże cm doklejające się do CTM, podczas gdy Tm nadpisuje obie macierze tekstu — dwie różne reguły aktualizacji schowane za identycznymi operandami
Jak PDF Library for Delphi rozstrzyga, które jednostkowe Tm wyrzucić
PDF Library for Delphi wyrzuca każde jednostkowe cm podczas swojego przebiegu peephole i wyrzuca jednostkowe Tm tylko wtedy, gdy skan wstecz od tego operatora dojdzie do BT albo innego jednostkowego Tm, zanim spotka cokolwiek, co mogłoby ruszyć macierze tekstu. Test na "jednostkowość" jest numeryczny: operator potrzebuje dokładnie sześciu operandów liczbowych równych 1, 0, 0, 1, 0, 0, więc 1.0 0 0 1.0 0 0 Tm też się kwalifikuje. Idąc wstecz, skan wkłada każdego spotkanego operatora do jednej z dwóch grup:
- Stop i zachowaj Tm:
Td,TD,T*, niejednostkoweTm,Tj,TJ,',",ET, każdy operator nierozpoznany przez parser albo początek strumienia - Przejdź obok i skanuj dalej: operatory, które nigdy nie dotykają macierzy tekstu ani macierzy linii tekstu, jak
Tf,Tc, ustawiacze koloru,gs, operatory marked-content,Doicm
Wcześniejsze jednostkowe Tm kończy skan na korzyść usunięcia niezależnie od tego, czy optymalizator je zachowuje, czy już zaplanował jego usunięcie. Tak czy inaczej zostawiło obie macierze na jednostkowej, czyli w tym samym stanie, jaki zostawia BT. Dlatego bieg trzech jednostkowych Tm prosto po BT zapada się do niczego
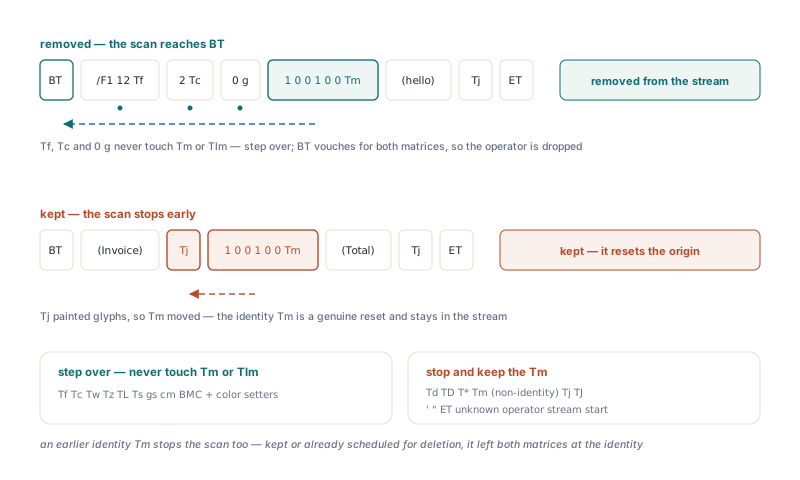
Konserwatywne zatrzymania są zamierzone. Nieznany operator może być rozszerzeniem dostawcy robiącym cokolwiek, więc skan odmawia wnioskowania poza nim. Po ET nie ma otwartego obiektu tekstu, a jednostkowe Tm siedzące tam nie ma BT, które rękuje za wartości macierzy. Skan patrzy też na jeden strumień treści naraz. To ma znaczenie dla stron, których /Contents jest tablicą: PDF pozwala obiektowi tekstu zacząć się w jednym strumieniu i ciągnąć w następnym, więc warstwa otwierająca się w środku obiektu tekstu, bez własnego BT, zachowuje swoje jednostkowe Tm, nawet gdy poprzednia warstwa uczyniłaby je zbędnym
Uważamy, że to właściwa strona, na którą wypada errzyć. Śledzenie macierzy przez granice strumieni albo symulowanie nieznanych operatorów odzyskałoby może czternaście bajtów nieskompresowanego tekstu na dziwaczny plik. Pomyłka rusza glif na drukowanej fakturze. Koszt i ryzyko nie są w tej samej lidze
Jeden efekt uboczny jest wart poznania, bo zmienia to, co widzisz w wyjściu. Ten sam przebieg usuwa też obiekty tekstu bez niczego w środku, więc BT 1 0 0 1 0 0 Tm ET znika całkowicie: jednostkowe Tm idzie najpierw, a para BT/ET, którą zostawia, jest pusta
Puszczanie optymalizatora na fragmencie strumienia treści
Optymalizator działa na tym samym sparsowanym modelu TPDFContentProgram, którego użyłbyś do edycji tekstu strony na poziomie instrukcji, jak w przewodniku po mapowaniu znak-bajt treści. To ułatwia wypróbowanie reguły na łańcuchu, zanim zaufasz jej z całym dokumentem. Helper niżej parsuje zdekodowany strumień, puszcza TPDFContentPeepholeOptimizer i emituje wynik jedną instrukcją na linię. Ustawienie CanonicalNumbers przed Parse naśladuje przebieg zapisowy, który przepisuje każdą liczbę ze stałą precyzją
uses
  PDFlibContentModel, PDFlibContentOptimize;

function OptimizeSnippet(const Source: AnsiString): AnsiString;
var
  Prog: TPDFContentProgram;
  Optimizer: TPDFContentPeepholeOptimizer;
begin
  Result := Source;
  Prog := TPDFContentProgram.Create;
  try
    Prog.CanonicalNumbers := True; // ta sama obsługa liczb co przebieg zapisu
    if not Prog.Parse(Source) then
      Exit; // grubo uszkodzona struktura: zostaw bajty w spokoju
    Optimizer := TPDFContentPeepholeOptimizer.Create(Prog);
    try
      Optimizer.Run; // zwraca liczbę usuniętych instrukcji
    finally
      Optimizer.Free;
    end;
    Result := Prog.Emit; // jedna instrukcja na linię, rozdzielone #10
  finally
    Prog.Free;
  end;
end;

// Usuwane: Tm bezpośrednio po BT, drugie z dwóch identity Tm pod rząd
//   OptimizeSnippet('BT /F1 12 Tf 1 0 0 1 0 0 Tm (hello) Tj ET')
// Zachowywane: Tm po Td, po Tj, po niejednostkowym Tm albo poza BT
//   OptimizeSnippet('BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET')
Przepuść strumień faktury przez niego, a jednostkowe Tm przeżyje, bo skan wstecz wpada na Tj na długo, zanim dojdzie do BT. Wstaw /F1 12 Tf, 2 Tc i 0 g między BT a jednostkowym Tm, a ono nadal poleci, bo żadne z nich nie dotyka macierzy tekstu. Interesujący przypadek to BT 10 20 Td 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm. Traci dokładnie jeden operator. Pierwsze jednostkowe Tm cofa ruch, który zrobiło Td, i tylko drugie jest zbędne
Parse zwraca False tylko przy grubym uszkodzeniu, takim jak niedomknięty łańcuch albo słownik. Nieznane operatory parsują się dobrze i zostają w programie, gdzie działają jako twarde zatrzymania dla skanu
Kiedy optymalizator peephole faktycznie biega?
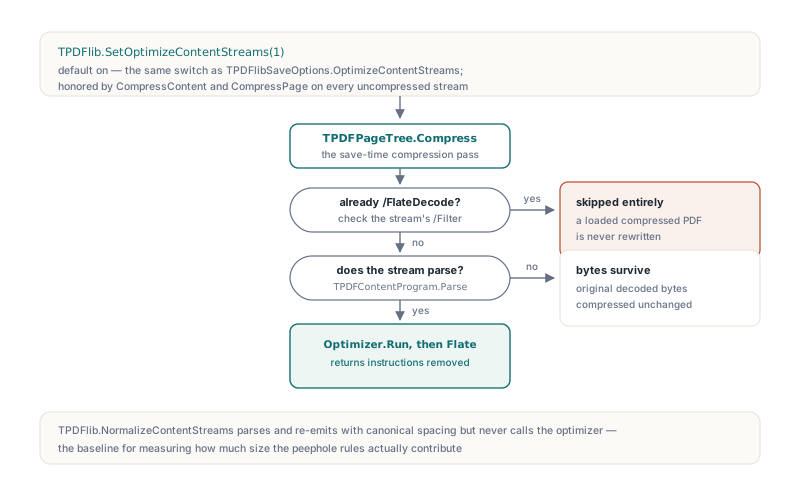
Optymalizator biega tylko wewnątrz przebiegu kompresji i tylko na strumieniach treści stron, które nie są już skompresowane Flate'em. TPDFlib.SetOptimizeContentStreams(1) jest domyślne, a ten sam przełącznik występuje jako pole OptimizeContentStreams w TPDFlibSaveOptions; honorują go i CompressContent, i CompressPage. Strumień, którego /Filter to już /FlateDecode, jest pomijany w całości, więc wczytanie typowego skompresowanego PDF-a i zapis ponowny zostawia jego operatory dokładnie takimi, jakimi były. Strumienie składowane bez kompresji dostają dekodowanie, optymalizację i potem kompresję Flate. Jeśli strumień nie da się sparsować, jego oryginalne zdekodowane bajty są kompresowane bez zmian
var
  Lib: TPDFlib;
  Options: TPDFlibSaveOptions;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('report.pdf', '') <> 1 then
      Exit;
    // Nieskompresowane strumienie stron przechodzą reguły peephole, potem Flate
    Lib.SetOptimizeContentStreams(1);
    Lib.CompressContent;
    Lib.SaveToFile('report-optimized.pdf');

    // Ten sam wybór przez dołączone opcje zapisu; False rezygnuje
    Options.CompressContent := True;
    Options.CompressFonts := True;
    Options.CompressImages := True;
    Options.Linearize := False;
    Options.KeepModDate := False;
    Options.OptimizeContentStreams := False;
    Options.GarbageCollect := False;
    Options.PackObjectStreams := True;
    Lib.SaveToFileOptions('report-plain.pdf', Options);
  finally
    Lib.Free;
  end;
end;
Zostaw domyślne włączone. Każda transformacja w przebiegu jest równoważna wyjściowo, a reguła macierzy jednostkowej goni wzorzec, który emituje wielu generatorów — otwieranie każdego obiektu tekstu BT 1 0 0 1 0 0 Tm. Wyłączenie ma sens głównie, gdy chcesz zdiffować własne nieskompresowane wyjście z tym, co napisałeś, albo gdy potrzebujesz bazy odniesienia. Dla tej bazy TPDFlib.NormalizeContentStreams parsuje i wypuszcza treść z kanonicznymi odstępami i liczbami, ale nigdy nie woła optymalizatora, więc luka rozmiaru między zapisem znormalizowanym a zoptymalizowanym to wkład reguł peephole. Spodziewaj się jej skromnej obok większych zysków opisanych w optymalizacji rozmiaru plików PDF z subsetowaniem fontów
Test pokrywający jeden kształt nie definiuje reguły
Test, który podaje BT 1 0 0 1 0 0 Tm (hello) Tj ET optymalizatorowi i asertuje, że nie zostaje żadne Tm, przypina jeden kształt: jednostkowe Tm bezpośrednio po BT jest usuwane. Nie mówi niczego o jednostkowym Tm po Td ani po pokazanym tekście. Przeczytanie tej pojedynczej asercji jako "jednostkowe Tm jest zawsze usuwalne" to łatwy błąd, i kosztowny, bo próbka przechodzi tak czy tak. Testy dla jakiejkolwiek reguły jak ta potrzebują kształtów zachowywanych zapisanych obok usuwalnych
Helper niżej liczy operatory Tm, które przeżyły, po czym sprawdza tabelę wejść. Zamień ExpectTm na asercję twojego frameworka testowego; nie jest częścią biblioteki
uses
  SysUtils, PDFlibContentModel, PDFlibContentOps, PDFlibContentOptimize;

function TmCountAfterOptimize(const Source: AnsiString): Integer;
var
  Prog: TPDFContentProgram;
  Optimizer: TPDFContentPeepholeOptimizer;
  I: Integer;
begin
  Result := -1; // -1 sygnalizuje niepowodzenie parsowania
  Prog := TPDFContentProgram.Create;
  try
    if not Prog.Parse(Source) then
      Exit;
    Optimizer := TPDFContentPeepholeOptimizer.Create(Prog);
    try
      Optimizer.Run;
    finally
      Optimizer.Free;
    end;
    Result := 0;
    for I := 0 to Prog.Count - 1 do
      if Prog[I].Op = coTextMatrix then
        Inc(Result);
  finally
    Prog.Free;
  end;
end;

// Twój własny helper sprawdzający, sugerowany tu; zamień na prawdziwą asercję
procedure ExpectTm(const Source: AnsiString; Expected: Integer);
var
  Actual: Integer;
begin
  Actual := TmCountAfterOptimize(Source);
  if Actual <> Expected then
    raise Exception.CreateFmt('%s: expected %d Tm, got %d',
      [string(Source), Expected, Actual]);
end;

procedure CheckIdentityTmRule;
begin
  // Kształty usuwalne
  ExpectTm('BT /F1 12 Tf 1 0 0 1 0 0 Tm (hello) Tj ET', 0);
  ExpectTm('BT 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm (a) Tj ET', 0);
  ExpectTm('BT /F1 12 Tf 2 Tc 0 g 1 0 0 1 0 0 Tm (a) Tj ET', 0);
  // Kształty, które muszą zachować jednostkowe Tm
  ExpectTm('BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET', 1);
  ExpectTm('BT 10 20 Td 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm (a) Tj ET', 1);
  ExpectTm('BT 2 0 0 2 5 5 Tm (a) Tj 1 0 0 1 0 0 Tm (b) Tj ET', 2);
  ExpectTm('1 0 0 1 0 0 Tm (a) Tj', 1);    // bez otaczającego BT
  ExpectTm('BT ET 1 0 0 1 0 0 Tm', 1);     // po ET
end;
Dwa ostatnie wiersze wyglądają głupio, dopóki nie przypomnisz sobie, że warstwowe tablice /Contents produkują dokładnie takie fragmenty. Strumień zaczynający się w połowie obiektu tekstu nie ma BT, a jednostkowe Tm po ET nie należy do żadnego obiektu tekstu wcale. Oba zostają. Pusta para BT ET w ostatnim wierszu jest usuwana przez regułę pustego obiektu tekstu, dlatego liczenie sprawdza operatory Tm zamiast porównywać całe łańcuchy
Czego reguła się wyrzeka, to sporadyczne jednostkowe Tm w środku obiektu tekstu — kilka bajtów na stronę, zanim Flate w ogóle je zobaczy. Co kupuje, to gwarancja, na której spoczywa konstrukcja optymalizatora: żadna transformacja w przebiegu nie zmienia widocznej strony. Optymalizator rozmiaru, który rusza tekst, to błąd renderowania z dobrym współczynnikiem kompresji
Jeśli generujesz albo post-processujesz treść PDF w Delphi albo C++Builder, PDF Library for Delphi and C++Builder pływa z parserem strumieni treści, tym przebiegiem peephole i pokazanymi wyżej opcjami zapisu, razem z NormalizeContentStreams do produkcji czystej, niezoptymalizowanej bazy do porównań