Escapuj komentarz klienta właściwie, tak że <b>urgent</b> wchodzi do Twojego szablonu HTML jako <b>urgent</b>, wrzuć go rendererowi, który parsuje znaczniki dwa razy, a PDF może wrócić ze słowem urgent na grubo. Escapowanie było poprawne. Renderer zdekodował je raz na przebieg. Każda ścieżka HTML-to-PDF, która parsuje, zapisuje wynik z powrotem jako HTML i parsuje ponownie, musi dekodować encje dokładnie raz przez całą podróż
Wersja z help desku tej historii jest zwyczajna. Zgłoszenia są eksportowane do PDF, komentarz klienta siedzi wewnątrz <p>, a ktoś wpisuje nawiasy kątowe w polu komentarza. Nieznana nazwa taga po prostu znika ze strony. Escapowana kotwica staje się klikalną adnotacją łącza w dokumencie, któremu Twój personel ufa. Plik jest poprawny i otwiera się wszędzie; po prostu mówi coś innego niż dane
Gdzie escapowany tekst zamienia się z powrotem w znaczniki
Escapowany tekst zamienia się w znaczniki w miejscu, gdzie renderer o dwóch przebiegach zapisuje już zdekodowany tekst z powrotem do HTML bez escapowania go ponownie. Cokolwiek pierwszy parse zdekodował, staje się potem żywą składnią dla drugiego
Dwa przebiegi w DrawHTMLText i DrawHTMLTextBox biblioteki PDF Library for Delphi (PDFlibPas) istnieją z dobrego powodu. Pierwszy parse rozdziela wejście na tagi i słowa. Renderer potem rozwiązuje kaskadę arkuszy: reguły z bloków <style> są dopasowywane do każdego taga, scalane z inline'owymi atrybutami style, i cała lista elementów jest zapisywana z powrotem jako jeden znormalizowany string HTML z każdym tagiem niosącym swój finalny styl. Przebieg layoutu parsuje ten string. Dopasowywanie selektorów, flexbox, grid i reszta wsparcia CSS opisanego w flexboxie, CSS grid i układzie przypisów w renderowaniu HTML PDFlibPas — wszystko zależy od tego kroku pośredniego
Niebezpieczeństwo siedzi w tym, jak słowa wracają na zewnątrz. Tagi da się zapisać z powrotem z ich postaci źródłowej, ale słowa są trzymane jako zdekodowany tekst, bo to mierzy łamacz linii. Dolicz słowo, które przyszło z <unsafe>, do znormalizowanego stringa tak jak jest, a <unsafe> dociera do drugiego parse'a jako element. Projekt dekodujący raz musi jeszcze domknąć trzy mniejsze przecieki:
- Jeśli
&nie jest w zbiorze dekodowanym,R&Ddrukuje się dosłownie i nie ma żadnego sposobu, by postawić zapis<na stronie jako tekst - Jeśli etap rysowania podstawia
ponownie po skończeniu parsowania, dosłowny zapis encji znika w ostatniej chwili - Jeśli producent HTML po stronie górnej, jak konwerter Markdown albo eksporter datasetu, escapuje tylko nawiasy kątowe, zapis encji wewnątrz próbki kodu albo wartości komórki jest dekodowany w znaczniki
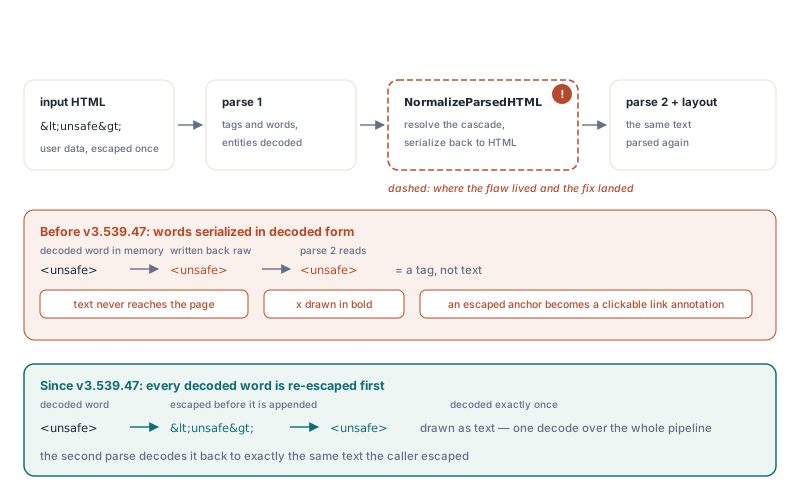
Tabela spod niżej wypisuje, co trafia na stronę dla garści wejść, porównując naiwnego renderera o dwóch przebiegach z potokiem PDFlibPas
| Wejście docierające do renderera | Naiwny renderer o dwóch przebiegach | PDFlibPas |
|---|---|---|
<unsafe> | Sparsowane jako tag, tekst nigdy nie dociera na stronę | <unsafe> narysowane jako tekst |
<b>x</b> | x narysowane na grubo | <b>x</b> narysowane jako tekst |
R&D | R&D wydrukowane dosłownie | R&D |
&lt; | &lt; wydrukowane dosłownie | < |
Span kodu Markdown zawierający | Twarda spacja | narysowane jako tekst |
Wartość komórki datasetu < | < | < |
Jak PDF Library for Delphi dekoduje każdą encję dokładnie raz?
PDF Library for Delphi dekoduje każdą encję dokładnie raz, trzymając trzy reguły razem: parser dekoduje & jako ostatni, etap rysowania niczego nie dekoduje, a każde miejsce, które zamienia zdekodowane słowa z powrotem w HTML, escapuje je najpierw. Zrzuć którąkolwiek z trzech i jeden z wierszy tabeli spod wyżej przeskoczy do naiwnej kolumny
Zacznij od tego, co jest dekodowane. W treści tekstowej parser rozpoznaje <, >, & i . Referencje numeryczne jak A i nazwane encje jak " zostają dosłownym tekstem. Ta krótka lista rozstrzyga, jak masz escapować własne wejście — wróci to jeszcze niżej
Kolejność wewnątrz dekodera ma znaczenie nawet w obrębie jednego przebiegu. Zdekoduj & najpierw, a wejście &lt; staje się <, i już następne podstawienie zamienia je w <: podwójne dekodowanie bez żadnego drugiego parse'a. Ścieżka słów 8-bit podstawia więc najpierw <, > i , a & jako ostatni, więc ampersand, który produkuje, nie jest już nigdy oglądany. Ścieżka słów UTF-16 idzie inną drogą do tego samego wyniku — jedno skanowanie od lewej do prawej w krokach dwubajtowych, przepisujące każde dopasowanie na miejscu i przesuwające się za nie
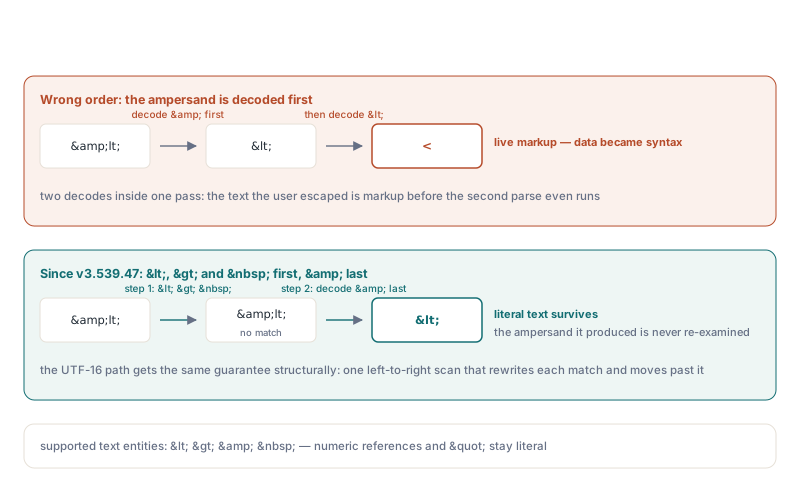
Etap rysowania nie dostaje późnego podstawienia . Słowo, które dociera do łamacza linii, to finalny tekst, a dekodowanie mieszka w parserze i nigdzie indziej
Reguła graniczna niesie największy ciężar. Gdy renderer zapisuje znormalizowany HTML, escapuje &, < i > w każdym zdekodowanym słowie przed doklejeniem, a drugi parse dekoduje to z powrotem do tych samych znaków. Efekt netto przez oba przebiegi: jedno dekodowanie. String kontynuacji, który zwraca DrawHTMLTextBox, trzyma się tej samej reguły. Słowa, które się nie zmieściły, są escapowane, zanim wejdą do reszty, a reszta reszty jest kopiowana ze znormalizowanego HTML, który jest już escapowany. Box, który bierze wszystko, zwraca pusty string
Dlaczego escapowanie UTF-16BE nie może używać podstawienia na poziomie bajtów?
Escapowanie UTF-16BE nie może używać podstawienia na poziomie bajtów, bo dwa bajty ampersanda mogą rozpiąć się na dwa niezwiązane znaki. Cała jednostka kodowa 16-bit to jedyna bezpieczna jednostka pracy
Renderer trzyma słowa Unicode jako big-endian UTF-16 spakowane w bajtowe stringi, wysoki bajt najpierw, więc ampersand to 00 26. Weź U+0100 (wielką łacińską A z makronem, bajty 01 00) po U+2603 (bałwan, bajty 26 03). Bufor czyta się 01 00 26 03, a bajty drugi i trzeci kreślą 00 26. Wyszukiwanie bajtowe #0'&' znajduje ampersanda, którego żaden znak nie zawiera, wszywa & w środek dwóch punktów kodowych i przesuwa każdy późniejszy znak o jeden bajt
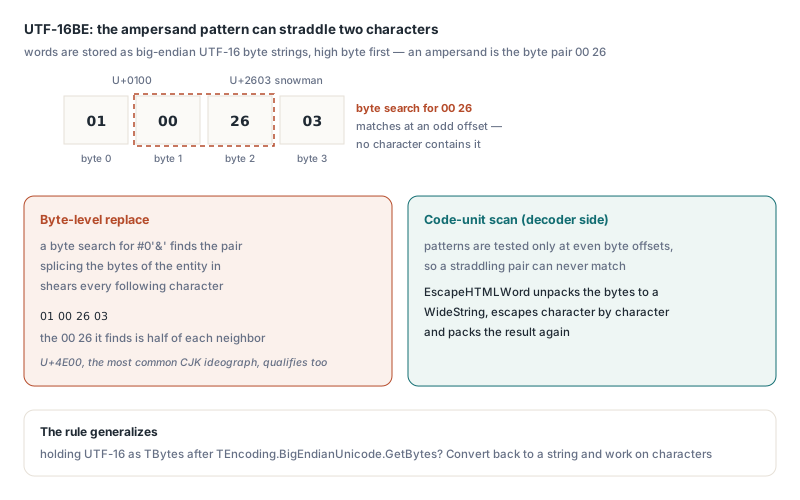
To nie jest egzotyczny kąt. Każdy znak, którego niski bajt jest zerem, może podać pierwszą połowę, a U+4E00 — jeden z najczęstszych ideogramów CJK — jest takim znakiem. Nawiasy kątowe są wystawione tak samo: 00 3C i 00 3E pokazują się za każdym razem, gdy za takim znakiem idzie jakiś z zakresu U+3C00 do U+3EFF z CJK Extension A. Dlatego PDFlibPas escapuje słowa Unicode rozpakowując je do WideString, escapując znak po znaku i pakując wynik ponownie. Dekoder jest bezpieczny z symetrycznego powodu: testuje wzorce tylko na parzystych offsetach
Twój własny kod może uderzyć w tę samą ścianę. Gdy tekst UTF-16 mieszka w TBytes, na przykład po TEncoding.BigEndianUnicode.GetBytes, szukanie w nim wzorców bajtowych to bug czekający na właściwą parę znaków. Konwertuj z powrotem na string i pracuj na znakach
Kod Markdown i komórki datasetu: ampersand idzie pierwszy
Oba producenci HTML wewnątrz PDFlibPas — konwerter Markdown i eksporter datasetu — escapują ampersanda przed nawiasami kątowymi, więc jedno dekodowanie w rendererze odtwarza oryginalny tekst bajt w bajt
W MarkdownToHTML spaney kodu inline i bloki kodu ogrodzone albo wcięciowe mapują & na &, < na < i > na >. Spacje stają się , a tab czterema z nich, co trzyma wcięcie nietknięte. Zwyczajna proza escapuje tylko nawiasy kątowe: surowy HTML wpisany w prozie nie może wsadzić tagów, a autor, który celowo pisze &, i tak dostaje ampersanda — tak, jak oczekują autorzy Markdown. DrawMarkdownText i DrawMarkdownTextBox puszczają tę samą konwersję, więc blok kodu wychodzi dokładnie tak, jak wpisano:
uses
System.SysUtils, PDFlibrary;
procedure RenderCodeSample;
var
Lib: TPDFlib;
Md, Html: WideString;
begin
Md := 'Comparison helper:' + sLineBreak + sLineBreak +
'```' + sLineBreak +
'if (A < B) and (Flags <> 0) then' + sLineBreak +
' WriteLn(''<tag> & R&D'');' + sLineBreak +
'```';
Lib := TPDFlib.Create;
try
// Obejrzyj HTML: wewnątrz kodu '&' staje się '&', a '<' staje się '<'
Html := Lib.MarkdownToHTML(Md);
Lib.SetOrigin(1); // top-left origin, Y grows downward
Lib.SetMeasurementUnits(0); // points
// Strona pokazuje kod dokładnie tak, jak wpisano, z zapisami encji włącznie
Lib.DrawMarkdownText(50, 50, 495, Md);
Lib.SaveToFile('code-sample.pdf');
finally
Lib.Free;
end;
end;Eksporter datasetu to miejsce, gdzie mieszka kuszący skrót. Gdyby renderer nie dekodował &, escapowanie ampersanda drukowałoby & w każdej komórce, która go zawiera, więc escapowanie samych nawiasów kątowych wygląda na przyjaźniejszy wybór. Rozpada się na pierwszej komórce, której wartość akurat zawiera <, która potem trafia na stronę jako <. Ponieważ renderer dekoduje &, eksporter za PDFlibExportDataSet escapuje & najpierw, a wartość taka jak R&D < & ląduje w PDF dosłownie. Reszta tego eksportera jest omówiona w eksporcie TDataSet do raportu PDF w Delphi
Czemu pierwszy, a nie gdziekolwiek w łańcuchu? Escapuj < najpierw, a dostaniesz <. Escapuj & drugi, a to zamieni się w &lt;, co poprawne pojedyncze dekodowanie pokaże jako < zamiast <. Sekwencyjny łańcuch podstawień działa tylko, gdy znak escape jest sam obsłużony przed każdym krokiem, który go wprowadza
Jak escapować niezaufany tekst dla DrawHTMLTextBox?
Escapuj niezaufaną treść tekstową dla PDFlibPas podstawiając &, potem <, potem > — dokładnie raz — i trzymaj niezaufane dane całkiem poza wartościami atrybutów. Helper spod niżej jest do dodania przez Ciebie; to goły kod RTL:
uses
System.SysUtils, PDFlibrary;
// Twój własny helper (nie część biblioteki): escapuje niezaufany tekst
// dla treści tekstowej HTML PDFlibPas. '&' musi być podstawiony najpierw,
// inaczej ampersand wewnątrz świeżo wyprodukowanego '<' zostanie
// escapowany drugi raz
function EscapeHTMLText(const S: string): string;
begin
Result := StringReplace(S, '&', '&', [rfReplaceAll]);
Result := StringReplace(Result, '<', '<', [rfReplaceAll]);
Result := StringReplace(Result, '>', '>', [rfReplaceAll]);
end;
procedure RenderTicket(const CustomerComment: string);
var
Lib: TPDFlib;
Html: WideString;
begin
Lib := TPDFlib.Create;
try
Lib.SetOrigin(1);
Lib.SetMeasurementUnits(0);
Html := '<p><b>Customer comment</b></p>' +
'<p>' + EscapeHTMLText(CustomerComment) + '</p>';
Lib.DrawHTMLText(50, 50, 495, Html);
Lib.SaveToFile('ticket.pdf');
finally
Lib.Free;
end;
end;Karm go komentarzem Try <a href="https://example.com">this</a> & <b>, a strona pokaże te znaki jeden do jednego. Pod rendererem dekodującym dwa razy to samo escapowane wejście staje się żywą adnotacją łącza. To krok od kosmetycznej wpadki do problemu bezpieczeństwa: komentarz zgłoszenia nigdy nie powinien móc zasadzić klikalnego URL-a w PDF idącym do Twojego własnego personelu
Zauważ, czego helper nie rusza. Uniwersalne escapery podstawiają też " na " i ' na ', co jest właściwe dla przeglądarki i złe tutaj — dekodowanie tekstu PDFlibPas zna tylko cztery encje wypisane wcześniej, więc te dwa wydrukowałyby się dosłownie jako " i '. Nie reużywaj browserowego escapera do tego. Cudzysłowy są nieszkodliwe w treści tekstowej; mają znaczenie tylko wewnątrz wartości atrybutów, a renderer w ogóle nie dekoduje encji w atrybutach. Dla atrybutów wolimy regułę niż sprytniejszy escaper, bo tam i tak żaden schemat escapowania nie jest sprawdzany: trzymaj wartości użytkownika poza href, src i style. Jeśli cel łącza naprawdę musi przyjść z wejścia użytkownika, waliduj go sam przeciw allow-liście schematów i znaków i odrzucaj cokolwiek zawierającego cudzysłowy albo nawiasy kątowe
Z pojedynczego przebiegu dekodowania płyną wprost dwa nawyki:
- Zawsze escapuj
&. Pomiń to, a tekst użytkownika zawierający<pokaże się jako<— nieszkodliwe, ale nie to, co użytkownik wpisał - Escapuj w jednym punkcie. Tekst przepuszczony przez dwa escapery renderuje
<jako widoczny zapis<, więc znajdź jedyne miejsce, gdzie Twoje dane wchodzą do stringa HTML, i escapuj tam
Paginacja z LeftOverText bez psucia escapowania
DrawHTMLTextBox zwraca HTML, który się nie zmieścił, zwyczajowo zwany LeftOverText, i ta reszta zachowuje dosłowne zapisy encji i escapowane nawiasy kątowe nietknięte, gdy idzie do następnego boxa. Podawaj ją z powrotem dokładnie tak, jak ją dostałeś
const
  BoxLeft = 50;
  BoxTop = 50;
  BoxWidth = 495;    // rozmiar pod stronę A4 w punktach
  BoxHeight = 740;
  MaxPages = 500;    // Twój własny bezpieczny sufit

procedure RenderLongHTML(Lib: TPDFlib; const Html: WideString);
var
  Rest: WideString;
  Pages: Integer;
begin
  Lib.SetOrigin(1);
  Lib.SetMeasurementUnits(0);
  Rest := Lib.DrawHTMLTextBox(BoxLeft, BoxTop, BoxWidth, BoxHeight, Html);
  Pages := 1;
  while (Rest <> '') and (Pages < MaxPages) do
  begin
    Lib.NewPage;
    Inc(Pages);
    // Reszta to już escapowany HTML: nigdy jej nie escapuj ani nie de-escapuj
    Rest := Lib.DrawHTMLTextBox(BoxLeft, BoxTop, BoxWidth, BoxHeight, Rest);
  end;
  if Rest <> '' then
    raise Exception.CreateFmt('Content still left after %d pages', [MaxPages]);
end;
Traktuj resztę jako nieprzezroczystą. To znormalizowany HTML ze stylami już rozwiązanymi na każdy tag, więc przepuszczenie jej przez własny escaper zamienia każdy < w &lt;, a dekodowanie jej wręcza następnemu boxowi żywe tagi. Wszczepienie świeżego tekstu użytkownika ma te same dwa tryby porażki. Sufit stron kosztuje jedno porównanie: jeśli jakiś element nigdy nie zmieści się w boxie, nieograniczona pętla nie ma naturalnego wyjścia
Markdown ma własną kontynuację. DrawMarkdownTextBox zwraca resztę zaczynającą się od komentarza znacznika, który mówi wejściom Markdown, by pominąć konwersję przy następnym wywołaniu. Podawaj ją z powrotem do DrawMarkdownTextBox albo DrawMarkdownText — tak samo, jak podawałbyś LeftOverText z powrotem do DrawHTMLTextBox. Reszta Markdown należy do wejść Markdown, więc trzymaj ją po tej stronie i puszczaj przez wywołania HTML wyłącznie reszty DrawHTMLTextBox
Kształt za tym wszystkim — parse, zapis z powrotem do tej samej składni, parse ponownie — wychodzi też w silnikach szablonów, sanitizatorach HTML i łańcuchach Markdown-to-HTML-to-PDF, a porażka przychodzi w dwóch kierunkach. Za mało re-enkodowania zamienia dane w składnię. Za dużo enkodowania albo dekoder puszczany dwa razy pokazuje czytelnikowi zapisy encji albo je zjada. Łatanie jednego kierunku zwykle łamie drugi, dlatego renderer PDFlibPas trzyma dekodowanie &, dekodowanie go jako ostatniego, brak późnego dekodowania i re-escapowanie na każdej granicy jako jedną paczkę. Kierunek eksportu trzyma tę samą regułę w eksporcie semantycznym PDF do Markdown i DOCX z Delphi, gdzie każdy dosłowny znak jest escapowany dla składni docelowej dokładnie raz
Rysowanie HTML i Markdown, eksporter raportów datasetu i reszta silnika layoutu przychodzą jako natywne źródła Pascal w PDF Library for Delphi, i dla Delphi, i dla Free Pascal. Edycje, pokrycie platform i pobranie wersji próbnej są wypisane na stronie produktu PDF Library for Delphi