Pół punktu rozstrzyga. W raporcie z tekstem głównym 10-punktowym tytuł sekcji złożony 11-punktową pogrubioną konwertuje się do Markdown jako zwykły akapit, podczas gdy 12-punktowy podpis na okładce, w zwykłej gramaturze, wraca jako ### Quarterly figures. To wygląda na odwrotne, dopóki nie przypomnisz sobie, co strona PDF faktycznie zapisuje: glify na współrzędnych, nazwę fontu i rozmiar. Nic na stronie nie mówi "nagłówek". Każdy nagłówek, jaki emituje konwerter, to zgadywanka zbudowana z tych trzech faktów, a zgadywanka ma progi
Dlaczego strona PDF nie ma akapitów do eksportu
Strona PDF zawiera operatory pokazywania tekstu, nie akapity. Każdy operator kładzie przebieg glifów na pozycji, w takiej kolejności, w jakiej aplikacja produkująca akurat je wyemitowała, i ISO 32000-1 nie nakłada na producenta żadnego obowiązku powiedzenia, że dwa przebiegi należą do tego samego zdania, notabene do tego samego elementu listy albo komórki tabeli. Format opisuje wydrukowaną stronę dokładnie i osiąga to przez wyrzucenie struktury, która stronę wyprodukowała
Więc każdy konwerter odbudowuje to, co generator wyrzucił. Linie pochodzą ze wspólnych linii bazowych i odstępów pionowych. Łamania akapitów pochodzą ze zmian odstępów i wcięć. Lista to bieg bloków zaczynających się znakiem wypunktowania albo wzorcem numeru. Tabela to siatka bloków tekstu, których krawędzie wyrównują się przez wiersze i kolumny. Na dokumentach trzymających się zwykłych nawyków typograficznych to działa dobrze; na broszurze złożonej dla efektu wizualnego ma bardzo niewiele, do czego się przytwierdzić
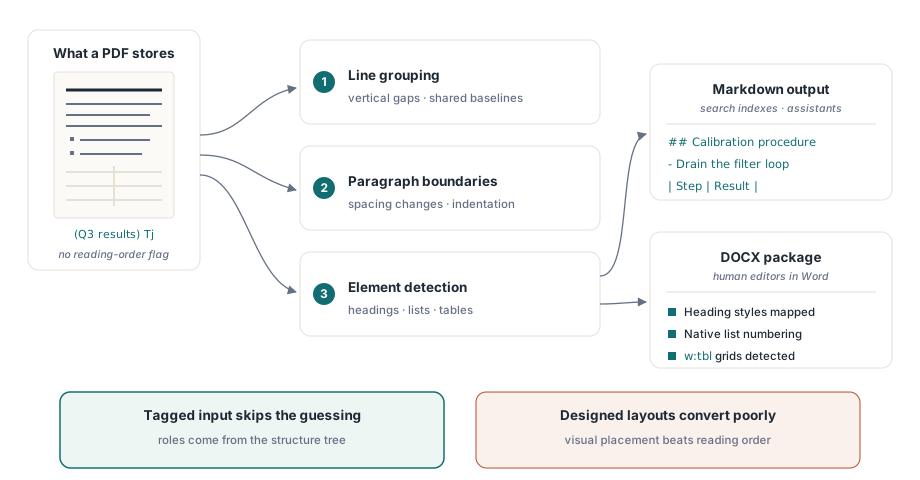
Oznaczone tagami PDF-y są dużym wyjątkiem. Gdy dokument niesie drzewo struktury, role akapitu, nagłówka, listy i tabeli są zapisane przez producenta zamiast odgadnięte po fakcie, dlatego praca opisana w strukturze dostępności oznaczonych tagami PDF opłaca się też w jakości konwersji. Jeśli kontrolujesz producenta, otagowanie wyjścia to najtańsza rzecz, jaką możesz zrobić dla każdego, kto będzie je później konwertował
Skąd biorą się poziomy nagłówków
PDF Library for Delphi rozstrzyga poziomy nagłówków na dwa sposoby, zależnie od wejścia. Na stronie oznaczonej tagami blok, którego rola strukturalna to H1 do H6, zachowuje ten poziom, a H albo Title staje się poziomem 1. Na stronie bez tagów eksport przechodzi na rozmiar fontu względem tekstu głównego strony i bierze pod uwagę tylko jednoakapitowe linie do 200 znaków
Reguła rozmiaru potrzebuje i ilorazu, i bezwzględnej luki, mierzonych wobec dominującego rozmiaru tekstu głównego:
| Wyjście Markdown | Największy tekst w linii | Przy tekście głównym 10 pt |
|---|---|---|
# | co najmniej 1.6 raza rozmiar tekstu głównego i co najmniej 4 pt więcej | 16 pt i więcej |
## | co najmniej 1.35 raza i co najmniej 2.5 pt więcej | 13.5 pt i więcej |
### | co najmniej 1.15 raza i co najmniej 1.25 pt więcej | 11.5 pt i więcej |
To wyjaśnia przykład otwierający. 11-punktowy pogrubiony tytuł nad tekstem 10-punktowym mija trzeci próg o pół punktu, a gramatura nie gra żadnej roli w poziomie. Podpis okładki na 12 punktach go przeskakuje. Bezwzględna luka istnieje dla małych rozmiarów tekstu głównego: przy tekście wielkości przypisu 6 punktów sam iloraz awansowałby linię 7-punktową na nagłówek, a dodatkowe wymaganie 1.25 pt to zatrzymuje
Uważamy to za właściwy kompromis. Pogrubienie jest zbyt częste wewnątrz tekstu głównego (wprowadzenia, terminy zdefiniowane, sumy w linii podsumowania), żeby było samo w sobie niezawodnym sygnałem nagłówka, i konwerter awansujący każdą pogrubioną linię produkuje Markdown z dziesiątkami pozornych sekcji. Przegapienie kilku nagłówków tylko-pogrubionych kosztuje mniej. Jeśli twoje dokumenty polegają na tytułach pogrubionych w rozmiarze tekstu głównego, niezawodna poprawka jest upstream: otaguj je albo podbij rozmiar tytułu o punkt i pół
Pogrubienie i kursywa w wyjściu są czytane z nazwy fontu. Przebieg, którego nazwa fontu zawiera Bold, Black albo Demi, staje się **bold**; Italic albo Oblique staje się *italic*. Producenci, którzy subsetują fonty pod nieprzejrzystymi nazwami takimi jak F3, albo udają pogrubienie obrysowując zwykłe glify, nie dają eksportowi niczego do czytania, i ten tekst przychodzi bez stylu
Eksport Markdown dla potoków wyszukiwawczych
Ścieżka Markdown jest tą, po którą sięgać, gdy celem jest potok tekstowy: witryna dokumentacji, indeks wyszukiwania, pocięty korpus dla asystenta. ExportPageMarkdown zwraca jedną stronę jako WideString, ExportDocumentMarkdown zwraca zakres stron, a SaveMarkdownToFile i SaveMarkdownToStream zapisują ten sam tekst jako UTF-8 bez znacznika kolejności bajtów. Brak BOM jest celowy; sporo generatorów witryn statycznych i narzędzi do diffów traktuje go jako treść
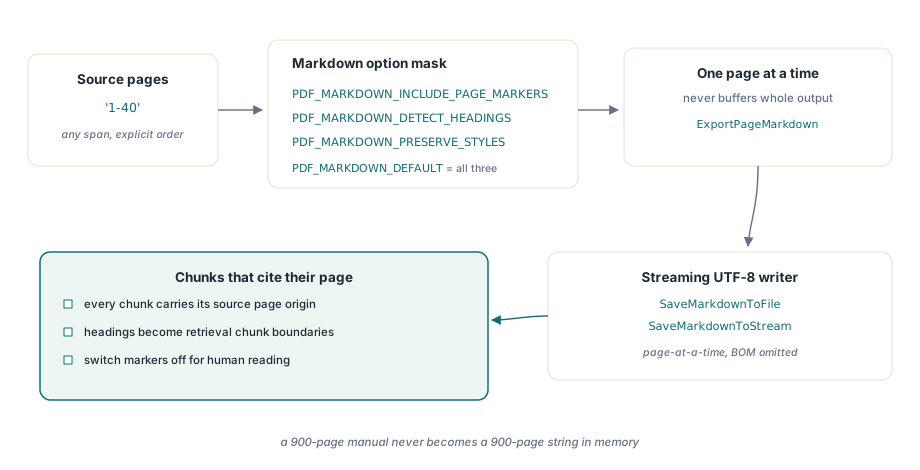
Opcje to maska bitowa: PDF_MARKDOWN_INCLUDE_PAGE_MARKERS (1), PDF_MARKDOWN_DETECT_HEADINGS (2) i PDF_MARKDOWN_PRESERVE_STYLES (4), przy czym PDF_MARKDOWN_DEFAULT łączy wszystkie trzy. Drugie, całodokumentowe ustawienie steruje samą analizą: SetStructuredTextOptions przyjmuje flagi PDF_STRUCTURED_* i jego domyślne wykrywa kolumny, wykrywa powtarzające się nagłówki i stopki oraz skleja tabele, które ciągną się przez łamanie strony
uses
  SysUtils, PDFlibrary;

var
  Pdf: TPDFlib;
  Exported: Integer;
begin
  Pdf := TPDFlib.Create;
  try
    if Pdf.LoadFromFile('handbook.pdf', '') = 0 then
      raise Exception.Create('Cannot open handbook.pdf');

    // Wykrywanie powtarzających się nagłówków i stopek jest domyślnie włączone;
    // dodanie EXCLUDE_FURNITURE zrzuca je też z wyjścia
    Pdf.SetStructuredTextOptions(PDF_STRUCTURED_ADVANCED_DEFAULT or
      PDF_STRUCTURED_EXCLUDE_FURNITURE);

    // Znaczniki stron i nagłówki, ale bez wyróżnień ** i *
    Exported := Pdf.SaveMarkdownToFile('1-40',
      PDF_MARKDOWN_INCLUDE_PAGE_MARKERS or PDF_MARKDOWN_DETECT_HEADINGS,
      'handbook.md');
    if Exported = 0 then
      raise Exception.CreateFmt('Markdown export failed, error %d',
        [Pdf.LastErrorCode]);

    // JSON z jednym wpisem na stronę: readingSource to tagged, mixed,
    // geometric albo geometric-columns
    Writeln(Pdf.GetLastStructuredTextDiagnostics);
  finally
    Pdf.Free;
  end;
end;
Dla korpusu wyszukiwawczego wyrzucamy PDF_MARKDOWN_PRESERVE_STYLES. Wyróżnienia są nakładane przebieg po przebiegu, więc pogrubiona fraza złożona z kilku przebiegów wychodzi jako **Net** **revenue**, co czyta się dobrze na ekranie i dokłada szumu do każdego embeddingu. Znaczniki stron to przypadek odwrotny: trzymaj je. Każdy znacznik to komentarz HTML, <!-- page: 12 -->, niewidoczny, gdy Markdown jest renderowany, i banalny do sparsowania, gdy tniesz fragmenty, więc odzyskany fragment może zacytować stronę, z której przyszedł. Gdy tabela ciągnie się z poprzedniej strony, znacznik nowej strony jest pomijany, żeby tabela pipe zostawała w jednym kawałku
Dwa zachowania łapią ludzi eksportujących strona po stronie w pętli. Po pierwsze, powtarzające się nagłówki są rozpoznawane przez powtarzalność: akapit w górnych albo dolnych 12 procentach strony liczy się jako meble, gdy pasujący tekst siedzi w tym samym paśmie na innej stronie tego samego eksportu, z cyframi znormalizowanymi, więc "Page 3 of 40" pasuje do "Page 4 of 40". Wywołanie jednostronicowe nie ma innej strony do porównania, więc nieotagowany powtarzający się nagłówek zostaje w tekście. Po drugie, obrazy w Markdown są osadzane inline jako URI data:, co trzyma plik samowystarczalnym i znaczy, że strona z dużą fotografią potrafi dolać setki kilobajtów base64 do pliku. Jeśli twój chunker ma limit rozmiaru, obetnij linie zaczynające się od 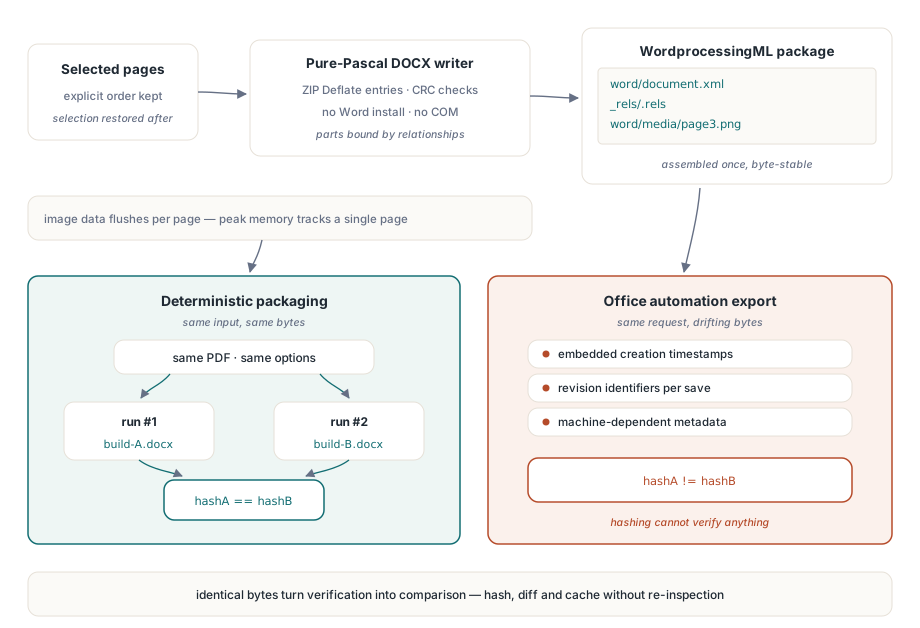
Dwa wybory utrzymują to w ryzach. Każdy wpis ZIP niesie tę samą stałą datę DOS, 1 stycznia 1980, zamiast czasu przebiegu, a część właściwości rdzeniowych nie ma dat stworzenia ani modyfikacji. Każdy wpis jest kompresowany gołym Deflate tylko wtedy, gdy faktycznie robi go mniejszym, więc media PNG, już skompresowane, są składowane jak leżą. Pierwszy punkt potwierdzisz przez unzip -v handbook.docx: każdy wiersz pokazuje tę samą datę
Automatyzacja Office nie może dać ci tego. Zapis przez Worda stempluje bieżący czas w metadane pakietu i nagłówki ZIP, więc ten sam dokument skonwertowany dwa razy różni się w sposób, który grzebie hasz. Za tym samym rozumowaniem stoją stabilne identyfikatory plików w deterministycznych identyfikatorach PDF dla powtarzalnych buildów: skoro wyjście jest powtarzalne, weryfikacja staje się porównaniem
Które wejścia konwertują się dobrze, a które nigdy nie będą
Jakość konwersji zależy bardziej od wejścia niż od konwertera i warto mówić swoim użytkownikom o tym z góry. Oznaczone tagami PDF-y i czysto wygenerowane dokumenty biznesowe (faktury, raporty, umowy) konwertują się dobrze: nagłówki lądują jako nagłówki, tabele przetrwają, listy przenumerowują się w Wordzie. Dwukolumnowe układy akademickie przechodzą w właściwej kolejności czytania, gdy geometria kolumn jest regularna, a diagnostyka zgłosi dla tych stron geometric-columns. Tabele łamiące się przez strony są sklejane z powrotem przez wnioskowanie, więc wyrywkuj je. Mocno zaprojektowany materiał marketingowy, gdzie tekst jest kładziony dla efektu, a nie w kolejności czytania, daje każdemu konwerterowi niewiele do odzyskania; spodziewaj się poprawek ręcznych
Dokumenty skanowane to osobny przypadek. Strona będąca jednym dużym obrazem nie zawiera obiektów tekstowych, więc nie ma czego eksportować, dopóki nie powstanie warstwa tekstowa, a puszczenie OCR jest warunkiem wstępnym dla obu formatów. Zanim zaangażujesz się w dużą partię, wypróbkuj kilkanaście reprezentatywnych plików i wylicz, co zawierają ich strony, jak opisano w wyszukiwaniu tekstu i wyliczaniu elementów strony; strona z obrazami i bez przebiegów tekstu powie ci więcej w sekundę niż czytanie skonwertowanego wyjścia
Wybierz format według tego, co dzieje się dalej. Markdown pasuje maszynom i potokom: nagłówki stają się granicami fragmentów, tabele zostają czytelne jako tabele pipe, a znaczniki stron dają każdemu fragmentowi cytowanie. DOCX pasuje ludziom, którzy muszą zmieniać dokument, bo to, co chcą dostać z powrotem, to edytowalny plik w Wordzie, z prawdziwymi listami i prawdziwymi tabelami, a sam tekst nie daje im tego
PDF Library for Delphi pływa dla Delphi, C++Builder i Lazarus, z edycjami DLL i ActiveX, które wystawiają te same wywołania eksportu Markdown i DOCX hostom C#, C++ i skryptowym. Referencja każdej flagi opcji i wersja próbna są na stronie produktu PDF Library for Delphi