PDF od dostawcy wygląda na ekranie idealnie, a walidator PDF/A odrzuca go jednym wierszem: 00030 At least one font is not embedded. Przeglądarka pożyczała czcionki z twojej maszyny przez cały czas. Otwórz deskryptor czcionki wewnątrz pliku, a prawie wszystko, czego potrzebuje czcionka osadzona, już tam jest, aż po szerokość trzonka i ramkę otaczającą; brakuje jednego odwołania do strumienia niosącego sam program czcionki
Ta historia w wydaniu wsadowym jest znajoma każdemu, kto prowadzi potok przyjmowania dokumentów do archiwum. Faktury, umowy i zeskanowane formularze przychodzą od dostawców i biur, każde biurko w firmie renderuje je dobrze, a walidator odrzuca plik za plikiem z tym samym wierszem. Nikt w górę łańcucha niczego nie wygeneruje ponownie. Potok musi naprawić to, co dostaje, i właśnie tę robotę opisuje ten artykuł. Jego towarzysz, artykuł o wykrywaniu naruszeń PDF/A i PDF/UA raportem preflight, mówi ci, które pliki są zepsute; ten zajmuje się najczęstszym pojedynczym sposobem, w jaki się psują
O co naprawdę prosi błąd 00030
ISO 19005-1 §6.3.4 wymaga, by każda czcionka używana przez zgodny plik niosła swój program czcionki wewnątrz tego pliku. Uzasadnienie to zwykła logika archiwalna. Dokument otwarty za pięćdziesiąt lat, na maszynie niedzielącej żadnej czcionki z tą, która go wyprodukowała, musi renderować się identycznie, a czcionka nieosadzona to tylko polecenie, żeby poszukać czegoś zwanego Arial w systemie, który akurat czyta. Jakiekolwiek glify i metryki ma zamiennik, to właśnie je widzi czytelnik
Nawyk nieosadzania sięga konwencji Standard 14. Wczesny PDF obiecywał, że każda przeglądarka dostarcza Helvetica, Times, Courier, Symbol i ZapfDingbats, więc generatory nauczyły się odwoływać do nich po nazwie i niczego nie osadzać. Sporo narzędzi wciąż tak robi. PDF/A odwołuje tę zwolnicę, a losLab PDF Library for Delphi stosuje ją po stronie zapisu: przy aktywnym trybie PDF/A albo PDF/X AddStandardFont zwraca 0 bez wybrania czcionki, bo biblioteka nie pakuje konturów Standard 14 i nie zapisze odwołania, którego nie potrafi podparć programem. AddTrueTypeFont z Embed=0 jest przy trybie PDF/A podnoszony do pełnego osadzenia, a Embed=2 (podzbiór) przechodzi bez zmian, bo podzbiór nadal jest osadzonym programem
To obejmuje pliki, które piszesz sam. Plik od dostawcy jest trudniejszy, bo słowniki czcionek napisał czyjś generator i nie ma jak poprosić go o drugą próbę. Dla takich plików biblioteka dostarcza EmbedMissingFonts, które naprawia wczytany dokument w miejscu, kopiując każdy brakujący program z czcionek zainstalowanych do deskryptora, który dokument już niesie
Czemu czcionce nieosadzonej potrzeba tylko jednego dodatkowego klucza?
Generator zapisujący nieosadzoną czcionkę TrueType nadal produkuje kompletny FontDescriptor: FontName, FontBBox, Flags, Ascent, Descent, StemV, CapHeight. Pomija tylko strumień niosący program czcionki, przywoływany z deskryptora jako /FontFile2 dla konturów TrueType albo /FontFile3 dla czcionek CID opartych na CFF. Dokładnie to dodaje EmbedMissingFonts. Czyta bajty programu, zapisuje je jako nowy strumień skompresowany Flate z wpisem /Length1 i doczepia odwołanie do deskryptora, który już tam jest
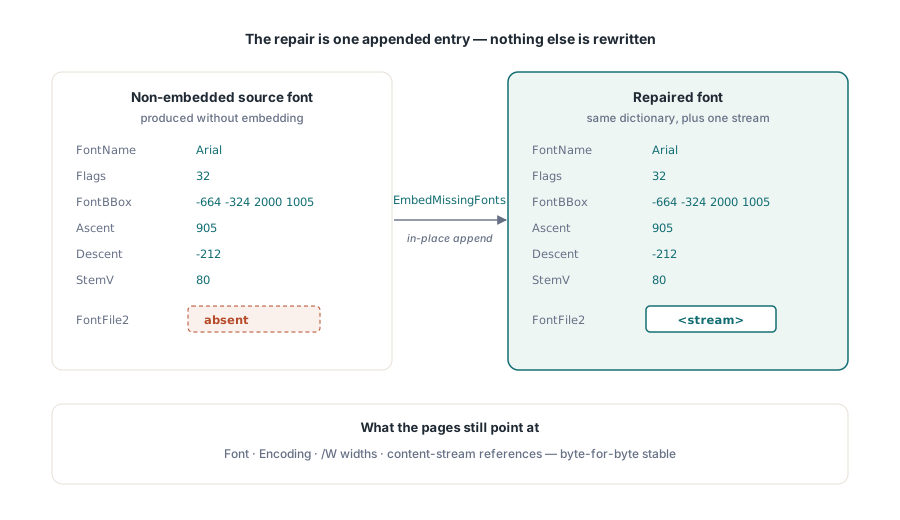
Uważamy, że podejście w miejscu to właściwy domyślny dla plików dziedziczonych, a powodem jest tablica Widths. Pozycje tekstu w strumieniu treści PDF są już ustalone; przeglądarka robi posuw szerokościami zapisanymi przez pierwotny generator. Przebudowa słownika czcionki z czcionki zainstalowanej zastąpiłaby te szerokości świeżo zmierzonymi, a jeśli zainstalowana wersja kroju różni się choć odrobinę od wersji autora, zmieniłeś dokument, który miałeś zachować. Zostawienie słownika, kodowania, szerokości i każdego strumienia treści nietkniętymi znaczy, że strony wciąż wskazują te same nazwy zasobów z tymi samymi metrykami
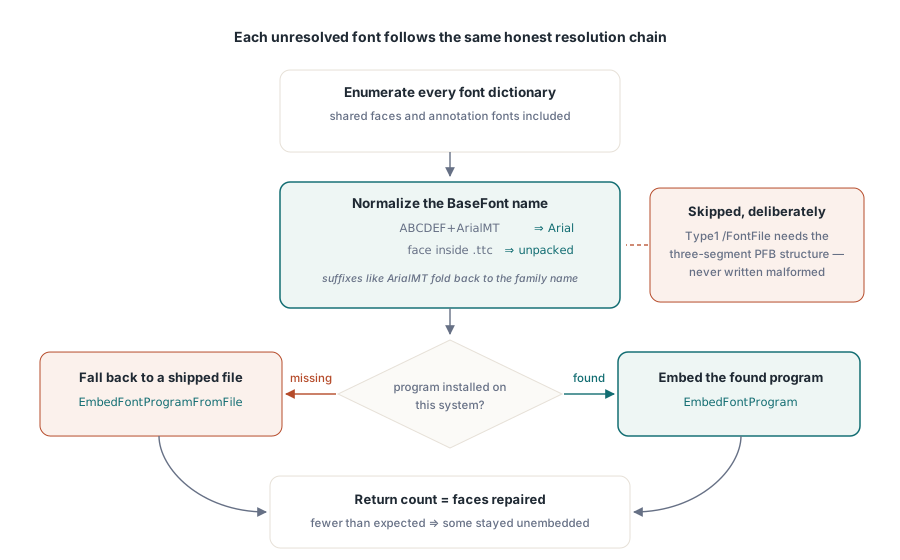
Przejście obejmuje każdy słownik Font w pliku, nie tylko te osiągalne z zasobów stron, więc czcionki używane tylko w wyglądach adnotacji albo współdzielone między stronami też są łapane. Złożone czcionki Type0, rodzaj produkowany dla tekstu CJK i większości nowoczesnego wyjścia Unicode, są obsłużone przez ich potomka CIDFont. Cała naprawa to jedno wywołanie na wczytanym dokumencie:
var
  PDF: TPDFlib;
  Repaired: Integer;
begin
  PDF := TPDFlib.Create;
  try
    if PDF.LoadFromFile('supplier-invoice.pdf', '') <> 1 then
      raise Exception.Create('Could not load PDF');

    // Zwraca, ile czcionek zyskało program. Czcionki już
    // osadzone są zostawiane w spokoju; czcionki bez zainstalowanego
    // odpowiednika są pomijane i po prostu nie liczone.
    Repaired := PDF.EmbedMissingFonts;
    Writeln(Format('%d font program(s) embedded', [Repaired]));

    PDF.SaveToFile('supplier-invoice-repaired.pdf');
  finally
    PDF.Free;
  end;
end;
Jak wyszukiwanie w czcionkach zainstalowanych dopasowuje nazwy
Nazwy BaseFont w prawdziwych plikach rzadko zgadzają się z nazwą rodziny, którą zna Windows. EmbedMissingFonts normalizuje każdą nazwę przed wyszukaniem:
- Prefiks podzbioru (sześć wielkich liter i plus, jak w
KQBWTE+Calibri) jest zdejmowany - Wszystko po pierwszym przecinku albo myślniku jest czytane jako styl, więc
Arial,BoldItaliciArial-BoldMTproszą o krój pogrubiony, aItalicalboObliqueo pochyły - Końcowe przyrostki
MTiPSsą zrzucane, więcArialMTrozwiązuje się doArial - Gdy krój mieszka wewnątrz TrueType Collection (.ttc), przesunięcia tabel są korygowane, tak by osadzony program był poprawną czcionką samodzielną
Trudniejszy problem to ten, że maper czcionek Windows nigdy nie mówi nie. Poproś GDI o rodzinę, której nie ma zainstalowanej, a odda krój zamiennika bez sprzecu; poproś o pogrubienie w rodzinie mającej tylko krój zwykły, a pogrubi kontury na ekranie. Każdy z tych wyników dałby ci idealnie wczytywalny program czcionki, który jest złą czcionką. Wyszukiwanie sprawdza więc krój, który GDI faktycznie wybrał, względem żądanej rodziny, ignorując spacje i wielkość liter, i sprawdza bity pogrubienia oraz pochyłości kroju względem żądanego stylu. Niezgodność w którejkolwiek z tych rzeczy znaczy, że czcionka jest pomijana
To celowy kompromis. Wyszukiwanie pobłażliwe podniosłoby liczbę napraw w każdej partii, a część tych „napraw” osadzałaby Arial Regular pod czcionką, którą dokument nazywa Arial,Bold. ISO 19005-1 §6.3.6 wymaga, by szerokości w słowniku czcionki zgadzały się z osadzonym programem, więc bliskie trafienie może zamienić błąd 00030 na błąd zgodności szerokości, a w najgorszym razie przechodzi walidację, renderując się odrobinę inaczej, niż zamierzał autor. Wolimy zgłosić pominięcie niż zarchiwizować zgadywankę
Wyszukiwanie czyta czcionki zainstalowane przez Windows GDI. W buildach na Linux albo macOS ścieżka systemowa nie zwraca niczego, a wywołanie oparte na pliku z następnej sekcji jest sposobem na dostarczenie programów
Co się dzieje, gdy czcionki nie ma w systemie?
Wartość zwracana ci to powie. Jeśli EmbedMissingFonts raportuje mniej czcionek, niż wiesz, że brakuje, różnicą są czcionki, których maszyna nie ma, albo nie ma w właściwym stylu. Dla nich EmbedFontProgramFromFile(FontName, FileName) dołącza program z pliku .ttf albo .otf, który dostarczysz, dzięki czemu potok może wozić ze sobą kroje firmowe, których spodziewa się spotkać, i celowo na nie przechodzić
Wzorzec, który w praktyce działa najlepiej, to dwa przejścia. Uruchom EmbedMissingFonts i zapisz, potem wczytaj wynik, wylicz, co wciąż jest nieosadzone, i zaoferuj każdą pozostałą nazwę własnemu folderowi czcionek. Ponowne wczytanie ma znaczenie: flaga osadzenia, którą GetFontIsEmbedded raportuje dla wyliczonej czcionki, odzwierciedla plik taki, jaki był, gdy odpalało FindFonts, więc wyliczanie w tej samej sesji co naprawa pokazywałoby nieświeże odpowiedzi
function FontFileFor(const BaseFont: string): string;
begin
  // Twoja własna funkcja pomocnicza (nie część biblioteki): mapuje
  // nazwy czcionek dokumentu na pliki czcionek dostarczane z aplikacją.
  // Pusty wynik sprawia, że EmbedFontProgramFromFile zwraca 0
  // bez dotykania systemu plików.
  if Pos('CorporateSans', BaseFont) > 0 then
    Result := ExtractFilePath(ParamStr(0)) + 'fonts\CorporateSans.ttf'
  else
    Result := '';
end;

procedure EmbedFromShippedFonts(const InFile, OutFile: string);
var
  PDF: TPDFlib;
  I, FontID: Integer;
  Name: string;
begin
  PDF := TPDFlib.Create;
  try
    if PDF.LoadFromFile(InFile, '') <> 1 then
      Exit;
    PDF.FindFonts;
    for I := 1 to PDF.FontCount do
    begin
      FontID := PDF.GetFontID(I);
      if (FontID > 0) and (PDF.SelectFont(FontID) = 1) and
         (PDF.GetFontIsEmbedded = 0) then
      begin
        // Podaj nazwę dokładnie tak, jak jest zapisana, z prefiksem podzbioru
        Name := PDF.FontName;
        if PDF.EmbedFontProgramFromFile(Name, FontFileFor(Name)) = 0 then
          Writeln('Still not embedded: ', Name);
      end;
    end;
    PDF.SaveToFile(OutFile);
  finally
    PDF.Free;
  end;
end;
O trzy szczegóły rozbija się to, czy pętla powiedzie się. Wywołania po nazwie, EmbedFontProgram dla czcionki zainstalowanej i EmbedFontProgramFromFile dla pliku, porównują z BaseFont dokładnie tak, jak dokument ją zapisuje, i działają na pierwszym słowniku Font niosącym tę nazwę, dlatego pętla przekazuje PDF.FontName wprost, zamiast oczyszczonej nazwy rodziny. Format programu musi pasować do typu czcionki: dane TrueType z konturami glifów dla czcionki TrueType albo CIDFontType2, program OpenType CFF (takiego zaczynającego się od znacznika OTTO) dla czcionki CIDFontType0, zapisywanego wtedy jako /FontFile3 z subtypem OpenType. Podaj plik CFF czcionce TrueType, a wywołanie zwróci 0. A ścieżka naprawy obejmuje czcionki TrueType i CID; wpis /FontFile czcionki Type1 wymaga trzysegmentowego układu PFB z jawnymi kluczami długości, więc odwołania Type1 są pomijane i zostawiane, by zwracana liczba je oznaczyła. Odwołania Standard 14 są zwykle zapisywane jako Type1, więc spodziewaj się ich na tej resztkowej liście
Jest też pytanie, na które biblioteka nie odpowie za ciebie. Uprawnienia do osadzania czcionki TrueType należą do jej odlewni, a potok zapisujący licencjonowane programy do dokumentów opuszczających organizację potrzebuje kogoś, kto potwierdzi, że licencje na to pozwalają. Kod osadzi każdy plik, na który go wskażesz. To, czy wolno ci, jest pytaniem prawnym
Domknięcie pętli z CreatePreflightReport
Audyt, który odrzucił plik, powinien być tym, który go przepuszcza. CreatePreflightReport z ComplianceTests = 1 odpala kontrole PDF/A, a ustalenie 00030 jest raportowane raz na cały plik, więc pojedyncza przeoczona czcionka utrzymuje go w raporcie. Uruchom go na źródle, napraw i zapisz, potem uruchom ponownie na wyjściu
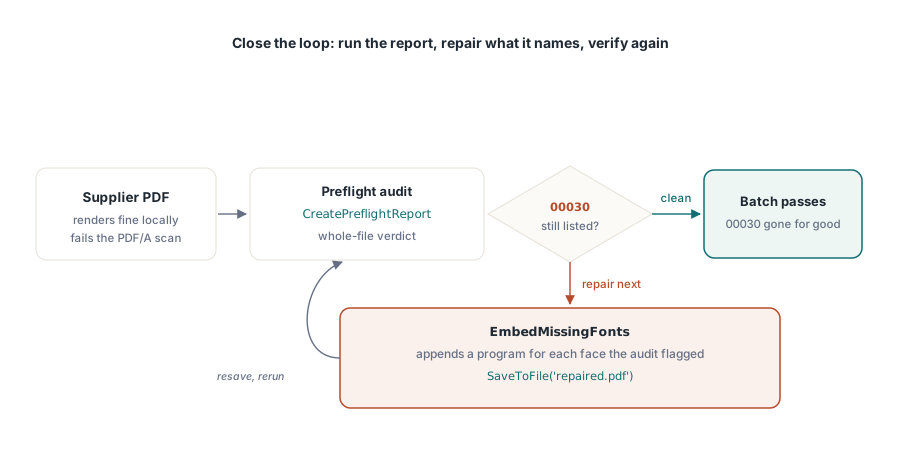
function HasFontEmbeddingViolation(PDF: TPDFlib;
  const FileName: string): Boolean;
var
  Report: string;
begin
  // ComplianceTests = 1 wybiera kontrole PDF/A
  Report := PDF.CreatePreflightReport(FileName, '', 1, 0);
  Result := Pos('00030', Report) > 0;
end;
Jeden wynik zaskakuje ludzi za pierwszym razem. Kontrola czcionek ignoruje czcionki, które treść rysuje wyłącznie niewidocznie, w trybie renderowania tekstu 3, czyli tak, jak większość silników OCR kładzie przeszukiwalną warstwę tekstu nad zeskanowany obraz. Plik skanowany może więc przejść 00030, choć FindFonts wciąż wylicza krój nieosadzony. To spójne z tym, jak PDF/A traktuje tekst niewidoczny, i znaczy, że wyliczenie per czcionka i werdykt per plik mogą w pełni uczciwie się różnić na tym samym dokumencie
Dla logów wsadowych, które muszą nazwać dokładnie który krój w którym pliku pozostał nieosadzony, lepszym narzędziem jest wyliczenie per czcionka: wczytaj wyjście, wywołaj FindFonts, potem SelectFont i GetFontIsEmbedded dla każdego wpisu. Artykuł o wydobywaniu tekstu, obrazów i czcionek z wczytanych plików PDF używa tego samego wyliczania, by zasilić ekstrakcję zamiast naprawy
Osadzenie zdejmuje jedno ustalenie, a twoje własne wyjście nigdy nie powinno go potrzebować
Osadzenie czcionek usuwa błąd 00030 i nic poza tym. Plik, który zawodzi też na szyfrowaniu, brakujących metadanych XMP, przestrzeni barw zależnej od urządzenia bez OutputIntent albo czcionkach bez map ToUnicode, nadal zawiedzie po osadzeniu każdego programu, więc naprawa należy do pętli preflight i pracuje przez to, co raport nazwie. Rozmiar to drugi koszt. Pełny program czcionki CJK potrafi sięgnąć kilku megabajtów, a osadzenie kilku z nich może uczynić jednostronicową fakturę wielokrotnie większą od pierwotnej; artykuł o optymalizacji rozmiaru pliku PDF i podzbiorach czcionek opisuje przycinanie każdego osadzonego programu do glifów, których strony faktycznie używają
Po stronie zapisu SetEmbedAllFonts(1) powstrzymuje twój własny kod przed produkowaniem plików, które ten artykuł naprawia. Stosuje to samo podnoszenie, jakiego tryb PDF/A używa wobec zwykłego dokumentu: każde późniejsze wywołanie AddTrueTypeFont z Embed=0 osadza pełny program. Ustawienie należy do wybranego dokumentu i dotyka czcionek dodanych po wywołaniu, więc ustaw je zaraz po NewDocument. Nasza rekomendacja to włączanie tego dla wszystkiego, co może trafić do archiwum, PDF/A albo nie, bo pliki, które dziś tworzysz, to dziedziczone pliki tego, kto je później czyta
PDF.NewDocument;
PDF.SetEmbedAllFonts(1);
// Od tego miejsca AddTrueTypeFont('Segoe UI', 0) osadza
// pełny program, dokładnie jak AddTrueTypeFont('Segoe UI', 1)
PDF.AddTrueTypeFont('Segoe UI', 0);
Ścieżka wczytaj-napraw-zapisz, fallback oparty na pliku i zabezpieczenie po stronie zapisu wchodzą w skład losLab PDF Library dla Delphi, C# i VB.NET, razem z silnikiem preflight używanym wyżej do potwierdzenia wyniku; strona produktu dokumentuje resztę API czcionek, łącznie z inspekcją per czcionka i tworzeniem podzbiorów