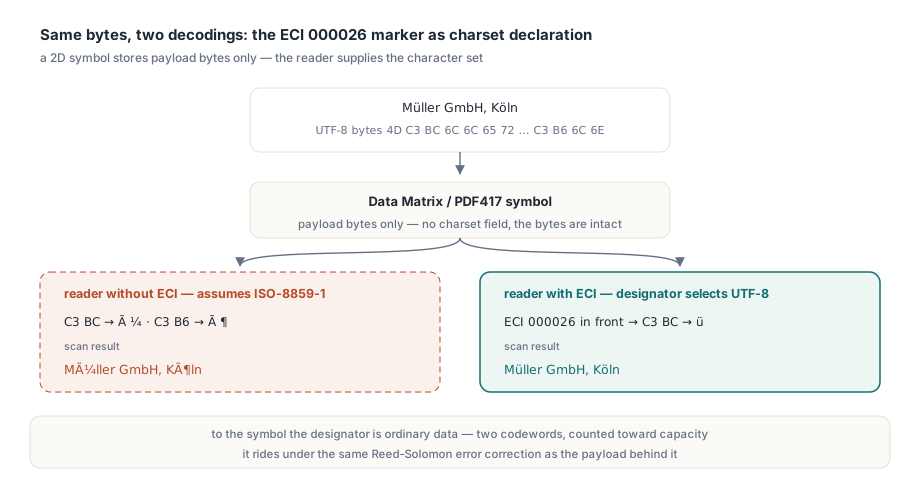
Etykieta magazynowa zapisuje odbiorcę Müller GmbH, Köln jako UTF-8 w symbolu Data Matrix, a każda skanerka ręczna na hali odczytuje z powrotem Müller GmbH, Köln. Ustawienie właściwości BarcodePayloadEncoding biblioteki PDFlibPas na bpeUTF8WithECI wstawia przed danymi znacznik ECI 000026, który mówi czytnikom Data Matrix i PDF417, żeby dekodowały bajty jako UTF-8
Dlaczego payload UTF-8 dekoduje się jako Müller?
Symbol nie niesie deklaracji zestawu znaków, więc czytnik wraca do domyślnego jednobajtowego zestawu znaków symbologii, którym dla Data Matrix jest ISO-8859-1. UTF-8-owe ü to dwa bajty C3 BC, które ISO-8859-1 mapuje na à i ¼; ö staje się ö tym samym mechanizmem. Same bajty są nietknięte. Extended Channel Interpretation to odpowiednik deklaracji zestawu znaków w świecie kodów kreskowych. Rejestr ECI organizacji AIM przydziela zestawom znaków numery, wśród nich 000026 dla UTF-8, a symbol otwarty oznacznikiem ECI każe zgodnemu ze standardem czytnikowi dekodować wszystko po nim właśnie w tym zestawie. Dla symbolu ten oznacznik to zwykłe dane. W obu omawianych tu symbologiach zajmuje dwa słowa kodowe, wlicza się do pojemności i jest chroniony tą samą korekcją błędów Reed-Solomon dla kodów 2D co payload za nim
Pozycje słów kodowych ECI w Data Matrix i PDF417
Każda symbologia ma sztywno wyznaczone miejsce na znacznik. Wstaw go gdzie indziej, a symbol albo w ogóle się nie zdekoduje, albo zdekoduje się ze śmieciami na początku:
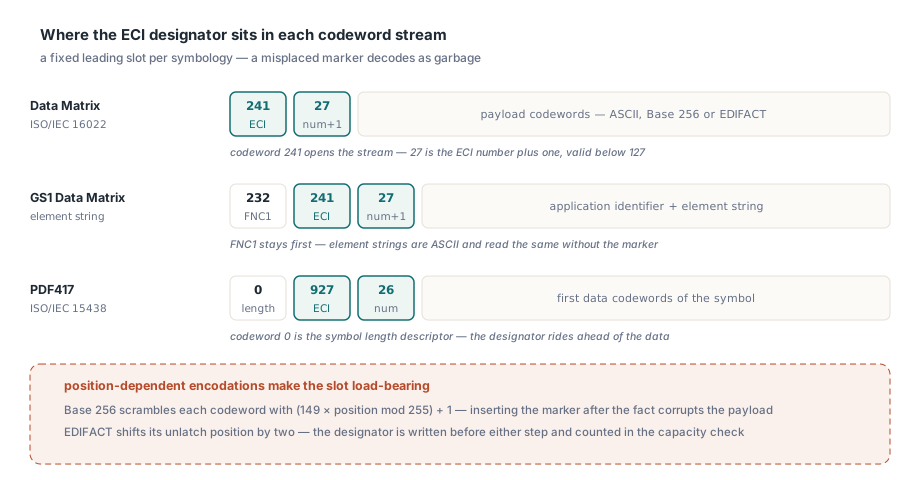
- Data Matrix (ISO/IEC 16022): słowo kodowe 241, potem numer ECI plus jeden w jednosłownej formie używanej dla wartości poniżej 127, czyli 27 dla UTF-8. Otwiera strumień danych
- GS1 Data Matrix: FNC1 (słowo kodowe 232) musi zostać na pierwszej pozycji, więc PDFlibPas stawia znacznik od razu za nim, jeśli o niego poprosisz; łańcuchy elementów GS1 pochodzą jednak z podzbioru ASCII i bez niego czytają się tak samo
- PDF417 (ISO/IEC 15438): słowo kodowe 0 to deskryptor długości symbolu, a za nim idzie znacznik jako słowa kodowe 927 i 26, przed pierwszym słowem kodowym danych
Base 256 to trudny przypadek. To kodowanie, zwarty tryb Data Matrix dla dowolnych bajtów, miesza każde słowo kodowe wartością pseudolosową wyliczoną z jego absolutnej pozycji w symbolu, (149 × position mod 255) + 1. Doklej znacznik po mieszaniu, a każdy bajt za nim był pomieszany dla pozycji o dwa miejsca wcześniejszej niż ta, którą widzi czytnik, więc cały payload rozmesza się do złych wartości. Kodowanie EDIFACT ma łagodniejszą wersję tej samej zależności — jego pozycja unlatch przesuwa się o dwa, gdy znacznik trafia na przód. PDFlibPas zapisuje znacznik do strumienia słów kodowych, zanim którykolwiek z tych kroków ruszy, a kontrola pojemności wybierająca rozmiar symbolu już go wlicza. Kod etykiety dla obu symbologii:
uses
  SysUtils, PDFlibrary;

procedure PrintConsigneeLabel(const FileName: string);
var
  Pdf: TPDFlib;
begin
  Pdf := TPDFlib.Create;
  try
    Pdf.NewDocument;                                // tworzy i wybiera stronę 1
    Pdf.SetPageSize('A4');
    Pdf.SetMeasurementUnits(1);                     // milimetry
    Pdf.SetOrigin(1);                               // Top liczy się od górnej krawędzi

    Pdf.BarcodePayloadEncoding := bpeUTF8WithECI;   // bajty UTF-8 + ECI 000026
    if Pdf.DrawDataMatrixSymbol(20, 20, 0.5, 'Müller GmbH, Köln',
      1,      // Encoding: 1 = kodowanie ASCII
      0,      // SymbolSize: 0 = pierwszy z tabeli rozmiar, który się mieści
      100) <> 1 then                                // normalna orientacja, domyślna strefa ciszy 1 modułu
      raise Exception.CreateFmt('Data Matrix failed (%d)', [Pdf.LastErrorCode]);

    if Pdf.DrawPDF417SymbolEx(20, 50, 'Zustellung: Müller GmbH, Köln',
      0, 0, 0,  // orientacja, kolumny, wiersze: automatycznie
      -1,       // poziom korekcji automatyczny
      0.3, 3.0) <> 1 then
      raise Exception.Create('PDF417 failed');

    // Skaner obsługujący ECI powinien zwrócić niemiecki tekst dla obu symboli
    Pdf.BarcodePayloadEncoding := bpeSystemANSI;    // powrót do wartości domyślnej
    Pdf.SaveToFile(FileName);
  finally
    Pdf.Free;
  end;
end;
NewDocument tworzy stronę 1 i od razu ją wybiera, więc symbole lądują na pierwszej stronie bez wołania NewPage. SetOrigin(1) przenosi początek układu do lewego górnego rogu, przez co Top staje się odległością górnej krawędzi symbolu od góry strony. Przy domyślnym początku w lewym dolnym rogu Top równy 10 mm stawia tę krawędź 10 mm nad dołem arkusza, a 11-milimetrowy symbol zwisa z niego. DrawDataMatrixSymbol zwraca 1 przy sukcesie. Dla danych, których nie umie zakodować — payloadu, który po doliczeniu znacznika przerasta największy symbol, albo wymuszonego rozmiaru — zwraca 0, ustawia LastErrorCode na 302 i niczego nie rysuje, więc przykład traktuje wszystko poza 1 jako błąd
Czy każda etykieta powinna nosić znacznik ECI?
Nie, i domyślna wartość to odzwierciedla. BarcodePayloadEncoding przyjmuje trzy wartości, a każda pasuje do innej populacji czytników:
bpeSystemANSI(domyślna) przepuszcza tekst przez systemową stronę kodową ANSI i nie zapisuje żadnego znacznika, czego oczekują układy etykiet zbudowane przy pomocy funkcji QR, PDF417 i Data Matrix w PDFlibPasbpeUTF8zapisuje bajty UTF-8 bez znacznika, dla systemów zamkniętych, w których kod odczytuje twoje własne oprogramowanie i z góry zakłada UTF-8bpeUTF8WithECIzapisuje bajty UTF-8 i opatruje je oznaczeniem ECI 000026
Ceną etykietowania wszystkiego jest wsparcie po stronie czytników. Obsługa ECI to opcja konfiguracyjna wielu skanerek i zależnie od tego ustawienia urządzenie może odmówić symbolu albo przepuścić oznacznik do gospodarza jako tekst: konwencja AIM to backslash i sześć cyfr, więc aplikacja dostaje \000026Müller GmbH, Köln. Włączaj znacznik per symbol, dla payloadów z tekstem spoza ASCII, i wdrażaj go razem ze zmianą profilu skanerek. Jednobajtowy payload to wciąż uczciwy wybór, gdy każda nazwa mieści się w stronie kodowej zakładanej przez twoje czytniki. ü to bajt FC i w Windows-1252, i w ISO-8859-1, więc niemiecki adres zapisany pod bpeSystemANSI na zachodnioeuropejskim Windowsie zdekoduje się poprawnie na czytniku Data Matrix, który o ECI nigdy nie słyszał. Tekst japoński nie ma takiego planu awaryjnego
Rozmiar symbolu: wybór automatyczny, sztywne szablony i prostokąty
Dwa słowa kodowe znacznika rzadko działają w pojedynkę. Przy kodowaniu ASCII wiersz odbiorcy pod bpeSystemANSI niesie ü i ö jako pojedyncze bajty powyżej 127, po dwa słowa kodowe każdy, a cały wiersz kosztuje 19 słów kodowych, co mieści się w symbolu 20×20 z jego 22 słowami kodowymi danych. Jako UTF-8 dwie litery stają się czterema wysokimi bajtami, a wiersz kosztuje 23. Ze znacznikiem wychodzi 25. To już wymaga 22×22, a ten skok bierze się z samych bajtów UTF-8, bo 23 przepełnia 20×20. Szablon, który przybija SymbolSize na 9 (20×20), dostaje 0 i błąd 302 z DrawDataMatrixSymbol natychmiast po zmianie kodowania, a w slocie na kod nie trafia się nic
Automatyczny dobór rozmiaru potrafi zmienić kształt. Przy SymbolSize równym 0 PDFlibPas przechodzi listę rozmiarów ISO/IEC 16022 po kolei i bierze pierwszy wpis, którego pojemność danych pomieści strumień. Sześć rozmiarów prostokątnych siedzi na tej liście między kwadratami. Payload, który wypełniał symbol 26×26 (44 słowa kodowe danych), ze znacznikiem potrzebuje 46, a następny wpis mieszczący 46 to 16×48 z 49, przed 32×32 z 62. Przy 0,5 mm na moduł kwadrat 13 mm staje się paskiem 8 × 24 mm. Z pełnym 22×22 dzieje się to samo: 30 słów kodowych plus dwa ląduje w 16×36. Małe payloady zostają kwadratowe — trzy słowa kodowe, które wypełniały 10×10, rosną do pięciu i mieszczą się w 12×12, które wyprzedza 8×18 na liście. Jeśli etykieta rezerwuje kwadratowy slot, przybij SymbolSize do kwadratu, na który cię stać (16 dla 32×32), i pozwól błędowi 302 mówić ci, kiedy nazwa jest na niego za długa; dobór automatyczny pasuje do układów godzących oba kształty
PDF417 rośnie według innej reguły. Przy ErrorLevel równym -1 koder planuje korekcję błędów z zalecanych poziomów minimalnych ISO/IEC 15438, które skaczą przy 41, 161 i 321 słowach kodowych, licząc deskryptor długości. Strumień 39 słów kodowych ze znacznikiem robi się 41, poziom minimalny przesuwa się z 2 na 3, a blok korekcji błędów, na który koder planuje, rośnie z 8 do 16 słów kodowych. To dziesięć słów kodowych na zapas. Przy automatycznych kolumnach i wierszach koder rozkłada prostokąt z tej większej sumy, więc payload tuż pod progiem zyskuje więcej miejsca, niż sugerują jego dwa słowa kodowe znacznika
Które kodowanie daje mniejszy Data Matrix dla UTF-8?
Porównaj oba koszty bezpośrednio. Kodowanie ASCII pakuje parę cyfr w jedno słowo kodowe, a czysty ASCII po jednym na znak, ale każdy bajt powyżej 127 kosztuje dwa: Upper Shift (235) i bajt minus 127. Base 256 płaci raz za latch i pole długości — jedno słowo kodowe długości do 249 bajtów, dwa ponad to — a potem po jednym słowie kodowym na bajt, bez pakowania cyfr. Dla tekstu bez serii cyfr Base 256 wygrywa, jak tylko payload trzyma trzy wysokie bajty. Wiersz Müllera już je trzyma, przy 21 słowach kodowych wobec 23. Długie ciągi numeryczne odchylają wagę z powrotem ku ASCII, bo tam każda para cyfr oszczędza słowo kodowe. Pomocnik poniżej liczy oba koszty i rysuje tańszym trybem; czysty ASCII nie dostaje znacznika wcale, bo pod każdym zestawem znaków czyta się identycznie:
// Rysuje Data Matrix dla tekstu Unicode tańszym kodowaniem
function DrawUnicodeDataMatrix(Pdf: TPDFlib; Left, Top, ModuleSize: Double;
  const Text: WideString): Integer;
var
  Bytes: UTF8String;
  I, HighBytes, AsciiCost, Base256Cost, Mode: Integer;
  Saved: TPDFlibBarcodePayloadEncoding;
begin
  Bytes := UTF8Encode(Text);
  HighBytes := 0;
  AsciiCost := 0;
  I := 1;
  while I <= Length(Bytes) do
  begin
    if (I < Length(Bytes)) and (Bytes[I] >= '0') and (Bytes[I] <= '9') and
       (Bytes[I + 1] >= '0') and (Bytes[I + 1] <= '9') then
    begin
      Inc(AsciiCost);                    // para cyfr: jedno słowo kodowe
      Inc(I, 2);
      Continue;
    end;
    if Ord(Bytes[I]) > 127 then
    begin
      Inc(HighBytes);
      Inc(AsciiCost, 2);                 // Upper Shift + (bajt - 127)
    end
    else
      Inc(AsciiCost);
    Inc(I);
  end;
  if Length(Bytes) <= 249 then
    Base256Cost := Length(Bytes) + 2     // latch + jedno słowo kodowe długości
  else
    Base256Cost := Length(Bytes) + 3;    // latch + dwa słowa kodowe długości

  Saved := Pdf.BarcodePayloadEncoding;
  try
    if HighBytes = 0 then
    begin
      Pdf.BarcodePayloadEncoding := bpeSystemANSI;  // czysty ASCII: bez znacznika
      Mode := 1;
    end
    else
    begin
      Pdf.BarcodePayloadEncoding := bpeUTF8WithECI;
      if Base256Cost < AsciiCost then
        Mode := 3                        // Base 256
      else
        Mode := 1;                       // ASCII
    end;
    Result := Pdf.DrawDataMatrixSymbol(Left, Top, ModuleSize, Text, Mode, 0, 100);
  finally
    Pdf.BarcodePayloadEncoding := Saved;
  end;
end;
Dla 東京都千代田区 postać UTF-8 to 21 bajtów, wszystkie powyżej 127. Ze znacznikiem Base 256 potrzebuje 25 słów kodowych danych, a kodowanie ASCII 44, co według tabeli pojemności daje symbol 22×22 wobec 26×26 przy tym samym rozmiarze modułu. Tamto 26×26 jest wypełnione po brzegi. Jeszcze jedno słowo kodowe i skacze na 16×48. Payloady GS1 (tryb 7) zostają poza pomocnikiem, bo ich łańcuchy elementów to ASCII. Kody QR biorą swój tryb danych przez argument EncodeOptions funkcji DrawQRCode, a symbole Aztec rysowane przez PDFlibPas niosą flagę ECI 26 automatycznie, ilekroć bajty payloadu to poprawne UTF-8 z co najmniej jednym znakiem spoza ASCII
Dla wiersza Müllera znacznik kosztuje dwa słowa kodowe, a przeskok z 20×20 na 22×22 — z 10 mm na 11 mm przy modułach 0,5 mm — wynika z samych bajtów UTF-8. Jeśli slot twojej etykiety ma ten zapas milimetra, ustaw BarcodePayloadEncoding na bpeUTF8WithECI w instancji TPDFlib z biblioteki PDFlibPas Delphi PDF Library tuż przed narysowaniem symbolu odbiorcy i ustaw z powrotem bpeSystemANSI dla starych symboli na tej samej stronie