HotXLS, det native Excel-biblioteket for Delphi og C++Builder, parser XLSX-ark på flere tråder gjennom en lasteprosess i tre faser: ark-XML dekomprimeres serielt, parses parallelt, og de små delene leses serielt etterpå. Den første utgaven av denne funksjonen ga bare 12–25 % gevinst, fordi Delphis standard minnehåndterer låste og serialiserte arbeidertrådene. Ved å kutte heap-allokeringer fra omtrent 20 til 9,1 per celle økte den parallelle hastighetsgevinsten til ×1,90 på åtte tråder. Denne artikkelen går gjennom målingene, blindveiene og de to fiksene som faktisk fungerte
Hvordan parser HotXLS XLSX-ark parallelt?
HotXLS deler Open opp i tre faser, og det er bare den midterste som kjører på arbeidertråder. Årsaken er zip-beholderen: et zip-arkiv er én delt inndatastrøm med én inflate-tilstandsmaskin, og denne tilstandsmaskinen kan ikke leses av to tråder samtidig. Å pakke den inn i en lås ville vært bortkastet, fordi inflate i seg selv er serielt per oppføring, så en lås ville bare gjenskapt seriell kjøring med ekstra overhead. Fase A dekomprimerer derfor XML-en for hvert ark til sin egen TMemoryStream mens den fortsatt kjører enkelttrådet; i vår benchmark-fil tok dette omtrent 4 ms for åtte arkdeler, så det er langt fra flaskehalsen. Fase B kjører ParseWorksheetXml for hvert ark i en arbeiderpool, og det er her nesten hele lastetiden befinner seg. Fase C går tilbake til zip-en serielt for de små delene: kommentarer, tegninger, diagrammer og tabeller
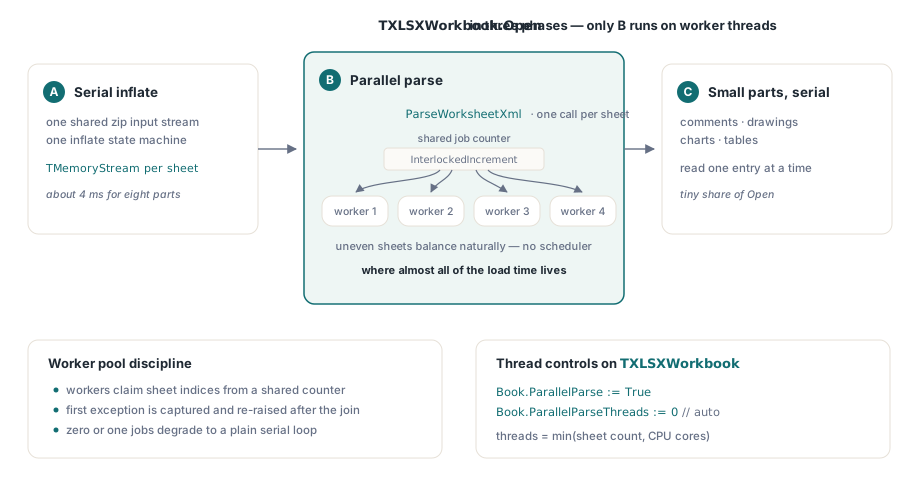
Selve arbeiderpoolen er bevisst enkel. Arbeiderne henter jobbindekser fra en delt teller med InterlockedIncrement, slik at ark av ujevn størrelse balanseres naturlig uten noen planlegger. Trådantallet er min(sheet count, CPU cores), det første unntaket fra en arbeider fanges med AcquireExceptionObject og gjenreises på hovedtråden etter sammenslåingen, og dispatcheren faller tilbake til en ren seriell løkke når det er null eller én jobb. To egenskaper på TXLSXWorkbook styrer funksjonen: ParallelParse slår poolen av og på, og ParallelParseThreads setter et tak på trådantallet, der 0 betyr automatisk. Arbeidsbøker med flere ark er formen som drar nytte av dette, inkludert den typen du får ved å duplisere et malark dusinvis av ganger
var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.ParallelParse := True;      // aktiver den parallelle arbeiderpoolen
    Book.ParallelParseThreads := 0;  // 0 = auto: min(ark, CPU-kjerner)
    if Book.Open('quarterly-ledger.xlsx') <= 0 then
      raise Exception.Create('open failed');
    // ... les celler som vanlig; arbeidsboken er fullstendig materialisert ...
  finally
    Book.Free;
  end;
end;
Hvorfor gjør flere tråder XLSX-parsing tregere i Delphi?
Fordi Delphis standard minnehåndterer beskytter heapen sin med en global lås, og arkparsing er allokeringstung: celler, Variants og WideStrings i millionvis. Hver arbeider som rører heapen, må stille seg i kø på denne låsen, så tråder som ser uavhengige ut i kildekoden, kjører i praksis nesten én om gangen. Vår første benchmark gjorde dette smertelig konkret. På en arbeidsbok med 8 ark, 5000 rader og 4 kolonner per ark, målt på en i5-11600K (6 kjerner, 12 tråder) under Win64, ble parallell Open bare 12–25 % raskere, mot et planlagt anslag på minst 40 %. En gjennomgang av trådantall på 2, 3, 4, 6 og 8 tråder ga en flat kurve, og i senere instrumenterte kjøringer var 2-tråders-konfigurasjonen faktisk 26 % tregere enn seriell kjøring — det klassiske kjennetegnet på to tråder som kaster en omstridt lås frem og tilbake
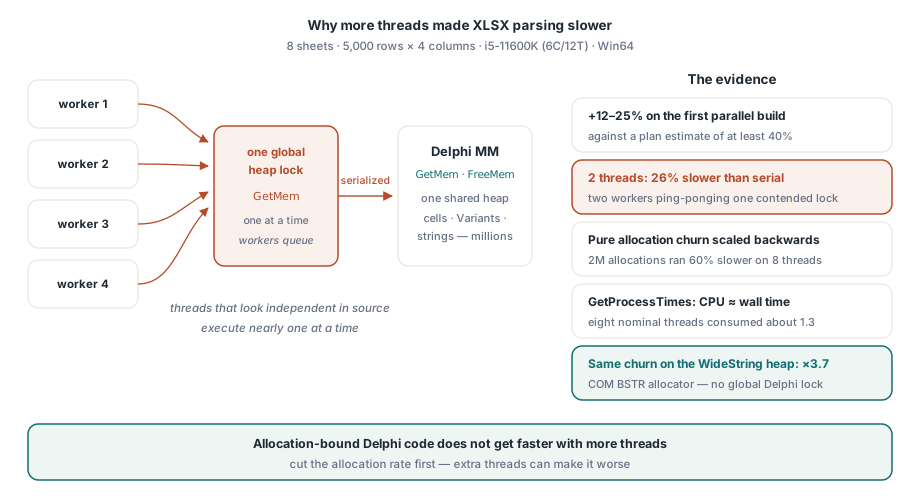
Tre målinger festet diagnosen, og hver av dem veltet den forrige intuisjonen. For det første ble en liten fil (8 ark med 1 rad) åpnet på 1,2 ms, noe som beviste at parsing utgjør nesten 100 % av Open, og at det ikke fantes noen skjult fast kostnad å skylde på. For det andre viste en mikrobenchmark av ren allokeringstrafikk at Delphis minnehåndterer skalerte baklengs: det samme totale volumet på 2 millioner objekt- og AnsiString-allokeringer kjørte 60 % tregere på 8 tråder enn på én, mens den samme trafikken mot WideString-heapen — som er COM-ens BSTR-allokator og ikke Delphis MM — skalerte til ×3,7. At HotXLS bruker WideString gjennomgående, viste seg å være en historisk tilfeldighet som spilte oss i hendene. For det tredje viste GetProcessTimes at CPU-tiden under en parallell Open omtrent tilsvarte klokketiden: åtte nominelle tråder brukte til sammen bare rundt 1,3 tråders CPU-verdi. Arbeiderne spant ikke rundt; de sov i minnehåndtererens konkurransesti, blokkert i stedet for opptatt
Den praktiske lærdommen gjelder langt utover regneark. Hvis en Delphi-arbeidslast allokerer mye, hjelper det ikke å øke trådantallet før allokeringsraten går ned, og det kan lett gjøre ting verre. Før denne fiksen fortalte vi brukere som justerte ParallelParseThreads, den ærlige sannheten: på allokeringsbundne filer ga flere tråder nesten ingenting
Hvor kommer 20 heap-allokeringer per celle fra?
En tellende wrapper installert med SetMemoryManager besvarte det spørsmålet presist: omtrent 20 Delphi-MM-allokeringer per celle, hvorav 2,87 millioner var på 32 byte eller mindre. Synderen var slett ikke celleobjektene. TXMLScaner.GetTokenValue materialiserte en fersk AnsiString ved hvert kall, og den kalles omtrent 15–20 ganger per celle: én gang hver for elementnavn, attributtnavn, attributtverdier og tekstinnhold. I tillegg produserte RTL-ens UTF8ToWideString-rute et midlertidig UnicodeString-mellomledd for hver konvertering. Celleobjekter sto for bare 160 tusen allokeringer, omtrent 8 % av totalen, noe som drepte den opprinnelige planen vår på stedet: vi hadde tenkt å bygge en pool for celleobjekter, og tallene sa at det aldri ville lønne seg
var
  OldMM, NewMM: TMemoryManagerEx;
  AllocCount, TinyCount: Int64;

function CountingGetMem(Size: NativeInt): Pointer;
begin
  AtomicIncrement(AllocCount);
  if Size <= 32 then
    AtomicIncrement(TinyCount);   // trafikken av små objekter vi bryr oss om
  Result := OldMM.GetMem(Size);
end;

// installer før Open, gjenopprett etterpå
GetMemoryManager(OldMM);
NewMM := OldMM;
NewMM.GetMem := CountingGetMem;
SetMemoryManager(NewMM);
Denne ti-minutters diagnosen er verdt å stjele til enhver Delphi-ytelsesundersøkelse. Å telle allokeringer etter størrelsesbøtte koster nesten ingenting å bygge, og den viser deg hvor presset på minnehåndtereren faktisk oppstår — i vårt tilfelle to RTL-vaner inne i XML-skanneren, snarere enn noe i objektmodellen. Profilere pekte hele tiden på parseren som helhet; wrapperen pekte på to konkrete linjer
Fiksen: token-interning og en UTF-8-dekoder uten mellomledd
To målrettede endringer i XML-leseren fjernet mer enn halvparten av allokeringene per celle uten å røre parserens struktur. Den første er interning av elementnavn. Ark-XML gjentar et lite vokabular i det uendelige: row, c, v, r, t, s, og en håndfull attributtnavn. InternTokenName holder en cache med 64 plasser for tidligere sette navn og sammenligner skannerens byggebuffer mot en cachet oppføring med TokenEqualsAnsi, en direkte bytesammenligning som ikke allokerer noe. Ved treff returnerer den den cachede AnsiString-en, og her spiller typevalget en rolle: AnsiString er referansetalt, så å returnere en cachet instans koster bare én økning av referansetellingen og null heap-trafikk. WideString har ingen referanseteling, og hver tilordning går gjennom SysAllocString, så interning av WideStrings ville ikke spart noe. Interning er bare verdt å gjøre på den referansetalte strengtypen
function TXMLScaner.InternTokenName: AnsiString;
var
  Slot: Integer;
begin
  Slot := TokenHash mod 64;
  if TokenEqualsAnsi(FInternNames[Slot]) then
    Result := FInternNames[Slot]    // bare refcount++, ingen allokering
  else
  begin
    Result := GetTokenValue;        // materialiser én gang, cache deretter
    FInternNames[Slot] := Result;
  end;
end;
Den andre endringen angriper celletekst. Den gamle stien bygde et AnsiString-token, overleverte det til UTF8ToWideString, som bygde et UnicodeString-mellomledd, som til slutt ble konvertert til WideString-en cellen lagrer: to Delphi-MM-allokeringer per tekst-token før den egentlige. Erstatningen, XmlUtf8ToWide(TokenPtr, TokenLen), er en to-pass ren Pascal UTF-8-dekoder som leser direkte fra skannebufferen: første pass måler UTF-16-lengden, andre pass dekoder inn i en WideString som allokeres én gang. Nettokostnad per tekst-token: én COM-allokering, null Delphi-MM-allokeringer. Et semantisk notat for de forsiktige: ved feilformede UTF-8-sekvenser lar den nye dekoderen bytene passere gjennom i stedet for å erstatte dem med erstatningstegn slik RTL-en gjør, noe som bare påvirker hvordan korrupte filer degraderer; på gyldig input er utdataene byte-identiske. XML-tegnentiteter når aldri dekoderen, fordi skanneren allerede har løst dem opp til UTF-8 i token-bufferen
Hva vant vi, og hvor parallell parsing fortsatt ikke hjelper
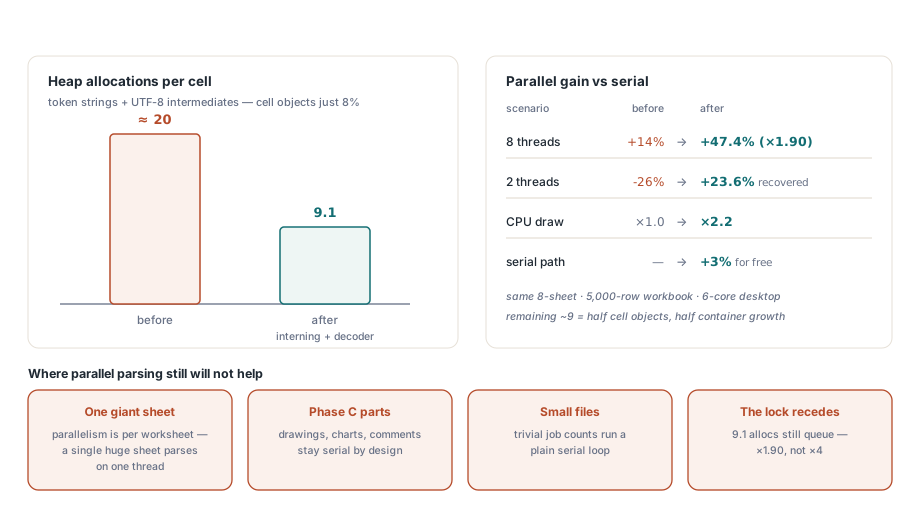
De to fiksene kuttet allokeringene per celle fra omtrent 20 til 9,1, og de parallelle tallene beveget seg slik teorien sa de skulle. På den samme benchmarken med 8 ark og 5000 rader, og på den samme 6C12T-maskinen, gikk 8-tråders-forbedringen fra 14 % til 47,4 %, en ×1,90 hastighetsgevinst over seriell kjøring. 2-tråders-tilfellet svingte fra 26 % tregere til 23,6 % raskere, og målt CPU-utnyttelse steg fra ×1,0 til ×2,2. Den serielle stien ble omtrent 3 % raskere som bonus, siden færre allokeringer også hjelper en enkelt tråd. De gjenværende ~9 allokeringene per celle er omtrent halvparten celleobjekter og halvparten amortisert containervekst; vi målte dem, vurderte at avkastningen var avtakende, og stoppet der, med MM-wrapperen klar til å samples på nytt per kallsted hvis en fremtidig arbeidslast rettferdiggjør en ny runde
Begrensningene er verdt å si like tydelig som gevinstene. HotXLS paralleliserer på arknivå, så en arbeidsbok som er ett kjempestort ark, parses på én tråd uansett hva ParallelParseThreads sier; for den formen er den strømmende direktelesaren det bedre verktøyet, siden den unngår å materialisere arbeidsboken i det hele tatt. Filer der tiden går med til Fase C-delene — tegninger, diagrammer og kommentarer — får mindre gevinst fordi den fasen forblir seriell med hensikt. Små filer er ikke verdt å tråde i det hele tatt, som er grunnen til at dispatcheren stille kjører seriell for trivielle jobbantall. Og taket satt av minnehåndtereren har ikke forsvunnet, bare trukket seg tilbake: ved 9,1 allokeringer per celle belaster den globale låsen fortsatt arbeiderne, som er grunnen til at åtte tråder gir ×1,90 og ikke ×4. For det bredere verktøysettet for å kutte last- og lagringstider, inkludert stiler, pooler og bulk-radtilbakekall, se vår guide til ytelse for store arbeidsbøker i Delphi
Parallell XLSX-parsing, egenskapene ParallelParse og ParallelParseThreads, og den allokeringsslanke XML-leseren som er beskrevet her, følger med som standarddeler av HotXLS Delphi Excel Component, som leser og skriver XLS, XLSX og ODS nativt fra Delphi og C++Builder uten noen Excel-automatisering involvert