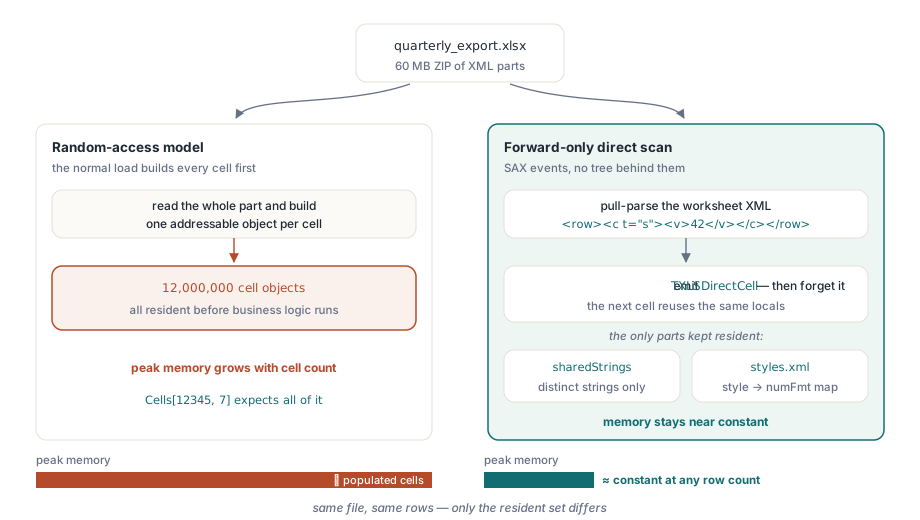
Et regneark med en million rader og et titalls kolonner er en helt ordinær eksport fra en databaserapporteringsjobb. Åpner du det på vanlig måte, ved å laste hele arbeidsboken inn i en TXLSWorkbook, må prosessen materialisere hver eneste av de tolv millioner cellene som et levende objekt før den første linjen forretningslogikk kjører. Filen på disk kan være seksti megabyte komprimert XML. Objekttreet den utvides til er flere ganger så stort, og alt sammen må være til stede samtidig fordi modellen er tilfeldig-tilgang etter design. For en rapport du har tenkt å lese fra topp til bunn og deretter kaste, er det svært mye minne brukt på en struktur du aldri trengte
Det finnes en annen vei gjennom den samme filen. I stedet for å bygge en modell, skanner du ark-XML-en bare fremover, én celle om gangen, og lar hver celle flyte forbi etter at du har sett på den. Ingenting hoper seg opp. Minnebruken holder seg nesten konstant enten arket har tusen rader eller ti millioner, fordi leseren aldri holder på mer enn den delen den for øyeblikket parser, pluss et par små oppslagstabeller. Dette er det HotXLS-direktelesaren gjør, og resten av denne artikkelen handler om hvorfor den forblir liten og hva den gir deg til gjengjeld
Hvorfor modellen i minnet ikke skalerer
En XLSX-fil er en ZIP-pakke med XML-deler beskrevet av ECMA-376. Hvert regneark er sin egen del, xl/worksheets/sheetN.xml, og inne i den er hver rad et <row>-element som inneholder <c>-celleelementer. Den vanlige lastestien leser den delen og konstruerer et adresserbart objekt for hver celle, slik at du senere kan spørre etter Cells[12345, 7] og få et svar i konstant tid. Tilfeldig tilgang er hele poenget med en arbeidsbokmodell, og det er nettopp det som gjør redigering, formelevaluering og stilsetting praktisk
Kostnaden er at tilfeldig tilgang krever at alt er til stede samtidig. Du kan ikke indeksere inn i en struktur du bare har bygget delvis. Så toppminnebruken ved en full innlasting er en funksjon av celleantallet, og på et ark med millioner av utfylte celler havner den funksjonen et sted tjenesten din ikke ønsker å være, særlig hvis flere slike jobber kjører samtidig på en delt maskin. Når tilgangsmønsteret du faktisk trenger er sekvensielt, betaler du for tilfeldig tilgang — en evne du ikke kommer til å bruke
En fremoverrettet SAX-skanning som ikke bygger noe tre
Direktelesaren åpner ZIP-pakken og går gjennom hver arkdel med en pull-parser i SAX-stil. SAX betyr her at parseren rapporterer parse-hendelser etter hvert som den støter på dem — et startelement, en tekstforekomst, et sluttelement — og går så videre. Den beholder ikke noe nodetre etter seg. Leseren sporer gjeldende rad og kolonne fra r-attributtene, samler cellens type, stilindeks, verdi og formeltekst etter hvert som hendelsene kommer inn, og når den avsluttende </c>-taggen sees, sender den ut én celle og glemmer den. Neste celle gjenbruker den samme håndfullen av lokale variabler
Fordi ingenting beholdes mellom cellene, vokser ikke minnebruken med antall celler. Det er egenskapen som er verdt å holde fast ved. Et ark med to hundre rader og et ark med tjue millioner rader koster leseren den samme mengden resident minne, og forskjellen mellom dem er bare hvor lenge skanningen varer. Du gir avkall på tilfeldig tilgang, modellens fremste egenskap, og til gjengjeld får du et minnetak som celleantallet ikke kan presse gjennom
Hva som forblir resident, og hvorfor akkurat disse to delene
Skanningen er ikke helt tilstandsløs, og unntakene er lærerike. To små tabeller må holdes i minnet gjennom hele skanningen, fordi en celle alene ikke bærer nok informasjon til å tolkes uten dem
Den første er den delte strengtabellen. I SpreadsheetML lagrer ikke en tekstcelle sin egen tekst. Den bærer t="s" og en numerisk verdi som er en indeks inn i xl/sharedStrings.xml, en enkelt deduplisert liste over hver distinkte streng i arbeidsboken. Dette er et godt plassbytte for filer der de samme etikettene gjentas over tusenvis av rader, men det betyr at leseren må laste den strengtabellen på forhånd og holde den resident, fordi enhver celle hvor som helst i ethvert ark kan referere til hvilken som helst oppføring i den. Tabellen har en størrelse bestemt av antall distinkte strenger, ikke av celleantallet, så den forblir beskjeden selv på enorme ark
Den andre er tallformat-mappingen fra stildelen. En numerisk celle og en datocelle er byte for byte identiske på tråden: begge er et rent tall, fordi en dato i SpreadsheetML bare er et serielt dagantall. Det eneste som skiller dem er cellens stil, som peker via cellXfs i xl/styles.xml til en tallformat-id. For å rapportere en dato som en dato i stedet for det rå serielle tallet, laster leseren den stil-til-format-tabellen og holder den resident. Alt annet i filen, altså selve celledataene som utgjør hoveddelen av bytene, strømmer forbi uten å bli lagret
Hver celle rapporterer en type og en verdi
Hver celle som sendes ut, ankommer som en TXLSDirectCell-post. Den bærer arkindeksen og -navnet, den 1-baserte raden og kolonnen, en semantisk Kind, Value som en Variant, Formula-teksten uten det innledende likhetstegnet, og den rå StyleIndex. Typen er én av xdkNumber, xdkString, xdkBoolean, xdkDate eller xdkError, slik at du kan forgrene basert på hva cellen betyr, i stedet for å utlede det på nytt fra attributter. En formelcelle rapporterer typen til sitt bufrede resultat, med formelteksten ved siden av, slik at en beregnet sum kommer gjennom som et tall som også forteller deg hvordan det ble produsert
type
  TReportScan = class
    procedure OnCell(Sender: TObject; const Cell: TXLSDirectCell;
      var Abort: Boolean);
  end;

procedure TReportScan.OnCell(Sender: TObject; const Cell: TXLSDirectCell;
  var Abort: Boolean);
begin
  case Cell.Kind of
    xdkString:  AccumulateLabel(Cell.Row, Cell.Col, VarToStr(Cell.Value));
    xdkNumber:  AddToTotals(Cell.Col, Double(Cell.Value));
    xdkDate:    NoteWhen(Cell.Row, VarToDateTime(Cell.Value));
    xdkBoolean: FlagRow(Cell.Row, Boolean(Cell.Value));
    xdkError:   LogBadCell(Cell.Row, Cell.Col, VarToStr(Cell.Value));
  end;
end;
Å skille en dato fra et tall
Datospørsmålet fortjener et nærmere blikk, fordi det er der de fleste naive skannere går galt. Det finnes ingen datotype for en numerisk celle. En celle som holder den serielle verdien 46000, kan være en mengde, en pris, eller den 17. februar 2025, og filen forteller deg hvilket bare gjennom tallformat-ID-en nådd via cellens stil. ECMA-376 reserverer en blokk med innebygde format-ID-er hvis betydning er fast på tvers av alle samsvarende produsenter, og de datobærende ID-ene ligger i to intervaller: 14 til 22 for standard dato- og klokkeslettformater, og 45 til 47 for forløpt-tid-formatene, slik som [h]:mm:ss. Når DetectDates er på, som den er som standard, løser leseren hver numeriske celles stil til dens format-ID, og en celle hvis ID faller i disse reserverte intervallene, rapporteres som xdkDate med Value allerede konvertert til en Delphi TDateTime. Egendefinerte formater sjekkes også, ved å inspisere formatkoden for dato- og klokkeslett-tokens, men de reserverte intervallene er den pålitelige ryggraden. Slår du av DetectDates, blir ikke engang stiltabellen lastet, hver numeriske celle kommer gjennom som xdkNumber, og skanningen blir marginalt slankere
Hopp over ark og avbryt tidlig
Sekvensiell skanning har en stillferdig fordel som tilfeldig tilgang ikke kan matche: du kan stoppe. OnSheet-hendelsen utløses før hvert regneark åpnes, og den gir deg to brytere. Setter du SkipSheet, blir hele den delen aldri parset, og det er slik du skanner bare de arkene du bryr deg om i en arbeidsbok med flere ark, uten å betale for å lese resten. Setter du Abort, avsluttes hele skanningen umiddelbart. OnCell-hendelsen bærer sin egen Abort, slik at du kan stoppe i det øyeblikket du har funnet det du lette etter — en bestemt rad, en vaktverdi, slutten av en topptekstblokk — uten å lese de gjenværende millioner cellene. På en fremoverrettet skanning er avbrytelse reelt gratis, fordi arbeidet du hopper over, er arbeid som ennå ikke hadde skjedd
procedure TReportScan.OnSheet(Sender: TObject; SheetIndex: Integer;
  const SheetName: WideString; var SkipSheet: Boolean; var Abort: Boolean);
begin
  // Skann bare "Data"-arket; la resten være ulest
  SkipSheet := SheetName <> 'Data';
end;
Å telle celler uten en handler
Én nylig forbedring er verdt å trekke frem, fordi den gjør et vanlig spørsmål om til ett enkelt, billig kall. Leseren teller hver utfylte celle den passerer, og den gjør dette uansett om en OnCell-handler er tilknyttet eller ikke. Tidligere, uten noen handler satt, kom det utfylte celleantallet tilbake som null, siden tellingen var en bieffekt av utsendingen. Nå er tellingen uavhengig av utsendingen. Det betyr at du kan stille ett spørsmål — hvor mange utfylte celler inneholder egentlig denne arbeidsboken — og få svaret for prisen av én skanning uten noen callbacks i det hele tatt. Både ReadFile og ReadStream returnerer den summen som en Int64, og det samme tallet er etterpå tilgjengelig som egenskapen CellCount. En returverdi på -1 signaliserer at filen ikke kunne åpnes eller ikke er en OOXML-pakke

var
  Reader: TXLSDirectReader;
  Populated: Int64;
begin
  Reader := TXLSDirectReader.Create;
  try
    // Ingen OnCell-handler: en ren opptelling av utfylte celler, fortsatt nesten konstant minnebruk
    Populated := Reader.ReadFile('quarterly_export.xlsx');
    if Populated < 0 then
      raise Exception.Create('Not a readable XLSX package')
    else
      Writeln(Format('%d populated cells (CellCount = %d)',
        [Populated, Reader.CellCount]));
  finally
    Reader.Free;
  end;
end;
For den fullstendige skanningen tilknytter du handleren og kaller ReadFile på nøyaktig samme måte. Kontrasten til en full innlasting er selve poenget: der det å laste quarterly_export.xlsx inn i en arbeidsbok ville utvidet hver celle til et resident objekt og holdt på alt sammen, beholder direktelesaren bare de delte strengene og stiltabellen mens de tolv millioner cellene flyter gjennom OnCell din, én om gangen. Regnestykket som kjørte per celle etterlater seg ingenting, så toppminnebruken bestemmes av arbeidsbokens antall distinkte strenger, ikke av radantallet
Direktelesaren er det riktige verktøyet når jobben er å lese en stor arbeidsbok én gang og trekke ut eller oppsummere den. Når du i stedet trenger den fulle modellens tilfeldige tilgang, men vil at den skal oppføre seg pent på store filer, dekker justeringene i våre notater om ytelse for store arbeidsbøker i Delphi den veien. Og når retningen er motsatt — å produsere store mengder utdata i stedet for å konsumere dem — bruker gjennomgangen av strømmende skriving for batch-jobber på server den samme konstant-minne-disiplinen på skriving. Alle tre følger med som en del av HotXLS Delphi Component for Delphi og C++Builder, sammen med API-ene for lesing, skriving, formler og formatering som er dekket andre steder på denne bloggen
