Een tabel die over drie pagina's van een Word-export loopt, komt nooit dichter dan 72 punten bij de onderrand van het papier. Eén-inch-marges zijn 72 punten, en de tekstverwerker stopt met het plaatsen van rijen bij de marge. Een linker die fragmenten alleen samenvoegt wanneer ze binnen 36 punten van de paginaranden zitten, ziet drie ongerelateerde tabellen met identieke kolommen. De vraag die wél werkt is anders: staat er iets anders dan een doorlopende header of footer tussen het einde van het ene fragment en het begin van het volgende?
Die vraag brengt twee eigen valkuilen mee. Een formulier kan de ene tabel onderaan pagina 1 laten eindigen en bovenaan pagina 2 een andere tabel openen met dezelfde kolombreedten. En een lijnengrid kan één enkele rij over de breuk duwen, te kort voor een detector die twee rijen wil zien voordat hij iets een tabel noemt
Twee randtests in ExtractDocumentTables
PDFium Component markeert continuaties in TPdf.ExtractDocumentTables, de documentniveau-tegenhanger van de per-pagina-ExtractTables uit het artikel over tabel-detectie en -extractie. Met DetectContinuations aan, zoals in TPdfTableExtractionOptions.Default, extraheert de methode elke pagina, sorteert de tabellen op paginanummer en dan van boven naar beneden binnen elke pagina, en checkt elk paar buren in die lijst. Alleen buren worden vergeleken. Een continuatiekandidaat is daarom altijd de onderste tabel op pagina N gekoppeld aan de bovenste tabel op pagina N+1, en een kleine tabel die onder een lange op pagina N staat, neemt de plek van de lange in dat paar in. Wanneer er een kort notitietabelje onder een lange staat, link die fragmenten dan in je eigen code via paginanummers en ColumnCount
De eerste test is puur geometrisch. De onderrand van het eerdere fragment moet binnen ContinuationMargin punten van de pagina-onderkant liggen, en de bovenrand van het latere fragment binnen dezelfde afstand van de bovenkant van de volgende pagina. De default is 36 punten, een halve inch. Rapporten uit layout-engines die een vaste contentbox vullen, passeren die moeiteloos. Een Word-export met één-inch-marges mist aan elke kant ten minste 36 punten, en de marge oprekken tot de test slaagt gaat mis, want hetzelfde getal stelt ook de header- en footerbanden van de tweede test in
Die tweede test, de inhoudsbewuste, is wat tekstverwerker-output aan kan. De twee combineren met OR: één van beide opent de poort
Wat geldt als tekst tussen twee fragmenten?
Elk woord op een pagina geldt als bodytekst tenzij hij volledig binnen de doorlopende headerband of de footerband ligt, en beide banden zijn ContinuationMargin punten diep. Per pagina registreert ExtractDocumentTables de laagste onderrand onder de woorden waarvan de top boven de footerband ligt en de hoogste bovenrand onder de woorden waarvan de onderkant onder de headerband ligt, de eigen celtekst van de tabel incluis. Als de tabel de laatste bodycontent op pagina N is, ligt zijn onderrand op of onder het laagste woord, en de test slaagt binnen AlignmentTolerance, dat default op 3 punten staat. Het latere fragment moet de gespiegelde voorwaarde bovenaan pagina N+1 halen
De banden negeren heeft een voet in de specificatie. ISO 32000-1 §14.8.2.2 behandelt doorlopende koppen, voeten en paginanummers als pagination-artifacts, content die alleen bestaat omdat het document in pagina's is gesneden. Een getagd bestand kan ze declareren met /Artifact, zoals het artikel over marked content uitlegt, maar de exports die tafelstitching het hardst nodig hebben dragen zelden tags, dus de positie staat in voor de tag. Met de default band wordt een paginanummer waarvan de glyphs 30 punten boven de onderrand uitkomen genegeerd Een disclaimerregel die tot 40 punten reikt is bodytekst, en hij blokkeert de koppeling
Op een pagina zonder tekstlaag vallen de opgeslagen extremen terug op de paginagrenzen, de inhoudsbewuste test slaagt dan vanzelf, en de overige poorten beslissen. Footers die als afbeeldingen of vectoromlijningen zijn getekend zijn om dezelfde reden onzichtbaar en blokkeren nooit een koppeling
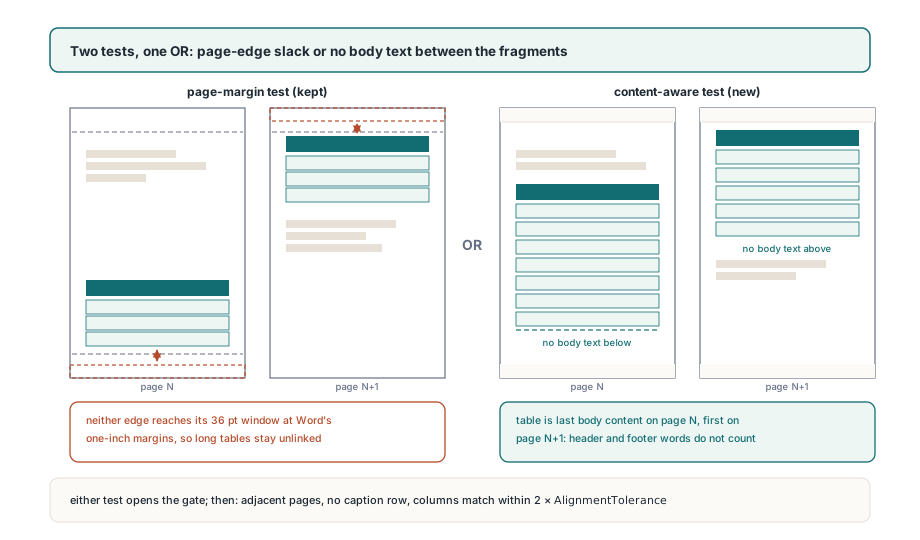
Een randtest halen opent alleen de poort. De pagina's moeten opeenvolgend zijn, het latere fragment mag niet openen met een caption-rij, en de kolomgrenzen moeten binnen tweemaal AlignmentTolerance uitlijnen, 6 punten bij de defaults. Als dat alles klopt, wordt het eerdere fragment ptcStart met een vers groepnummer, of schuift hij van ptcEnd naar ptcMiddle als hij al een keten sloot, en het latere fragment wordt ptcEnd in dezelfde groep. Een tabel over drie pagina's leest start, middle, end. Groepnummers beginnen bij 1; groep 0 met ptcNone betekent dat de tabel alleen staat. ToJson schrijft dezelfde data als "continuationGroup" en "continuation" (none, start, middle of end), dus een service die JSON ontvangt kan zelf stitchen
De listing hieronder gaat uit van een Word-export met een voet van twee regels van zo'n 50 punten diep, dus de marge gaat naar 54 om beide regels binnen de band te houden
uses
  System.SysUtils, PDFium;

var
  Pdf: TPdf;
  Options: TPdfTableExtractionOptions;
  Tables: TPdfTables;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'itinerary-from-word.pdf';
    Pdf.LoadDocument;

    Options := TPdfTableExtractionOptions.Default;  // DetectContinuations = True
    Options.ContinuationMargin := 54;               // footer verondersteld ~50 pt diep

    Tables := Pdf.ExtractDocumentTables(Options);
    for I := 0 to High(Tables) do
      case Tables[I].Continuation of
        ptcStart:
          Writeln(Format('group %d starts on page %d, %d rows',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
        ptcMiddle, ptcEnd:
          Writeln(Format('group %d continues on page %d, %d rows',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
      else
        Writeln(Format('standalone table on page %d, %d x %d',
          [Tables[I].PageNumber, Tables[I].RowCount,
           Tables[I].ColumnCount]));
      end;
  finally
    Pdf.Free;
  end;
end.
Hoe een volle breedte eerste rij twee tabellen uit elkaar houdt
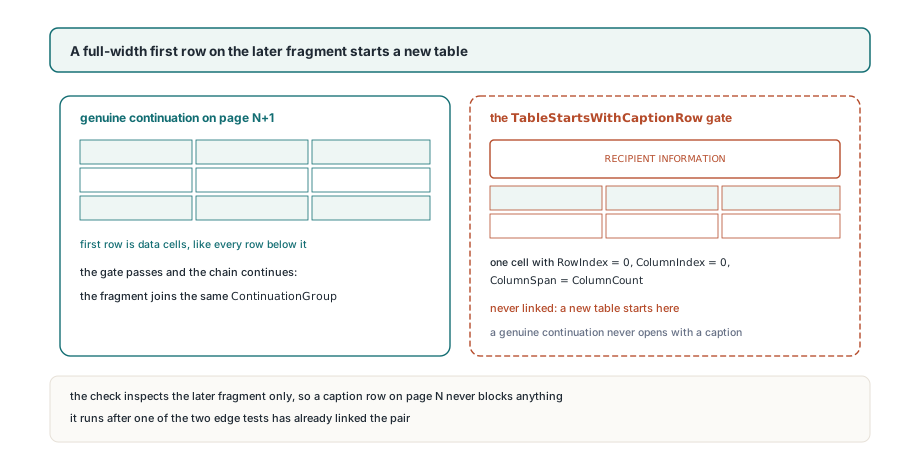
Een later fragment waarvan de eerste rij één cel is die alle kolommen beslaat, wordt als nieuwe tabel gemeld, ook wanneer een randtest slaagt en de kolommen matchen. Formulieren zijn waar de inhoudsbewuste test te ver zou doorschieten: de ene tabel eindigt onderaan pagina 1, de volgende sectie opent bovenaan pagina 2 met identieke kolombreedten, en elke geometrische check slaagt. Het verschil zit in de openingsrij van de tweede tabel, een sectiecaption zoals RECIPIENT INFORMATION als één samengevoegde cel over de volle breedte. Een echte continuatie opent niet zo, want de caption van een tabel blijft op de pagina waar de tabel begint
De regel leest alleen de cellen van het latere fragment. Dat fragment heeft ten minste twee kolommen nodig en een cel met RowIndex = 0, ColumnIndex = 0 en ColumnSpan = ColumnCount. Het eerdere fragment wordt nooit bekeken, dus een tabel waarvan de eigen caption bovenaan pagina N staat, linkt normaal naar zijn continuatie op pagina N+1
De kolomvergelijking die daarna volgt is strenger dan een gelijk aantal kolommen. De grensposities van elk fragment worden herbouwd uit zijn celrechthoeken; een grens die onder een samengevoegde cel verborgen zit, wordt aangevuld door hem gelijkmatig te verdelen tussen de dichtstbijzijnde bekende grenzen aan weerszijden. Daarna wordt elk grenspaar vergeleken, en een verschil boven 6 punten verwerpt de koppeling. Twee tabellen met vier kolommen en andere verhoudingen blijven uit elkaar. Ook een echte continuatie waarvan de generator een kolom met 8 punten tussen pagina's verschoof; AlignmentTolerance verhogen om die te accepteren, maakt ook de clustering die tijdens detectie wordt gebruikt losser
Eén gelijnde rij over een paginabreuk
Een lijnengrid dat één enkele rij op de volgende pagina duwt, houdt die rij wanneer hij in een keten linkt en verliest hem wanneer dat niet zo is. De default MinRows van 2 voorkomt dat twee verdwaalde lijnen als tabel worden gemeld. Een rij die over de breuk is geduwd is anders: het is echte data, en hem laten vallen laat de gestitchte tabel één rij te kort achter zonder fragment dat het gat verklaart
De documentscan handelt dat in drie stappen af. Als DetectContinuations en DetectRuledTables allebei aan staan, draait de ruled-detector op elke pagina met zijn rijvloer verlaagd naar 1. Daarna worden continuaties over het hele resultaat gemarkeerd. Ten slotte wordt elke tabel met minder rijen dan de MinRows van de aanroeper die niet in een keten belandde, verwijderd. Een één-rij-grid midden op een gewone pagina gaat door dat filter en verdwijnt, wat precies de bedoeling van MinRows is
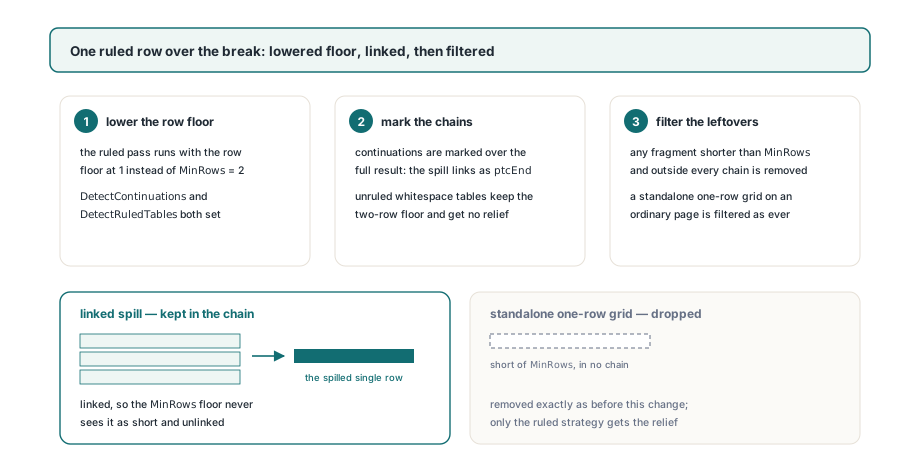
Laat MinRows op 2 staan. Hem zelf op 1 zetten zet het eindfilter uit, en elk één-rij-lijnengrid op elke pagina komt terug
De uitzondering geldt alleen voor lijnengrids. De whitespace-strategie heeft ten minste twee uitgelijnde rijen nodig om een tabel te herkennen, dus hij houdt een interne vloer van 2 aan ongeacht wat MinRows zegt; ExtractTables accepteert MinRows = 1, maar alleen ruled-detectie honoreert hem. Voor een ongelijnde tabel die één rij overstuurt, geven de word-boxes van de pagina of de blocks uit structured text blocks en leesvolgorde je de posities om die rij zelf terug te halen
Een keten terugstitchen tot één tabel
Ketens komen aaneengesloten terug. Links worden alleen gelegd tussen buren in de gesorteerde array, dus een ptcStart-fragment wordt direct gevolgd door zijn ptcMiddle- en ptcEnd-fragmenten, en een lus die op ptcNone of ptcStart reset en op ptcNone of ptcEnd uitschrijft, hoeft nooit iets op groepnummer op te zoeken
De herhaalde headerrij is het lastige deel: Word kan hem op elke pagina herhalen, andere generators doen dat niet. De IsHeader-flag op TPdfTableCell kan dat niet beslechten, want hij wordt per positie toegekend, RowIndex < HeaderRowCount, afzonderlijk per fragment. Rij 0 van een continuatie wordt als header gemarkeerd of hij nu de header herhaalt of data draagt, en de één-rij-spill uit de vorige sectie ook. De routine hieronder vergelijkt de tekst van de eerste rij van elke continuatie met de eerste rij van de keten en gooit hem alleen weg bij exacte match
Hij bouwt rijen ook uit Cells in plaats van de ToCsv-uitvoer in regels te splitsen. Een cel waarvan de tekst in de cel afbreekt, komt terug met een CR LF tussen zijn visuele regels, ToCsv houdt die breuk binnen het gequote veld, en de eerste regel van de CSV-tekst wissen zou een twee-regelige headercel halverwege hakken
// Helpers aan de lezerkant (geen onderdeel van de bibliotheek): herbouw elke keten
// als één tab-gescheiden bestand, met op latere pagina's herhaalde headers weg
function RowText(const T: TPdfTable; Row: Integer): string;
var
  Parts: array of string;
  I: Integer;
begin
  SetLength(Parts, T.ColumnCount);
  for I := 0 to High(T.Cells) do
    if (T.Cells[I].RowIndex = Row) and (T.Cells[I].ColumnIndex >= 0) and
       (T.Cells[I].ColumnIndex < T.ColumnCount) then
      Parts[T.Cells[I].ColumnIndex] :=
        StringReplace(string(T.Cells[I].Text), #13#10, ' ', [rfReplaceAll]);
  Result := '';
  for I := 0 to High(Parts) do
  begin
    if I > 0 then
      Result := Result + #9;
    Result := Result + Parts[I];
  end;
end;

procedure ExportChains(const Tables: TPdfTables; const Folder: string);
var
  I, R, FirstRow: Integer;
  Header: string;
  Lines: TStringList;
begin
  Lines := TStringList.Create;
  try
    for I := 0 to High(Tables) do
    begin
      FirstRow := 0;
      if Tables[I].Continuation in [ptcNone, ptcStart] then
      begin
        Lines.Clear;
        Header := RowText(Tables[I], 0);
      end
      else if (Trim(Header) <> '') and (RowText(Tables[I], 0) = Header) then
        FirstRow := 1;                     // header herhaald op deze pagina
      for R := FirstRow to Tables[I].RowCount - 1 do
        Lines.Add(RowText(Tables[I], R));
      if Tables[I].Continuation in [ptcNone, ptcEnd] then
        Lines.SaveToFile(Format('%s\table%d-page%d.tsv',
          [Folder, I, Tables[I].PageNumber]));
    end;
  finally
    Lines.Free;
  end;
end;
Exacte vergelijking is de juiste keuze. Een header die de tekstverwerker herhaalt, matcht teken voor teken, terwijl een fuzzy match vroeg of laat een datarij zou inslikken die op de header lijkt. Een verdwaalde extra header is makkelijk te vinden in de uitvoer; een ontbrekende datarij niet
De footerband meten in plaats van gokken
ContinuationMargin doet drie klussen met één getal: paginarandspeelruimte voor de eerste test, footerband-diepte en headerband-diepte voor de tweede. Een footer dieper dan de band laat zijn bovenste regel in de bodyzone achter, het eerdere fragment lijkt alsof er tekst op volgt, en de keten breekt op die pagina. Een band die te diep is ingesteld begint echte content in te slikken: een korte afsluitregel net boven de ondermarge valt erin, en de tabel boven die regel kan dan linken naar wat de volgende pagina maar opent
Het document zelf kan het getal aanleveren. TPdf.PageWordBoxes geeft elk woord op de huidige pagina terug met een pagina-ruimte Rect waarvan Top groter is dan Bottom, dus de hoogste Top onder de woorden die onder de bodymarge liggen, is de footerdiepte. De sonde hieronder neemt een waarde net onder de ondermarge van de layout, 70 voor een één-inch-pagina, en houdt 36 punten als vloer voor documenten zonder footer
// Helper aan de lezerkant (geen onderdeel van de bibliotheek): de hoogste word-top
// gevonden onder BodyMargin op een pagina, dus de diepte van de footer-zone
function MeasureFooterDepth(Pdf: TPdf; BodyMargin: Double): Double;
var
  P, I: Integer;
  Words: TPdfWordBoxes;
begin
  Result := 0;
  for P := 1 to Pdf.PageCount do
  begin
    Pdf.PageNumber := P;
    Words := Pdf.PageWordBoxes;
    for I := 0 to High(Words) do
      if (Words[I].Rect.Bottom < BodyMargin) and
         (Words[I].Rect.Top > Result) then
        Result := Words[I].Rect.Top;
  end;
end;

// gebruikt System.Math voor Max
Options := TPdfTableExtractionOptions.Default;
Options.ContinuationMargin := Max(36.0, MeasureFooterDepth(Pdf, 70) + 2);
Tables := Pdf.ExtractDocumentTables(Options);
De band is aan beide randen even diep, dus meet ook een diepe doorlopende header tegen de pagina-bovenkant en gebruik het grootste van de twee. Houd de speelruimte op een paar punten; elk extra punt is een punt bodytekst die de inhoudsbewuste test niet meer ziet
Eén layout verslaat de caption-regel uit overweging: een generator die een samengevoegde "continued"-banner als eerste rij van elk continuatiefragment wegschrijft. Elk zo'n fragment wordt als nieuwe tabel gemeld, dus link ze in je eigen code via opeenvolgende paginanummers, gelijke ColumnCount en de bannertekst in rij 0
Continuatiemarkering, de caption-regel en de één-rij-uitzondering draaien allemaal binnen ExtractDocumentTables, dat zich in de Delphi-, C++Builder- en Lazarus-builds hetzelfde gedraagt. De volledige set tabel-extractie-opties staat op de pagina van PDFium Component for Delphi