Een tweekoloms conferentieartikel dat op verticale positie wordt gesorteerd komt terug met een eerste regel als Abstract We measure the 2 Related work Earlier studies: de openingswoorden van de linkerkolom en de openingswoorden van de rechterkolom, aan elkaar geplakt omdat allebei op dezelfde baseline staan. Er ging niets mis in de parser. Een PDF-pagina biedt twee verdedigbare volgordes voor zijn tekst, de volgorde waarin de content stream hem tekent en de positie van elke glyph op de pagina, en voor veel layouts staan die twee volgordes op gespannen voet. Een extractor die gepositioneerde blokken teruggeeft in plaats van één string laat u zien welke volgorde u kreeg en laat u omschakelen wanneer het de verkeerde is voor de pagina die voor u ligt
Wat GetStructuredText teruggeeft
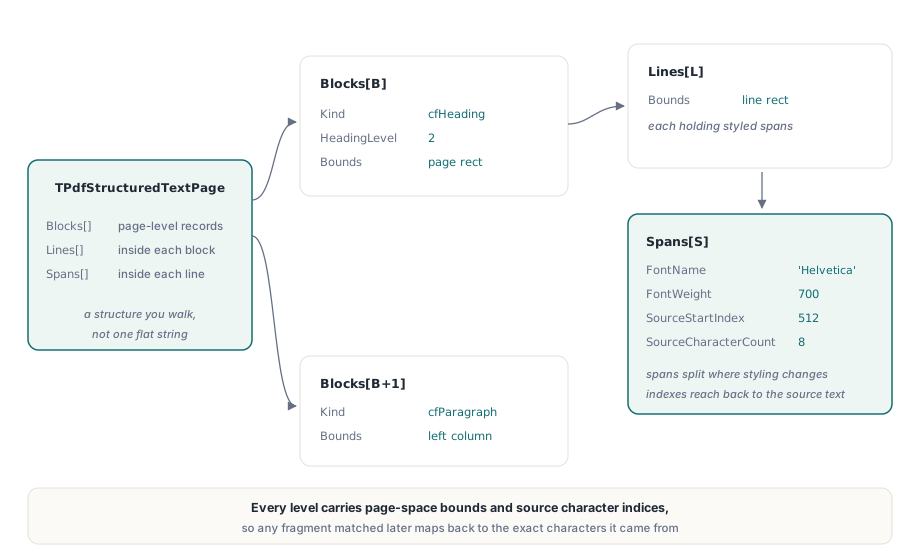
TPdf.GetStructuredText in PDFium Component geeft een TPdfStructuredTextPage terug voor de huidige pagina: een array van blokken, elk blok een array van regels, elke regel een array van gestileerde spans. Elk niveau draagt zijn eigen Text en een pagina-ruimte Bounds-rechthoek in PDF-punten mee, dus een kop, één regel of een vette zin kan op de pagina worden gelokaliseerd zonder tweede opzoeking. Het paginarecord voegt Width, Height, CharacterCount en twee kwaliteittellers toe die verderop worden beschreven
De afgeplatte Page.Text wordt uit de blokken opgebouwd in plaats van uit de kale karakterstroom. Regels binnen een blok worden met één CRLF samengevoegd en blokken worden gescheiden door een lege regel, wat betekent dat een platte-tekst-dump van Page.Text al laat zien waar de extractor zijn blokgrenzen trok. Dat maakt hem het snelste om af te drukken wanneer een pagina vreemd leest
Al dit wordt aangedreven door een klein optiesrecord. TPdfStructuredTextOptions.Default zet ReadingOrder op roPhysicalLayout, zet IncludeFontInfo en IncludeSemantics aan en stelt MaxCharacters in op 1.000.000. Het veld ReadingOrder is degene die de vorm van de uitvoer het meest verandert
Hoe de twee leesvolgordes regels en blokken opbouwen
roContentOrder houdt de tekenvolgorde van de producent aan, terwijl roPhysicalLayout de volgorde herbouwt uit glyphposities, en het verschil toont zich eerst in hoe regels worden gevormd. In contentvolgorde worden karakters genomen in de volgorde waarin de pagina ze tekent. Een nieuwe regel begint bij een expliciet regeleinde of wanneer het volgende karakter niet langer verticaal overlapt met de huidige regel. Een regel voegt zich dan alleen bij het blok erdirect voor als de twee horizontaal met minstens een vijfde van de smalste breedte overlappen en de verticale afstand niet meer is dan ongeveer twee en een kwart regelhoogten; anders opent hij een nieuw blok. Blokken blijven in tekenvolgorde
Physical layout gooit de tekenvolgorde weg. Elk karakter met een bekende doos wordt gesorteerd op het verticale midden van die doos, bovenkant van de pagina eerst, daarna op zijn linkerrand. Karakters waarvan de verticale omvang genoeg overlappen delen een regel, en die test kijkt alleen naar hoogte. Horizontale afstand speelt er geen rol in. Elke regel voegt zich dan bij welk bestaand blok op de pagina hem ook het best past volgens dezelfde overlap-en-afstandsregel, en de voltooide blokken worden gesorteerd op hun bovenrand, met de linkerrand als tiebreaker binnen een halve punt
Die tweede regel is waar het openingsvoorbeeld vandaan komt. Als de twee kolommen van een artikel een raster van baselines delen, overlappen de eerste regel van de linkerkolom en de eerste regel van de rechterkolom verticaal, dus zet physical layout ze op één regel. De afstand bij de goot is wijder dan een kwart van de fontgrootte, dus voegt de extractor één spatie in en gaat door. Elke regel van de body doet hetzelfde, de samengevoegde regels overlappen elkaar allemaal horizontaal, en de hele tweekoloms body wordt één breed blok dat dwars door de goot leest
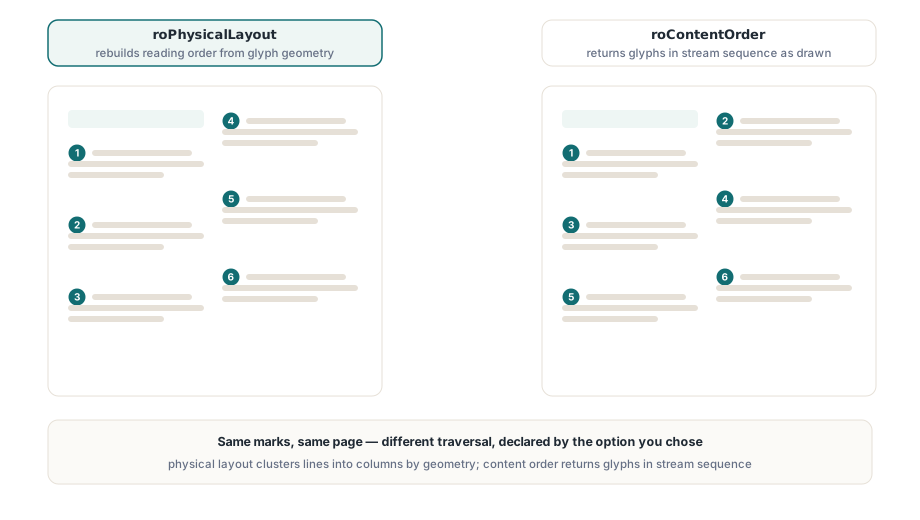
Contentvolgorde doet die pagina goed zodra de producent kolom één vóór kolom twee heeft geschreven, wat tekstverwerkers en zetsystemen normaal doen. De regels van de linkerkolom stapelen zich tot blokken, de eerste regel van de rechterkolom heeft geen horizontale overlap ermee en opent een vers blok, en de blokken komen in de volgorde waarin de auteur ze schreef. Physical layout verdient zijn plaats op een ander soort pagina: facturen, bankafschriften, formulieren en slides, waar een label en zijn waarde op dezelfde baseline staan en de rij van links naar rechts lezen precies is wat u wilt. Het is ook de modus voor wanneer de tekenvolgorde betekenisloos is, bijvoorbeeld tekst die lettertype voor lettertype wordt geschilderd of een pagina die uit vele kleine overlays is opgebouwd
Voor een gemengde collectie splitst u de keuze op documenttype. Artikelen, rapporten en handleidingen uit een bekend authoringtool gaan door roContentOrder; formulieren en transactionele documenten blijven op de roPhysicalLayout-default. De routine hieronder drukt de blokken van één pagina in contentvolgorde af, met koppen gemarkeerd wanneer het bestand getagd is
uses
  SysUtils, PDFium;

procedure DumpBlocks(Pdf: TPdf; PageNumber: Integer);
var
  Options: TPdfStructuredTextOptions;
  Page: TPdfStructuredTextPage;
  B, L: Integer;
begin
  Pdf.PageNumber := PageNumber;                 // vanaf 1
  Options := TPdfStructuredTextOptions.Default;
  Options.ReadingOrder := roContentOrder;      // producenten die kolom voor kolom schrijven

  Page := Pdf.GetStructuredText(Options);
  if Page.Source = rosStructure then
    Writeln('block kinds come from the structure tree')
  else
    Writeln('block kinds are inferred from layout');

  for B := 0 to High(Page.Blocks) do
  begin
    if Page.Blocks[B].Kind = cfHeading then
      Writeln(Format('[%d] H%d  %s',
        [B, Page.Blocks[B].HeadingLevel, Page.Blocks[B].Text]))
    else
    begin
      Writeln(Format('[%d] x=%.0f..%.0f, %d line(s)',
        [B, Page.Blocks[B].Bounds.Left, Page.Blocks[B].Bounds.Right,
         Length(Page.Blocks[B].Lines)]));
      for L := 0 to High(Page.Blocks[B].Lines) do
        Writeln('      ', Page.Blocks[B].Lines[L].Text);
    end;
  end;
end;
Hoe spott u een regel die dwars door de goot loopt?
Een samengevoegde regel verraadt zichzelf via zijn spans. GetStructuredText begint een nieuwe span wanneer het volgende karakter niet de directe opvolger van de vorige is in de oorspronkelijke karaktervolgorde van de pagina, naast de stijlwijzigingen die hieronder worden behandeld. Binnen één kolom zijn opeenvolgende woorden meestal ook opeenvolgend in de bron. Bij de goot van een samengevoegde regel springt de bronindex met honderden karakters, en de horizontale afstand tussen de twee spans is veel wijder dan welke woordspatie ook
Die twee signalen samen vormen een betrouwbare test, en u kunt hem draaien op de defaultuitvoer voordat u beslist of een pagina contentvolgorde nodig heeft. De momentopname van karakterdata die GetStructuredText leest wordt per pagina gecachet, standaard acht pagina's, dus dezelfde pagina een tweede keer vragen met een andere ReadingOrder hergroepeert data die al in het geheugen staat in plaats van de pagina opnieuw te extraheren
// LineCrossesGutter is een helper die u zelf toevoegt: hij vlagt een regel met twee
// naburige spans die ver uit elkaar op de pagina staan en niet aan elkaar grenzen
// in de bronkaraktervolgorde
function LineCrossesGutter(const Line: TPdfStructuredTextLine;
  MinGap: Double): Boolean;
var
  S: Integer;
  Prev, Cur: TPdfStructuredTextSpan;
begin
  Result := False;
  for S := 1 to High(Line.Spans) do
  begin
    Prev := Line.Spans[S - 1];
    Cur := Line.Spans[S];
    if (Prev.SourceStartIndex < 0) or (Cur.SourceStartIndex < 0) then
      Continue;                                 // alternate-text-blokken
    if (Cur.Bounds.Left - Prev.Bounds.Right > MinGap) and
       (Cur.SourceStartIndex <>
        Prev.SourceStartIndex + Prev.SourceCharacterCount) then
      Exit(True);
  end;
end;

function ExtractWithFallback(Pdf: TPdf): TPdfStructuredTextPage;
var
  Options: TPdfStructuredTextOptions;
  B, L, Lines, Crossing: Integer;
begin
  Options := TPdfStructuredTextOptions.Default;   // roPhysicalLayout
  Result := Pdf.GetStructuredText(Options);

  Lines := 0;
  Crossing := 0;
  for B := 0 to High(Result.Blocks) do
    for L := 0 to High(Result.Blocks[B].Lines) do
    begin
      Inc(Lines);
      if LineCrossesGutter(Result.Blocks[B].Lines[L], 18) then
        Inc(Crossing);
    end;

  // een kwart van de regels die een afstand overschrijden lijkt op kolommen, niet op een formulierrij
  if (Lines > 0) and (Crossing * 4 >= Lines) then
  begin
    Options.ReadingOrder := roContentOrder;
    Result := Pdf.GetStructuredText(Options);
  end;
end;
Achttien punten is een kwart inch, ruim wijder dan een woordspatie in brontekst en smaller dan de meeste goten. De één-op-vier-drempel houdt een factuur met een paar label-en-bedrag-rijen op physical layout terwijl een echte tweekoloms body, waar bijna elke regel overschrijdt, omschakelt. Schreef de producent de pagina rij voor rij over beide kolommen, dan blijven de bronindices aaneengesloten, springt de test nooit aan en scheidt geen van beide volgordes de kolommen voor u; die pagina heeft de kolommodus van de readable-content-API nodig, beschreven in twee kolommen lezen met een overspannende kop
Wat verandert IncludeSemantics, en wat laat hij met rust?
IncludeSemantics labelt blokken; hij herschikt ze niet. Met de optie aan leest GetStructuredText de leesbare inhoud van de pagina en geeft elk blok de soort van het fragment dat hem met de grootste oppervlakte overlapt. De beschikbare soorten zijn cfParagraph, cfHeading met een HeadingLevel, cfListItem, cfTableCell, cfCaption, cfFigure, cfLink, cfOther voor elke andere tag, en cfPlain wanneer niets matchte. Elk blok pikt ook een Language en een StructElementIndex op die hem aan een element van de boomstructuur koppelt
Het veld Source zegt waar het label vandaan kwam: rosStructure wanneer de pagina een bruikbare boomstructuur heeft in de zin van ISO 32000-1 §14.7, rosHeuristic wanneer de soorten werden afgeleid. Page.Source geeft hetzelfde antwoord voor de pagina als geheel. Een kop die met rosStructure wordt gemeld is een kop omdat de auteur hem tagde; één die met rosHeuristic wordt gemeld is een onderbouwde gok, en een indexeringspipeline die titels weegt moet de twee anders behandelen. De blokvolgorde komt in beide gevallen nog steeds uit ReadingOrder. De semantische pass gebruikt de readable-content-defaults, dus een kolominstelling die via ReadableContentOptions wordt toegepast bereikt GetStructuredText niet
Figuren krijgen één extra regel. Op een getagde pagina wordt een Figure-element of alternatieve tekst die aan geen enkel tekstblok is gekoppeld als een blok op zich toegevoegd, met de alternatieve beschrijving als zijn tekst. Zo'n blok heeft één regel en één span met SourceStartIndex op -1, want geen glyph op de pagina heeft hem voortgebracht. Code die spans terug naar karakters mapt moet die waarde overslaan, wat de gotentest hierboven ook controleert. De controles op de boomstructuur zelf staan in PDF/UA-boomstructuurvalidatie
Spans, bounds en de weg terug naar karakters
Elke TPdfStructuredTextSpan draagt zijn tekst, zijn bounds, FontName, FontSize, FontWeight en Angle mee, plus SourceStartIndex en SourceCharacterCount. Met IncludeFontInfo aan eindigt een span waar ook maar een van de vier stijlwaarden verandert, dus een zin met drie vette woorden in het midden komt binnen als drie spans en nadruk kan worden herbouwd uit FontWeight in plaats van uit lettertypenamen worden geraden. Met IncludeFontInfo uit blijven de stijlvelden leeg en breken spans alleen waar de bronvolgorde wordt onderbroken
De hoek telt op pagina's met stempels. Een diagonale DRAFT-watermerk huist in dezelfde coördinatenruimte als de brontekst, en in physical layout kunnen zijn letters op bodyregels landen die ze verticaal kruisen. Spans met een niet-nul Angle zijn makkelijk weg te laten voordat u tekst voor indexering samenvoegt
De twee bronvelden zijn wat een zoektreffer omzet in iets dat u kunt tekenen. Ze indexeren de karaktervolgorde van de pagina, dus een zin die in een blok wordt gevonden zet direct om in karakterboxen voor een markering, met de aanpak uit visuele tekstregelselectie met karakterboxen. Wanneer de reflow- of HTML-vorm van de pagina het doel is, voeden dezelfde blokken het reflow-model en zijn HTML-export
Een karakterbudget en twee kwaliteittellers
MaxCharacters weigert een pagina ronduit wanneer hij meer karakters bevat dan is toegestaan. GetStructuredText controleert de telling voordat hij werkarrays alloceert, en een te grote pagina gooit EPdfError met de melding Structured text character budget exceeded; een partieel pagina wordt nooit teruggegeven. De waarde moet positief zijn. De karaktermomentopname per pagina die de methode leest heeft een eigen default-plafond van 1.000.000 karakters en 100.000 tekstobjecten, gemeld als Text snapshot budget exceeded, dus MaxCharacters boven de miljoen laat geen grotere pagina door
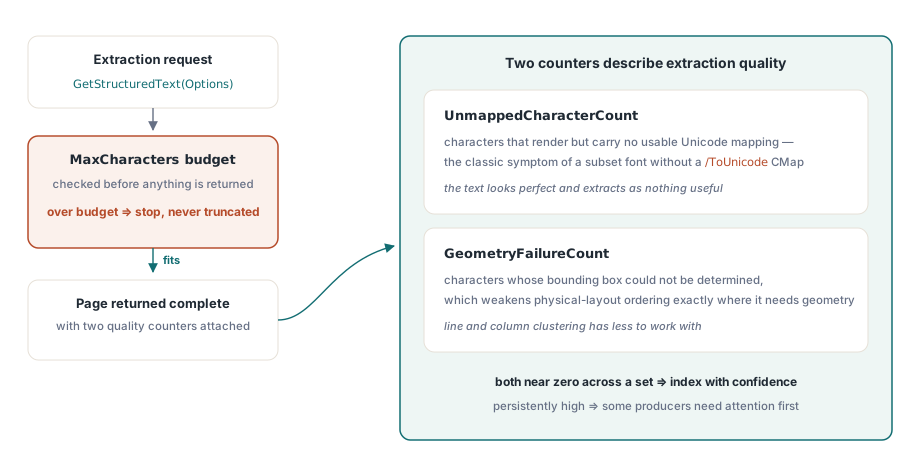
UnmappedCharacterCount telt karakters waarvoor PDFium helemaal geen Unicode-waarde kon produceren. Die karakters verschijnen als U+FFFD in elk Text-veld. De gebruikelijke oorzaak is een subsetlettertype met een eigen codering en geen /ToUnicode-CMap, het geval dat ISO 32000-1 §9.10.2 beschrijft, waarin tekst correct rendert en niet betrouwbaar te extraheren is. De teller meet alleen ontbrekende mappings: een glyph wiens /ToUnicode-entry het verkeerde codepunt noemt telt als gemapt, dus een pagina met geloofwaardelijk ogende rommel kan nog steeds nul melden
GeometryFailureCount telt karakters zonder bruikbare doos, regeleinden uitgezonderd. In contentvolgorde volgen zulke karakters simpelweg hun buren. In physical layout hebben ze geen positie om op te sorteren, dus worden ze na elk gepositioneerd karakter geplaatst en belanden ze aan de onderste regel van de pagina. Een pagina met een niet-nul geometrietelling en vreemde fragmenten op zijn laatste regel toont precies dat
// LogRejected en LogQuality zijn uw eigen logroutines
function ExtractForIndex(Pdf: TPdf; PageNumber: Integer;
  out Page: TPdfStructuredTextPage): Boolean;
var
  Options: TPdfStructuredTextOptions;
begin
  Result := False;
  Pdf.PageNumber := PageNumber;
  Options := TPdfStructuredTextOptions.Default;
  Options.MaxCharacters := 200000;              // intakelimiet voor deze pipeline
  try
    Page := Pdf.GetStructuredText(Options);
  except
    on E: EPdfError do
    begin
      LogRejected(PageNumber, E.Message);       // karakter- of momentopnamebudget
      Exit;
    end;
  end;

  if Page.UnmappedCharacterCount * 20 > Page.CharacterCount then
    LogQuality(PageNumber, Format('%d of %d characters have no Unicode value',
      [Page.UnmappedCharacterCount, Page.CharacterCount]));
  if (Options.ReadingOrder = roPhysicalLayout) and
     (Page.GeometryFailureCount > 0) then
    LogQuality(PageNumber, Format('%d characters without a box; check the last line',
      [Page.GeometryFailureCount]));
  Result := True;
end;
Voor een pagina die u alleen als string nodig heeft, behandelt tekst uit PDF-documenten extraheren de eenvoudigere aanroepen, en BDC- en MCID-marked content lezen en schrijven gaat één laag onder de boomstructuur. Het gestructureerde paginamodel, de readable-content-lezer en de reflow-export worden allemaal geleverd in de Delphi- en Lazarus-component die op de productpagina van PDFium Component wordt beschreven