Een blinde gebruiker opent een kwartaalrapport in uw spiksplinternieuwe Delphi-viewer, zet NVDA aan, en hoort de paginavoet, dan een kolom met cijfers, dan de titel die elke ziende lezer als eerste gelezen zou hebben. Of hoort helemaal niets. De pagina ziet er op het scherm perfect uit, en dat is precies de val: renderen en lezen zijn verschillende problemen die door verschillende code worden opgelost. De volgorde waarin een PDF zijn glyphs verft heeft geen verplichting overeen te komen met de volgorde waarin een mens ze hoort, dus een viewer die uitsluitend op render-aanroepen is gebouwd produceert een vlekkeloos beeld en een onbruikbare vertelling. PDFium Component, de VCL/LCL-wrapper rond de PDFium-engine voor Delphi, C++Builder en Lazarus, draagt daarom een aparte set lees-API's met zich mee. De teken-API's kunnen geen leesvolgorde herstellen die ze nooit meekregen
Een toegankelijke lezer slaagt of faalt op drie dingen. Hij moet een volgorde extraheren die een schermlezer kan uitspreken, een zichtbare woordcursor pinnen op wat de stem ook zegt, en toegeven wanneer een document nooit getagd is in plaats van te gokken en te doen alsof. Elk ervan heeft een heldere API om naar te grijpen en een falen dat bijt als u het detail overslaat
De leesvolgorde leeft in de structuurboom, niet in de tekenvolgorde
ISO 32000-1 §14.8 definieert logische structuur als een boom van elementen over de pagina-inhoud uitgespreid. PDF/UA (ISO 14289-1) gaat verder en maakt die boom verplicht: elk stuk echte inhoud moet in leesvolgorde erdoor bereikbaar zijn, met pagina-artefacten als zodanig gemarkeerd en overgeslagen. Een correct getagd rapport weet dat "Kwartaalresultaten" een koptekst van niveau twee is en dat het totaalraster een tabel is met koptekstcellen. Een ongetagd rapport is een stapel gepositioneerde glyph-runs die toevallig op een document lijken
ReadablePageContent loopt die structuur af wanneer die aanwezig is en levert fragmenten getagd met een semantische Kind, waarden als cfHeading en cfParagraph, zodat de UI "koptekst" kan zeggen vóór de woorden in plaats van een vetgedrukte regel als gewone looptekst voor te lezen. Zonder bruikbare boom valt dezelfde aanroep terug op heuristische layout-analyse: kolommen detecteren, baselines clusteren, van links naar rechts en van boven naar beneden ordenen. Die fallback is prima voor een memo in één kolom en wankel voor een nieuwsbrief, een formulier in meerdere kolommen, alles met een zijbalk of een pull quote. Wat telt is weten welk resultaat u kreeg, en de API vertelt het u ronduit. Het record TPdfReadableContent draagt een veld Source dat op rosStructure staat wanneer de volgorde uit de getagde boom kwam, of op rosHeuristic wanneer die uit geometrie werd afgeleid. Toon een gegiste volgorde alsof die geverifieerd is en u hebt de toegankelijkheidsversie verscheept van een geslaagde badge op een build die niemand draaide
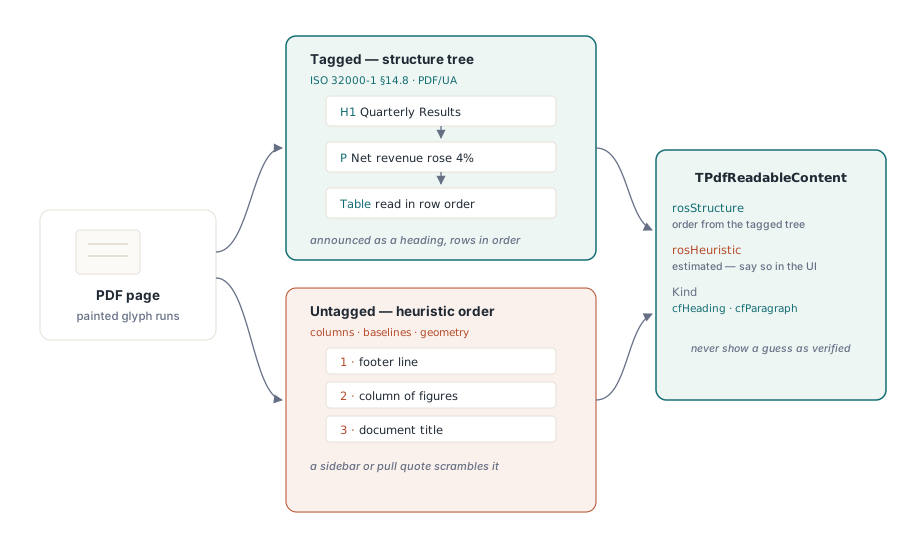
De goedkope zet bij openen is IsTagged lezen en eenmaal ValidatePdfUa aanroepen, dan het antwoord cachen. Een gefaalde PDF/UA-check is geen reden om het bestand te weigeren. Het is reden om "geschatte leesvolgorde" in de statusbalk te zetten, zodat wanneer een klant mailt met een klacht over verminkte vertelling, support al weet of ze kijken naar een taggingprobleem in het bestand of een bug in uw code
Van pagina naar spraakqueue met ReadingUnits
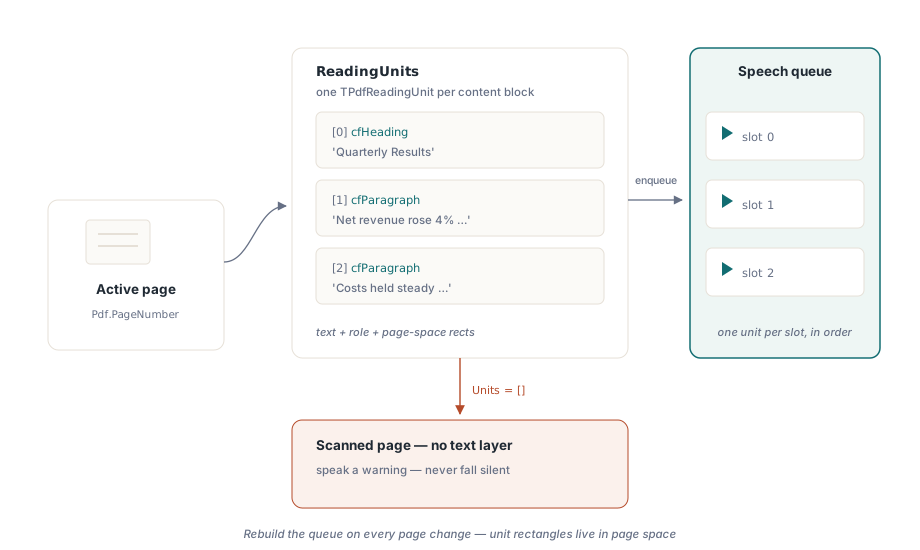
Voor text-to-speech doet ReadingUnits het zware werk. Het retourneert een array van TPdfReadingUnit-records voor de actieve pagina, elk met de uit te spreken tekst, zijn semantische rol, en de rechthoeken die het op de pagina plaatsen. Er is een documentbrede metgezel, DocumentReadingUnits, wanneer u doorlopend lezen over pagina's wilt. Eén unit valt rechtstreeks in één slot van een spraakqueue:
procedure TReaderForm.QueuePageSpeech(PageNumber: Integer);
var
  Units: TPdfReadingUnits;
  i: Integer;
begin
  Pdf.PageNumber := PageNumber;   // ReadingUnits werkt op de actieve pagina
  Units := Pdf.ReadingUnits;
  FSpeechQueue.Clear;
  for i := Low(Units) to High(Units) do
    FSpeechQueue.Add(Units[i]);  // tekst + semantiek + markeringsrechthoeken
  FCurrentPage := PageNumber;
  SpeakNextUnit;
end;
Twee dingen in die lus gaan makkelijk fout. Houd de queue per pagina en bouw hem telkens opnieuw op wanneer de gebruiker navigeert, want leesunits dragen rechthoeken in paginaruimte; een queue die is overgebleven van pagina drie schildert zijn markeringen op pagina vier. En behandel een lege Units-array op een pagina die duidelijk inhoud heeft als uw image-only-detector. Een gescande pagina is pixels zonder tekstlaag eronder, en het juiste antwoord is een waarschuwing uitspreken ("deze pagina heeft geen extraheerbare tekst") in plaats van stil te vallen op een manier die de luisteraar niet van een hang kan onderscheiden
Een woordcursor die de stem volgt
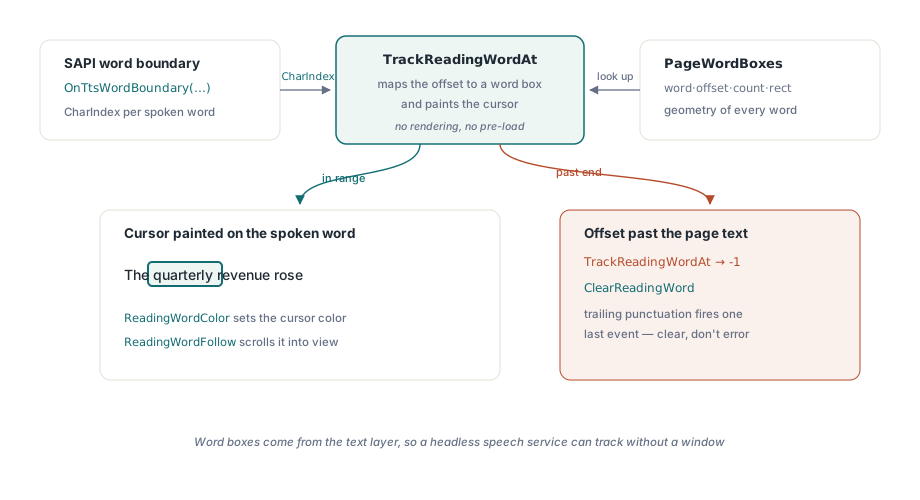
Een hele paragraaf tegelijk markeren voelt traag aan voor een slechtziende gebruiker die de woorden met het oog volgt terwijl ze hardop worden gelezen. Markering op woordniveau, het karaoke-effect, heeft twee stukken nodig: de geometrie van elk woord, en een manier om de voortgangsrapporten van de TTS-engine op die geometrie af te beelden. PageWordBoxes levert de geometrie als TPdfWordBox-records, elk met de woordtekst, zijn teken-offset, zijn tekentelling, en een rechthoek in paginaruimte. TrackReadingWordAt levert de afbeelding. Voed het met de tekenpositie die het word-boundary-event van SAPI al rapporteert, en het herleidt die offset tot een index in de word-box-array en schildert de cursor op het overeenkomende woord in één aanroep
procedure TReaderForm.PrepareKaraoke(PageNumber: Integer);
begin
  // De woordvakken van de view komen van de pagina die de view toont.
  // Alleen Pdf.PageNumber instellen zou de view niet verplaatsen
  PdfView.PageNumber := PageNumber;
  FWordBoxes := PdfView.PageWordBoxes;
end;

procedure TReaderForm.OnTtsWordBoundary(Sender: TObject; CharIndex: Integer);
var
  WordIdx: Integer;
begin
  // TrackReadingWordAt vertaalt de offset EN tekent de woordcursor
  WordIdx := PdfView.TrackReadingWordAt(FCurrentPage, CharIndex);
  if WordIdx < 0 then
    PdfView.ClearReadingWord;  // grens liep voorbij de paginatekst
end;
Het contract is royaal op één punt en meedogenloos op een ander. Het royale deel: TrackReadingWordAt houdt zijn eigen word-box-cache bij voor de pagina die hij volgt, dus er is niets vooraf te laden en er gebeurt helemaal geen renderen omdat de word-boxes uit de tekstlaag komen. Een headless spraakservice zonder zichtbaar venster kan toch posities volgen. Het meedogenloze deel: de tekenindex moet wijzen in de tekst die de component extraheerde, niet in een of andere opgeschoonde string die u zelf bouwde. Wanneer CharIndex voorbij het einde van de paginatekst loopt, retourneert de functie -1 in plaats van te raisen, wat de hele tijd gebeurt wanneer een TTS-engine een laatste boundary-event afvuurt voor nasleepende leestekens. Lees -1 als "wis de cursor", nooit als een fout
Aan de weergavezijde stelt ReadingWordColor de cursorkleur in. De standaard amber houdt stand over de meeste pagina-achtergronden, maar test het onder elk weergavefilter dat uw viewer aanbiedt. Een amber cursor kan volledig verdwijnen onder kleurinversie, en inversie tegelijk met spraak is precies hoe een slechtziende gebruiker werkt, dus de enige combinatie die u het hardst goed moet krijgen is degene die een snelle demo nooit oefent. Zet ReadingWordFollow op True en de view scrollt het uitgesproken woord uit zichzelf in beeld, wat u niet kunt missen op een ingezoomde pagina die over schermen uitstort. Let op één scope-regel: SetReadingWord schildert alleen op de actieve pagina van TPdfView. Besluit vooraf of handmatig scrollen de spraak pauzeert of dat het volggedrag dat overstemt, want geen van beide kiezen laat de stem doorlezen terwijl de cursor ergens buiten beeld staat
De documenten die uw lezer breken
Een handvol invoervormen verslaat een naïeve implementatie betrouwbaar genoeg dat ze thuishoren als permanente samples in de regressiesuite, niet als eenmalige bugs die u oplost en vergeet
- Ongetagde maar tekstrijke bestanden. Heuristische volgorde is meestal juist voor een lineair rapport en fout zodra een zijbalk of pull quote erbij komt. Markeer de volgorde als geschat, zowel in de UI als in uw diagnostieklog, zodat het falen later leesbaar is
- Image-only-scans. Helemaal geen tekstlaag. Vang ze via lege leesunits en wijs de gebruiker op een OCR-stap upstream in plaats van de lezer een lege pagina te laten vertellen
- Combinerende tekens en gemengde scripts. Unicode-combineertekens collapsen niet altijd één-op-één tot visuele woorden, dus het aantal word-boxes kan afwijken van wat uw eigen tokenizer verwacht. Indexeer de word-box-array niet met offsets die u zelf berekende door tekst te splitsen; gebruik alleen de indices die
TrackReadingWordAtretourneert
Test het als een auditor, niet als een demo
"Het las mijn sample hardop" bewijst niets. Een ronde die u kunt verdedigen draait drie bestanden door de voltooide build met NVDA eraan vast: één bekend-getagd bestand, waarin kopteksten als kopteksten worden aangekondigd en een tabel in rijvolgorde wordt gelezen; één bekend-ongetagd bestand, waarin de indicator voor geschatte volgorde zichtbaar is; en een scan, waarin de geen-tekst-waarschuwing werkelijk wordt uitgesproken. Elk ervan oefent een pad dat het gelukkige pad overslaat
Bevestig van daaruit dat de woordcursor vergrendeld blijft op dubbele spreesnelheid en op de helft, en dat het scrollen van ReadingWordFollow niet worstelt met het eigen scrollen van de gebruiker. Draai dan spraak terwijl u door elk kleurfilter cyclt en kijk dat de cursor nooit verdwijnt. Het artikel over kleurfilters voor slechtzienden behandelt dat renderpad in detail, en de diepgaande blik op de woord-spraakcursor ontleedt de TTS-timing
De reading-unit- en word-box-API's die hierboven zijn gebruikt, worden meegeleverd met PDFium Component voor Delphi en C++Builder (VCL) en Lazarus/FPC (LCL). De productpagina linkt de volledige API-referentie, inclusief de record-layouts voor reading-units en word-boxes achter deze voorbeelden