Objectnummer 1 is niet pagina 1. Dat ene feit legt meer PDF-verwerkingscode plat dan welk ander onderdeel van het formaat ook, en de reden laat zich pas zien zodra je stopt met kijken naar wat een viewer rendert en begint te kijken naar de objectgrafiek die de viewer echt leest
Een PDF-bestand is een verzameling genummerde indirecte objecten. Elk draagt een objectnummer en een generatienummer, en andere objecten wijzen ernaar met een verwijzing geschreven als N G R — 3 0 R betekent de huidige versie van object 3. Pagina's zijn objecten als alle andere, maar waar ze in het bestand staan en welke nummers ze dragen zegt niets over de weergavevolgorde. Die volgorde komt uit de /Pages-boom. Scan je objecten numeriek, dan bouw je voor een flink deel van de bestanden in het wild de pagina's in de verkeerde volgorde
In die boom woont ook veel minder voor de hand liggend gedrag. Zijn vorm bepaalt hoe snel een viewer naar pagina 8.214 kan springen, zijn binnenknopen geven paginagrootte en fonts stilletjes door aan de bladeren eronder, en de /Count-totalen die de hele structuur snel maken worden door niets afgedwongen. We lopen alle drie langs, te beginnen bij de volgorde zelf
De paginaboom bepaalt de volgorde
Elke PDF heeft een documentcatalogus (ISO 32000-2 §7.7.2), en de /Pages-entry van de catalogus wijst naar de wortelknoop van de paginaboom. Die wortel is een dictionary met /Type /Pages, een /Kids-array met indirecte verwijzingen, en een /Count die het aantal bladpagina's eronder geeft. De weergavevolgorde is een diepte-eerst, links-naar-rechts-walk door die boom. Dat is de hele regel
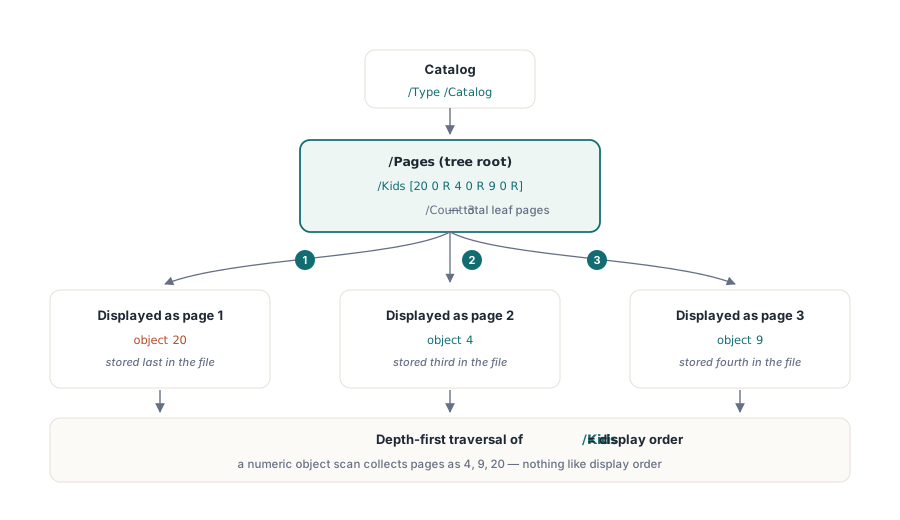
Een minimaal bestand van drie pagina's maakt het concreet:
%PDF-1.7

1 0 obj
<< /Type /Catalog /Pages 2 0 R >>
endobj

2 0 obj
<< /Type /Pages /Kids [20 0 R  4 0 R  9 0 R] /Count 3 >>
endobj

% Object 4 staat derde in het bestand maar is pagina 2 in de weergavevolgorde
4 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 5 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj

% Object 9 staat vierde maar is pagina 3
9 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 10 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj

% Object 20 staat laatst maar is pagina 1; Kids[0] beslist, niet het objectnummer
20 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 21 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj
De /Kids-array luidt [20 0 R 4 0 R 9 0 R], dus object 20 is pagina 1, object 4 is pagina 2 en object 9 is pagina 3. Code die objecten in numerieke volgorde doorloopt en alles met /Type /Page verzamelt, heeft dit bestand verkeerd. Erger: de uitvoer ziet er nog plausibel uit — juist paginatotaal, herkenbare content op elke pagina, verkeerde volgorde
Generatoren produceren zulke indelingen om gewone redenen. Een library die vooraf objectnummers voor alle pagina's reserveert, nummert ze in aanmaakvolgorde en schrijft daarna de bytes in welke volgorde de serializer uitkomt. Een merge-tool hernummert objecten uit elk brondocument om botsingen te vermijden, zodat de paginaobjecten verspreid over de gecombineerde objecttabel belanden terwijl de nieuwe wortel-/Kids-array de juiste volgorde bevat. En incrementele updates plakken nieuwe objecten met verse nummers achteraan in het bestand, dus een pagina die in een revisie is toegevoegd staat tegen het einde van de bytestroom ook als hij op positie 1 hoort
Dat laatste geval is degene die bijt. Een testcorpus van één tool kan volledig slagen, en dan komen bestanden uit een merge-werkstroom, of documenten die een paar revisies doormaakten, door elkaar uit de bus. Heuristische fixes houden het niet, want de mislukking hangt af van de generator en van de bewerkingsgeschiedenis van het bestand. De echte fix is kort: begin bij de catalogus, los /Pages op, loop /Kids recursief door en emitteer bladeren in de volgorde waarin je ze tegenkomt. Onze case study over paginavolgorde-debuggen volgt precies dit symptoom langs een verkeerde diagnose naar de oorzaak, met de recursieve traverseringcode en qpdf-stappen om het resultaat te controleren
Fan-out is een beslissing over prestaties
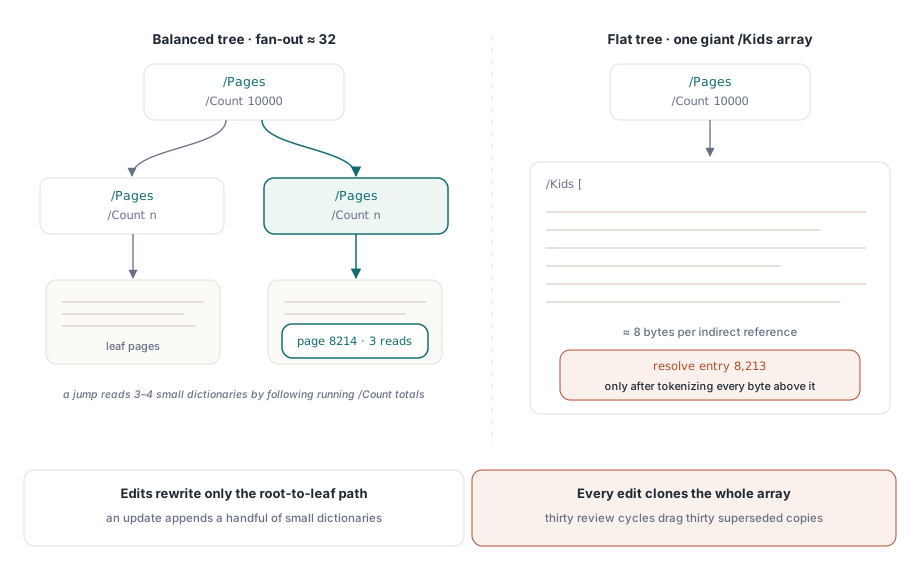
De specificatie staat twee vormen toe. Eenvoudige generatoren emitteeren een vlakke boom: één wortel-/Pages-knoop waarvan de /Kids niets anders bevat dan /Page-bladeren. Niets dwingt een schrijver te nesten, en een document van 10.000 pagina's met 10.000 bladverwijzingen in één array is conform. De PDF Reference beveelt desondanks een gebalanceerde boom aan voor grote documenten, en gangbare generatoren volgen dat advies met een bescheiden fan-out — doorgaans enkele tientallen kids per binnenknoop, waar elke binnenknoop zijn eigen /Kids en zijn eigen /Count heeft
De reden is wat een viewer moet lezen voordat het iets kan tonen. Neem een sprong recht naar pagina 8.214 van dat bestand met 10.000 pagina's. Met een vlakke boom moet de viewer eerst de wortel parsen, en de wortel is één enorm array: bij ruwweg acht bytes per indirecte verwijzing een object van 80 KB dat van eind tot eind getokeniseerd moet worden voordat entry 8.213 oplost. Met een gebalanceerde boom met fan-out 32 leest dezelfde sprong de wortel, vergelijkt lopende /Count-totalen om het juiste kind te kiezen, en daalt af. Drie of vier kleine dictionaries van elk een paar honderd bytes. Die O(log n)-willekeurige toegang is waar de boom voor ontworpen is, en het is de volledige reden dat /Count op binnenknopen bestaat — een lezer kan een hele subboom overslaan zonder er één object binnenin te openen
De boomvorm bepaalt ook de kosten van bewerken. Een incrementele update die één pagina invoegt moet elke knoop herschrijven waarvan /Kids of /Count veranderde, dus het pad van de nieuwe ouder van het blad tot de wortel. In een gebalanceerde boom is dat pad een handjevol kleine dictionaries achteraan in het bestand. In een vlakke boom is het "pad" het reusachtige wortelarray, bij elke revisie volledig gedupliceerd. Een contract dat dertig review-en-annotate-rondes doormaakt kan dertig vervangen exemplaren van hetzelfde 80 KB-array in zijn bytestream gaan slepen
Voor verwerkingscode heeft nesten een bottere gevolg. Je kunt niet aannemen dat het eerste /Kids-niveau pagina's bevat, dus elk kind moet gecontroleerd worden: /Type /Pages betekent recursie, /Type /Page betekent blad. Code die op het eerste niveau stopt werkt op elk vlak bestand dat hij tegenkomt en laat dan stilletjes hele subbomen vallen zodra een generator besluit te nesten
Binnenste knooppunten dragen geërfde attributen
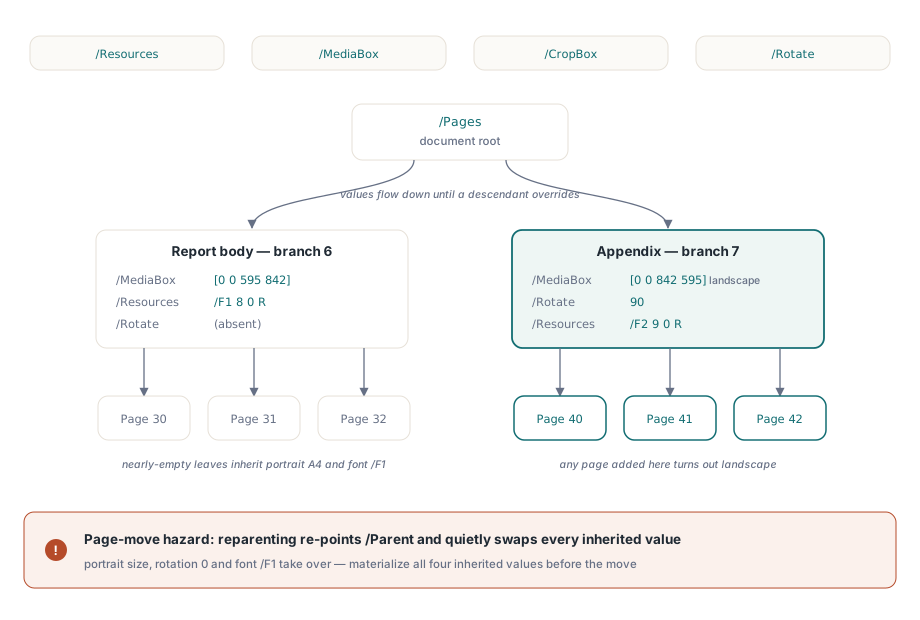
Binnenknopen doen meer dan opzoekingen routeren. Vier pagina-attributen zijn overerfbaar (ISO 32000-2 §7.7.3.4): /Resources, /MediaBox, /CropBox en /Rotate. Elk ervan mag op een /Pages-knoop staan, waar het voor elk blad eronder geldt tenzij een afstammeling het overruled. Een schrijver die een rapport met een liggende bijlage produceert kan die indeling in de boom zelf uitdrukken:
5 0 obj   % documentwortel
<< /Type /Pages /Count 6 /Kids [6 0 R  7 0 R] >>
endobj

6 0 obj   % rapportbody: staand A4, tekstfont
<< /Type /Pages /Parent 5 0 R /Count 3
   /Kids [30 0 R  31 0 R  32 0 R]
   /MediaBox [0 0 595 842]
   /Resources << /Font << /F1 8 0 R >> >> >>
endobj

7 0 obj   % bijlage: liggend A4, geroteerd, eigen font
<< /Type /Pages /Parent 5 0 R /Count 3
   /Kids [40 0 R  41 0 R  42 0 R]
   /MediaBox [0 0 842 595] /Rotate 90
   /Resources << /Font << /F2 9 0 R >> >> >>
endobj

40 0 obj  % bijlagepagina: erft grootte, rotatie, fonts
<< /Type /Page /Parent 7 0 R /Contents 43 0 R >>
endobj
Objecten 40 tot en met 42 zijn bijna leeg. Paginagrootte, rotatie en font-resources komen allemaal van knoop 7, wat het bestand compact en zelfonderhoudend houdt: voeg een vierde pagina onder de bijlageknoop toe en hij komt er liggend uit zonder dat iemand er iets aan doet
Het betekent ook dat de eigenschappen van een pagina niet allemaal op de pagina staan. Object 40 heeft geen /MediaBox-sleutel, en dat is volkomen legaal — een lezer die de ontbrekende sleutel als misvormde invoer behandelt wijst geldige bestanden af. De opzoeking moet de /Parent-keten volgen tot hij de entry vindt of de wortel bereikt. Die walk heeft een cyclusbewaking nodig. Een beschadigd bestand kan een /Parent-verwijzing dragen die terugwijst naar een al bezochte knoop, en zonder een set bezochte objecten draait de opzoeking oneindig
Dezelfde mechaniek schept het klassieke pagina-verplaats-gevaar. Stel dat een tool object 40 naar de rapportbody verplaatst door de twee /Kids-arrays te bewerken en /Parent naar knoop 6 te herwijzen. De verplaatsing is structureel geldig, maar object 40 erft nu de staande /MediaBox, geen rotatie en font /F1 — terwijl zijn content-stream nog /F2 selecteert, dat niet meer oplost. De pagina krimpt, draait terug en verliest zijn tekst in één bewerking. Herordeningscode die deugt schrijft de opgeloste waarden van alle vier de overerfbare attributen op de page-dictionary voordat hij de ouder wijzigt. Heb je ooit een pagina in een editor gesleept en zag je hem van grootte of oriëntatie wisselen, dan is dit de mechaniek die je zag
Afvlakken (Flattening): legaal, gebruikelijk, soms duur
Veel tools slaan de andere kant op. Minimale schrijvers emitteeren een een-niveauboom omdat dat simpel is, en veel merge- en split-hulpmiddelen herbouwen wat ze lezen tot één vlakke /Kids-array, want gebalanceerde uitvoer is extra werk en vlakke uitvoer conformt altijd. Een correcte herbouw moet overerving tegelijk oplossen. Elk attribuut dat een blad erfde moet op het blad gekopieerd worden, of naar de nieuwe wortel getild worden als het document-breed gelijk is; sla die stap over en de uitvoer verandert geometrie precies zoals in het pagina-verplaats-geval
Voor gewone documenten is afvlakken ongevaarlijk. Het doet pijn op schaal, op de twee al beschreven manieren: het wortelarray wordt één groot object dat elke opening en elke paginasprong volledig parset, en elke structurele bewerking herschrijft het helemaal. Wat afvlakken niet sloopt is delen via indirecte verwijzingen. Een vlakke boom waarin alle 10.000 pagina's naar hetzelfde /Resources-dictionaryobject wijzen is nog steeds gededupliceerd — het enige wat verloren gaat is de optie om de entry van de pagina weg te laten en een voorouder hem te laten leveren
Wanneer /Count liegt
/Count is pure administratie. Het moet gelijk zijn aan het aantal bladpagina's in de subboom van de knoop, en niets in het bestandsformaat dwingt dat af. Twee corruptiepatronen verklaren het meeste van de liegende tellingen die in het wild voorkomen
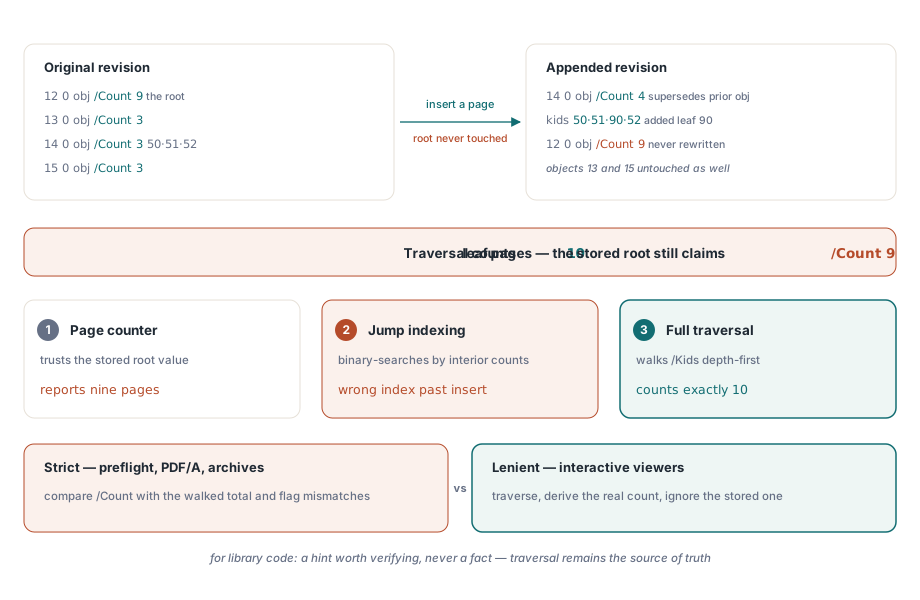
De eerste is de verouderde (stale) telling die achterblijft door een incrementele update. Een editor voegt een pagina in, herschrijft de directe ouder (immediate parent) met een nieuwe /Kids en een bijgewerkte /Count, en voegt beide toe aan het bestand — maar raakt de voorouders (ancestors) nooit aan:
% Original revision
12 0 obj
<< /Type /Pages /Count 9 /Kids [13 0 R  14 0 R  15 0 R] >>
endobj

14 0 obj
<< /Type /Pages /Parent 12 0 R /Count 3
   /Kids [50 0 R  51 0 R  52 0 R] >>
endobj

% Toegevoegde revisie: één pagina in de middelste tak ingevoegd
% Object 14 is superseded; object 12 is never rewritten
14 0 obj
<< /Type /Pages /Parent 12 0 R /Count 4
   /Kids [50 0 R  51 0 R  90 0 R  52 0 R] >>
endobj
De boom bevat nu tien bladeren, maar de wortel zegt nog negen. Een viewer die de wortel vertrouwt toont negen in zijn paginateller. Eén die binnenknopen gebruikt om een paginasprong binair te zoeken rekent voor elke pagina na het invoegpunt de verkeerde index uit. Een volledige traversering vindt er tien. Drie verschillende antwoorden, één bestand
Er is een stillere manier om door hetzelfde bestand gebeten te worden. Code die de worteltelling leest, de boom begint te doorlopen en stopt zodra hij zoveel pagina's heeft verzameld, zal pagina tien nooit zien. Geen exceptie, geen waarschuwing, gewoon een document dat één pagina tekortkomt. /Count als loopgrens of bounds-check gebruiken is de fout; de walk moet doorlopen tot de boom uitgeput is, wat het opgeslagen getal ook zegt
Het tweede patroon is de telling die nooit juist kon zijn: negatief, nul op een gevulde knoop, of absurd groot. Die komen uit fuzzing, uit transportbeschadiging en af en toe uit rekenfouten in editors. Ze zijn gevaarlijk specifiek voor code die /Count vertrouwt voor allocatie. Een array voorbereiden op een /Count van -3 geeft hooguit een range error, en het doen vanaf een /Count van twee miljard is een denial-of-service-allocatie. Behandel de waarde als onbetrouwbare invoer, zoals elk ander getal in het bestand
Parsers vallen hierover in twee kampen. Strikte consumenten — preflight-tools, PDF/A-validators, archiefpipelines — vergelijken /Count met het traverseringsresultaat en wijzen het bestand af of vlaggen het. Interactieve viewers zijn vrijwel universeel soepel: ze traverseren, leiden het echte totaal af en negeren het opgeslagen stilletjes, en dat is precies waarom een bestand met een verouderde telling jaren kan ronddraaien zonder klacht totdat het een strengere parser tegenkomt in een geautomatiseerd werkproces. Voor library-code vinden wij het midden de juiste default. Gebruik /Count als hint voor voorallocatie, en voor het overslaan van subbomen zodra hij is geverifieerd, en laat traversering de bron van waarheid blijven
In productie kondigen deze mislukkingen zich zelden als boomproblemen aan. Ze tonen zich als doorelkaar geschudde pagina's, een ontbrekende pagina na een merge, of een pagina die van grootte of oriëntatie wisselt na een herordening. De debugging-case-study spoort zo'n rapport terug langs de boom. Voor de omliggende bestandsanatomie (objecten, cross-reference-data, trailers) is het overzicht van de PDF-bestandsstructuur het startpunt
De HotPDF Delphi Component pakt dit alles intern aan: hij doorloopt geneste bomen van elke diepte, lost geërfde attributen op wanneer pagina's worden gekopieerd of verplaatst, en controleert /Count tegen het werkelijke aantal bladeren in plaats van het te vertrouwen, dus pagina-indexen in zijn API betekenen altijd logische pagina's