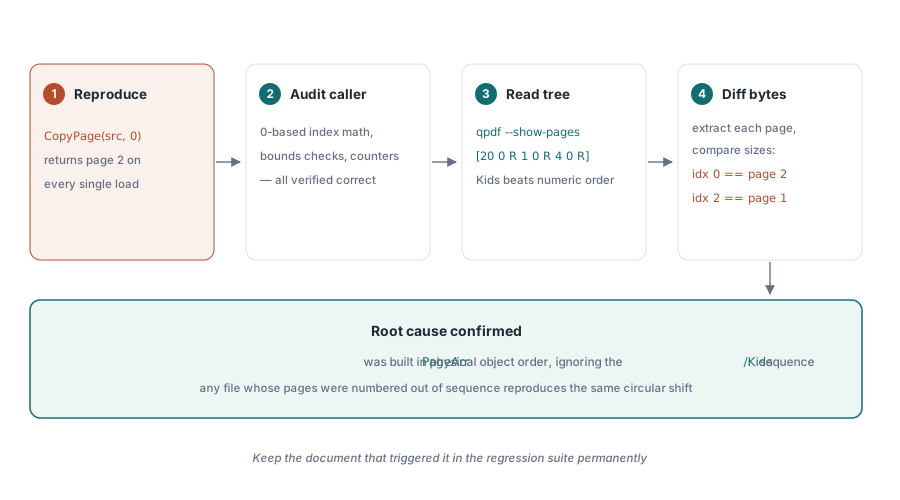
Het klassieke symptoom lijkt op een off-by-one: een pagina-kopieerroutine vraagt pagina 1 van een document van drie pagina's op en krijgt steevast pagina 2. De indexeringslogica klopt. De aanroep gebruikt een logische index op basis van 0, de rekenkunde is correct, de grensvoorwaarden zijn in orde. Toch komt er elke keer de verkeerde pagina uit
De oorzaak zit helemaal niet in de kopieercode. Hij zit in de manier waarop de loader zijn pagina-array opbouwt, en het is een van de gemakkelijkste valkuilen in het parseren van PDF's om in te stappen
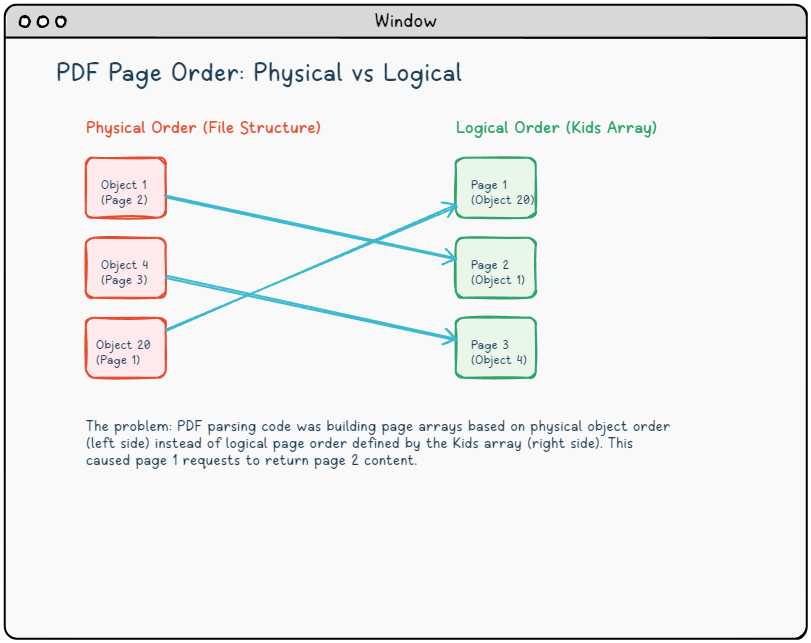
Twee volgordes, één bron van verwarring
Een PDF-bestand is een verzameling indirecte objecten, elk geïdentificeerd door een objectnummer. De bestandsstructuur legt geen verplichting op aan die nummers om de leesvolgorde te weerspiegelen. Object 1 kan pagina 2 bevatten; object 20 kan pagina 1 bevatten. Wat de leesvolgorde daadwerkelijk definieert, is de paginaboom (page tree): een hiërarchie van /Pages-dictionaries waarvan de /Kids-arrays paginaverwijzingen opsommen in de reeks waarin een viewer ze zou moeten weergeven (ISO 32000-1 §7.7.3)
Hier is een paginaboom die de valkuil blootlegt:
{ root van de pages tree, object 16 }
16 0 obj
<<
  /Type /Pages
  /Count 3
  /Kids [20 0 R   { logische pagina 1 }
         1 0 R    { logische pagina 2 }
         4 0 R]   { logische pagina 3 }
>>
endobj
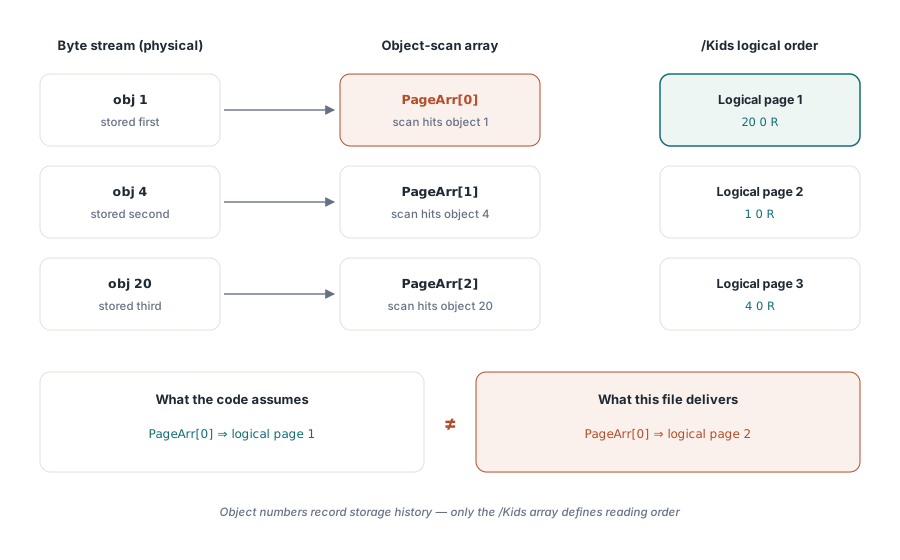
Het bestand vermeldde toevallig object 1 en object 4 vóór object 20 in de bytestroom. Elke parser die de indirecte objecten in bestandsvolgorde doorliep en ze in een PageArr stampte naarmate hij dictionaries van het pagina-type vond, zou eindigen met object 1 op index 0, object 4 op index 1 en object 20 op index 2. Logische pagina 1 bevindt zich op PageArr[2]. Vragen om pagina-index 0 haalt in plaats daarvan logische pagina 2 op
De hypothese bevestigen
Voordat u code aanpast, bewijs de mismatch in plaats van hem aan te nemen. De qpdf command-line tool maakt dit eenvoudig:
{ shell }
qpdf --show-pages input.pdf
{ De output laat de Kids-volgorde zien: 20 0 R, dan 1 0 R, dan 4 0 R }

qpdf --show-object="16 0 R" input.pdf
{ Toont de Pages dictionary met /Kids in leesvolgorde }
Elke pagina afzonderlijk extraheren en de bestandsgroottes vergelijken bevestigt de mapping: wat de PageArr[0] van een objectscan oplevert, is de inhoud die hoort bij logische pagina 2, en PageArr[2] bevat logische pagina 1. De circulaire verschuiving is de smoking gun. Dat verklaart ook waarom het symptoom opduikt bij veel verschillende brondocumenten: elke PDF waarbij pagina-objecten toevallig lagere objectnummers hebben dan een eerdere logische pagina, triggert het
Er is een eenvoudige reden waarom PDF's in deze staat belanden. Een incrementele update behoudt de objectnummers van de objecten die hij wijzigt, maar alles wat hij toevoegt — bijvoorbeeld een voorblad dat vooraan wordt ingevoegd — krijgt een nieuw nummer boven alles wat al in het bestand staat, terwijl zijn verwijzing naar het begin van de Kids-array gaat. Tools die documenten samenvoegen of herschikken, hernummeren objecten in welke volgorde hun dat uitkomt. Sommige generatoren schrijven pagina's gewoon in een volgorde die handig is voor content streaming in plaats van in de logische paginavolgorde. Het PDF-formaat vereist niet dat ze iets anders doen
De juiste aanpak: volg de Kids-array
Bouw de paginalijst door de /Kids-keten vanaf de catalogusroot te doorlopen, niet door indirecte objecten te scannen. De wandeling moet recursief zijn, want een groot document spreidt zijn pagina's doorgaans over tussenliggende /Pages-nodes, en hij moet waken voor een misvormde boom die terugwijst naar een van zijn eigen voorouders. In de schets hieronder staan TPdfDict en TPdfArray voor welke dictionary- en arraytypes uw parser ook gebruikt:
type
  TPageList = array of TPdfDict;

procedure CollectPages(Node: TPdfDict; var Pages: TPageList;
  Depth: Integer = 0);
var
  Kids: TPdfArray;
  Child: TPdfDict;
  I: Integer;
begin
  if Depth > 64 then  // een cyclus of een pathologisch diepe boom
    raise EPdfError.Create('Page tree too deep or cyclic');
  Kids := Node.GetArray('Kids');
  if Kids = nil then
    Exit;
  for I := 0 to Kids.Count - 1 do
  begin
    Child := Kids.ResolveDict(I);  // volg de indirecte verwijzing
    if Child = nil then
      Continue;
    if Child.GetName('Type') = 'Pages' then
      CollectPages(Child, Pages, Depth + 1)  // tussenliggende node
    else
    begin
      SetLength(Pages, Length(Pages) + 1);   // blad: volgende pagina in weergavevolgorde
      Pages[High(Pages)] := Child;
    end;
  end;
end;

// Gebruik: begin bij de /Pages-entry van de catalogus
SetLength(Pages, 0);
CollectPages(Catalog.ResolveDict('Pages'), Pages);
if Length(Pages) <> Catalog.ResolveDict('Pages').GetInteger('Count') then
  LogWarning('Page tree /Count disagrees with the pages actually found');
Twee details zijn doelbewust. Een blad zonder /Type-entry wordt nog steeds als pagina behandeld, omdat sommige schrijvers die weglaten en viewers die bestanden toch openen. En de laatste /Count-vergelijking kost niets maar vangt afgekapte of handmatig bewerkte bomen af voordat een aanroeper erin indexeert
Laadt u documenten met HotPDF, dan is deze volgorde al geregeld zodra het document laadt: pagina-indexen volgen de weergavevolgorde van de paginaboom, inclusief geneste /Pages-nodes, dus index 0 is altijd de eerste pagina die een viewer toont. De wandeling hierboven is relevant wanneer uw eigen code de PDF-structuur direct parseert
Kopiëren op logische index met CopyPageFromDocument
Omdat HotPDF de paginavolgorde bij het laden vaststelt, betekenen logische pagina-indexen wat aanroepers verwachten. De hoger gelegen CopyPageFromDocument neemt een 0-based logische index en kopieert de juiste pagina naar het bestemmingsdocument:
var
  Source, Dest: THotPDF;
begin
  Source := THotPDF.Create(nil);
  Dest   := THotPDF.Create(nil);
  try
    Source.LoadFromFile('source.pdf');

    Dest.FileName := 'extracted.pdf';
    Dest.BeginDoc;

    { Kopieer logische pagina 0 (de eerste pagina die de gebruiker ziet) }
    Dest.CopyPageFromDocument(Source, 0, 0);

    Dest.EndDoc;
  finally
    Source.Free;
    Dest.Free;
  end;
end;
Omdat de index een weergavevolgorde-index is, gedraagt CopyPageFromDocument zich correct, zelfs bij documenten waar fysieke en logische volgorde uiteenlopen. Voor batchbewerkingen accepteert InsertPagesFromDocument een array van logische indices en kopieert ze in één doorgang
Wat dit onthult over het parseren van PDF's
De PDF-specificatie is expliciet: de logische paginavolgorde wordt gedefinieerd door de /Kids-array van de paginaboom, niet door objectnummers of byte-offsets (ISO 32000-1 §7.7.3.2). Elke parser die een andere volgorde als afkorting gebruikt, zal correcte resultaten produceren bij de meerderheid van de documenten die hij ziet, omdat de meeste generatoren pagina's in de natuurlijke volgorde schrijven en sequentiële objectnummers toewijzen. De fout verbergt zich totdat iemand een PDF laadt die incrementeel is bewerkt, gereorganiseerd door een andere tool, of gegenereerd door software die een andere lay-out heeft gekozen
Testen uitsluitend met zelfgegenereerde PDF's mist deze klasse van problemen volledig. Paginavolgorde-afhandeling heeft een testcorpus van documenten uit gevarieerde bronnen nodig: incrementele opslag, gescande documenten met ingevoegde voorbladen, PDF's van tools die de objectgraaf anders lineariseren of optimaliseren. Elk document waarvan fysieke en logische volgorde uiteenlopen, verdient een vaste plek in dat corpus
De HotPDF Delphi Component-pagina behandelt de volledige API voor paginabewerkingen, inclusief CopyPageFromDocument, InsertPagesFromDocument en MovePage