Het attribuut axis="rowAxis" op een pivotField-element leest als perfect zinnige XML, en een lezer die het mapt op "rijveld" laadt de pivot met elk veld op de juiste as. Haal hetzelfde onderdeel door een validator gebouwd op het schema uit ECMA-376 Part 1 §18.10 en hij faalt op het eerste attribuut: ST_Axis heeft precies vier tokens, axisRow, axisCol, axisPage en axisValues, en rowAxis zit er niet bij. Een pivot-schrijver moet het schema naar de zin staan, niet zijn eigen lezer, want de mensen die het bestand openen gebruiken Excel en hun eigen parsers
Pivotvelddefinities staan vol regels als die. Drie glippen langs een rondgangtest heen: de enumeratietokens, de eis dat een items-element nooit leeg is, en de afsluitende subtotaalentries die Excel achter de data-items opsomt. Twee meer zitten aan de leeskant, in attributen die Excel weglaat omdat ze hun schemastandaardwaarde dragen. De rest van dit artikel doorloopt elke regel, laat zien hoe de XML eruit moet zien en toont de Delphi-aanroepen die het opleveren
Waarom een rondgang geen verkeerd axis-token vangt
Een rondgang bewijst dat de schrijver en de lezer het met elkaar eens zijn, en niets meer. Accepteert de lezer zowel axisRow als rowAxis, dan slaagt een schrijver die de verkeerde uitzendt voor elke save-then-load-controle die u maar kunt schrijven, want de lezer repareert de fout op de weg terug naar binnen. De fout komt pas boven water wanneer een strengere consument het onderdeel opent: een schemavalidator, een uit de XSD gegenereerde parser, of Excel dat beslist dat het onderdeel reparatie behoeft
HotXLS splitst de twee kanten met opzet. De XLSX-schrijver zendt alleen de vier ST_Axis-tokens uit, terwijl de pivot-lezer ook de Engels ogende spellingen rowAxis, colAxis, pageAxis en dataAxis mapt op de bijbehorende as, zodat bestanden van producenten die die gebruiken alsnog laden met hun indeling intact. Uitvoer wordt aan het schema gehouden; invoer hoeft alleen herkenbaar te zijn. Het omgekeerde, een strenge lezer gepaard met een slordige schrijver, zou ten minste luid falen in uw eigen tests; een vergevende lezer met een slordige schrijver faalt nergens zichtbaars
<!-- ongeldig: rowAxis is geen ST_Axis-waarde, en CT_Items mag niet leeg zijn -->
<pivotField axis="rowAxis" defaultSubtotal="1"><items count="0"></items></pivotField>

<!-- geldig: ST_Axis-token, echte items, afsluitend standaardsubtotaal -->
<pivotField axis="axisRow" defaultSubtotal="1">
  <items count="4"><item x="0"/><item x="1"/><item x="2" h="1"/><item t="default"/></items>
</pivotField>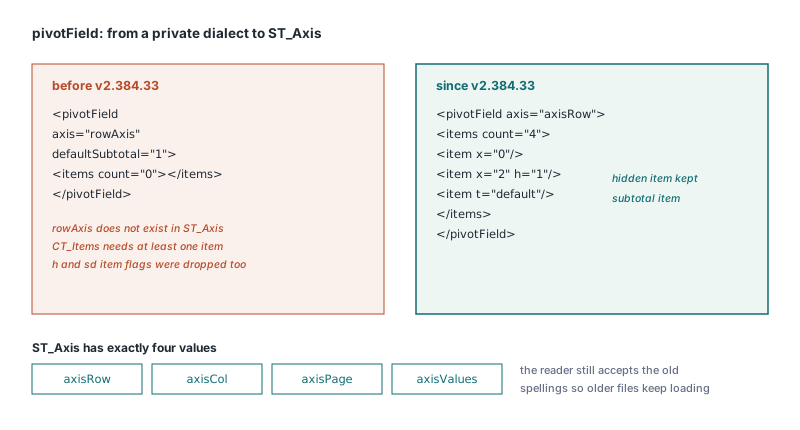
Wat CT_PivotField verder verwacht buiten de as
CT_PivotField heeft nog drie eisen die makkelijk vallen weg te laten. Een veld dat in het waardengebied wordt geaggregeerd, moet dat op zijn eigen definitie zeggen met dataField="1", ook al verwijst de <dataFields>-lijst er al naar. HotXLS zet die vlag op elk pivotveld waarnaar een entry in DataFields wijst, dus een veld dat met AddDataFieldByName is toegevoegd wordt op beide plekken gemarkeerd
De tweede regel is structureel. CT_Items eist ten minste één item-kind, wat <items count="0"></items> ongeldig maakt ook al is het welgevormde XML die overal parseert. Heeft een veld geen items, dan laat HotXLS het hele items-element weg. De derde regel gaat over toestand per item: een verborgen lid draagt h="1" en een lid met ingeklapte details draagt sd="0". Beide komen uit TXLSPivotItem.IsHidden en TXLSPivotItem.IsDetailHidden en worden bij elke opslag geschreven, dus een in code gezet filter overleeft de weg naar Excel
Achterste subtotaalitems en de count-valkuil
Heeft een veld items, dan volgt Excel de data-items op met één extra item per subtotaalfunctie, getypeerd met ST_ItemType. Het automatische subtotaal is <item t="default"/>; expliciete functies gebruiken sum, countA, avg, max, min, product, count, stdDev, stdDevP, var en varP. Deze entries dragen geen x-index naar de cache, en ze worden meegeteld in het count-attribuut van items. Een schrijver die ze achterwege laat, produceert een itemslijst die niet langer matcht met de subtotalvlaggen op hetzelfde element
HotXLS leidt de staart bij de opslag af uit TXLSPivotField.Subtotals: één t="…"-item per functie in de set, in enumeratievolgorde, bij de count opgeteld, plus het bijbehorende attribuut in de stijl van sumSubtotal="1" op het veld. Velden gemaakt door AddPivotTable beginnen met een lege set, wat defaultSubtotal="0" schrijft en helemaal geen achterste item. Laat voor gegenereerde rapporten de set leeg: subtotaalregels veranderen de hoogte van de pivot en schuiven alles wat eronder staat op. Voeg functies aan Subtotals alleen toe op de velden waar een lezer de extra regels nodig heeft
De naamgeving verdient een tweede blik voordat u een functie kiest. xlpsCount mapt op countA, dat alle niet-lege entries telt, en xlpsCountNums mapt op count, dat alleen getallen telt. Wie "count" in de XML leest en naar xlpsCount grijpt, krijgt de andere functie
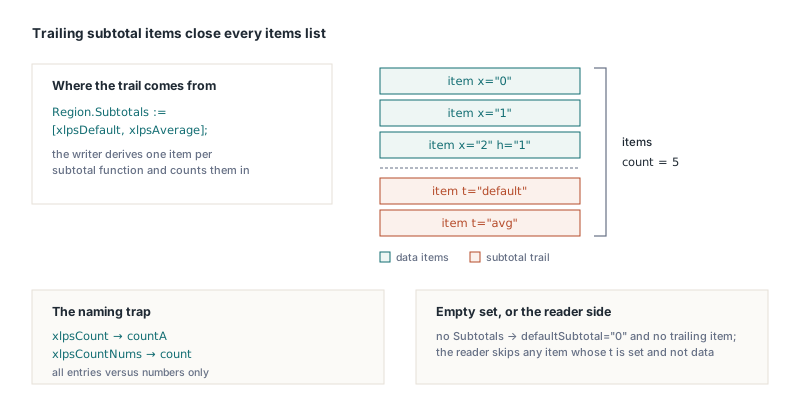
Het programma hieronder bouwt een pivot vanuit een bestaand datablad met een rijveld, een kolomveld en één waardeveld. Het veld Region krijgt het automatische subtotaal plus een gemiddelde, wat twee achterste items na zijn data-items oplevert en dataField="1" op Revenue
uses
  SysUtils, lxHandleX, lxPivot;

var
  Book  : TXLSXWorkbook;
  Sheet : TXLSXWorksheet;
  Pivot : TXLSPivotTable;
  Region: TXLSPivotField;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Open('orders.xlsx');
    Sheet := Book.Sheets[1];                  // Sheets is 1-based
    Pivot := Sheet.AddPivotTable('Data!$A$1:$D$800', 3, 6, 'RegionTotals');
    if Pivot = nil then
      raise Exception.Create('Bad source range or anchor');

    Region := Pivot.AddRowField('Region');    // nil als het veld niet bestaat
    if Region <> nil then
      Region.Subtotals := [xlpsDefault, xlpsAverage];  // -> levert t="default", t="avg" op
    Pivot.AddColumnField('Quarter');
    Pivot.AddDataFieldByName('Revenue', xlpaSum);      // Revenue krijgt dataField="1"

    Book.SaveAs('orders-pivot.xlsx');
  finally
    Book.Free;
  end;
end;
Lezen wat Excel weglaat
De lezer heeft het spiegelbeeldprobleem. Een door Excel gemaakt pivotveld somt zijn subtotaalentries op in items, en die als gewone leden inladen zou het veld fantoomitems geven die naar geen enkele cachewaarde wijzen. HotXLS slaat elke item over waarvan het t-attribuut aanwezig is en niet data is, wat subtotaal-, eindetotaal- en lege entries dekt. De subtotaalfuncties komen binnen via de eigen vlaggen van het veld en belanden in Subtotals, dus code die over Items loopt ziet alleen echte leden en elke CacheItemIndex verwijst naar een cachewaarde
Ontbrekende attributen zijn de andere helft. In het schema zijn defaultSubtotal op CT_PivotField en containsString op CT_SharedItems allebei standaard true, en Excel laat ze weg wanneer ze die waarde dragen. HotXLS leest een afwezige defaultSubtotal als true en voegt xlpsDefault toe aan Subtotals wanneer het veld geen expliciete subtotalvlaggen draagt, precies hoe Excel zelf zo'n veld toont. Een afwezige containsString leest ook als true, dus een kale tekstcacheveld wordt als stringdata geclassificeerd. Leest u een van beide attributen als false, dan verliest elke door Excel opgeslagen pivot zijn automatische subtotalen bij het laden, terwijl tekstvelden in een ander type veranderen. Een schrijver die elk attribuut altijd uitspelt raakt dit pad nooit aan; alleen bestanden van een andere producent oefenen het uit
Een door Excel geladen werkmap is hier de juiste testinvoer, want het is de enige soort bestand die die attributen achterwege laat. De controle hieronder opent er een en loopt een rijveld af:
var
  Book : TXLSXWorkbook;
  Pivot: TXLSPivotTable;
  Fld  : TXLSPivotField;
  I, J : Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Open('saved-by-excel.xlsx');
    Pivot := Book.Sheets[1].PivotTables.FindByName('PivotTable1');
    if Pivot = nil then
      Exit;
    for I := 0 to Pivot.FieldCount - 1 do
    begin
      Fld := Pivot.Fields[I];
      if Fld.Axis <> xlpfaRowField then
        Continue;
      // Een Excel-veld zonder subtotalattributen meldt nog steeds de standaard
      if xlpsDefault in Fld.Subtotals then
        Writeln(Fld.Name, ': automatic subtotal');
      // Subtotaleentries zijn overgeslagen, dus elke item mapt op een cachewaarde
      for J := 0 to Fld.ItemCount - 1 do
        Assert(Fld.Items[J].CacheItemIndex >= 0);  // controle die we suggereren voor uw eigen tests
    end;
  finally
    Book.Free;
  end;
end;
Waarom numFmtId="General" ongeldig is op cachefields
numFmtId="General" is ongeldig omdat ST_NumFmtId een unsigned integer is, hoe natuurlijk het ook voelt om de naam te lenen die gebruikers in het dialoogvenster Celeigenschappen zien. Een parser die attributen vanuit het schema typeert, verwerpt de naam ronduit, en precies die klasse fouten verandert in een reparatiedialoog in Excel; het artikel over de OPC- en markupregels achter de Excel-reparatieprompt behandelt hoe die dialogen worden getriggerd. HotXLS schrijft elke cacheField met een numerieke numFmtId genomen uit de NumberFormat van het cachefeld, die 0 is, het ingebouwde General-formaat, tenzij er iets anders is gezet
Pivottabellen onder rij 65535 hebben 32-bit posities nodig
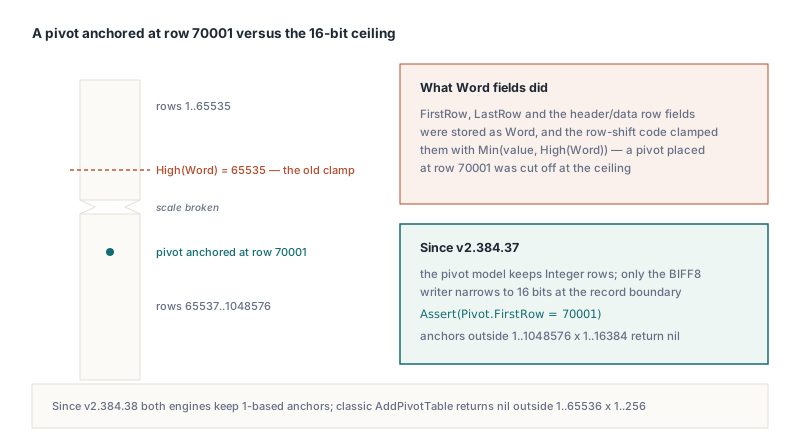
Een pivotmodel gedeeld door de XLS- en XLSX-engines wordt verleid om zijn veldbreedtes te lenen van het BIFF8 SxView-record, waar 16 bits elke rij dekken die een klassiek blad kan bevatten. Een XLSX-blad loopt tot 1.048.576 rijen. Sla FirstRow, LastRow, FirstHeaderRow, FirstDataRow en de kolom-tegenhangers op als Word, klem ze met Min(Value, High(Word)), en een pivot verankerd op rij 70001 wordt afgekapt op 65535
Op TXLSPivotTable zijn die properties Integer, en alleen de BIFF8-schrijver versmalt ze aan de recordgrens. TXLSXWorksheet.AddPivotTable geeft nil terug voor een anker buiten 1..1048576 bij 1..16384, en AddPivotTableCopy geeft nil terug wanneer de omvang van de kopie van het grid zou lopen
var
  Book, Check: TXLSXWorkbook;
  Pivot      : TXLSPivotTable;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Open('orders.xlsx');
    // Rij 70001 ligt voorbij het 16-bit bereik
    Pivot := Book.Sheets[1].AddPivotTable('Data!$A$1:$D$800', 70001, 1, 'LateTotals');
    if Pivot = nil then
      Exit;  // anker buiten het werkblad of onoplosbaar bronbereik
    Pivot.AddRowField('Region');
    Pivot.AddDataFieldByName('Revenue', xlpaSum);
    Book.SaveAs('late.xlsx');
  finally
    Book.Free;
  end;

  Check := TXLSXWorkbook.Create;
  try
    Check.Open('late.xlsx');
    Pivot := Check.Sheets[1].PivotTables.FindByName('LateTotals');
    // Assert is een controle die we suggereren voor uw eigen tests
    Assert((Pivot <> nil) and (Pivot.FirstRow = 70001));
  finally
    Check.Free;
  end;
end;
De klassieke XLS-engine volgt dezelfde 1-based conventie. De records SxView en DConRef slaan 0-based waarden op, terwijl het model, net als de XLSX-engine en Cells[Row, Col], 1-based posities aanhoudt: de BIFF8-lezer telt er 1 bij op en de schrijver haalt er 1 af aan de recordgrens. De klassieke AddPivotTable geeft nil terug voor een anker buiten 1..65536 bij 1..256, dus veranker pivots op (1, 1) in plaats van (0, 0). De recordindeling zelf wordt beschreven in de BIFF8 SX-records achter klassieke .xls-pivottabellen
Tegen het schema testen in plaats van uw eigen lezer
Elke valkuil hierboven overleeft een rondgang wanneer de vergevende kant en de foutieve kant in dezelfde bibliotheek wonen. Drie soorten controles vangen ze. Een schemavalidatie van de gegenereerde onderdelen pivotTableN.xml en pivotCacheDefinitionN.xml vangt verzonnen tokens, lege items-elementen en benoemde formaat-ids. Door Excel opgeslagen bestanden door uw eigen lezer halen oefent de attributen die Excel op hun standaardwaarde weglaat. Asserties die het exacte token in de geschreven XML vastpinnen, zoals axis="axisRow", vangen een schrijver die afdrijft naar een spelling die alleen uw lezer begrijpt; asserten op de geparseerde as kan dat niet
Pivots gebouwd via de API, inclusief de berekende velden, berekende items en percent-van-totaal-indelingen uit XLSX-pivottabellen bouwen en verversen met berekende velden, komen naar buiten met deze regels toegepast en zonder extra code aan uw kant. Het werk dat voor u overblijft is kiezen welke velden subtotalen krijgen en welke count-functie u bedoelt
De HotXLS Delphi spreadsheet component bouwt, leest en slaat XLS- en XLSX-pivottabellen op vanuit Delphi- en C++Builder-code, zonder Excel-installatie of COM-automatisering op de machine die hem draait