Excel toont "We found a problem with some content" op een XLSX die LibreOffice en elke eigen lezer zonder mopperen openen, omdat Excel twee dingen afdwingt die die lezers negeren: schemavereiste attributen en de uniciteitsregels van de Open Packaging Conventions. Drie van die regels zijn makkelijk te breken in elke writer die gegenereerde onderdelen combineert met bewaarde: een <phoneticPr> heeft zijn fontId nodig, elke onderdeelnaam krijgt exact één Override in [Content_Types].xml, en twee root-relaties mogen nooit een identifier delen zoals rId4. Dit artikel doorloopt elk ervan en hoe HotXLS, de native Excel-spreadsheetcomponent voor Delphi en C++Builder, het pakket schrijft om eraan te voldoen
Waarom weigert Excel een pakket dat elke andere lezer accepteert?
Omdat de reparatieprompt een schema- en pakketvalidator is, geen parserfout. Een workbook kan via je eigen bibliotheek, via LibreOffice en via XML-validators rondreizen en structureel gezond zijn in de OPC-zin die het artikel over XLSX OPC-relationship-resolutie gebruikt: elk onderdeel bereikbaar, elk doel oplosbaar. Open hem via Workbooks.Open in een geïsoleerde COM-instantie met DisplayAlerts uit en de aanroep kan nog steeds keihard mislukken. Interactief geeft hetzelfde bestand het bekende venster met het aanbod te repareren, en het reparatielogboek, als Excel er de moeite voor neemt er één te schrijven, noemt het onderdeel maar niet de regel. Verschillende onafhankelijke overtredingen kunnen achter die ene prompt schuilen, en Excel meldt ze niet één voor één; hij weigert het workbook en jij mag de onderdelen maar vinden en analyseren. Hieronder volgt elke regel, de natuurlijke manier om haar te overtreden en hoe HotXLS het pakket in plaats daarvan schrijft, want elk ervan is een regel waar elke Delphi-XLSX-writer over kan struikelen
Regel 1: phoneticPr fontId is verplicht, ook als hij nul is
Het element <phoneticPr> draagt een fontId-attribuut dat in ECMA-376 Part 1 §18.4.3 als use="required" is gedeclareerd, en de waarde 0 is een legale fontindex, geen afwezigheid. Een writer die nul als "niet gezet" behandelt en het attribuut alleen uitschrijft als Sheet.PhoneticFontId > 0 volgt een natuurlijke Delphi-reflex, want integer-velden defaulten op nul, maar hij produceert <phoneticPr type="noConversion"/> voor elk workbook wiens phonetic-font toevallig het eerste font in styles.xml is, en dat is makkelijk te raken want index 0 is simpelweg het eerste font. Excel weigert dan bij het teruglezen een waarde die hij zelf heeft geschreven
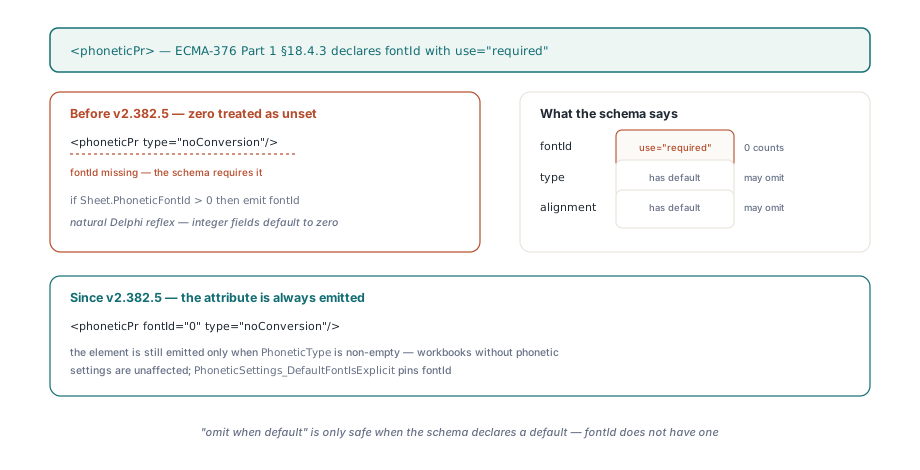
// De natuurlijke reflex: nul geldt als niet-ingesteld, fontId valt weg
phoneticXml:= '<phoneticPr';
if Sheet.PhoneticFontId > 0 then
  phoneticXml:= phoneticXml+ ' fontId="'+ IntToStr(Sheet.PhoneticFontId)+ '"';

// lxHandleX.pas, worksheet writer — het attribuut is verplicht, ook nul
phoneticXml:= '<phoneticPr fontId="'+ IntToStr(Sheet.PhoneticFontId)+ '"';
phoneticXml:= phoneticXml+ ' type="'+ XlsxEscapeAttr(Sheet.PhoneticType)+ '"';
if Sheet.PhoneticAlignment<> '' then
  phoneticXml:= phoneticXml+ ' alignment="'+ XlsxEscapeAttr(Sheet.PhoneticAlignment)+ '"';
HotXLS schrijft het element alleen als TXLSXWorksheet.PhoneticType niet leeg is, dus workbooks die nooit phonetic-instellingen hadden blijven ongemoeid. Zet PhoneticFontId op nul op een vers blad, sla op, en xl/worksheets/sheet1.xml draagt <phoneticPr fontId="0". De ruimere les: "weglaten bij default" is alleen veilig als het schema een default declareert; type en alignment hebben defaults in dat element, fontId niet
Regel 2: één Override per onderdeelnaam in [Content_Types].xml
De content-types-stream mag elke onderdeelnaam hooguit één keer declareren, en Excel behandelt een tweede Override voor dezelfde PartName als corruptie, zelfs als beide entries dezelfde ContentType dragen. HotXLS heeft twee writers die die stream voeden. BuildContentTypesXml declareert elk onderdeel dat het objectmodel genereert: workbook, styles, shared strings, theme, worksheets en, als TXLSXWorkbook.CustomProperties.Count > 0, /docProps/custom.xml. Als PreserveUnsupportedParts aan staat, voegt TXLSXOpaquePackage daarna voor elk onderdeel dat hij letterlijk uit het bronpakket heeft gevangen een Override toe, zodat die bytes op de terugweg gedeclareerd blijven. De botsing is een onderdeel dat aan beide kanten leeft. Custom document properties worden in het model geparseerd, maar de docProps/custom.xml van het bronpakket wordt ook opaak gevangen, dus een naïeve merge declareert hem twee keer, en chart- en pivot-cache-onderdelen kunnen op dezelfde plek belanden als het model een onderdeel regenereert dat de opaaklaag ook heeft vastgehouden. Een opaak writer zonder zicht op wat het model al heeft geschreven kan het niet weten, en daarom krijgt ContentTypeOverridesXml dat zicht
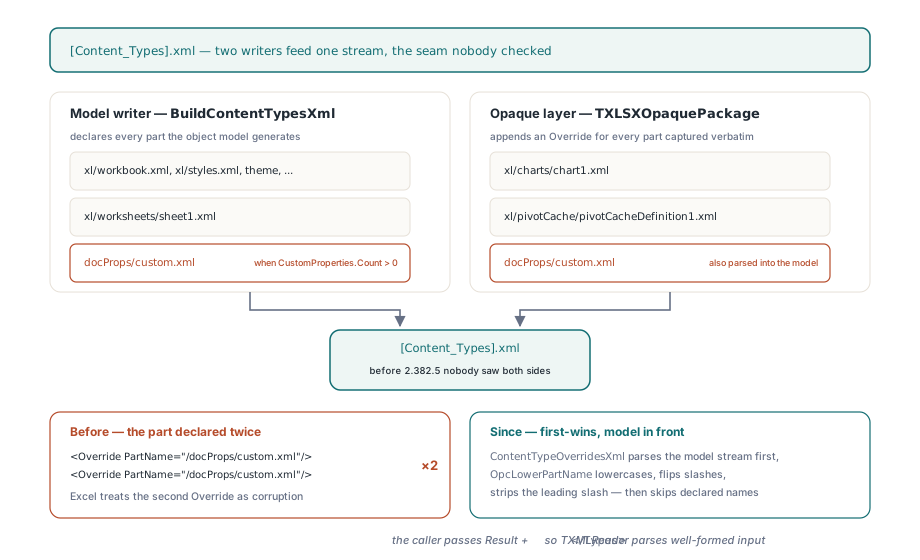
<!-- Wat een naïeve merge oplevert -->
<Override PartName="/docProps/custom.xml"
    ContentType="application/vnd.openxmlformats-officedocument.custom-properties+xml"/>
...
<Override PartName="/docProps/custom.xml"
    ContentType="application/vnd.openxmlformats-officedocument.custom-properties+xml"/>
HotXLS geeft de gegenereerde XML aan ContentTypeOverridesXml en laat de opaak writer hem parsen voordat hij iets uitschrijft. Twee details dragen de correctheid. OpcLowerPartName lowercased, zet backslashes om naar forward slashes en schuurt voorloopslashes eraf vóór de vergelijking, want OPC-onderdeelnamen worden case-insensitief vergeleken en het model schrijft ze met een voorloopslash terwijl de opaaklaag ZIP-itemnamen zonder bewaart. En de aanroeper in BuildContentTypesXml geeft Result + '</Types>' mee, waarmee het half afgebouwde document wordt gesloten zodat TXMLReader goed gevormde invoer ziet in plaats van een afgekapte stream. De regel die overblijft is first-wins met het model vooraan: wat het objectmodel declareert is leidend, en de opaak-replay vult alleen gaten
// lxOpcPackage.pas — TXLSXOpaquePackage.ContentTypeOverridesXml
function TXLSXOpaquePackage.ContentTypeOverridesXml(const ExistingXml: WideString): WideString;
begin
  ...
  UsedNames.Sorted:= True;
  UsedNames.Duplicates:= dupIgnore;
  if ExistingXml<> '' then
    // Parse de door het model gegenereerde stream en verzamel elke gedeclareerde PartName.
    while Reader.Read do
      if (Reader.NodeType= xmlntElement)and (Reader.Name= 'Override') then
      begin
        Index:= Reader.AttributeIndex('PartName');
        if Index>= 0 then
          UsedNames.Add(String(OpcLowerPartName(Reader.Attribute[Index].Value)));
      end;
  for i:= 0 to FParts.Count- 1 do
  begin
    Part:= TXLSXOpaquePart(FParts[i]);
    if (Part.ContentType= '')or (LowerCase(ExtractFileExt(String(Part.PartName)))= '.rels')or
      (UsedNames.IndexOf(String(OpcLowerPartName(Part.PartName)))>= 0) then
      Continue;                       // al gedeclareerd, of een rels-onderdeel
    UsedNames.Add(String(OpcLowerPartName(Part.PartName)));
    Result:= Result+ '<Override PartName="/'+ OpcXmlEscapeAttribute(Part.PartName)+
      '" ContentType="'+ OpcXmlEscapeAttribute(Part.ContentType)+ '"/>';
  end;
end;
Regel 3: relatie-Id's zijn uniek binnen een relatieonderdeel
Elke Relationship in een .rels-onderdeel heeft een Id nodig die uniek is binnen dat onderdeel, en Excel weigert het pakket als er twee delen. HotXLS schrijft de _rels/.rels op pakketniveau met vaste identifiers: rId1 voor het workbook, rId2 en rId3 voor core- en extended document properties, en rId4 voor custom properties als het model die heeft. De opaak-pakketlaag plakt daarna alle root-relaties die hij uit de bron heeft vastgehouden erachter, en nummert elke identifier die al in een UsedIds-lijst staat om. Als die lijst alleen rId1 tot en met rId3 kent, en niet dat het model op het punt staat zijn eigen custom-properties-relatie te schrijven, komt een bronpakket wiens custom-properties-relatie ook rId4 is — wat Excel standaard schrijft — uit met twee rId4-entries naar hetzelfde doel. RootRelationshipsXml reserveert daarom rId4 en slaat de bronkopie over zodra het model custom properties schrijft. De aanroeper, BuildRootRelsXml, geeft Workbook.FCustomProps.Count > 0 als tweede argument mee, zodat de reservering en de oversprongen kopie door dezelfde voorwaarde worden gestuurd die bepaalt of het model rId4 überhaupt schrijft. Hernummeren is veilig aan de pakketwortel, want niets in het workbook verwijst op naam naar root-relatie-identifiers; dezelfde truc zou één niveau lager verkeerd zijn, waar r:id-attributen in workbook.xml binden aan identifiers in het workbook-relations-onderdeel, en daarom houdt MergeWorkbookRelationshipsXml een aparte identifierkaart bij
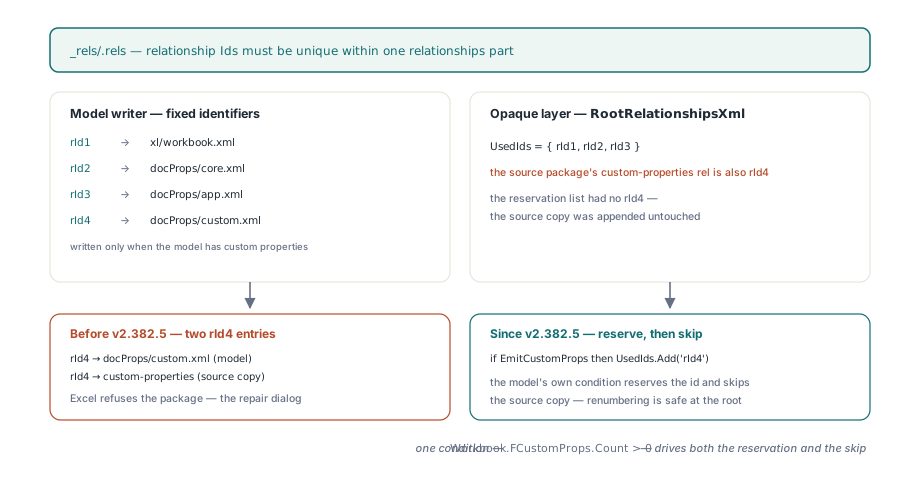
// lxOpcPackage.pas — TXLSXOpaquePackage.RootRelationshipsXml
UsedIds.CaseSensitive:= False;
UsedIds.Add('rId1');
if EmitCustomProps then UsedIds.Add('rId4');   // gereserveerd door de model-writer
if EmitDocProps then
begin
  UsedIds.Add('rId2');
  UsedIds.Add('rId3');
end;
for i:= 0 to FRootRelationships.Count- 1 do
begin
  Rel:= TXLSXOpaqueRelationship(FRootRelationships[i]);
  // Het model bezit de custom properties; speel de bronkopie niet af.
  if EmitCustomProps and OpcEndsWith(LowerCase(Rel.RelType), '/custom-properties') then
    Continue;
  Id:= Rel.Id;
  if (Id= '')or (UsedIds.IndexOf(String(Id))>= 0) then
    Id:= AllocateRelationshipId(UsedIds);      // laagste vrije rIdN
  UsedIds.Add(String(Id));
  ...
end;
Wat hebben de drie regels gemeen?
Alle drie bewaken ze tegen een writer met twee bronnen en geen enkele eigenaar van de pakketinvarianten. Het objectmodel genereert de onderdelen die het begrijpt; de opaaklaag speelt de onderdelen af die het niet begrijpt, zodat een rondreis grafieken, pivot-caches, custom XML en alles anders bewaart wat staat in de notities bij verliesvrije rondreis van theme, extLst en calcChain. Elke kant kan op zichzelf consistent zijn. De eisen die OPC aan het hele pakket stelt, unieke Override-onderdeelnamen en unieke relatie-identifiers per onderdeel, bestaan alleen op de naad waar de twee worden samengevoegd, dus iemand moet die naad bezitten. De fontId-regel heeft één niveau lager dezelfde vorm: een writer kan weten wat hij wil weglaten en de schema's die zeggen dat het niet mag nooit raadplegen. HotXLS beslecht dit met een vaste prioriteit in plaats van een merge-heuristiek. Het model schrijft eerst, en de opaaklaag ziet wat er is geschreven en wijkt bij elke botsing. De invarianten zijn ook goedkoop van buitenaf te controleren: lees [Content_Types].xml en elk .rels-item in een opgeslagen pakket en faal op elke dubbele PartName, Extension of Id. Die controle heeft geen Excel nodig en dekt de twee uniciteitsregels; voor de fontId-regel is nog steeds een schemavalidator nodig
Print areas die formules zijn, geen ranges
Het printgebied is het andere dat Excel op een opgeslagen kopie vergelijkt: een template wiens _xlnm.Print_Area Excel meldt als $A$1:$J$29 moet na een rondreis identiek meldbaar zijn. Daarachter zitten twee valkuilen. Bij import maakt een prefix-strip die alles tot de eerste ongequote ! afknipt van een dynamisch printgebied zoals OFFSET('Print Data'!$A$1,0,0,2,2) de rommel $A$1,0,0,2,2), en laat bij een gekwalificeerde unie zoals 'Print Data'!$A$1:$B$2,'Print Data'!$D$1:$E$2 alleen het eerste segment zijn prefix verliezen. Bij export geeft het één keer toevoegen van de bladnaam aan de hele opgeslagen PrintArea een kale unie $A$1:$B$2,$D$1:$E$2 een gekwalificeerd eerste segment en een naakt tweede, en dat accepteert Excel niet als _xlnm.Print_Area-definitie onder ECMA-376 Part 1 §18.2.5
// Import: strip de prefix alleen als wat overblijft een gewone sqref is
function XlsxPrintAreaFromDefinition(const Formula: WideString): WideString;
begin
  Result:= Formula;
  if not XlsxReadFormulaSheetPrefixAt(Formula, 1, Prefix, SheetPart, Start) then
    Exit;
  Area:= Copy(Formula, Start, Length(Formula));
  if XlsxParseSqrefPart(Area, R1, C1, R2, C2) then
    Result:= Area;                    // 'Sheet'!$A$1:$J$29 -> $A$1:$J$29
end;                                  // OFFSET(...) komt er onaangeroerd uit

// Export: kwalificeer elk door komma gescheiden segment, of geen ervan
function XlsxPrintAreaDefinition(const SheetName, Area: WideString): WideString;
begin
  Result:= Area;
  ... split Area on ',' with StrictDelimiter ...
  for I:= 0 to Parts.Count- 1 do
    if not XlsxParseSqrefPart(WideString(Trim(Parts[I])), R1, C1, R2, C2) then
      Exit;                           // een formule: woordelijk uitschrijven
  Result:= '';
  for I:= 0 to Parts.Count- 1 do
  begin
    if I> 0 then Result:= Result+ ',';
    Result:= Result+ XlsxQuoteSheetName(SheetName)+ '!'+ WideString(Trim(Parts[I]));
  end;
end;
De koppelingsregel is aan beide kanten dezelfde: een printgebied is alleen een kale range als elk segment als zodanig parseert, anders is het een formule en reist hij letterlijk mee. Met die regel overleven de genoemde basis, de bladgekwalificeerde basis en de unie herhaalde opslaan-en-heropen-cycli. Hoe printgebieden samengaan met pagina-instelling en de rest van het afdrukmodel staat in het artikel over bladbeveiliging, pagina-instelling en afdrukken
Hoe vind je tegen welke regel Excel bezwaar maakt?
Vertrek vanuit de aanname dat je eigen validator ongelijk heeft, want hij is geslaagd. De Open XML SDK-validator benoemt een schemaovertreding zoals de ontbrekende fontId met onderdeel en XPath, en de verpakingslaag eronder weigert een pakket met dubbele content-type-entries helemaal niet te openen, dus draai hem eerst. Als hij zwijgt en Excel toch repareert, bisecteer het pakket: unzip, verwijder een onderdeel met zijn relatie en zijn Override, zip opnieuw en open weer, telkens de kandidatenlijst helfend tot de prompt verdwijnt. De drie overtredingen hierboven komen in die volgorde naar boven, en geen enkele zou zichtbaar zijn in het gerepareerde bestand dat Excel aanbiedt op te slaan, want de reparatie wist of hernummert de overtredende entries stilletjes. Twee ontwerpkeuzes in de HotXLS-writer zijn goed om te weten. De ontdubbeling is first-wins met het model vooraan, dus als het bronpakket een andere content type declareerde voor een onderdeel dat het model ook genereert, wint de declaratie van het model en valt die van de bron weg, wat klopt voor de onderdelen die HotXLS regenereert en geen algemene merge is. En de extra TXMLReader-pas over de gegenereerde content-types-stream draait bij elke opslag met PreserveUnsupportedParts aan, een kleine kost tegenover een stream die zelden groter is dan een paar kilobytes. Met deze regels op plaats opent een leningtemplate met 4805 formules, opgeslagen door zowel de Win32- als de Win64-build, zonder prompt in Excel, herberekent met nul mismatches en meldt hetzelfde printgebied als het origineel
Als je zelf XLSX schrijft vanuit Delphi, is de checklist kort: schrijf elk attribuut uit dat het schema als verplicht markeert, ongeacht zijn waarde, declareer elke onderdeelnaam één keer, en houd één lijst met gebruikte identifiers per relatieonderdeel bij over elke schrijver die eraan raakt. Als je liever hebt dat die lijst al bestaat en tegen Excel is getest in plaats van alleen tegen je eigen lezer, dan wordt de pakketschrijver die hier beschreven staat meegeleverd in de HotXLS Delphi spreadsheet component, samen met de opaque-onderdeel-round-trip die de naad überhaupt het bewaken waard maakte