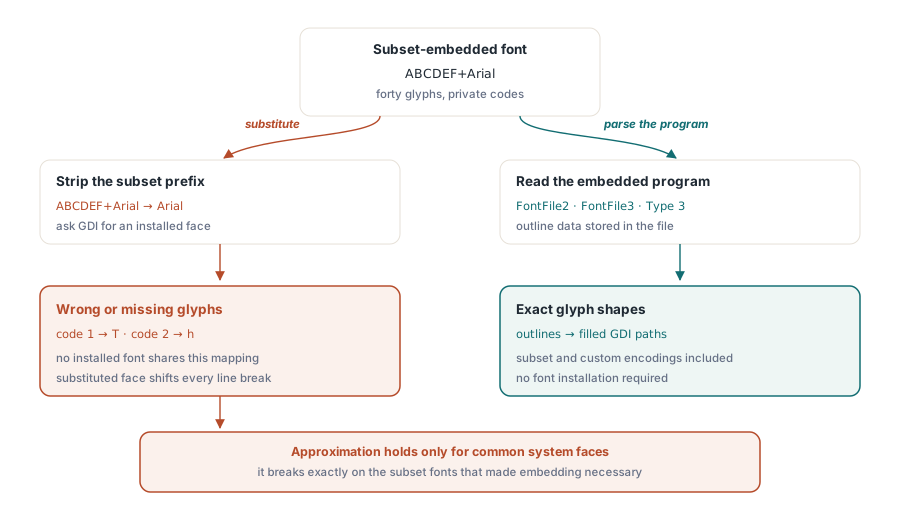
Een thumbnailstrip voor een batch leveranciersfacturen oogt in één oogopslag goed: tabellijntjes op hun plek, logo scherp, kolommen uitgelijnd. Zoom erop in en de klantnaam is een rij holle hokjes, terwijl de totalenkolom letters bevat die niets spellen. Elke kapotte factuur gebruikt hetzelfde font, ABCDEF+Arial, en elk van die facturen leest prima in een desktop-PDF-viewer op dezelfde machine. De thumbnailcode nam de fontnaam, gooide de zesletterige subset-tag weg, vroeg Windows om Arial en gaf hem de rauwe karaktercodes van de pagina. Die codes waren nooit die van Arial. Een getrouw bitmap uit een PDF-pagina halen vraagt twee dingen: de contentstream van de pagina uitvoeren als programma, en tekst tekenen uit de glyph-contouren die in het bestand staan in plaats van uit welke fonts de rendermachine toevallig geïnstalleerd heeft
Een PDF-pagina is iets dat je uitvoert
ISO 32000-1 §8 beschrijft een pagina als een contentstream: operatoren die de transformatiematrix wijzigen met cm, graphics state opslaan en herstellen met q en Q, pads bouwen, fonts selecteren met Tf, glyphs plaatsen met Tj en afbeeldingen en forms schilderen met Do. Nergens in het bestand staat hoe één pixel eruitziet. Om aan een bitmap te komen, moet iets die stream uitvoeren tegen een actuele transformatiematrix, een state-stack, een clip-pad en een paar vul- en lijnkleurruimten, en daarna rasteriseren wat eruit komt
HotPDF's RenderLoadedPageToBitmap is die interpreter. Hij loopt de operatoren van een geladen pagina af, houdt de matrix en graphics state zoals de specificatie ze definieert, lost kleurruimten op, zet PDF-pads om in GDI-pads en haalt glyph-stappen uit de /Widths-array van het font in plaats van uit GDI. Image XObjects gaan door dezelfde decoders die de bibliotheek voor extractie gebruikt, dus elk beeldfilter dat HotPDF voor extractie kan decoderen, JPXDecode-gecomprimeerde JPEG 2000-afbeeldingen incluis, duikt ook op in de gerenderde pagina
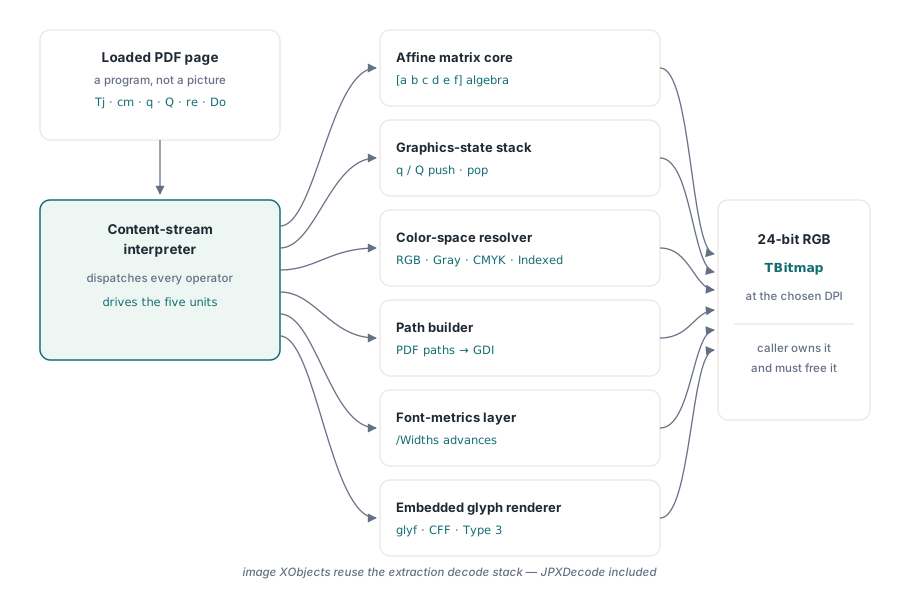
Een geladen pagina renderen naar een TBitmap in Delphi
THotPDF.RenderLoadedPageToBitmap(PageIndex, DPI) neemt een nulgebaseerde pagina-index en een resolutie in dots per inch, waarbij 72 DPI één PDF-unit op één pixel mapt, en geeft een nieuwe 24-bits RGB-TBitmap terug. Een index buiten bereik of een pagina die niet gebouwd kan worden geeft nil terug in plaats van te gooien. Dat past bij een viewer, die één beschadigde pagina moet kunnen overslaan en met de rest verder moet. De bitmap is eigendom van de aanroeper
var
  Pdf: THotPDF;
  Bmp: TBitmap;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('report.pdf') > 0 then
    begin
      Bmp := Pdf.RenderLoadedPageToBitmap(0, 144);  // pagina 1 op 144 DPI
      if Bmp <> nil then
      try
        Image1.Picture.Assign(Bmp);
      finally
        Bmp.Free;  // aanroeper is eigenaar van de bitmap
      end;
    end;
  finally
    Pdf.Free;
  end;
end;
Pixelformaten volgen uit het zichtbare gebied van de pagina. De renderer neemt /CropBox geknipt op /MediaBox, zoals ISO 32000-1 §14.11.2 het zichtbare gebied definieert, gebruikt /MediaBox als er geen bruikbare crop box is, schaalt met DPI/72 en rundt naar boven af. Een US Letter-pagina zonder aparte crop box komt daarom exact als 612×792 pixels terug op 72 DPI. Een A4-pagina (595,28×841,89 punten) op 96 DPI komt uit op 794×1123, want 793,7 en 1122,5 worden beide naar boven afgerond. Een /Rotate van 90 of 270 wisselt breedte en hoogte, en de flip van PDF's oorsprong linksonder naar GDI's bovenaan gebeurt binnen de paginamatrix, dus het beeld komt rechtop binnen zonder nabewerking
DPI is de enige schaalknop, en hij dekt de gewone klussen. Thumbnails op 36 of 48 DPI zijn klein en snel. Eén schermpreview op 96 of 144 DPI past bij typische schermdichtheid. Export op 300 DPI geeft output van printkwaliteit, tegen de prijs van een bitmap van 2550×3300 per Letter-pagina, ruwweg 24 MiB per stuk bij drie bytes per pixel
Waarom tekenen gesubstitueerde fonts de verkeerde glyphs?
Verkeerde glyphs in een gerenderde PDF betekenen bijna altijd dat de rasterizer een geïnstalleerd font heeft ingewisseld voor het font dat in het bestand zit. De afkorting uit het factuurvoorbeeld is verleidelijk omdat hij vaak werkt: strip het subset-prefix van /BaseFont, vraag een GDI-font op de resterende naam aan en teken de string. Voor gewone Arial- of Times New Roman-tekst met standaardencoding klaagt niemand
Subsetfonts breken hem als eerste. Een subset kan alleen de veertig glyphs bevatten die een document gebruikt, genummerd in een volgorde die privé is voor dat bestand, dus code 1 kan "T" zijn en code 2 "h". Een geïnstalleerd font kan dat niet weten. Eigen encodings, symbool- en barcodefonts, en elk lettertype dat op de rendermachine ontbreekt falen om dezelfde reden. En zelfs als de vervanger elk karakter heeft, wijken zijn stapbreedtes af van het ingebedde font, dus lijnen groeien of krimpen en rechts uitgelijnde kolommen komen niet meer uit
Tekst tekenen uit het ingebedde fontprogramma
HotPDF tekent tekst uit de fontprogramma's die in de PDF staan. Als een font een ingebed TrueType-programma (/FontFile2) of een CFF-programma (/FontFile3) meedraagt, wordt elke glyph uit die data voorzien van een contour en gevuld als GDI-pad, met fontgrootte, tekstmatrix en actuele transformatiematrix samengesteld tot één transformatie. Subsetfonts, privé-encodings en fonts die de machine nooit heeft gezien komen eruit met hun echte vormen. Hoe een karaktercode bij een glyph komt hangt af van het fonttype, en elk type heeft zijn eigen valkuil:
- TrueType-outlines: contouren komen uit de tabellen
glyfenloca. Kwadratische segmenten worden verheven tot de kubische Béziers die GDI tekent, wat een exacte omzetting is, het geïmpliceerde on-curve-punt tussen twee opeenvolgende off-curve-punten wordt gereconstrueerd, en samengestelde glyphs duiken recursief in hun componenten met de transformatie van elke component toegepast - CID-keyed TrueType:
Type0-fonts bovenCIDFontType2bereiken glyph-ID's via/CIDToGIDMap, ofwelIdentity(ook de standaard als de entry ontbreekt) of een expliciete map-stream, en nemen stappen uit/Wen/DW, zodat twee-byteIdentity-H-tekst over de juiste afstand stapt. Voorgedefinieerde CJK-CMaps en ingebedde CMap-streams decoderen code met variabele lengte vóór de lookup - CFF-programma's:
Type1C,CIDFontType0Cen CFF in een OpenType-container draaien door een Type 2-charstring-interpreter die lijnen, curven, de flex-familie, hint-masken en lokale en globale subroutine-aanroepen aan kan, met de subroutine-bias toegepast. CID-keyed programma's mappen elke code via de charset van het font, wat telt voor subsets waarvan de glyph-volgorde verschilt van de CID-volgorde, en kiezen de privé-dictionary per glyph viaFDArrayenFDSelect - Simpele TrueType-fonts: één-byte-codes gaan door de ingebedde
cmap, eerst de Unicode-subtabellen (3,1) en (3,10) proberend, dan de (3,0)-symboolsubtabel, zowel direct als op de U+F000-spiegel die symboolfonts gebruiken, en dan de oude Macintosh (1,0)-tabel
Twee regels liggen daar bovenop. De /Encoding-dictionary van een simpel font wordt opgelost in de volgorde die ISO 32000-1 §9.6.6 voorschrijft: /Differences overschrijft de base encoding, die de ingebouwde mapping van het programma overschrijft. TeX en andere PostScript-afstammende toolchains leunen hier zwaar op, dus de volgorde verkeerd hebben verhaspelt precies de wiskunde- en symbooltekst waar een verkeerde glyph het lastigst te zien is. Type3-fonts, waarvan de glyphs kleine contentstreams op zichzelf zijn, worden nagespeeld door dezelfde interpreter met fontmatrix, fontgrootte en tekstmatrix samengesteld; glyph-ruimte /Widths gaan door /FontMatrix zoals §9.6.5 voorschrijft, en een glyphprocedure die een d1-bounding box declareert wordt daarop afgeknipt, zodat een misvormde barcodeglyph niet buiten zijn cel kan schilderen
Als één enkele code niet gemapt kan worden, omdat het programma beschadigd is of de subset die glyph mist, wordt dat ene karakter getekend met het geïnstalleerde font van dezelfde naam en gebruikt de rest van de run nog steeds de ingebedde contouren. De hele run laten vallen zou het probleem verbergen; één vreemde letter valt makkelijker op. Fonts zonder bruikbaar ingebed programma volgen de route van geïnstalleerde fonts zoals beschreven in niet-ingebedde fonts renderen met systeemfonts
Hoe houdt u herhaalde renders snel?
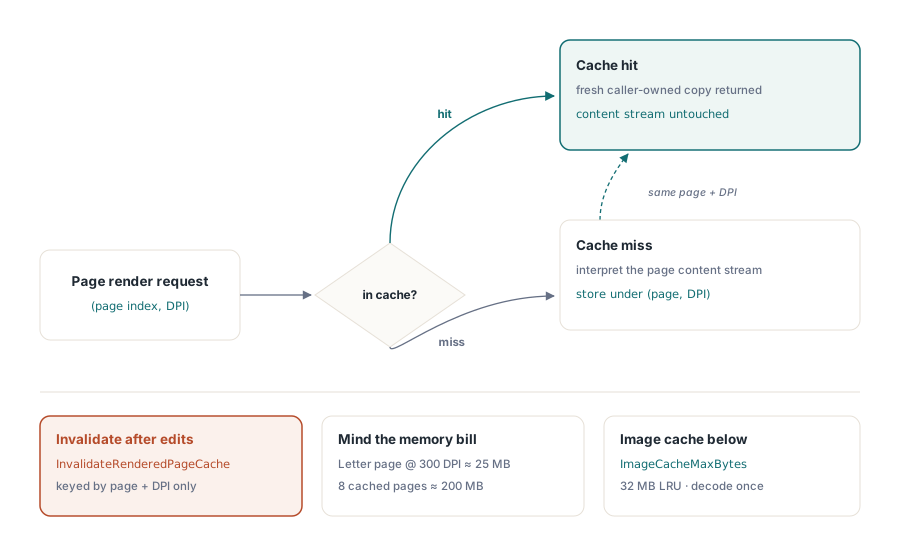
Voor alles interactiefs, roep RenderLoadedPageToBitmapCached aan in plaats van de kale methode. Hij houdt recentelijk gerenderde pagina's bij in een most-recently-used-cache met als sleutel pagina-index, DPI en de actuele renderinstellingen (kleurintent, overprint-preview, fallbackbeleid en welke optional content-lagen zichtbaar zijn), en een hit geeft een verse kopie voor de aanroeper terug zonder de contentstream opnieuw te interpreteren. Wisselen tussen twee pagina's, of een resize die dezelfde pagina op dezelfde DPI opnieuw vraagt, raakt elke keer de cache. Voor een eenmalige export die elke pagina één keer bezoekt is de kale RenderLoadedPageToBitmap de betere keus, want de gecachte variant kopieert elke bitmap die hij teruggeeft en zou pagina's vasthouden die niemand nog eens vraagt
// Thumbnailstrip: de eerste passage rendert, terugscrollen raakt de cache
Pdf.RenderCacheCapacity := 32;   // entrylimiet; standaard is 8
for I := 0 to Pdf.LoadedPageCount - 1 do
begin
  Bmp := Pdf.RenderLoadedPageToBitmapCached(I, 48);
  if Bmp <> nil then
  try
    ThumbList.AddThumbnail(I, Bmp);  // uw eigen UI-code
  finally
    Bmp.Free;
  end;
end;

// Ook 300-DPI-pagina's cachen? Geef de raster-cache een groter bytebudget
// (Policy: THPDFCacheAdmissionPolicy)
if Pdf.GetCacheAdmissionPolicy(clkRaster, Policy) then
begin
  Policy.MaxTotalBytes := Int64(512) * 1024 * 1024;
  Pdf.SetCacheAdmissionPolicy(clkRaster, Policy);
end;

// Na directe wijzigingen aan pagina-inhoud:
Pdf.InvalidateRenderedPageCache;  // de volgende render weerspiegelt de bewerking
RenderCacheCapacity is slechts één van twee limieten. De raster-cache heeft ook een bytebudget, standaard 128 MiB, met een plafon van 64 MiB per entry, en hij rekent vier bytes per pixel bij het budgetteren. Stel dat een viewer Letter-pagina's op 300 DPI cachet: elke entry geldt als ongeveer 32 MiB, dus er passen er maar drie in, wat RenderCacheCapacity ook zegt. Op 48 DPI geldt dezelfde pagina als ongeveer 0,82 MiB, en tot 32 thumbnails uit de lus hierboven blijven onder de 27 MiB resident. Als de cache vol is, verdringt een eenmaal opgevraagde pagina een vaak opgevraagde pagina misschien niet; hij wordt nog steeds gerenderd en teruggegeven, alleen niet bewaard. Draait een viewer pagina's in een voorspelbare volgorde, dan vult PrefetchLoadedPages dezelfde cache op een werkthread vóór de gebruiker
Een nieuw document laden legt de cache leeg. Versche pagina-bewerkingen van de bibliotheek zelf, zoals FlattenLoadedFormFields, gooien de getroffen pagina's al weg; na elke wijziging die u zelf aan pagina-objecten of contentstreams maakt, roep InvalidateRenderedPageCache aan, want de cache kan niet merken dat de bytes achter een pagina zijn veranderd. Daaronder zit een tweede opslag voor gedecodeerde image XObjects, begrensd door ImageCacheMaxBytes (standaard 32 MiB), zodat een logo of briefhoofd dat op elke pagina terugkomt één keer per documentlaad decodeert in plaats van één keer per Do-operator. InvalidateRenderedPageCache legt die ook leeg. Moeten thumbnails een herstart van de applicatie overleven, dan dekt de schijflaag van de rendercache dat geval
Achterhalen wanneer een pagina bij benadering is getekend
De meeste pagina's raken nooit een fallback, want de renderer dekt veel meer dan tekst en afbeeldingen. CalGray, CalRGB, Lab en op ICC gebaseerde kleurruimten worden omgerekend met de geldende rendering intent, die RenderColourIntent kan oversturen, en ConfigureRenderICCWorkflow neemt proof- en output-ICC-profielen voor soft-proofing. Geïndexeerde paletten, Separation- en DeviceN-tints en gesamplede Type 0-functiekleurlookups zijn gedekt. Functie-, axiale, radiale en mesh-shadings renderen zowel via de sh-operator als via shadingpatronen, en transparency-groepen, knockout-groepen en alpha- of luminositeitssoftmasken compositeren met hun blend modes, zoals beschreven in blend-mode-groepen en luminositeitsmasken
Echte bestanden bevatten nog steeds dingen die niet exact te tekenen zijn: een resource die de pagina noemt maar nooit definieert, een afbeelding waarvan de data niet decodeert, een Form XObject dat zichzelf schildert. RenderFallbackPolicy beslist wat er dan gebeurt. De standaard, rfpIgnore, tekent de dichtstbijzijnde benadering en gaat verder. rfpReport doet hetzelfde maar legt per fallback een diagnose vast, tot RenderFallbackDiagnosticLimit entries (standaard 256). rfpStrict gooit een exception in plaats van een benaderde bitmap terug te geven. Form-nesting stopt op 32 niveaus en een form die naar zichzelf verwijst wordt overgeslagen, dus een kapot of vijandig bestand kan niet onbegrensd in recursie gaan
// rfpReport en THPDFRenderFallbackDiagnostics zijn gedeclareerd in HPDFPageRenderer
var
  Diags: THPDFRenderFallbackDiagnostics;
  J: Integer;
begin
  Pdf.RenderFallbackPolicy := rfpReport;
  Bmp := Pdf.RenderLoadedPageToBitmap(PageIndex, 150);
  try
    Diags := Pdf.GetLastRenderFallbackDiagnostics;
    for J := 0 to High(Diags) do
      Log.Add(Format('page %d: %s %s - %s', [PageIndex + 1,
        string(Diags[J].OperatorName), string(Diags[J].ObjectName),
        string(Diags[J].Reason)]));
    if Pdf.LastRenderFallbackDroppedCount > 0 then
      Log.Add(Format('%d more fallbacks not recorded',
        [Pdf.LastRenderFallbackDroppedCount]));
  finally
    Bmp.Free;  // Free is veilig op nil
  end;
end;
Draai QA- en ingestie-builds met rfpReport. De bitmap is identiek aan wat rfpIgnore oplevert, en het log laat zien welke pagina's bij benadering zijn getekend en waarom, voordat een klant meldt dat pagina 14 raar oogt. Houd rfpStrict voor archiveringsconversie, waar een stilletjes benaderde pagina erger is dan een gefaalde. Een cache-hit herstelt de diagnoses die zijn vastgelegd toen die pagina voor het eerst werd gerenderd, dus GetLastRenderFallbackDiagnostics geeft hetzelfde antwoord of de gecachte variant nu werk heeft gedaan of niet
RenderLoadedPageToBitmap, de gecachte variant en het tekstpad met ingebedde glyphs maken deel uit van het HotPDF Delphi Component, een native VCL-bibliotheek voor Delphi en C++Builder zonder externe DLL's, dat ook documenten maakt, bewerkt en tekst uit dezelfde geladen documenten extraheert die u rendert