Als een PDF een font niet insluit, rendert het HotPDF-component die tekst met een geïnstalleerd Windows-font dat HPDFMapBaseFontToSystem kiest: hij decodeert de /BaseFont-naam, haalt het stijldeel eraf, probeert meerdere spellingen tot GDI bevestigt dat de familie geïnstalleerd is, meet ontbrekende standard 14-breedtes vanuit metrisch compatibele fonts, en zet single-byte codes om naar Unicode vóór het tekenen. Elk van die stappen bestaat omdat de voor de hand liggende aanpak op echte bestanden faalt. De RenderLoadedPageToBitmap-paginarender doet ingesloten programma's goed; dit is het verhaal van de fonts die helemaal niet in het bestand zitten
Waarom tekent GDI stilletjes het verkeerde lettertype voor een niet-ingesloten font?
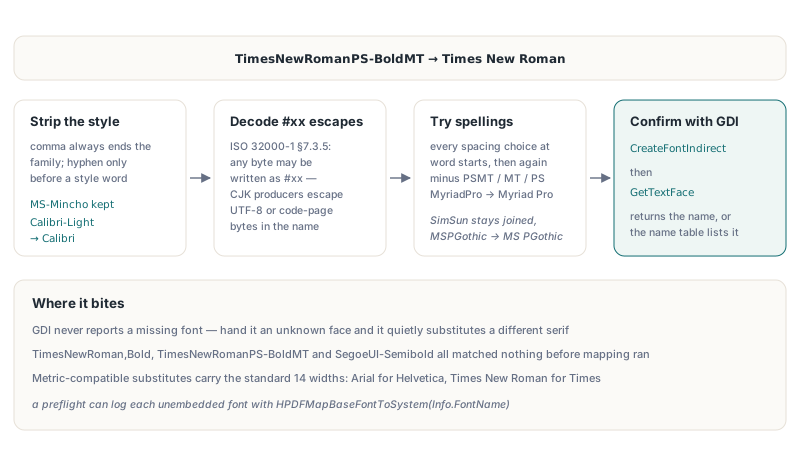
GDI meldt nooit een ontbrekend font: geef CreateFontIndirect een facenaam die hij niet kent en hij kiest stilletjes een vervanger, vaak een andere serif zonder bold gewicht. Geef de PDF-naam bijna letterlijk door en TimesNewRoman,Bold, TimesNewRomanPS-BoldMT en SegoeUI-Semibold matchen allemaal niets en komen eruit in wat GDI maar kiest. Namen kunnen erger. ISO 32000-1 §7.3.5 laat een naam elke byte als #xx schrijven, en CJK-producenten spellen fontnamen routinematig als escaped UTF-8 of legacy code-page-bytes; een mapper die de decodeerstap overslaat vraagt GDI om een face die naar de escapes zelf is vernoemd. HPDFMapBaseFontToSystem decodeert eerst de escapes, geeft een geldige UTF-8-bytereeks terug als zijn tekens, en leest overige hoge bytes in de systeemcodepagina
Het stijldeel eraf halen is waar de heuristiek bijt. Een komma beëindigt altijd de familie (Arial,Bold geeft Arial), maar een koppelteken doet dat alleen als het woord erna een stijl is: Bold, Italic, Oblique, Regular, Roman, Medium, Light, Black, Heavy, Semi, Demi, Thin, Extra, Ultra of Condensed. Die regel houdt MS-Mincho heel terwijl Calibri-Light tot Calibri wordt. HotPDF probeert daarna spellingen van de familie, gevolgd door spellingen van de familie met een PSMT-, MT- of PS-achtervoegsel eraf. Die spellingen dekken elke keuze van spaties op de plekken waar een woord kan beginnen: vóór een hoofdletter die op een kleine letter volgt (MyriadPro wordt Myriad Pro), bij de laatste hoofdletter van een reeks waarop een kleine letter volgt (UIGothic), en na een voorloop-MS (MSPGothic), van de volledig gespatieerde vorm tot aan de naam zoals geschreven; voorbij vier van zulke plekken worden alleen de volledig gespatieerde en de aaneengeschreven naam geprobeerd. Spaties kunnen niet blind worden toegepast, want Windows houdt sommige woorden aan elkaar: SimSun is geïnstalleerd onder precies die spelling, terwijl MicrosoftYaHei, MicrosoftJhengHei en MSPGothic bij Microsoft YaHei, Microsoft JhengHei en MS PGothic horen. Een mapper die een spatie vóór elke binnenhoofdletter zet, zoekt MicrosoftYaHei op als Microsoft Ya Hei en vindt hem nooit. Een kandidaat geldt als geïnstalleerd wanneer CreateFontIndirect gevolgd door GetTextFace de gevraagde naam teruggeeft, of wanneer de name-tabel van het gekozen font hem vermeldt als familie-, volledige of typografische familienaam in welke taal dan ook; het antwoord wordt per naam gecached, dus documenten met veel niet-geïnstalleerde fonts bevragen Windows niet bij elke pagina voor elke naam opnieuw
Omdat de mapping-functie publiek is in de unit HPDFRenderFontMetrics, kan een preflight-rapport tonen met welke geïnstalleerde familie elk niet-ingesloten font gaat renderen, met de font-enumeratie die THotPDF al aanbiedt voor geladen documenten:
uses
  HPDFDoc, HPDFRenderFontMetrics;

procedure ListSystemFontMappings(Pdf: THotPDF; Log: TStrings);
var
  Page, I: Integer;
  Info: THPDFLoadedFontInfo;
begin
  for Page := 0 to Pdf.LoadedPageCount - 1 do
    for I := 0 to Pdf.GetLoadedFontCount(Page) - 1 do
      if Pdf.GetLoadedFontInfo(Page, I, Info) and not Info.IsEmbedded then
        Log.Add(Format('page %d  /%s  %s -> %s',
          [Page + 1, string(Info.ResourceName), string(Info.FontName),
           HPDFMapBaseFontToSystem(Info.FontName)]));
end;
Hoe meet HotPDF standard 14-fonts zonder /Widths?
HotPDF meet de ontbrekende advances op het geïnstalleerde font met dezelfde metrics, want ISO 32000-1 §9.6.2.2 staat de standard 14-fonts toe om /Widths weg te laten en de library scheept geen AFM-tabellen in. Arial draagt de metrics van Helvetica, Times New Roman die van Times en Courier New die van Courier, dus HPDFMeasureBaseFontWidths maakt het bijpassende face aan op lfHeight = -1000 en roept GetCharWidth32W aan; op die hoogte zit het resultaat al in de 1/1000 em-eenheden die PDF-breedtes gebruiken. De renderer zet eerst elke code om naar Unicode via /Encoding, /BaseEncoding en /Differences, met StandardEncoding als default. SVG-export en tekstextractie delen nog een valkuil: een standard Type 1-font zonder enige /Encoding heeft alsnog een impliciete StandardEncoding, en een decoder die zonder hem is gebouwd draagt geen encoding-informatie, dus elke gemeten breedte blijft ongebruikt. HotPDF levert de impliciete StandardEncoding mee en markeert hem als predefined encoding; hem via het CMap-naampad sturen zou elke code als 0 decoderen, en elke breedte zou volgen
Bold, italic en de font descriptor-flags met nummering vanaf 1
De /Flags-entry van een font descriptor nummert zijn bits vanaf 1, niet vanaf 0, dus ForceBold is bit 19 ($40000) en Italic is bit 7 ($40), volgens ISO 32000-1 Table 123. De off-by-one is makkelijk gemaakt: tel vanaf nul en $20000 lijkt ForceBold, maar het is bit 18, SmallCap, en een gewichtstest erop rendert elk small-caps-face bold. De valkuil verschuilt zich ook goed, want /FontDescriptor is bijna altijd een indirecte referentie: code die alleen directe objecten leest bereikt de flags-tak helemaal niet, en dezelfde blindheid negeert /Widths 12 0 R en zet tekst neer op een fallback advance. Indirecte referenties oplossen en de bitconstanten aan Table 123 vastpinnen horen bij elkaar:
const
  // ISO 32000-1 Table 123 telt bitposities vanaf 1
  FD_ITALIC     = $00040;  // bit 7
  FD_SMALLCAP   = $20000;  // bit 18, geen gewicht
  FD_FORCEBOLD  = $40000;  // bit 19

procedure ApplyDescriptorFlags(Flags: Integer; var LF: TLogFont);
begin
  if (Flags and FD_FORCEBOLD) <> 0 then
    LF.lfWeight := FW_BOLD;
  if (Flags and FD_ITALIC) <> 0 then
    LF.lfItalic := 1;
end;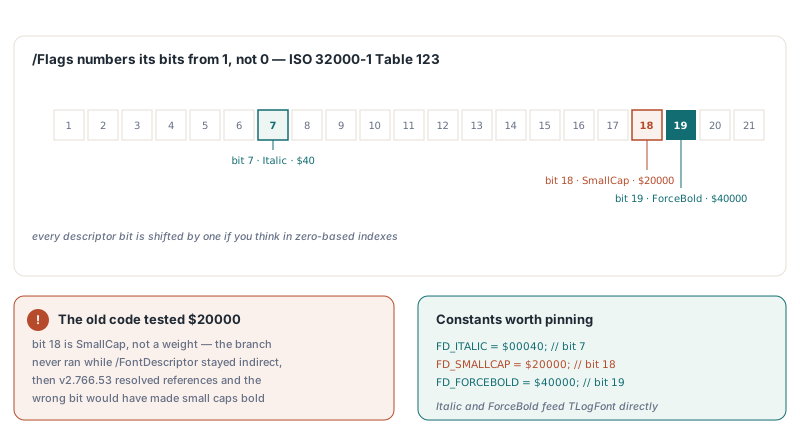
Waarom krijgen CJK-fonts met een UCS2 CMap de verkeerde breedtes?
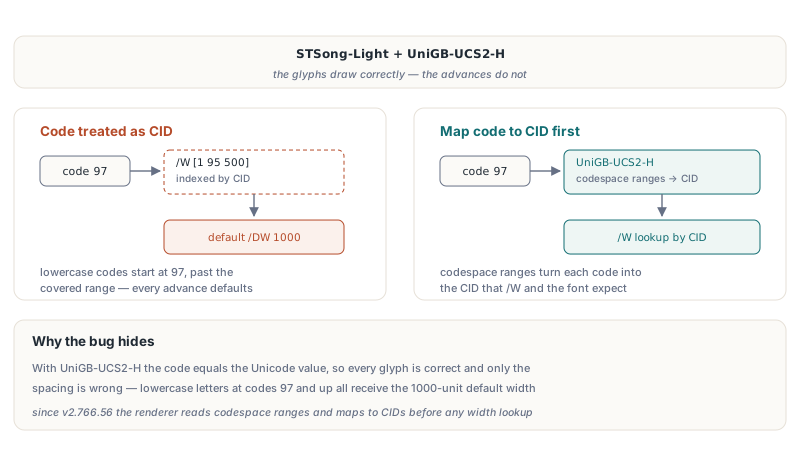
CJK-tekst met een predefined UCS2 CMap tekent de juiste glyphs maar de verkeerde spatiëring als een renderer de code als de CID behandelt, want /W is geïndexeerd op CID, niet op character code. Met STSong-Light en UniGB-UCS2-H is de code toevallig gelijk aan de Unicode-waarde, dus GDI tekent de juiste tekens en de fout schuilt in de advances: kleine letters komen binnen als codes 97 en hoger, vallen buiten een /W-entry zoals [1 95 500] en krijgen allemaal de default breedte /DW van 1000. De HotPDF-renderer leest codes via de CMap codespace-bereiken (ISO 32000-1 §9.7.6.2) en mapt ze naar CIDs voordat hij breedtes opzoekt. Hij werkt vanuit de ingebouwde UCS2- en UTF16-tabellen en ingesloten CMap-streams; een identity-benadering voor zoiets als GBK-EUC-H zou er alleen maar ondersteund uitzien terwijl hij verkeerde uitvoer produceert, dus die wordt bewust niet gebruikt
Waarom veranderen letters met accenten in vraagtekens op Chinese Windows?
Single-byte codes mogen nooit bij de ANSI ("A")-functies van GDI uitkomen, want GetGlyphOutlineA en GetGlyphIndicesA interpreteren bytes in de systeemcodepagina terwijl TextOutA de character set van het gekozen font gebruikt. Op een Chinees systeem wordt de Arial-byte $A9 (het copyright-teken in Windows-1252) een GBK-leadbyte en rendert als "?", en elk outline-pad dat de A-functies aanroept loopt er recht in. HotPDF vraagt het gerealiseerde font met GetTextCharset naar zijn character set, zet die via TranslateCharsetInfo om naar een codepagina, haalt de byte door MultiByteToWideChar en roept de W-functies aan; symbol fonts gebruiken in plaats daarvan U+F000 plus de code. Encodings die niet met Windows-1252 overeenkomen — /Differences, StandardEncoding, MacRomanEncoding — worden naar Unicode gemapt voordat een systeemfont ze te zien krijgt
Hoe ver komt tekenen met systeemfonts?
Renderen met systeemfonts is van nature een benadering, en gelokaliseerd Windows voegt een twist toe: GetTextFace meldt de familienaam in de systeemtaal, dus op naam alleen zou Microsoft YaHei op Chinese Windows of Yu Mincho op Japanse Windows als ontbrekend worden beoordeeld. Daarom wordt een face die onder een andere naam terugkomt ook in de name-tabel van het font opgezocht. Metrische compatibiliteit bestaat voor de families Helvetica, Times en Courier; Symbol mapt naar Symbol en ZapfDingbats naar Wingdings, wat een noodmaatregel is in plaats van een match. De preflight hierboven loopt de /Resources-dictionary van elke pagina af, dus fonts waarnaar alleen van binnenuit form XObjects wordt verwezen, hebben een eigen passe nodig. Als een code nog steeds niet getekend kan worden, meldt de draw-time unresolved glyph tracking dat, wat een beter signaal is dan miniaturen met het blote oog beoordelen
Het duurzame antwoord zit aan de authoringkant. HotPDF zelf schrijft met FontEmbedding standaard op True, en substitueert een ingesloten Arial zelfs wanneer code SetFont met Helvetica aanroept, en ingesloten tekst gaat via de embedded font glyph renderer in plaats van langs een van het gegok hierboven. Een goedkoop vangnet voor inkomende bestanden is waarschuwen vóór het renderen wanneer een gemapte familie niet in de schermfontlijst staat:
// VCL: Screen.Fonts somt geïnstalleerde familienamen op (Forms-unit)
function MissingSystemFamily(const BaseFont: AnsiString): Boolean;
begin
  Result := Screen.Fonts.IndexOf(HPDFMapBaseFontToSystem(BaseFont)) < 0;
end;
Voor het volledige component, inclusief paginarendering, tekstextractie en font subsetting aan de schrijfkant, zie de productpagina van de HotPDF Delphi PDF component