Een parser hangt op een misvormde PDF wanneer een tak een byte leest, weigert hem te behandelen en terugkeert zonder de cursor te verplaatsen. De caller-lus ziet geen vooruitgang en geen reden om te stoppen, dus draait hij eeuwig door. HotPDF shipped exact dat defect in drie onafhankelijke parsers, allemaal bereikbaar vanaf inputs onder de vijftig bytes
Dit is een denial-of-service-klasse die een eigen naam verdient, want hij ziet er niet uit als degene waar iedereen al tegen waakt. Er is geen decompressie, geen groeiende toewijzing, geen geheugendruk om een watchdog te laten trippen. Het proces zit gewoon op honderd procent CPU op een enkele kern met een handvol bytes in een buffer. Heb je na het lezen over geneste filter-amplificatie en PDF-bommen een decode-budget toegevoegd, dan zal dat budget hier niet afgaan: er wordt niets gedecodeerd en niets toegewezen. Ander falen, andere fix
Waarom kost een bestand van veertig bytes meer dan een decompressiebom?
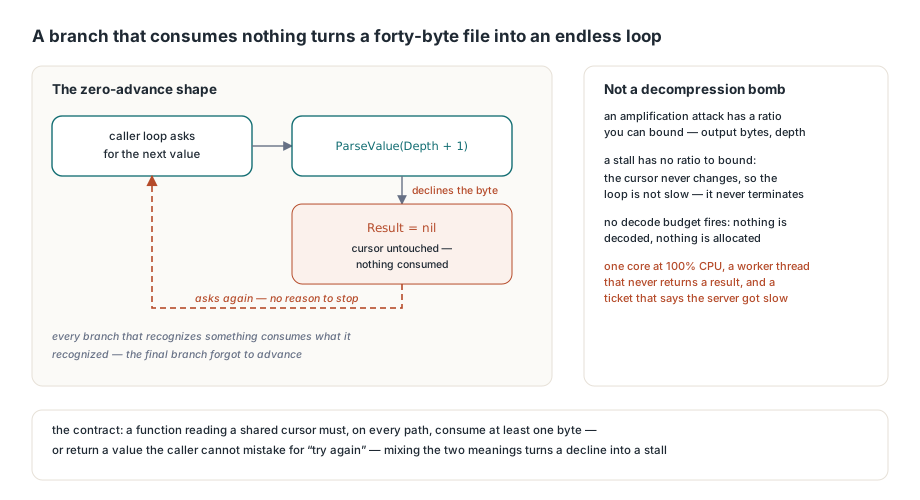
Omdat de kosten helemaal geen relatie met de inputgrootte hebben. Een amplificatie-aanval heeft een ratio die je kunt begrenzen: cap de output-bytes, cap de recursiediepte, en het slechtste geval wordt eindig. Een zero-advance-lus heeft geen ratio om te begrenzen. De lusconditie is een functie van een cursor die nooit verandert, dus het is niet traag, het is niet-terminerend, en geen enkele upstream limiet op grootte vangt hem. Dat maakt hem operationeel ook uniek smerig. Een crash geeft je een stack, een out-of-memory geeft je een logregel, en een gestalde parser geeft je een worker-thread die nooit een resultaat teruggeeft, een request dat nooit timeout omdat niets stroomafwaarts weet dat het begon, en een ticket dat zegt dat de server op dinsdag traag werd. De structurele oorzaak heeft altijd dezelfde vorm. Een tokenizer of value-parser heeft een keten van takken die op de huidige byte zijn gesleuteld. Elke tak die iets herkent consumeert wat hij herkende. Dan is er een laatste tak, of een guard vóór de keten, die terugkeert voor de bytes die niemand opeiste, en de auteur redeneert erover als een foutpad in plaats van als een scanstap. Foutpaden keren terug. Scanstappen schuiven op. Wanneer één functie allebei moet zijn, is het opschuiven wat wordt vergeten
De object-parser: twee delimiters die niemand consumeerde
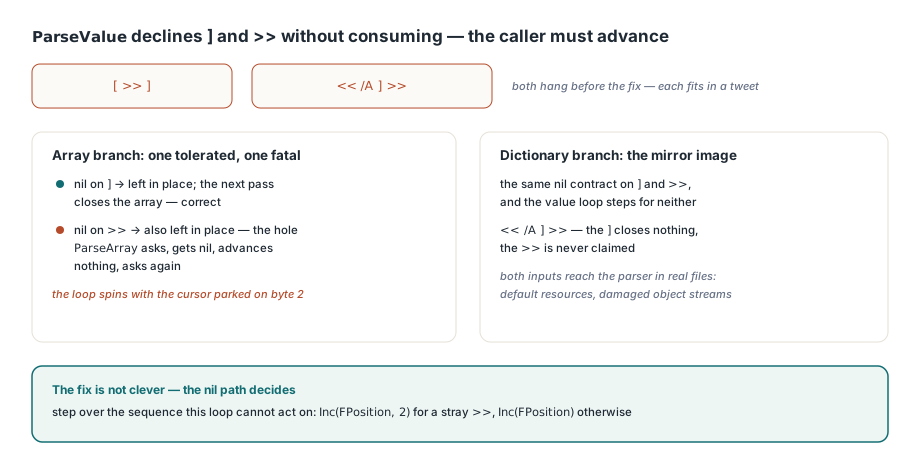
In HPDFParser begint de methode THPDFSpanObjectParser.ParseValue met het botweg afwijzen van twee bytesequenties. Volgens ISO 32000-1 sectie 7.3 kan een waarde niet met ] of met >> beginnen, want die sluiten een container in plaats van een waarde te openen, dus ParseValue geeft voor beide nil terug zonder ze te consumeren. Dat is het correcte contract, en het legt de hele last van het opschuiven bij de caller. De array-tak honoreerde de helft ervan: bij een nil-resultaat checkte hij op ], liet hem op zijn plaats staan voor de volgende pass om de array te sluiten, en stapte over al het andere heen — behalve dat de check toevallig zo was geschreven dat een verdwaalde >> ook op zijn plaats bleef. Dus [ >> ] hangt, want ParseArray vraagt om een waarde, krijgt nil, schuift niets op en vraagt opnieuw. De dictionary-tak had het spiegelbeeld-gat, en << /A ] >> hangt op dezelfde manier. Beide inputs zijn valide genoeg om de parser te bereiken en kort genoeg om in een tweet te passen
uses
  HPDFObjs, HPDFParser;

procedure ProbeParserStalls;
var
  Stats: THPDFParserViewStatistics;
  Arr: THPDFArrayObject;
  Dict: THPDFDictionaryObject;
begin
  // Vóór de fix keerde geen van beide aanroepen hieronder ooit terug
  Arr := HPDFParserParseSimpleArrayWithStatistics('[ >> ]', Stats);
  Arr.Free;
  WriteLn('array errors=', Stats.ErrorCount, ' valid=', Stats.Valid);

  Dict := HPDFParserParseSimpleDictionaryWithStatistics('<< /A ] >>', Stats);
  Dict.Free;
  WriteLn('dict errors=', Stats.ErrorCount, ' valid=', Stats.Valid);
end;
De fix is niet slim, en dat is het punt: het nil-pad moet expliciet beslissen welke van de twee niet-geconsumeerde sequenties de huidige lus kan verwerken, en over de andere heen stappen
Value := ParseValue(Depth + 1);
if Value = nil then
begin
  RecordError;
  // ParseValue geeft nil terug voor zowel ']' als '>>' zonder ze te
  // consumeren. De ']' sluit de array bij de volgende pass af, maar een
  // verdwaalde '>>' binnen een array moet worden overgeslagen of de parse schuift nooit op
  if (FPosition < FLength) and StartsWithPair('>', '>') then
    Inc(FPosition, 2)
  else if (FPosition < FLength) and (CharAt(FPosition) <> ']') then
    Inc(FPosition);
  Continue;
end;
Nog één ding verdient hier aandacht. THPDFSpanObjectParser.RecordError verhoogt alleen ErrorCount in THPDFParserViewStatistics; het capt niets. De parser zet HPDFParserMaximumDepth op 64 om het nesten te begrenzen, maar heeft geen equivalente limiet op het foutenaantal, en een teller die nooit wordt gelezen is een gemiste circuit breaker. Zelfs met het herstelde opschuiven zal een input die één fout per byte produceert een groot object opvreten op een tempo dat een vroege exit verdient in plaats van een volledige traversal. Check Valid op het statistiekenrecord na elke parse en behandel een grote ErrorCount als een reden om het object niet meer te vertrouwen, niet louter als een diagnostiek
Dezelfde vorm in de CMap-tokenizer en de XFDF-reader
HPDFCMapReader.NextToken droeg het identieke defect in zijn fallback-tak. De functie geeft een TCMapTok terug en handelt <, ( en / af met toegewijde takken; al het andere valt door naar "lezen tot whitespace of delimiter". Is de startbyte zelf een delimiter uit de set van ISO 32000-1 sectie 7.2.2, dan draait die lus nul keer, komt het token leeg terug en vraagt de caller om hetzelfde token opnieuw. Van de zes tekens die daar kunnen landen werd alleen [ eerder door de bfrange-afhandeling onderschept, dus een verdwaalde ), >, ], { of } ergens in een ToUnicode-CMap was genoeg om tekstextractie te stallen
// keyword of getal: lezen tot whitespace of delimiter
StartP := P;
while (P <= Len) and (not IsCMapWhiteSpace(Text[P]))
  and (not IsCMapDelimiter(Text[P])) do
  Inc(P);
// Een delimiter die geen van de takken hierboven opeist (een verdwaalde ')',
// '>', '[', ']', '{' of '}') zou P laten staan waar hij stond en een leeg
// keyword teruggeven, zodat de caller eeuwig om hetzelfde token zou vragen
if P = StartP then
  Inc(P);
AKeyword := Copy(Text, StartP, P - StartP);
Result := ctKeyword;
De XFDF-kant had een variant met een andere oorsprong en hetzelfde effect. HPDFXFDFXml.ParseElement zet bovenaan Result := P, terwijl P nog naar de openende < wijst, en verhoogt pas daarna zijn lokale cursor, dus elke vroege exit die volgt geeft de entry-positie terug tenzij hij Result eerst overschrijft. Een doctype-declaratie volgens XML 1.0 sectie 2.8, of iets anders zonder parseerbare tagnaam zoals <1a>, nam een exit die Result nooit bijwerkte, en de kind-element-lus ontving de positie die hij had doorgegeven. De attributen-lus had er nog drie, want ReadName, de whitespace-skip en de =-afhandeling wijzen allemaal een byte af die noch een naamteken, noch whitespace, noch een van =, >, / is, en geen van hen consumeerde hem. De aangrenzende CDATA-reparatie verplaatste een verantwoordelijkheid in plaats van een guard toe te voegen: een CDATA-sectie volgens XML 1.0 sectie 2.7 begint met <, dus de kind-lus gaf hem vroeger aan ParseElement, die dan een tagnaam uit de sectie-inhoud las. Hem in de kind-lus met IsCDATAStart herkennen en bytes in de tekstbuffer kopiëren tot IsCDATAEnd is de correcte verdeling, en de oude skip was ook één byte kort, want de marker is acht bytes gerekend vanaf de !
Gedeclareerde aantallen die de data overleven
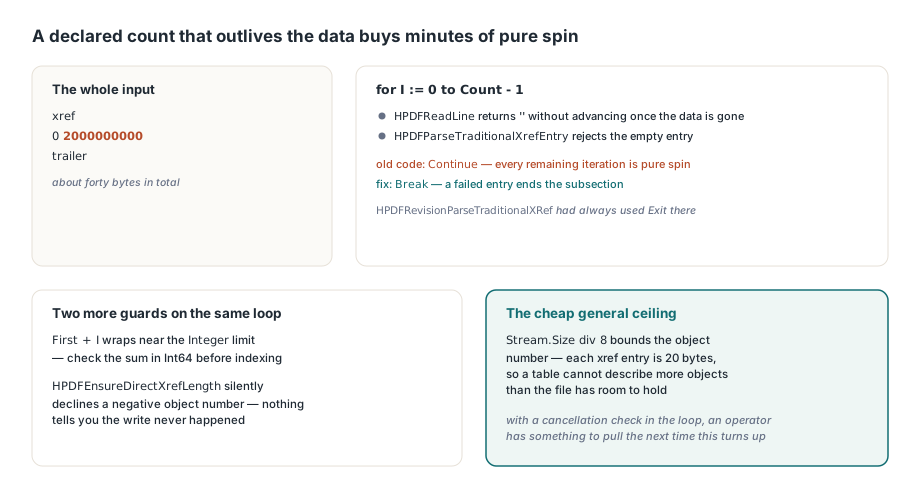
Een latere release bracht hetzelfde patroon van de tegenovergestelde richting aan het licht, en het is de variant die het waarschijnlijkst in je eigen code bestaat. Een cross-reference-subsection-header volgens ISO 32000-1 sectie 7.5.4 is een first count-paar, en beide HotPDF traditionele-xref-parsers loopen for I := 0 to Count - 1 erover, met Continue in plaats van Break wanneer een entry niet parseerde. Dat leest als tolerantie voor één slechte regel. Het is het niet: HPDFReadLine geeft een lege string terug zonder op te schuiven zodra de data op is, en HPDFParseTraditionalXrefEntry wijst een lege entry direct af, dus elke resterende iteratie van het gedeclareerde aantal is pure spin. De rekenkunde is onaardig — de header xref\n0 2000000000\ntrailer plus een minimale wrapper is ongeveer veertig bytes, en het koopt tientallen seconden van een drukke kern zonder enige cancel-check ergens in de lus. De aanwijzing zat in dezelfde unit, want HPDFRevisionParseTraditionalXRef had op die positie altijd Exit gebruikt. Wanneer twee functies dezelfde grammatica parsen en van mening verschillen over of een mislukte entry de subsection beëindigt, is een van beide een fork die stopte met het krijgen van fixes, hetzelfde handtekening als in hybride cross-reference-afhandeling waar een traditionele tabel en een stream dezelfde objecten beschrijven
if not HPDFParseIntegerPair(Line, First, Count) then
  Exit;
for I := 0 to Count - 1 do
begin
  Entry := HPDFReadLine(XrefData, P);
  // Een gedeclareerd aantal groter dan de tabel zou hier anders spinnen
  // met geen data meer om te lezen
  if not HPDFParseTraditionalXrefEntry(Entry, EntryOffset, GenNum, InUse) then
    Break;
  // First komt uit de subsection-header, dus de som wrapt voor een
  // gedeclareerde start bij de Integer-limiet, en de groeihelper weigert
  // stilzwijgend een negatieve index
  if (First < 0) or (Int64(First) + I > MaxInt) then
    Break;
  ObjNumber := First + I;
  if (ObjNumber < 0) or (Int64(ObjNumber) > Stream.Size div 8) then
    Break;
  HPDFEnsureDirectXrefLength(State, ObjNumber);
  // ... de entry registreren ...
end;
De twee grenzen na de Break horen bij dezelfde reparatie. HPDFEnsureDirectXrefLength weigert de array voor een negatief objectnummer te laten groeien en zegt er niets over, en First + I wrapt voor een gedeclareerde start bij de Integer-limiet, dus een negatieve index bereikt de writes eronder. Het objectnummer-plafond van Stream.Size div 8 is het goedkope algemene antwoord, want geen enkele traditionele cross-reference-tabel kan meer objecten beschrijven dan het bestand ruimte heeft om te bevatten, en elke header die iets anders claimt beschrijft een bestand dat niet bestaat. Repareer je met de hand een beschadigde tabel, dan geldt dezelfde redenering van de andere kant, het terrein dat in de notities over handbewerkte PDF's diagnosticeren en repareren wordt behandeld
Hoe bewijs je dat een hang-fix werkelijk werkt?
Door de oude code te draaien, niet door hem te herlezen. Een stall is een van de weinige defectklassen waar een fix met een binair signaal en zonder instrumentatie te verifiëren is, want het proces keert ofwel terug ofwel niet, en over control flow redeneren is precies de vaardigheid die de bug in de eerste plaats produceerde. De mechaniek is het kopiëren waard. Extraheer de pre-fix-revisie van de gewijzigde units in een scratch-directory, compileer dan één kleine probe met het unit-zoekpad dat die directory vóór de echte library zet: dcc32 -U<scratchdir>;<Lib> probe.dpr. De compiler neemt de oude bronnen voor wat hij het eerst vindt en de huidige bronnen voor al het andere, dus één probe-binary oefent de oude parser tegen de rest van de library. Draai hem onder een timeout — veertig seconden is gul — en behandel exitcode 124 als de assertie. Trek daarna de units één voor één uit de scratch-directory terug en herbouw. Alle drie de stalls reproduceerden zo, elk toe te schrijven aan een specifieke unit, en alle drie kwamen terug zodra de gefixte bron weer in het pad stond, tegen de kosten van één compile per unit
Twee valkuilen zijn het weten waard voordat je het probeert. Het unit-zoekpad is stilzwijgend permissief: geef -U een Unix-stijl pad uit een shell, zoals $PWD, en de compiler negeert die directory zonder een woord, wat betekent dat je probe tegen de huidige bronnen compileerde en om de verkeerde reden slaagde. Converteer het pad eerst naar native Windows-vorm. De tweede is dat de scratch-directory de include-bestanden niet draagt, dus je hebt ook -I<Lib> nodig voor HotPDF.inc, of de build faalt op een manier die eruitziet als een bronprobleem in plaats van een padprobleem. En wees eerlijk over wat de methode je niet geeft: hij bevestigt dat een specifieke input op een specifieke build ophield met hangen, en zegt niets over de inputs waar je niet aan dacht. Zero-advance-defecten worden gevonden door fuzzen of door elke tak van elke tokenizer te lezen, niet door achteraf geschreven regressietests
Wat te auditen in je eigen parsers
De herbruikbare regel is een contract, geen checklist-item. Elke functie die van een gedeelde cursor leest moet op elk pad, inclusief zijn faalpaden, ofwel minstens één byte consumeren ofwel een waarde teruggeven die de caller niet kan verwarren met "probeer opnieuw". Die twee betekenissen in één nil of één leeg token mengen is wat van een weigering een stall maakt. Audit dus op de vorm in plaats van op het symptoom. Vind elke lus waarvan de terminatie afhangt van een cursor die een andere functie bezit, en vraag wat er gebeurt wanneer die functie de huidige byte weigert. Vind elke fallback-tak die is geschreven als "lezen tot X" en vraag wat hij doet wanneer de cursor al op X staat. Vind elke lus die door een aantal uit het bestand is begrensd in plaats van uit de data, en laat een mislukt element de lus beëindigen in plaats van een iteratie overslaan. Wordt dezelfde grammatica op twee plekken geparst, diff ze dan, want één zal een fix hebben ontvangen die de ander niet kreeg. En zet een cancel-check binnen elke lus die voor een door de caller opgegeven aantal iteraties kan draaien, zodat een operator iets heeft om aan te trekken wanneer de volgende van deze in productie opduikt
De hier beschreven parsers zitten in de huidige HotPDF Delphi Component voor Delphi en C++Builder, met de statistiekenrecords en dieptelimieten blootgelegd zodat je eigen hardening erop kan bouwen