HotPDF kan een geladen document opslaan in een diagnostische vorm die bedoeld is om door een mens te worden gelezen en bewerkt, en het bestand vervolgens repareren nadat u het hebt bewerkt. SaveLoadedDocumentDiagnostic schrijft het document met deterministische dictionary-volgorde, elk object als een gewoon indirect object, geen object streams, geen cross-reference stream en geen linearisatie. RepairDiagnosticDocument herbouwt vervolgens de byte-offsets, streamlengtes, cross-reference-tabel en trailer die uw bewerking ongeldig heeft gemaakt
Dit duo bestaat voor één workflow: begrijpen of repareren wat er daadwerkelijk in een PDF zit. Elke ontwikkelaar die ooit een renderprobleem heeft gedebugd, heeft het bestand willen openen, één getal in één dictionary willen veranderen, en het resultaat willen bekijken. In een normale PDF is dat onmogelijk, omdat de inhoud gecomprimeerd is in object streams en elke byte die u invoegt, offsets verschuift die een cross-reference-tabel exact vastlegt
Wat maakt een diagnostische opslag anders?
Zes instellingen veranderen samen. Dictionary-sleutels worden in deterministische volgorde geschreven, zodat twee opslagen van hetzelfde document vergelijkbare bestanden opleveren. De diagnostische outputmodus annoteert de structuur. Volledig herschrijven wordt geforceerd, zodat niets als een onaangeraakte incrementele revisie wordt meegenomen. Linearisatie staat uit, omdat een gelineariseerd bestand georganiseerd is voor een webviewer in plaats van voor een lezer. Cross-reference streams staan uit, zodat de tabel platte tekst is. En object streams staan uit, zodat geen enkel object verborgen zit in een gecomprimeerde container
Het resultaat is een bestand waarvan de header een diagnostische markering draagt naast de gebruikelijke %PDF--handtekening, en waarvan u de inhoud in elke editor kunt doorbladeren. Objecten verschijnen achter elkaar, dictionaries zijn leesbaar, en content streams staan waar u ze kunt vinden. De reparatietool controleert op die markering en weigert bestanden die deze missen, want de compacte structuur van een normale PDF is niet iets wat een byte-range-reparatietool zou moeten proberen te interpreteren

uses
  HPDFDoc;

var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('invoice.pdf') <= 0 then
      Exit;
    // Leesbaar, één object per blok, niets verborgen in object streams
    Pdf.SaveLoadedDocumentDiagnostic('invoice-diagnostic.pdf');
  finally
    Pdf.Free;
  end;
end;
Waarom breekt bewerken het bestand, en wat moet er worden herbouwd?
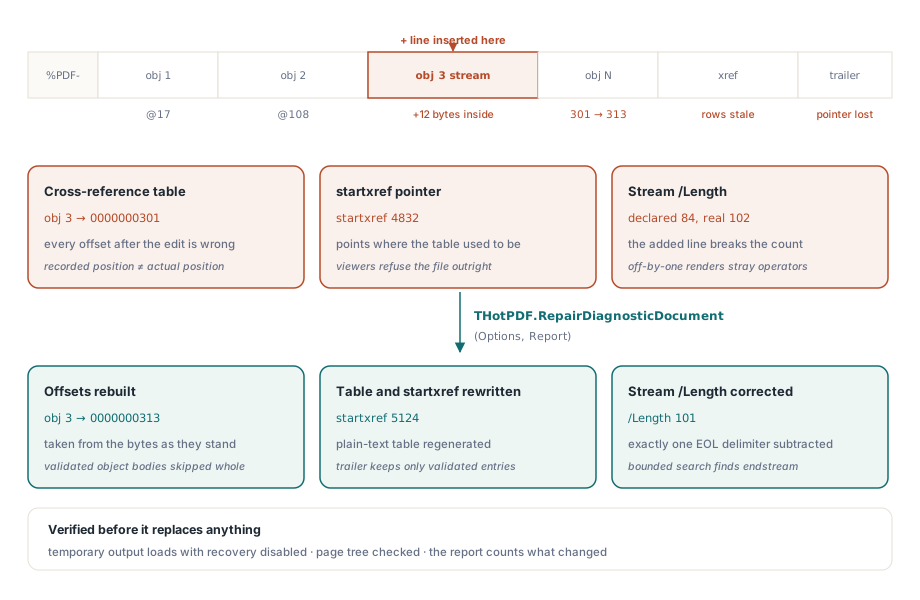
Drie dingen in een PDF coderen bytepositie of byteaantal. De cross-reference-tabel koppelt elk objectnummer aan een byte-offset. De startxref-waarde aan het eind van het bestand wijst naar de tabel. En elke stream-dictionary draagt een /Length die aangeeft hoeveel bytes de streamtekst in beslag neemt
Verander één teken ergens vóór het einde van het bestand en de offsets erna zijn fout. Voeg een regel toe aan een content stream en de /Length is ook fout. De meeste viewers zullen het bestand weigeren, en de viewers die het herstellen doen dat door te scannen, wat de fout verbergt in plaats van hem te repareren. Reparatie herbouwt alle drie op basis van wat de bytes nu daadwerkelijk zeggen
var
  Options: THPDFDiagnosticRepairOptions;
  Report: THPDFDiagnosticRepairReport;
begin
  Options := THPDFDiagnosticRepairOptions.Default;
  Options.VerifyOutput := True;         // laad het resultaat voordat het wordt vervangen

  if THotPDF.RepairDiagnosticDocument('invoice-diagnostic.pdf',
       'invoice-fixed.pdf', Options, Report) then
    Writeln(Format('%d objects, %d streams, %d lengths corrected, ' +
      '%d xref rows rebuilt, %d pages verified',
      [Report.ObjectCount, Report.StreamCount,
       Report.RepairedStreamLengthCount, Report.RebuiltXRefEntryCount,
       Report.VerifiedPageCount]))
  else
    Writeln(Format('repair failed (%d): %s',
      [Ord(Report.Status), string(Report.Diagnostic)]));
end;
Bytes kopiëren, niet opnieuw serialiseren
De ontwerpbeslissing die deze tool betrouwbaar maakt, is dat hij het document nooit laadt en opnieuw wegschrijft. Hij kopieert de bytebereiken van objecten die hij heeft gevalideerd, verandert alleen de /Length-waarden die fout zijn, en herbouwt de tabel, trailer en startxref eromheen
Laden en opnieuw serialiseren zou veel eenvoudiger te implementeren zijn en zou dingen stilzwijgend veranderen. Onbekende objectsyntaxis zou worden genormaliseerd, string-escapes zouden worden herschreven in de voorkeursvorm van de writer, en al gecodeerde streampayloads zouden opnieuw kunnen worden gecodeerd. Voor een debugtool is dat onaanvaardbaar: u hebt één getal bewerkt, en de diff zou één getal moeten tonen, geen duizend incidentele opmaakwijzigingen. Als u precies wilt weten wat er tussen twee bestanden is veranderd, is dat een vergelijkingsprobleem, behandeld in het vergelijken van twee PDF-bestanden op structuur en pixels

De twee parseregels die valse objecten voorkomen
Een byte-range-scanner staat voor een voor de hand liggende valkuil: tekst die eruitziet als een objectheader kan binnen een streampayload of binnen een string voorkomen. Een naïeve scan zou een cross-reference-rij afgeven die naar het midden van een content stream wijst, en het resulterende bestand zou op een nieuwe en verwarrendere manier kapot zijn
HotPDF vermijdt dit door het volledige bytebereik van elk gevalideerd object over te slaan, met behulp van het geregistreerde eindoffset, zodat niets binnen een objecttekst ooit als kandidaat wordt beschouwd. Tussen objecten zijn alleen PDF-witruimte en commentaar toegestaan; al het andere betekent dat de regio niet wordt begrepen en de bytes ervan niet in de output mogen worden getrokken
Streamlengtes vergen evenveel zorg. De werkelijke payloadlengte sluit de regeleindescheider uit die een writer vóór endstream invoegt. Wanneer de opgegeven lengte precies op de markering uitkomt, wordt die opgave geaccepteerd. Wanneer dat niet zo is, voert de reparatietool een begrensde zoekactie uit naar het endstream- en endobj-paar en trekt precies één scheider af, een CR, een LF of een CRLF. Dit met één byte fout doen, levert een bestand op dat opent en een pagina rendert met één afdwalende operator aan het einde van zijn content stream
Wat de trailer mag behouden
De herbouwde trailer is geen kopie van de oude. /Size, /Prev en /XRefStm beschrijven allemaal de vorige bestandslay-out en worden opnieuw berekend of weggelaten. Alleen entries waarvan de doelen zijn gevalideerd, blijven bestaan: /Info, /ID en /Encrypt. En /Root moet naar precies één Catalog-object verwijzen — niet nul, en niet meerdere, wat gebeurt bij een bestand dat is samengesteld door objectblokken te knippen en te plakken
Outputveiligheid wordt behandeld zoals het hoort voor een tool die draait op bestanden waar mensen om geven. Het resultaat wordt naar een tijdelijk bestand in de doelmap geschreven, vervolgens geverifieerd door het via het normale traject te laden met cross-reference-herstel uitgeschakeld, zodat een bestand dat alleen opent dankzij herstel als een mislukking telt. Pas nadat de paginaboom is geverifieerd, vervangt het tijdelijke bestand het doel atomair. Een mislukte reparatie overschrijft nooit een bestaande output
Budgetten en eerlijke faalcodes
Drie limieten begrenzen het werk: invoerbytes, aantal kandidaat-objecten en maximaal objectnummer, standaard 8 GiB, twee miljoen en twee miljoen. Het objectnummerplafond doet er meer toe dan het lijkt, omdat een schaarse tabel met enkele objecten genummerd in de miljarden anders de herbouwde cross-reference-tabel enorm zou opblazen. Klassieke cross-reference-tabellen weigeren ook offsets die meer dan tien decimale cijfers zouden vergen, wat een formaatbeperking is en geen implementatiekeuze
Fouten rapporteren een specifieke status in plaats van een boolean: ongeldige argumenten, bron te groot, geen diagnostisch bestand, objectlimiet overschreden, ongeldig object, dubbel object, ontbrekende catalogus, ongeldige trailer, outputfout of validatie mislukt. Elk daarvan wijst naar een andere oplossing. Een dubbel object betekent dat u een objectblok twee keer hebt geplakt. Een ontbrekende catalogus betekent meestal dat het object met /Type /Catalog beschadigd was. Validatie mislukt betekent dat de structuur nu consistent is maar de paginaboom niet laadt, wat doorgaans een /Kids-array is die niet in de pas is bewerkt met zijn /Count
Twee praktische opmerkingen sluiten de cirkel. Bewaar het diagnostische bestand, niet alleen het gerepareerde, zodat de volgende bewerking begint vanaf een leesbare basis. En lever geen diagnostische output aan eindgebruikers: het is groter dan een normale opslag omdat niets in object streams wordt gecomprimeerd, en het productietraject voor een compact bestand is het gewone opslagtraject beschreven in object streams en incrementele updates. Wanneer het doel is te ontdekken wat er mis is in plaats van het te veranderen, antwoordt het geautomatiseerde traject in automatisering van preflight-rapporten sneller dan bytes lezen
Diagnostisch opslaan, reparatie, preflight en vergelijking werken allemaal op hetzelfde geladen documentmodel in Delphi en C++Builder; de volledige functielijst staat op de HotPDF Delphi PDF component-pagina