Het content-stream-fragment [(Reference)-333(Manual)] TJ tekent twee woorden met een duidelijke tussenruimte, maar bevat helemaal geen spatiekarakter. De tussenruimte is pennbeweging: ISO 32000-1 §9.4.3 opdracht de lezer de volgende glyph 333 duizendsten van de fontgrootte naar rechts te schuiven voordat Manual wordt getekend. Een extractor die karakters kopieert en geometrie negeert geeft ReferenceManual terug, en een zoekindex die hem voedt matcht nooit de zin “Reference Manual”. TeX-uitvoer, veel Distiller-bestanden en de meeste uitgevulde layouts scheiden woorden op deze manier
Regeleinden lopen vanaf de andere kant mis. Een superscript die boven de baseline staat splitst zijn regel in twee, een diagonale DRAFT-watermerk komt binnen met één karakter per regel, en een afgekapte proefopdruk begint met de slug line van de printer die geen enkele viewer toont. Geen van deze bestanden is kapot. Elk gebruikt een legale manier van tekstplaatsing die een extractor die karakters kopieert verkeerd leest
Woordspaties herbouwd uit glyph-geometrie
THotPDF.ExtractLoadedPageText in HotPDF Delphi Component bepaalt woordafbrekingen uit glyph-posities, en een spatiekarakter in de stream is slechts één van de signalen die hij leest. Langs de schrijfrichting van de vorige glyph meet hij de afstand van het einde van de eigen breedte van die glyph tot de oorsprong van de huidige glyph, en voegt één spatie in als de afstand meer dan 0,15 van de dooshoogte van de huidige glyph bedraagt, gemeten van ascent tot descent in user space. Voor het TJ-fragment hierboven zit een derde em ruim voorbij die grens voor elk gewoon tekstlettertype, dus leest de pagina-tekst Reference Manual
Twee condities houden de spatie tegen. Er wordt niets toegevoegd als de tekst tot nu toe al op een wit ruim eindigt of de volgende glyph er één is (spatie, tab, no-break space, ideografische spatie), dus producenten die wél spaties tonen krijgen nooit dubbele. Ook tussen twee CJK-karakters komt niets. Ideogrammen, kana, hangul en full-width-vormen tellen allemaal mee, want uitvullen rekt een Chinese of Japanse regel uit zonder dat die rek een woordgrens betekent. Los daarvan valt een glyphdoos met hoogte nul terug op de Tf-grootte als zijn hoogte. Elk getal dat de regel gebruikt staat op de glyphrecords opgeslagen, dus een bestand waarvan de spatiëring verkeerd oogt kan glyph voor glyph worden nagespeeld
uses
  SysUtils, HPDFDoc, HPDFContentStream;

// Drukt de tussenruimten af die ExtractLoadedPageText in spaties zou omzetten.
// Alleen horizontale tekst; ExtractLoadedPageGlyphs geeft de pagina-
// content stream zonder Form XObject-tekst en zonder het crop-filter
procedure DumpWordGaps(Pdf: THotPDF; PageIndex: Integer);
var
  Glyphs: THPDFGlyphArray;
  I: Integer;
  Height, Gap: Double;
begin
  if not Pdf.ExtractLoadedPageGlyphs(PageIndex, Glyphs) then
    Exit;
  for I := 1 to High(Glyphs) do
  begin
    if Glyphs[I].Vertical or Glyphs[I - 1].Vertical then
      Continue;
    // ascent-tot-descent-hoogte van de glyphdoos, in user space
    Height := Sqrt(Sqr(Glyphs[I].QuadX[3] - Glyphs[I].QuadX[0]) +
      Sqr(Glyphs[I].QuadY[3] - Glyphs[I].QuadY[0]));
    if Height <= 0 then
      Height := Abs(Glyphs[I].FontSize);
    // tussenruimte vanaf het einde van de eigen breedte van de vorige glyph
    Gap := Glyphs[I].BaselineStartX - Glyphs[I - 1].GlyphEndX;
    if (Height > 0) and (Gap > 0.15 * Height) then
      Writeln(Format('U+%.4x gap %.2f height %.2f: space',
        [Glyphs[I].Unicode, Gap, Height]));
  end;
end;
Waarom meten vanaf de eigen breedte van de glyph in plaats van de penpositie?
Omdat de penpositie na een glyph al spatiëring bevat die niets met woordafbrekingen te maken heeft. ISO 32000-1 §9.4.4 definieert de horizontale verplaatsing als glyphbreedte keer fontgrootte, plus karakterafstand Tc, plus woordafstand Tw, alles geschaald met horizontale schaling Tz. Elk glyphrecord draagt beide uiteinden mee: BaselineEndX / BaselineEndY bevatten die volledige verplaatsing, terwijl GlyphEndX / GlyphEndY alleen de advance van het lettertype op de huidige grootte en Tz bevatten. De twee lopen uit elkaar op bestanden die tracking aantrekken met een negatieve Tc en de spatie teruggeven via een TJ-correctie na elke glyph. Gemeten vanaf de pen ziet elke teruggave eruit als een tussenruimte, en een Chinese term als “95后” komt eruit als “9 5 后”. Gemeten vanaf de eigen breedte van de glyph geeft de correctie alleen terug wat Tc wegnam, en blijft de term intact
De drempel hangt om een vergelijkbare reden aan de dooshoogte van de glyph in plaats van aan de Tf-grootte. Word-exporten schrijven vaak 1 Tf en dragen de echte grootte in een geschaalde Tm, dus de fontgrootteoperand leest 1 terwijl de tekst 10 punten hoog is. Een regel die op die operand is geklemd zou de drempel op 0,15 punt zetten op zo'n pagina, en gewone kerningparen zouden beginnen te lezen als woordafbrekingen. De dooshoogte wordt gemeten nadat elke matrix is toegepast, dus 1 Tf met een geschaalde matrix en een kale 10 Tf geven dezelfde tekst
Twee randgevallen volgen rechtstreeks uit de geometrie. Een kop die met zeer losse letterspatiëring is gezet, waarin Tc alleen al meer dan 0,15 van de texthoogte tussen letters opent, extraheert als S P A C E D. Dat is hoe de pagina eruitziet, en we geven het liever terug dan dat we een heuristiek toevoegen die gokt welke wijde tussenruimten tracking zijn en welke woorden zijn; zo'n gok begint in strak uitgevulde kolommen echte woordafbrekingen in te slikken, en dat is een ergere faling voor zoekopdrachten. Onderdelen die op één baseline uit volgorde zijn getekend geven een negatieve tussenruimte en plakken zonder spatie samen. In lopende tekst is dat geval zeldzaam
Wanneer begint een nieuwe regel in de geëxtraheerde tekst?
ExtractLoadedPageText begint een nieuwe regel wanneer de beweging van de oorsprong van de vorige glyph naar de huidige, geprojecteerd op de normaal van de vorige schrijfrichting, meer dan de helft bedraagt van de grotere dooshoogte van de twee glyphs. Beweging langs de baseline telt nooit mee voor een regeleinde, hoe ver de pen ook springt
Een regel die de kale Y-beweging vergelijkt met de helft van de Tf-grootte faalt in twee richtingen. Met 1 Tf en een geschaalde Tm krimpt de drempel tot een halve eenheid, dus breekt een superscript die met een text rise van 0,4 is verhoogd de regel. Ook de kleine baseline-jitter die sommige layout-engines tussen runs achterlaten doet dat. Dezelfde regel negeert X volledig. Tekst onder een gedraaide Tm, zoals dat diagonale watermerk, stapt met elke glyph de pagina af en komt eruit als één karakter per regel, terwijl de projectie een run van 45 graden exact als een horizontale behandelt
Het nemen van de grootste van de twee hoogtes telt wanneer groottes op één regel mengen. Een displaywoord van 36 punten gevolgd door een bijschrift van 8 punten een paar punten lager wordt beoordeeld tegen de helft van de hoogte van de grote glyph, dus het paar blijft bij elkaar; beoordeeld tegen de kleine glyph alleen zou het bijschrift op een eigen regel belanden. De text rise zit in de glyphoorsprong, wat is waarom de verhoogde baseline van een superscript tegen diezelfde helft wordt gemeten
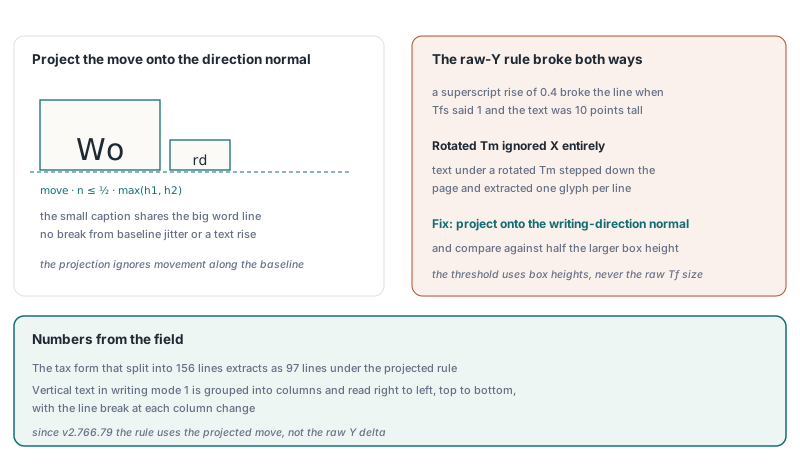
Verticale tekst in writing mode 1 (§9.7.4.3) volgt een apart pad. Die glyphs worden op hun oorsprong-X in kolommen gegroepeerd, met de helft van de fontgrootte als kolomtolerantie, dan van rechts naar links en van boven naar beneden gelezen, met een regeleinde bij elke kolomwissel. Een pagina die een verticale Japanse body mengt met een horizontale koptekst krijgt ook bij elke wissel tussen de twee richtingen een regeleinde
Welke glyphs halen het in de pagina-tekst
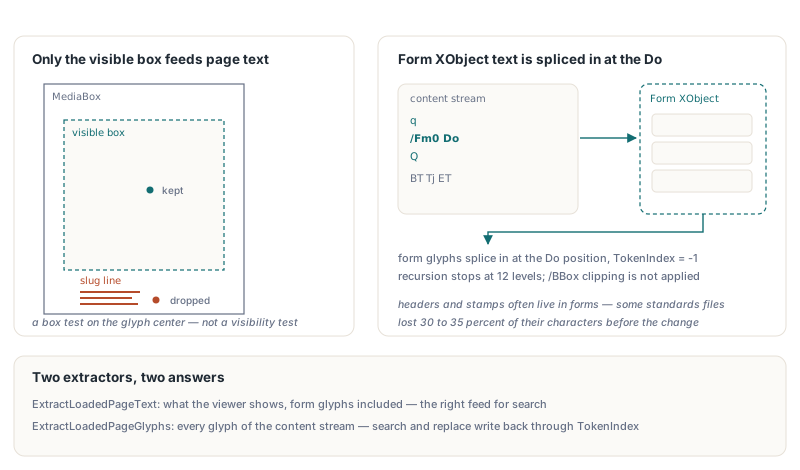
ExtractLoadedPageText geeft de tekst terug die een viewer toont. Hij houdt alleen glyphs waarvan het doosmidden binnen GetLoadedPageVisibleBox valt, de CropBox geknipt tot de MediaBox (§14.11.2), dus slug lines en andere printermerken die als tekst buiten het snijgebied staan vallen weg. ExtractLoadedPageGlyphs blijft elke glyph van de pagina-content stream teruggeven, slug line inbegrepen, voor de jobs die hem nodig hebben. Het filter is een geometrische test op één punt per glyph. Tekst die achter een clipping path verborgen is, wit wordt geschilderd of door een afbeelding wordt bedekt komt toch naar boven, want echte zichtbaarheid bepalen betekent de pagina renderen
uses
  SysUtils, HPDFDoc, HPDFContentStream;

var
  Pdf: THotPDF;
  Raw, Merged: THPDFGlyphArray;
  PageText: UnicodeString;
  L, B, R, T: Single;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('trimmed-proof.pdf');
    if Pdf.GetLoadedPageVisibleBox(0, L, B, R, T) then
      Writeln(Format('Visible box: %.1f %.1f %.1f %.1f', [L, B, R, T]));
    // elke glyph van de pagina-content stream, slug line inbegrepen
    if Pdf.ExtractLoadedPageGlyphs(0, Raw) then
      Writeln(Length(Raw), ' glyphs in the page content stream');
    // pagina-stream plus Form XObject-tekst, in schildervolgorde, vóór de crop
    if Pdf.ExtractLoadedPageGlyphsWithForms(0, Merged) then
      Writeln(Length(Merged), ' glyphs including forms');
    // wat de pagina toont: forms ingevoegd, glyphs buiten de crop weggegooid
    if Pdf.ExtractLoadedPageText(0, PageText) then
      Writeln(PageText);
    // dezelfde spatiëringsregels toegepast op de ongefilterde stream, voor een diff
    Writeln(HPDFAssemblePageText(Raw));
  finally
    Pdf.Free;
  end;
end.
Tekst die via Form XObjects wordt geschilderd is deel van de pagina-tekst. Koppen, stempels en watermerken wonen heel vaak in forms, en een extractor die alleen de pagina-content stream leest ziet ze nooit. HotPDF registreert elke Do samen met de CTM die op dat moment geldt, interpreteert de form op zijn /Matrix keer die CTM (§8.10.1) en voegt de glyphs van de form in op de positie van de Do, met recursie in geneste forms. Een form zonder eigen /Resources leent die van de stream die hem schildert, de oudere regeling die §7.8.3 beschrijft. Glyphs wiens midden buiten de /BBox van de form valt blijven buiten, want die doos knipt de form bij het schilderen. Een form die zichzelf schildert, direct of via een andere form, wordt geen tweede keer betreden, en de nesting stopt op 12 niveaus
Formglyphs dragen TokenIndex = -1 en ItemIndex = -1. Dezelfde reden houdt ExtractLoadedPageGlyphs beperkt tot pagina-stream-glyphs: zoeken, vervangen en redactie schrijven hun wijzigingen terug via TokenIndex, en een formglyph in die array zou ze naar bytes in een andere stream laten wijzen. Heeft u de samengevoegde lijst op glyphniveau nodig, dan geeft ExtractLoadedPageGlyphsWithForms hem terug in schildervolgorde, voordat het visible-box-filter draait
Nog één pass draait vóór de spatiëringsregels. Overprinted logo's en valse vet die door dezelfde tekst tweemaal met een kleine offset te schilderen wordt gemaakt, zouden anders met elke letter verdubbeld extraheren. Als een glyph hetzelfde karakter op dezelfde grootte schildert binnen een tiende van die grootte langs de baseline, en een vijfde er dwars op, van een eerdere glyph, dan blijft alleen één kopie over; spaties worden op deze manier nooit verwijderd. Het artikel over fake bold en dubbele glyphs in tekstextractie loopt dat geval door
De tekststatus over q en Q heen
Tekst na een Q decodeert verkeerd in elke extractor die bij q alleen de CTM bewaart. De tekststatusparameters, namelijk font, grootte, Tc, Tw, Tz, TL, rendering-modus en rise, horen bij de graphics state (§9.3.1), dus Q moet ze samen met al het andere op de stapel herstellen (§8.4.2). Eén patroon legt de fout snel bloot: een twee-byte Identity-H-lettertype wordt binnen q … Q geselecteerd voor één enkele tabelcel, en de tekst na de Q toont één-byte WinAnsi-strings zonder eigen Tf. Een interpreter die het binnenste lettertype vasthoudt leest die bytes in paren, en de dot leaders van een inhoudsopgave veranderen in een reeks losse CJK-karakters. De interpreter van HotPDF duwt alle acht tekststatuswaarden samen met de CTM op de stapel bij elke q en popt ze bij elke Q
Al het bovenstaande geldt op elke pagina, dus een heel document kan in één aanroep naar een UTF-8-bestand. ExtractLoadedPagesTextToStream neemt een paginabereik vanaf 1 (een lege string betekent elke pagina), een scheider die tussen pagina's wordt geschreven en een vlag voor de byte order mark, en geeft het aantal geëxtraheerde pagina's terug. Uitvoer wordt toegevoegd op de huidige positie van de stream, dus niets groter dan de tekst van één pagina wordt in het geheugen vastgehouden
uses
  SysUtils, Classes, HPDFDoc;

var
  Pdf: THotPDF;
  Output: TFileStream;
  Pages: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('report.pdf');
    Output := TFileStream.Create('report.txt', fmCreate);
    try
      // leeg bereik = elke pagina; form feed tussen pagina's; UTF-8 BOM
      Pages := Pdf.ExtractLoadedPagesTextToStream(Output, '', #12, True);
      Writeln(Pages, ' pages extracted');
    finally
      Output.Free;
    end;
  finally
    Pdf.Free;
  end;
end.
De tekst-API kiezen die bij de klus past
Voor zoeken en indexeren is ExtractLoadedPageText de juiste voeding: hij volgt de content-stream-volgorde en weerspiegelt wat de pagina toont. De decodeerketen eronder, van /ToUnicode-maps tot CID-lettertypen, staat in tekst uit geladen PDF's extraheren met HotPDF. Content-stream-volgorde is het zwakst bij getagde documenten waarvan de producent de lopende kop laatst heeft geschreven of twee kolommen heeft doorweefd; daarvoor wandelt tekstextractie in structuurvolgorde de boomstructuur af in auteurvolgorde in plaats van ze uit de geometrie af te leiden. Data die in tabellen vastzit wordt beter bediend door getypeerde tabelextractie over paginagrenzen heen, die cellen met hun waarden teruggeeft. Code die de pagina bewerkt hoort bij ExtractLoadedPageGlyphs, wiens tokenindices naar de bytes wijzen die hij zal herschrijven
De glyphrecordvelden die in deze voorbeelden worden gebruikt, samen met de rest van de tekstextractie-API en een proefbuild, staan gedocumenteerd op de productpagina van HotPDF Delphi PDF Component