OCR-tekstlagen, barcode-grenzen en gezichtsredactie-boxen drijven af op bijgesneden PDF-pagina's zodra bitmappixels via de MediaBox worden terug gemapt in plaats van via de box die de renderer werkelijk heeft gerasterd: de CropBox afgeknipt op de MediaBox (ISO 32000-1 §14.11.2). HotPDF mapt de resultaten van ApplyLoadedOCRTextLayer, DecodeLoadedPageBarcodes en DetectLoadedRedactionFindings via die zichtbare box, en elke custom engine of detector die u schrijft moet hetzelfde doen
Het symptoom is makkelijk te herkennen zodra je het gezien hebt. Een gescand contractarchief gaat door een OCR-pijplijn, de uitvoer is doorzoekbaar, en de zoektreffer voor een clausulenummer wordt een halve inch eronder en links van het gedrukte nummer gemarkeerd. De meeste bestanden in de batch zijn in orde. De verschoven exemplaren komen allemaal van één scanstation dat een /CropBox wegschrijft om de platrand bij te snijden. Dat ene detail scheidt het beeld dat de OCR-engine zag van het kader waarin de tekstlaag werd geplaatst, en dezelfde mismatch verplaatst barcode-grenzen en, serieuzer, gezichtsredactie-boxen
Waarom drijft de OCR-tekstlaag weg van de gescande woorden?
De tekstlaag drijft af wanneer twee helften van de pijplijn het oneens zijn over welke rechthoek de bitmap dekt. HotPDF-rendering, SVG-export, de viewer en afdrukken eren de CropBox: een pagina wordt getoond via zijn CropBox afgeknipt op zijn MediaBox, wat ISO 32000-1 §14.11.2 voorschrijft, en GetLoadedPageVisibleBox geeft die zichtbare box terug. Een device-naar-pagina-transformatie gebouwd vanuit GetLoadedPageBox(PageIndex, pbMediaBox, ...) gaat er daarentegen van uit dat de raster de MediaBox dekt, dus de raster en de transformatie beschrijven verschillende rechthoeken en elke herkende positie komt terug verschoven om de afstand tussen de twee
Dit goed krijgen betekent drie dingen per herkenningsfunctie in overeenstemming houden: de transformatie, de pixelbudgetschatting en de paginabox die in het requestrecord aan een custom engine wordt meegegeven. HotPDF leidt alle drie af uit de zichtbare box, wat ook betekent dat herkenning alleen content ziet die viewers werkelijk tonen
Een paar gevallen zijn immuun voor de mismatch:
- Pagina's zonder
/CropBox, of waarvan de CropBox gelijk is aan de MediaBox, mappen via beide boxen identiek DecodeLoadedPageBarcodesmetHasRegiongezet rendert exact de regio die u doorgeeft en mapt via diezelfde regio; de controle dat de regio binnen de pagina ligt, gebruikt de MediaBox- Op patronen gebaseerde redaction findings (e-mailadressen, kaartnummers enzovoort) komen uit tekstextractie in user space, niet uit een raster, dus alleen de gezichtsdetectie-findings hangen van de rastermapping af
Drie coördinaatframes, en welke HotPDF-API's elk gebruiken
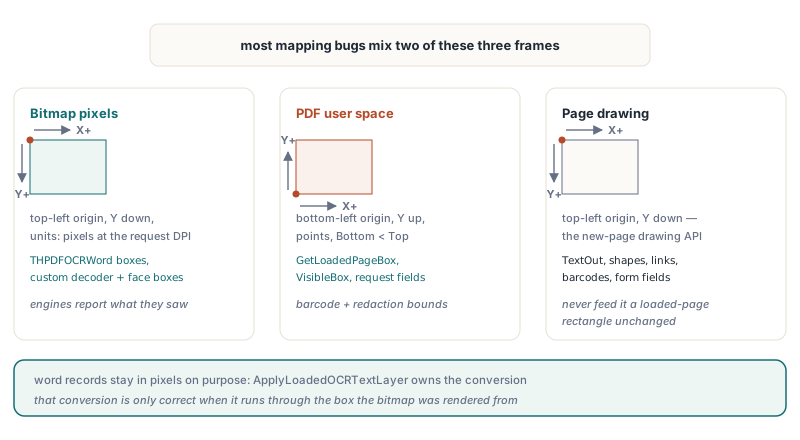
Code die HotPDF-herkenning aanraakt, werkt met drie frames, en de meeste mappingfouten komen van het door elkaar halen van twee ervan
- Bitmappixels: origine linksboven, Y groeit omlaag, de eenheden zijn pixels bij de aangevraagde DPI.
THPDFOCRWord.Left,Top,RightenBottomzitten in dit frame, net als de optionele baseline-punten, de resultaten die een customIHPDFBarcodeDecoderteruggeeft en de boxes van een customIHPDFFaceDetector - PDF user space van een geladen pagina: origine linksonder, Y groeit omhoog, de eenheden zijn punten, met
Bottom < Top.GetLoadedPageBoxenGetLoadedPageVisibleBoxgeven Left, Bottom, Right, Top terug in dit frame, en dat geldt ook voor de veldenPageLeft,PageBottom,PageRightenPageTopvanTHPDFOCRRequest, de grenzen inTHPDFDecodedBarcodeen de rechthoeken inTHPDFRedactionFinding - HotPDF pagina-tekencoördinaten: de API waarmee u nieuwe pagina's bouwt (tekstuitvoer, vormen, barcodes, links, formuliervelden) werkt met een origine linksboven en Y groeiend omlaag. Dat frame hoort bij documentgeneratie en heeft niets te maken met de hierboven genoemde geladen-document-API's, dus voer er nooit ongewijzigd een user-space-rechthoek van een geladen pagina in
Het OCR-wordrecord is bewust pixelgebaseerd: een engine meldt wat hij in de afbeelding zag, en ApplyLoadedOCRTextLayer bezit de conversie. Die scheiding werkt alleen als de conversie de juiste box gebruikt, en daarom bouwt HotPDF haar uit de zichtbare box
De device-naar-pagina-transformatie achter OCR, barcodes en gezichten
HotPDF mapt bitmappixels naar de pagina met één affiene matrix gebouwd uit vijf invoeren: de rotatie, de schaal DPI / 72, de bitmaphoogte en de Left, Bottom, Right en Top van de gerenderde box. OCR, barcodedecodering en gezichtsdetectie delen één routine daarvoor, dus de box-invoer bepaalt tegelijk de nauwkeurigheid van alle drie. Voor een ongedraaide pagina is de pagina-naar-device-matrix [A B C D E F]:
A = ScaleenD = -Scale, waarbijScale = DPI / 72; de negatieveDklapt user space (Y omhoog) om naar bitmapruimte (Y omlaag)B = C = 0, want een ongedraaide pagina heeft geen shear of assenwisselE = -Left * Scale, wat de linkerboxrand naar pixelkolom 0 verplaatstF = BitmapHeight + Bottom * Scale, wat de onderrand van de box op y = BitmapHeight mapt, de onderrand van de bitmap, zodat de bovenrand op rij 0 uitkomt
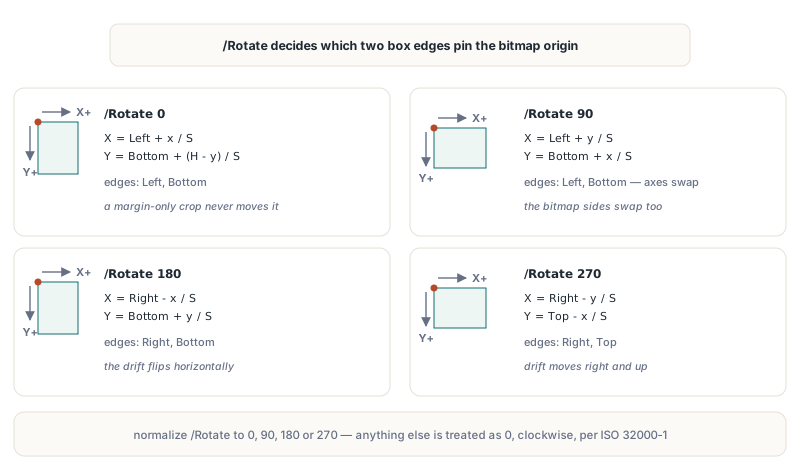
Pixels gaan via de inverse van die matrix terug naar de pagina. Request.PageRotation voert de /Rotate van de pagina genormaliseerd naar 0, 90, 180 of 270 (elke waarde die geen veelvoud van 90 is, geldt als 0), en de renderer draait de pagina met de klok mee zoals ISO 32000-1 §7.7.3.3 vereist. Onder rotatie wisselen de assen en zit een ander paar boxranden vast aan de bitmaporigine. Uitgeschreven als inverse formules, met S = DPI / 72, x en y in pixels en H de bitmaphoogte:
| /Rotate | Pagina-X | Pagina-Y | Boxranden waar de mapping van afhangt |
|---|---|---|---|
| 0 | Left + x / S | Bottom + (H - y) / S | Left, Bottom |
| 90 | Left + y / S | Bottom + x / S | Left, Bottom |
| 180 | Right - x / S | Bottom + y / S | Right, Bottom |
| 270 | Right - y / S | Top - x / S | Right, Top |
De laatste kolom verklaart waarom een MediaBox-gebaseerde mapping in productie willekeurig lijkt. Een CropBox die alleen de bovenkant van de pagina bijsnijdt laat Left en Bottom onaangeroerd, dus rechtopstaande pagina's komen er perfect uit en alleen pagina's met /Rotate 270 drijven af. Rotatie wisselt bovendien de bitmapdimensies: bij 90 en 270 is de bitmap (Top - Bottom) * S pixels breed en (Right - Left) * S pixels hoog
Wat gaat er mis met MediaBox [0 0 612 792] en CropBox [36 36 576 756]?
Met een half-inch crop aan elke kant landt de tekstlaag van een ongedraaide pagina precies 36 punten links van en 36 punten onder de gescande woorden zodra de MediaBox wordt gebruikt. Neem een US Letter-pagina waarvan de CropBox 36 punten (0,5 inch) van elke rand afsnijdt. De zichtbare box is 540 bij 720 punten, dus bij de default OCR-resolutie van 300 DPI is de schaal 300 / 72 ≈ 4.1667 en is de bitmap 2250 bij 3000 pixels
Stel dat de engine een woord meldt met pixelbox Left 450, Top 600, Right 900, Bottom 660 en geen baseline. HotPDF zet de baseline dan 20 procent van de woordhoogte boven de onderrand, op pixelrij 648, en mapt het startpunt (450, 648):
- Via de zichtbare box: x = 36 + 450 / 4.1667 = 144.0 en y = 36 + (3000 - 648) / 4.1667 = 600.48, en dat is waar het woord gedrukt staat
- Via de MediaBox: x = 0 + 108.0 = 108.0 en y = 0 + 564.48 = 564.48, een uniforme verschuiving van (-36, -36) punten
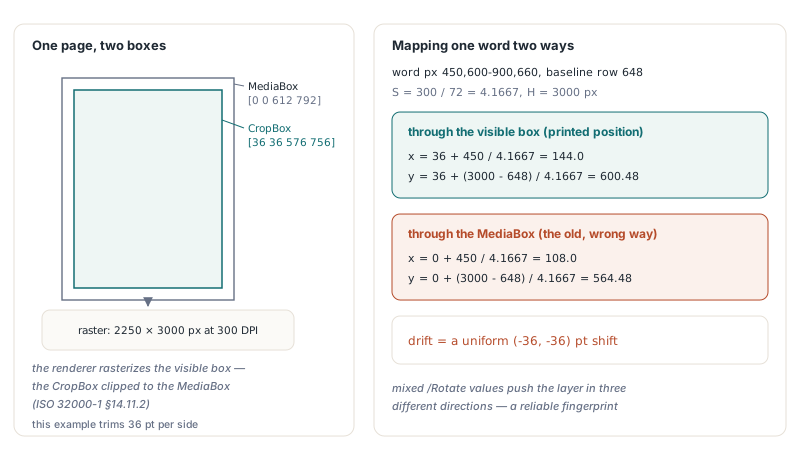
Draai dezelfde pagina en de richting van de fout verandert, omdat andere randen meespelen. Bij /Rotate 180 gebruikt de X-term Right, en 612 in plaats van 576 duwt de laag 36 punten naar rechts terwijl Bottom haar nog steeds 36 punten omlaag trekt. Bij /Rotate 270 zijn zowel Right als Top te groot, dus de laag schuift 36 punten naar rechts en 36 punten omhoog. Een document met gemengde oriëntaties kan de drift in drie richtingen tonen, een betrouwbare vingerafdruk voor deze fout. Handgeschreven code die de schaal uit de box afleidt, zoals Bitmap.Width / (Right - Left), rekt bovendien elke coördinaat met 612 / 540 uit, ruwweg 13 procent, bovenop de verschuiving
Welke van uw PDF-pagina's hebben CropBox-bewuste mapping nodig?
Een PDF-document vraagt om zorg zodra ten minste één pagina een zichtbare box heeft die verschilt van zijn MediaBox, en HotPDF kan dat in een paar regels vaststellen. Vergelijk GetLoadedPageBox met pbMediaBox tegen GetLoadedPageVisibleBox voor elke pagina, en print GetLoadedPageRotation ernaast zodat u de driftrichting uit de tabel hierboven kunt voorspellen. THPDFPageBoundary biedt ook pbCropBox, pbBleedBox, pbTrimBox en pbArtBox, maar GetLoadedPageBox(pbCropBox) valt terug op de MediaBox als er geen crop box bestaat en knipt niet af, dus de zichtbare box is het juiste vergelijkingspunt
uses
  System.SysUtils, HPDFDoc;

procedure ReportCroppedPages(const FileName: string);
var
  Pdf: THotPDF;
  I: Integer;
  ML, MB, MR, MT, VL, VB, VR, VT, Tmp: Single;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile(FileName) < 1 then
      raise Exception.Create('Cannot load ' + FileName);
    for I := 0 to Pdf.LoadedPageCount - 1 do
    begin
      if not Pdf.GetLoadedPageBox(I, pbMediaBox, ML, MB, MR, MT) then
        Continue;
      // de opgeslagen array mag zijn hoeken in willekeurige volgorde noemen
      if MR < ML then begin Tmp := ML; ML := MR; MR := Tmp; end;
      if MT < MB then begin Tmp := MB; MB := MT; MT := Tmp; end;
      // al genormaliseerd en tegen de MediaBox afgeknipt
      if not Pdf.GetLoadedPageVisibleBox(I, VL, VB, VR, VT) then
        Continue;
      if (Abs(VL - ML) > 0.01) or (Abs(VB - MB) > 0.01) or
         (Abs(VR - MR) > 0.01) or (Abs(VT - MT) > 0.01) then
        Writeln(Format('Page %d  MediaBox [%g %g %g %g]  visible [%g %g %g %g]  /Rotate %d',
          [I + 1, ML, MB, MR, MT, VL, VB, VR, VT,
           Pdf.GetLoadedPageRotation(I)]));
    end;
  finally
    Pdf.Free;
  end;
end;
Twee details van GetLoadedPageVisibleBox tellen voor scripts als dit. De functie laat zijn out-parameters onaangeroerd als ze faalt, dus vooraf een default paginaformaat zetten vóór de aanroep is een veilig patroon. En als een misvormde CropBox de MediaBox helemaal niet snijdt, geeft de functie de MediaBox terug in plaats van een lege rechthoek. Staat er in het rapport een pagina die een eerdere pijplijn via een MediaBox-gebaseerde mapping heeft ge-OCRd, bedenk dan dat de weggeschreven tekstlaag in het opgeslagen bestand blijft zitten: de default SkipPagesWithText-optie slaat die pagina's bij een tweede passe over tenzij u haar uitzet of de oude laag eerst verwijdert
Hoe mapt een custom IHPDFOCREngine pixels terug naar PDF-ruimte?
Een custom IHPDFOCREngine geeft woordboxen in bitmappixels terug en laat HotPDF het mappen doen; converteer alleen voor uw eigen beslissingen naar user space, en gebruik dan de box uit het request, nooit de MediaBox. De velden PageLeft, PageBottom, PageRight en PageTop van het request beschrijven de gerenderde zichtbare box, dus ze matchen Request.Bitmap exact. De helper hieronder is de inverse van de transformatie van de library, inclusief haar gebruik van de werkelijke bitmaphoogte voor rechtopstaande pagina's, dus hij is het tot op de pixel met HotPDF eens
uses
  System.SysUtils, System.Math, Vcl.Graphics, HPDFDoc;

// Bitmappixel (origine linksboven, Y omlaag) naar PDF user space
// (origine linksonder, Y omhoog), via de box waaruit de bitmap is gerenderd
procedure HotPixelToPage(Rotation, DPI, BitmapHeight: Integer;
  Left, Bottom, Right, Top: Single; X, Y: Double;
  out PageX, PageY: Double);
var
  S: Double;
begin
  S := DPI / 72.0;
  case Rotation of
    90:  begin PageX := Left + Y / S;  PageY := Bottom + X / S; end;
    180: begin PageX := Right - X / S; PageY := Bottom + Y / S; end;
    270: begin PageX := Right - Y / S; PageY := Top - X / S; end;
  else
    PageX := Left + X / S;
    PageY := Bottom + (BitmapHeight - Y) / S;
  end;
end;
Een realistische reden om user space binnen een engine nodig te hebben is een zoneregel: facturen waarvan u het briefhoofd nooit doorzoekbaar wilt hebben, of een stempelvlak dat de recognizer in de war stuurt. De engine hieronder, geschreven met TInterfacedObject zodat referentietelling de levensduur regelt, filtert woorden op waar hun middens op de pagina vallen, en geeft de overlevenden ongewijzigd in pixelcoördinaten terug. RunRecognizer staat model voor uw eigen recognizeraanroep
type
  TZoneFilterOCREngine = class(TInterfacedObject, IHPDFOCREngine)
  private
    FSkipLeft, FSkipBottom, FSkipRight, FSkipTop: Single;  // user space
    function RunRecognizer(Bitmap: TBitmap; MaxWords: Integer;
      out Words: THPDFOCRWords): boolean;  // uw recognizer, pixelboxen
  public
    constructor Create(SkipLeft, SkipBottom, SkipRight, SkipTop: Single);
    function GetName: AnsiString;
    function Recognize(const Request: THPDFOCRRequest;
      out Words: THPDFOCRWords; out Diagnostic: AnsiString): boolean;
  end;

function TZoneFilterOCREngine.Recognize(const Request: THPDFOCRRequest;
  out Words: THPDFOCRWords; out Diagnostic: AnsiString): boolean;
var
  Raw: THPDFOCRWords;
  I, Count: Integer;
  CX, CY: Double;
begin
  Diagnostic := '';
  SetLength(Words, 0);
  if not RunRecognizer(Request.Bitmap, Request.MaxWords, Raw) then
  begin
    Diagnostic := 'recognizer failed';
    Exit(False);
  end;
  SetLength(Words, Length(Raw));
  Count := 0;
  for I := 0 to High(Raw) do
  begin
    HotPixelToPage(Request.PageRotation, Request.DPI,
      Request.Bitmap.Height, Request.PageLeft, Request.PageBottom,
      Request.PageRight, Request.PageTop,
      (Raw[I].Left + Raw[I].Right) / 2, (Raw[I].Top + Raw[I].Bottom) / 2,
      CX, CY);
    if (CX >= FSkipLeft) and (CX <= FSkipRight) and
       (CY >= FSkipBottom) and (CY <= FSkipTop) then
      Continue;
    Words[Count] := Raw[I];  // nog steeds pixels: HotPDF mapt ze zelf
    Inc(Count);
  end;
  SetLength(Words, Count);
  Result := True;
end;
Geef de engine aan ApplyLoadedOCRTextLayer(PageIndices, Engine, Options, Info) zoals bij elke andere engine. De library valideert wat er terugkomt voordat ze het vertrouwt: een woord wordt laten vallen en geteld in Info.DroppedWordCount wanneer zijn box buiten de bitmap valt, wanneer Right <= Left of Bottom <= Top, of wanneer Confidence buiten 0..1 ligt of onder MinimumConfidence zit. Meer woorden teruggeven dan MaxWordsPerPage, of het lopende totaal voorbij MaxTotalWords duwen, laat de hele aanroep falen met een budgetfout, dus eer Request.MaxWords in de engine. Converteer woordboxen niet naar user space voordat u ze teruggeeft; HotPDF zou de puntwaarden als pixels behandelen en de laag zou naar de bitmaporigine inklappen
De uitvoer van uw eigen detector mappen
Dezelfde helper dient een eigen pijplijn gebouwd op RenderLoadedPageToBitmap, die de zichtbare box rendert en /Rotate toepast precies zoals de herkenningsfuncties doen. Lees de box met GetLoadedPageVisibleBox, normaliseer de rotatie op dezelfde manier als HotPDF, en map twee tegenovergestelde hoeken van elke pixelbox. De Y-as klapt om en, bij 90 en 270 graden, wisselen de assen, dus de gemapte hoeken komen in geen vaste volgorde naar buiten; neem het minimum en maximum van de gemapte punten, en dat is ook hoe HotPDF barcode-grenzen bouwt
const
  DPI = 200;
var
  Pdf: THotPDF;
  Bmp: TBitmap;
  VL, VB, VR, VT: Single;
  Rotation: Integer;
  PxL, PxT, PxR, PxB, X1, Y1, X2, Y2: Double;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('scanned-ids.pdf');
    if not Pdf.GetLoadedPageVisibleBox(0, VL, VB, VR, VT) then Exit;
    Rotation := Pdf.GetLoadedPageRotation(0) mod 360;
    if Rotation < 0 then Inc(Rotation, 360);
    if (Rotation <> 90) and (Rotation <> 180) and (Rotation <> 270) then
      Rotation := 0;
    Bmp := Pdf.RenderLoadedPageToBitmap(0, DPI);
    if Bmp = nil then Exit;
    try
      MyDetector(Bmp, PxL, PxT, PxR, PxB);  // uw code, pixelbox
      HotPixelToPage(Rotation, DPI, Bmp.Height, VL, VB, VR, VT,
        PxL, PxT, X1, Y1);
      HotPixelToPage(Rotation, DPI, Bmp.Height, VL, VB, VR, VT,
        PxR, PxB, X2, Y2);
      Writeln(Format('User-space box [%.2f %.2f %.2f %.2f]',
        [Min(X1, X2), Min(Y1, Y2), Max(X1, X2), Max(Y1, Y2)]));
    finally
      Bmp.Free;
    end;
  finally
    Pdf.Free;
  end;
end;
Het rotatiegedrag wordt dieper behandeld in paginarotatie afvlakken zonder de pagina-boxen te breken, en de barcodedecodeerpijplijn die dezelfde transformatie verbruikt in gedraaide QR-codes uit PDF-pagina's decoderen. Wrapt uw engine een externe recognizer, dan toont de Tesseract OCR-adapter voor doorzoekbare PDF de procesisolatie- en annuleringskant van dezelfde interface
Snelnaslag: CropBox-veilige coördinaatmapping
- De renderer rasteriseert de zichtbare box, de CropBox afgeknipt op de MediaBox (ISO 32000-1 §14.11.2); elke pixel-naar-pagina-mapping moet die box gebruiken, gelezen met
GetLoadedPageVisibleBox ApplyLoadedOCRTextLayer, volledige-paginaDecodeLoadedPageBarcodesen gezichtsfindings uitDetectLoadedRedactionFindingsmappen allemaal via de zichtbare box, en elke custom engine of detector moet dat ook doenTHPDFOCRWord-boxen zijn bitmappixels met origine linksboven;GetLoadedPageBoxenGetLoadedPageVisibleBoxgeven PDF user space terug met origine linksonder enBottom < Top- De schaal is
DPI / 72; leid haar af uit de DPI, nooit uit een paginabox gedeeld door de bitmapbreedte - /Rotate bepaalt welke randen tellen: Left en Bottom bij 0 en 90, Right en Bottom bij 180, Right en Top bij 270
- Geef OCR-woorden in pixels terug en laat HotPDF ze mappen; converteer alleen voor uw eigen filterlogica
- Bij het opnieuw draaien van OCR op pagina's die al een tekstlaag dragen, bedenk dat
SkipPagesWithTextze overslaat tenzij u haar uitzet of de oude laag eerst verwijdert
De herkenningsfuncties, pagina-box-queries en geladen-document-rendering die hier worden gebruikt, worden alle geleverd in de HotPDF-component voor Delphi en C++Builder; licenties, proefdownloads en de volledige functielijst staan op de HotPDF Delphi PDF-componentpagina