Het eerste object in een gelineariseerde PDF moet de exacte lengte van het bestand waarin hij zit aangeven, tot op de byte, en hij moet binnen de eerste 1024 bytes verschijnen. ISO 32000-1 Annex F noemt die entry /L, en een reader die hem met de echte bestandsgrootte ziet botsen krijgt de opdracht het document als een gewone PDF te behandelen en elke linearisatiehint erin te negeren. De writer moet dus de lengte printen van een bestand dat hij nog niet klaar heeft met schrijven, naast de offset van een hint stream, het einde van de eerste pagina en de positie van een cross-reference-tabel nabij het einde van het bestand. Alle vier de getallen verschuiven zodra iets ervoor van grootte verandert
De opbrengst is Fast Web View. Een gewone PDF bewaart zijn cross-reference-tabel achteraan, dus een browser die een gescand rapport van 200 pagina's krijgt kan pagina 1 pas vinden als de laatste byte binnen is; een gelineariseerd bestand zet pagina 1 en een klein cross-reference-deel vooraan, dus een client die HTTP range requests gebruikt tekent de eerste pagina vroeg. Wat volgt is de schrijfkant. Het lezersbeeld staat in de uitleg over PDF-linearisatie en Fast Web View
Hoe HotPDF een gelineariseerd bestand indeelt
HotPDF schrijft gelineariseerde output wanneer THotPDF.LinearizeOutput op True staat, en het bestand volgt de fysieke volgorde die Annex F voorschrijft, deel voor deel. Na de header komt het linearisatie-parameterdictionary, dan het cross-reference-deel van de eerste pagina met zijn trailer, de catalog met de andere documentniveau-objecten, de primaire hint stream, de eerste pagina met elk object dat hij nodig heeft, de resterende pagina's op volgorde, de objecten die latere pagina's delen, alles wat overblijft, en tenslotte de hoofdcross-reference-tabel
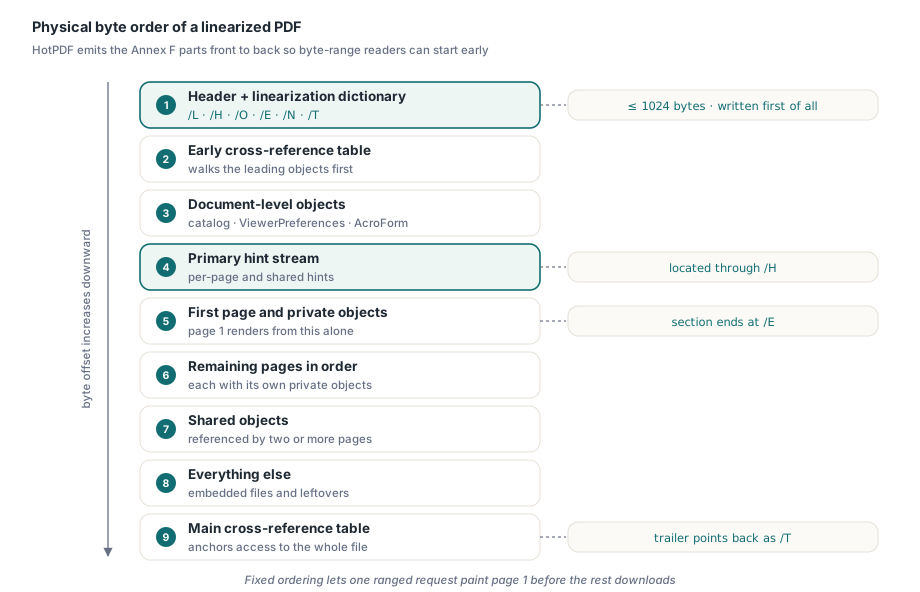
Niets in het documentmodel zegt bij welk deel een object hoort. De writer working dat uit vanuit de referentiegraaf op het moment dat EndDoc opslaat, wandelend vanaf elk paginaobject en tellend hoeveel pagina's elk indirect object bereiken. Een object dat vanaf één pagina wordt bereikt gaat naar het deel van die pagina. Een object dat vanaf meerdere pagina's wordt bereikt is gedeeld, met één nuance die een snelle lezing van de spec mist: wanneer pagina 1 tot de gebruikers behoort, gaat het object toch naar het eerste-pagina-deel, want pagina 1 moet uit de voorste bytes alleen kunnen renderen. Alleen objecten die puur onder latere pagina's worden gedeeld wachten in het gedeelde deel. De catalog, wat zijn /ViewerPreferences-, /OpenAction-, /Threads- en /AcroForm-entries ook aanwijzen, en het versleutelingsdictionary van een beveiligd document vormen samen de documentniveau-groep. Paginaboomknooppunten worden in het achterste deel geduwd zodat ze nooit de eerste pagina opblazen
Open de output in een hexeditor en de nummering oogt achterstevoren. Het voorste blok, van het linearisatie-dictionary tot de hint stream, draagt de hoogste objectnummers van het bestand, terwijl alles erna van 1 af wordt genummerd. Het kleine cross-reference-deel vooraan dekt precies dat hoge blok, en de hoofdtabel dekt 1 tot en met N
Een record-initialisatievalkuil in partitionlijsten
Lijsten zoals deze worden natuurlijk geschreven als een record met een dynamische array plus een aparte count, en juist die vorm verbergt een Delphi-valkuil. De compiler initialiseert de beheerde velden van een lokaal record. De kale Integer ernaast krijgt niets. Onder Win32 houdt de stackslot toevallig vaak nul, dus de eerste append landt op index 0 en elke test slaagt; onder Win64 kan het slot restjes bevatten en schrijft de eerste append naar een willekeurige index
type
  TPartList = record
    Values: TArray<Integer>;  // beheerd: door de compiler geleegd
    Count: Integer;           // onbeheerd: wat de stack toevallig bevatte
  end;

procedure Append(var List: TPartList; Value: Integer);
begin
  if List.Count = Length(List.Values) then
    SetLength(List.Values, List.Count * 2 + 16);
  List.Values[List.Count] := Value;
  Inc(List.Count);
end;

procedure BuildParts;
var
  FirstPage, Shared: TPartList;
begin
  FirstPage := Default(TPartList);   // vereist, niet cosmetisch
  Shared := Default(TPartList);
  Append(FirstPage, 12);
  Append(Shared, 40);
end;
De writer van HotPDF wijst elke partitionlijst Default toe voordat hij haar aanraakt. Een groene Win32-run zegt niets over of zo'n record was geïnitialiseerd
Waarom moet de layout convergeren voordat de eerste byte wordt weggeschreven?
Omdat de voorkant van het bestand offsets bevat die naar de achterkant wijzen, en het aantal cijfers in die offsets alles erachter verschuift. De trailer van de eerste pagina draagt een /Prev-entry met de byte-offset van de hoofdcross-reference-tabel. Schrijf die offset als 99998, kom er later achter dat de tabel echt op 100003 landt, en de trailer groeit met één cijfer. Het cross-reference-deel van de eerste pagina groeit mee, elk object erachter schuift één byte op, en de hoofdtabel zit nu op 100004. Eén enkele pass krijgt dit alleen bij toeval goed
HotPDF doorbreekt de cirkel in twee zetten. Het parameterdictionary gaat in een vaste slot van 384 bytes, opgevuld met spaties, zodat /L, /H, /E en /T de cijfers kunnen pakken die ze nodig hebben zonder ook maar één object te verschuiven; zou de dictionarytekst ooit meer dan 384 bytes nodig hebben, dan gooit de schrijfwijze een exception in plaats van het bestand te verschuiven. Daarmee is /Prev de enige vrije variabele, en hij loopt door een fixed-point-lus. Elk object wordt eerst geserialiseerd naar een counting stream die lengtes vastlegt en geen bytes houdt. Een layoutpass wijst daarna offsets sectie voor sectie toe en meldt waar de hoofdtabel zou landen, en dat antwoord wordt de input van de volgende pass. De lus stopt wanneer de voorgestelde offset ophoudt te bewegen en geeft na acht pogingen het op met een exception
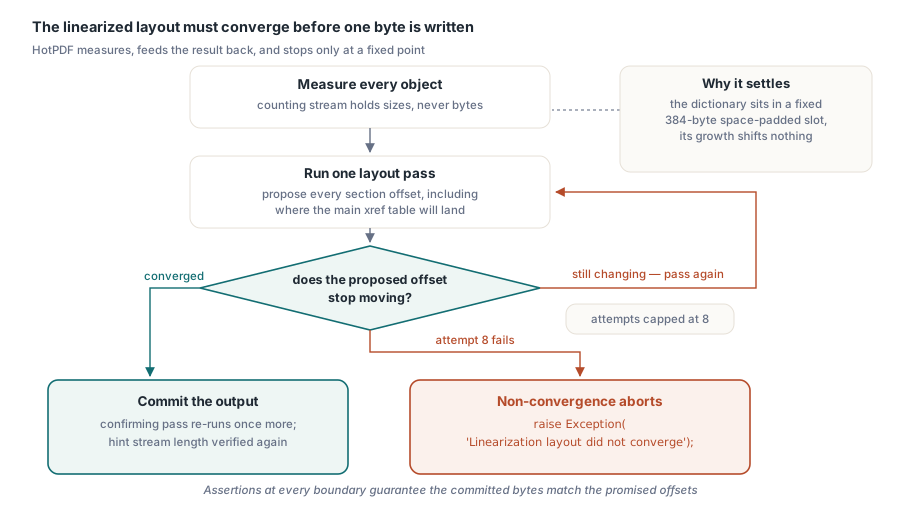
Alleen een verandering in cijferaantal verschuift iets, dus een derde pass is alleen nodig nabij een macht-van-tien-grens, zoals in het geval 99998. Na de convergentie draait de writer één bevestigende pass, herbouwt de hint stream met echte offsets en controleert dat zijn lengte niet veranderde; de offsets zitten in velden met vaste breedte, dus de placeholder-versie en de definitieve moeten matchen. Daarna gaat de output rechtstreeks naar de doelstroom zonder gebufferde tweede kopie, en bij elke sectiegrens worden de weggeschreven bytes vergeleken met de beloofde offset. Een mismatch gooit vanuit EndDoc
Hint tables, en waar Annex F op twee manieren leest
De primaire hint stream draagt twee tabellen. De page offset hint table legt per pagina vast hoeveel objecten zijn sectie bevat, hoe lang die sectie in bytes is, en van welke gedeelde objecten hij afhangt. De shared object hint table somt de lengte van elke gedeelde-objectgroep op. Daarmee kan een reader pagina 37 direct opvragen, en de /S-entry van de stream geeft de positie binnen de stream waar de gedeelde tabel begint
Twee details in Annex F F.4 zijn makkelijk fout te doen. Het eerste is dat offsets in de hint tables logische offsets zijn, berekend alsof de primaire hint stream niet bestond. Het eerste paginaobject en het eerste gedeelde object zitten fysiek beide na de hint stream, dus de writer trekt de lengte van het hint-object af voordat hij hun offsets vastlegt. Een writer die in plaats daarvan fysieke offsets vastlegt, ziet elk daaruit voortvloeiend range request precies de grootte van het hint-object ernaast zitten
Het tweede is een echte ambiguïteit. De tekst van F.4 beschrijft elke tabel als één doorlopende bitstroom, most significant bit eerst, en somt de gedeelde groepen van de eerste pagina en de latere gedeelde groepen op als twee aparte reeksen. Hint streams die in omloop zijn vullen elke kolom aan tot een bytegrens en behandelen de gedeelde groepen als één gecombineerde lijst, en dat is de vorm die hint-verwerkende readers naar wezenlijk weten accepteren. HotPDF schrijft de byte-uitgelijnde, gecombineerde layout. Dat is de juiste kant om te kiezen: een tabel die aan de letter van F.4 voldoet maar voor de clients die hem lezen verkeerd uitgelijnd is, faalt precies waar linearisatie zijn geld moest opleveren, en een volledige download van het bestand legt het probleem nooit bloot
Gelineariseerde output vanuit Delphi aanzetten
Aan de API-kant is de schakelaar één Boolean. LinearizeOutput default naar False, en de writer raadpleegt hem wanneer EndDoc het document serialiseert, dus zet hem bij de andere output-opties vóór BeginDoc en laat hem daarna met rust. Elke hierboven beschreven mislukking (niet-convergentie, een te groot parameterdictionary, een grensmismatch, de hieronder behandelde 4-GiB-plafond) komt naar boven als een exception vanuit EndDoc, wat een fallback eenvoudig maakt
procedure WriteReport(const FileName: string; Linearize: Boolean);
var
  PDF: THotPDF;
begin
  PDF := THotPDF.Create(nil);
  try
    PDF.FileName := FileName;
    PDF.Version := pdf17;
    PDF.LinearizeOutput := Linearize;   // vóór BeginDoc zetten
    PDF.BeginDoc;                       // maakt pagina 1 aan
    PDF.CurrentPage.TextOut(72, 72, 0, 'Quarterly summary');
    PDF.AddPage;
    PDF.CurrentPage.TextOut(72, 72, 0, 'Details');
    PDF.EndDoc;                         // layout en wegschrijven gebeuren hier
  finally
    PDF.Free;
  end;
end;

procedure PublishReport(const FileName: string);
begin
  try
    WriteReport(FileName, True);
  except
    on E: Exception do
    begin
      LogWarning('Linearization failed: ' + E.Message);  // uw eigen logger
      WriteReport(FileName, False);                       // gewone PDF in plaats daarvan
    end;
  end;
end;
De fallback levert een gewone PDF op die elke viewer opent; hij verliest alleen de snelle eerste pagina. Voor een rapportpijplijn is die afweging gemakkelijk, want een trage eerste paint is een ergernis en een ontbrekend rapport is een incident
De inzetkant weegt zwaarder dan de code. Linearisatie betaalt zich alleen terug wanneer de server HTTP Range-requests honoreert; een endpoint dat het bestand in één keer streamt koopt u een tragere schrijfwijze en een groter bestand voor niets. Laat LinearizeOutput uit voor bestanden die worden gemaild, bijgevoegd of gedownload voordat iemand ze opent. Zet hem aan voor documenten die een browser direct vanaf een URL opent, nadat u heeft bevestigd dat het antwoord Accept-Ranges: bytes draagt
Waarom schakelt LinearizeOutput object streams uit?
Omdat elke hint-table-entry een bytebereik beschrijft, en een object dat in een /ObjStm-container is gepakt geen eigen bytebereik heeft; hij bestaat alleen als plak van een andere gecomprimeerde stream die geheel moet worden opgehaald en geïnflateerd. Met LinearizeOutput aan schrijft HotPDF traditionele tekst-cross-reference-tabellen en uitgepakte indirecte objecten, ook wanneer UseXRefStream of UseObjectStreams ook is gezet. Het gelineariseerde pad gaat bij de save voor, dus uw code heeft geen conflict op te lossen
De kost is bestandsgrootte, want de kleine dictionaries die een object stream samen zou comprimeren blijven nu los. Als compacte output zwaarder weegt dan first-page-latentie, staat de afweging uitgelegd in object streams en incrementele updates in HotPDF. Office-exporters lopen van de andere kant tegen dezelfde spanning aan, en daarom emitteert een deel van hen de layout die wordt beschreven in hybride cross-reference-streams in door Office gegenereerde PDF's
Linearisatie heeft ook PDF 1.2 of later nodig. Bij een lagere Version promoveert HotPDF het document bij het opslaan naar 1.2. Met StrictVersionLock aangezet gooit hij in plaats daarvan een exception, want een versie die u met opzet heeft vastgezet hoort niet stilletjes achter uw rug te veranderen
Het 4-GiB-plafond op gelineariseerde output
Hint tables bewaren offsets en lengtes in 32-bits velden, dus een gelineariseerd bestand kan niets voorbij 4 GiB adresseren, en HotPDF weigert er één te produceren in plaats van offsets weg te schrijven die omslaan. Het plafond komt uit de veldbreedtes die Annex F definieert
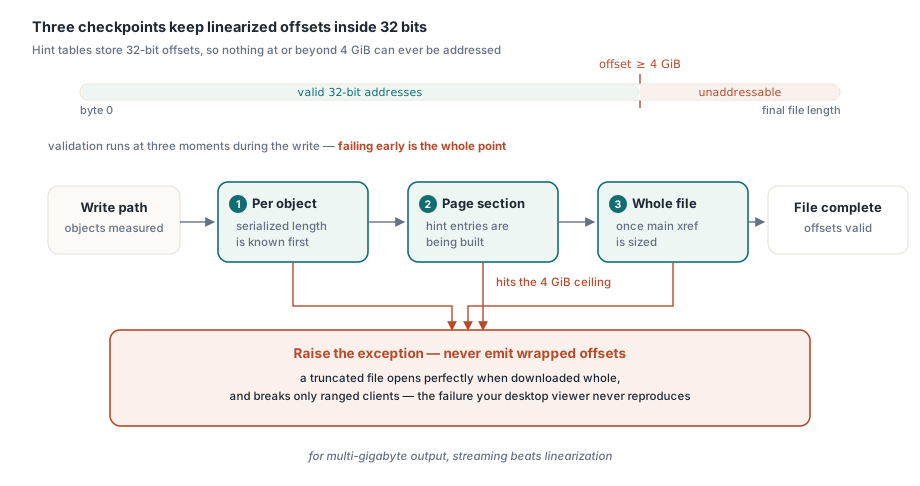
De controle draait op drie punten, alle drie voordat de eerste byte het doel bereikt: op elk object zodra zijn geserialiseerde lengte bekend is, op elke paginasectielengte terwijl de hint-entries worden gebouwd, en op de uiteindelijke bestandslengte zodra de hoofdcross-reference-tabel is gedimensioneerd. Omslaande offsets zouden de ergste manier zijn om te falen: een viewer die het hele bestand downloadt kan de hints negeren, terwijl de byte-range-client naar de verkeerde bytes springt, dus desktop-testing reproduceert de fout nooit. Voor output van meerdere gigabytes is de streamingroute in de Direct File API voor grote PDF-workflows de plek om te kijken
Controleren of een inkomend bestand gelineariseerd is
THotPDF.IsLoadedLinearized meldt of het geladen document zichzelf als gelineariseerd declareert. De controle gebeurt vóór het parsen: HotPDF leest tot 1024 bytes vanaf positie nul van de bron, vindt het eerste object, en zoekt daarin naar /Linearized met de waarde 1. Comments, literalen en hex-strings worden overgeslagen, dus de naam die binnen een string opduikt telt niet mee, en de scan stopt bij stream of endobj. Alleen 1 of een equivalent zoals 1.0 wordt geaccepteerd
Het antwoord wordt bij het laden gecached, want tegen de tijd dat applicatiecode het vraagt heeft de parser de streampositie verplaatst en heeft LoadFromFile zijn bronstroom al weer vrijgegeven
De flag meldt wat het bestand claimt. Annex F voegt een tweede voorwaarde toe: /L moet matchen met de echte bestandslengte, en een incrementele update die na de linearisatie wordt aangeplakt breekt die match, dus lezers vallen terug op het bestand als gewoon behandelen. Een pijplijn die bestanden van editors accepteert die hun saves aanplakken kan de twee getallen zelf vergelijken
// Eigen helper, geen deel van HotPDF: vergelijkt /L met de
// ware grootte; hij neemt één spatie na /L aan
function DeclaredLengthMatches(const FileName: string): Boolean;
var
  FS: TFileStream;
  Head: AnsiString;
  ActualSize: Int64;
  P, Q: Integer;
begin
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    ActualSize := FS.Size;
    SetLength(Head, 1024);
    SetLength(Head, FS.Read(Head[1], 1024));
  finally
    FS.Free;
  end;
  P := Pos(AnsiString('/L '), Head);
  Result := P > 0;
  if not Result then
    Exit;
  Inc(P, 3);
  Q := P;
  while (Q <= Length(Head)) and (Head[Q] in ['0'..'9']) do
    Inc(Q);
  Result := StrToInt64Def(string(Copy(Head, P, Q - P)), -1) = ActualSize;
end;

procedure InspectUpload(const FileName: string);
var
  PDF: THotPDF;
begin
  PDF := THotPDF.Create(nil);
  try
    if PDF.LoadFromFile(FileName) <= 0 then
      Exit;
    if not PDF.IsLoadedLinearized then
      Writeln('Not linearized')
    else if not DeclaredLengthMatches(FileName) then
      Writeln('Linearized, but modified after linearization')
    else
      Writeln('Ready for Fast Web View');
  finally
    PDF.Free;
  end;
end;
LinearizeOutput en IsLoadedLinearized maken deel uit van de HotPDF Delphi Component voor Delphi en C++Builder, en zijn productpagina documenteert hoe ze samenhangen met cross-reference-streams, object streams en version locking