Uw detectiecode meldt dat een PDF/UA-bestand van een andere producent niets claimt, en een PDF/R-scan geen PDF/R meer is op het moment dat een editor er een sticky note aan toevoegt. HotPDF leest deze claims uit een geladen document via accessors zoals IsLoadedPDFUA, GetLoadedPDFR1Version en GetLoadedPDFDeclarations, die elk kijken waar hun eigen standaard de identifier bewaart
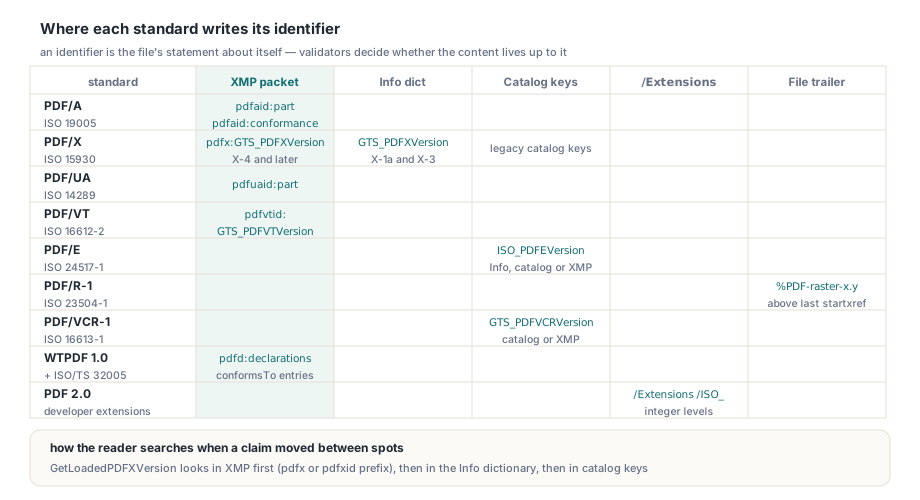
Waar elke PDF-standaard zijn identifier neerschrijft
De deelnormen zijn nooit tot één plek voor de claim gekomen. De meeste gebruiken XMP-eigenschappen in de /Metadata-stream van de catalog, een paar oudere vertrouwen nog op sleutels in de document-informatiedictionary, PDF/R zet een commentaarregel naast de trailer van het bestand, en de PDF 2.0-generatie voegt twee mechanismen toe: developer extension-dictionaries in de catalog en PDF Declarations binnen XMP. Een identifier is de verklaring van het bestand over zichzelf; of de content daar aan voldoet is aan een validator om te bepalen, en conforme PDF/A-, PDF/X- en PDF/UA-uitvoer produceren is een onderwerp op zich. Voor routering (printwachtrij voor PDF/X, archief voor PDF/A, toegankelijkheidspijplijn voor WTPDF) is de claim wat u nodig heeft, gelezen op de juiste plek:
| Standaard | Waar de claim huist | HotPDF-accessor |
|---|---|---|
| PDF/A (ISO 19005) | XMP pdfaid:part en pdfaid:conformance, plus pdfaid:rev in PDF/A-4 | IsLoadedPDFA, GetLoadedPDFAVersion, GetLoadedPDFARevision |
| PDF/X (ISO 15930) | GTS_PDFXVersion in de Info-dictionary voor PDF/X-1a en PDF/X-3, in XMP voor latere delen | IsLoadedPDFX, GetLoadedPDFXVersion |
| PDF/UA (ISO 14289) | XMP pdfuaid:part | IsLoadedPDFUA, GetLoadedPDFUAVersion |
| PDF/VT (ISO 16612-2) | XMP pdfvtid:GTS_PDFVTVersion | IsLoadedPDFVT, GetLoadedPDFVTVersion |
| PDF/E (ISO 24517-1) | ISO_PDFEVersion, gelezen uit de Info-dictionary, de catalog of XMP | IsLoadedPDFE, GetLoadedPDFEVersion |
| PDF/R-1 (ISO 23504-1) | %PDF-raster-x.y-comment direct boven de laatste startxref | IsLoadedPDFR1, GetLoadedPDFR1Version |
| PDF/VCR-1 (ISO 16613-1) | GTS_PDFVCRVersion in de catalog of XMP | IsLoadedPDFVCR, GetLoadedPDFVCRVersion |
| WTPDF 1.0, ISO/TS 32005 | pdfd:declarations-entries in XMP | IsLoadedWTPDF, GetLoadedWTPDFVersion, IsLoadedISO32005 |
| PDF 2.0 developer extensions | /Extensions /ISO_ in de catalog | HasLoadedISODeveloperExtension, GetLoadedISODeveloperExtensionLevels |
uses
  System.SysUtils, HPDFDoc;

procedure ReportClaims(const FileName: string; const Password: AnsiString);
var
  Pdf: THotPDF;
  PDFX, PDFXLevel: AnsiString;
begin
  Pdf := THotPDF.Create(nil);   // een aparte instantie, alleen voor inspectie
  try
    // De password-overload ontsleutelt de streams, het XMP-pakket inbegrepen;
    // geef '' mee voor bestanden die zonder wachtwoordvenster openen
    if Pdf.LoadFromFile(FileName, Password) <= 0 then
      raise Exception.CreateFmt('Cannot open %s', [FileName]);

    if Pdf.IsLoadedPDFA then
      Writeln('PDF/A: ', Pdf.GetLoadedPDFAVersion);        // bijv. PDF/A-2b
    PDFX := Pdf.GetLoadedPDFXVersion;                       // eerst XMP, daarna Info
    if PDFX <> '' then
    begin
      PDFXLevel := Pdf.GetLoadedInfoKeyValue('GTS_PDFXConformance');
      if PDFXLevel <> '' then
        Writeln('PDF/X: ', PDFX, ', conformance ', PDFXLevel)
      else
        Writeln('PDF/X: ', PDFX);
    end;
    if Pdf.IsLoadedPDFUA then
      Writeln('PDF/UA: ', Pdf.GetLoadedPDFUAVersion);      // bijv. PDF/UA-1
    if Pdf.IsLoadedPDFVT then
      Writeln('PDF/VT: ', Pdf.GetLoadedPDFVTVersion);
    if Pdf.IsLoadedPDFE then
      Writeln('PDF/E: ', Pdf.GetLoadedPDFEVersion);
    if Pdf.IsLoadedPDFR1 then
      Writeln('PDF/R: ', Pdf.GetLoadedPDFR1Version);       // bijv. PDF/R-1.0
    if Pdf.IsLoadedWTPDF then
      Writeln('WTPDF: ', Pdf.GetLoadedWTPDFVersion);
  finally
    Pdf.Free;
  end;
end;
Gebruik een aparte THotPDF-instantie voor inspectie, zoals het voorbeeld doet. De IsLoaded…-functies antwoorden voor welk document de component ook vasthoudt, ook voor eentje dat hij zelf aan het bouwen is: IsLoadedPDFUA is ook True wanneer PDFUACompliance voor de uitvoer is aangezet, en IsLoadedPDFX gaat akkoord met een niet-lege PDFXCompliance. Handig halverwege de constructie, maar op een component dat voor beide klussen wordt hergebruikt mengt het uw uitvoerinstellingen in het oordeel over het bestand van iemand anders
PDF/X is de enige familie waarvan de identifier tussen de delen verschoof. PDF/X-1a en PDF/X-3 zijn PDF 1.3-profielen die GTS_PDFXVersion in de document-informatiedictionary zetten en helemaal geen XMP nodig hebben, terwijl PDF/X-4 en latere delen de XMP-eigenschap pdfx:GTS_PDFXVersion vereisen. GetLoadedPDFXVersion kijkt eerst in XMP, onder ofwel het pdfx- ofwel het pdfxid-prefix, daarna in de Info-dictionary, daarna in de catalogsleutels die sommige legacy-producenten schrijven, en geeft de opgegeven waarde ongewijzigd terug. PDF/X-1a kent één adder om in code rekening mee te houden: zijn versiewaarde is PDF/X-1:2001, en het conformance-niveau PDF/X-1a:2001 huist in een eigen sleutel, /GTS_PDFXConformance, die het voorbeeld met GetLoadedInfoKeyValue leest wanneer het X-1a van gewone X-1 moet onderscheiden
Hoe ziet een geldige XMP-claim eruit?
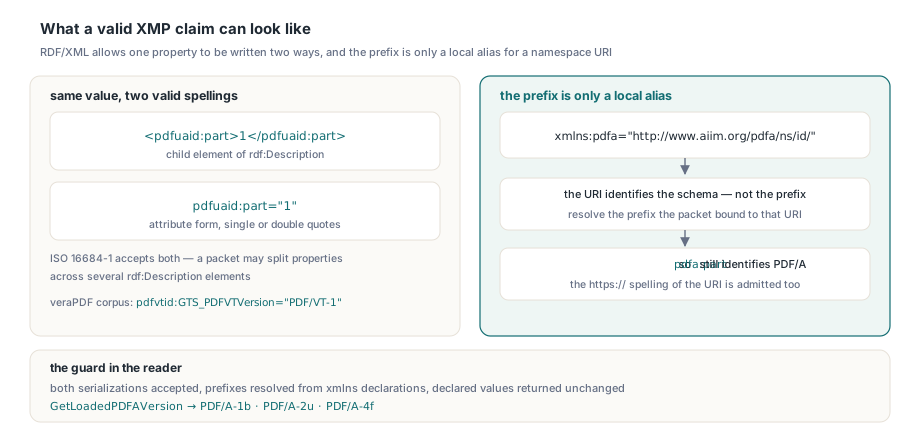
XMP is RDF, geserialiseerd als XML, en RDF/XML laat een eenvoudige eigenschap op twee manieren binnen een rdf:Description schrijven: als childelement, <pdfuaid:part>1</pdfuaid:part>, of als attribuut op de description zelf, pdfuaid:part="1", met enkele of dubbele aanhalingstekens. ISO 16684-1 accepteert beide, en een pakket mag zijn eigenschappen over meerdere rdf:Description-elementen verdelen. Die splitsing is niet hypothetisch. HotPDF schrijft de childelementvorm voor PDF/UA, PDF/VT, PDF/E en PDF/X, terwijl de veraPDF-testcorpus en veel externe producenten de korte vorm schrijven, met descriptions zoals pdfuaid:part="1" of pdfvtid:GTS_PDFVTVersion="PDF/VT-1" die de hele claim in attributen dragen. Een detector gebouwd rond Pos('<pdfuaid:part>', Xmp) en alleen getest op eigen uitvoer haalt elke lokale controle en meldt dan het eerste veraPDF-voorbeeld als ongeclaimd. De XMP-lezer van HotPDF behandelt beide vormen voor elke accessor in de tabel. GetLoadedPDFAVersion combineert pdfaid:part en pdfaid:conformance tot identifiers zoals PDF/A-1b, PDF/A-2u, PDF/A-4 of PDF/A-4f, en GetLoadedPDFARevision geeft pdfaid:rev terug, het editiejaar dat PDF/A-4 vereist (2020) en de delen 1 tot 3 niet definiëren:
procedure ReportPDFALevel(Pdf: THotPDF);
var
  Level, Revision: AnsiString;
begin
  Level := Pdf.GetLoadedPDFAVersion;      // 'PDF/A-1b', 'PDF/A-2u', 'PDF/A-4f', ...
  if Level = '' then
    Exit;
  Revision := Pdf.GetLoadedPDFARevision;  // '2020' voor PDF/A-4, leeg voor de delen 1-3
  if Revision <> '' then
    Writeln(Level, ', edition ', Revision)
  else
    Writeln(Level);
  // Verwacht: "PDF/A-2b" of de producent nu
  // <pdfaid:part>2</pdfaid:part> of pdfaid:part="2" schrijft
end;
Prefixen zijn het andere bewegende deel. In XML is het prefix slechts een lokale alias; wat het PDF/A-schema identificeert is de namespace-URI http://www.aiim.org/pdfa/ns/id/, waar goedgekeurde errata bij ISO 19005-4 ook de https://-spelling van toelaten, en een producent mag hem binden aan elk prefix dat hem uitkomt. GetLoadedPDFAVersion zoekt het prefix op dat het pakket voor die URI opgeeft voordat hij het deel en het niveau leest, dus een pakket dat pdfa:part schrijft in plaats van pdfaid:part identificeert nog steeds. Elke andere XMP-eigenschap die u zelf leest uit het gedecodeerde pakket dat GetLoadedXMPMetadata teruggeeft verdient dezelfde zorg: beide serialisaties, het prefix opgelost uit zijn xmlns-declaratie, en witruimte rond het gelijkteken toegestaan
Versleutelde bestanden verbergen de claim voor bytescans
Een scan door het ruwe bestand op pdfaid of ISO_PDFEVersion slaat het parsen over en breekt op twee gewone gevallen. De meeste XMP-streams zijn Flate-gecomprimeerd, dus de eigenschapsnamen verschijnen nooit als tekst op schijf. En in een versleuteld document is de metadatastream cijfertekst: ISO 32000-2 §7.6.4.2 definieert EncryptMetadata met als standaardwaarde true, dus tenzij de producent er expliciet van afzag, is het pakket samen met elke andere stream versleuteld. Een bytescan tegen een versleuteld PDF/E-1-bestand meldt de ISO_PDFEVersion-claim daarom als ontbrekend, ook al staat hij erin. De betrouwbare volgorde is laden, ontsleutelen, decoderen, dan zoeken. Open het bestand via de password-overload, LoadFromFile(FileName, Password), en geef een lege string mee voor bestanden die alleen een owner-password meedragen en in elke viewer zonder wachtwoordvenster openen. De eenargument-LoadFromFile(FileName) laadt de documentstructuur zonder zijn streams te ontsleutelen, wat het XMP-pakket onleesbaar laat; na de password-overload werken GetLoadedXMPMetadata en elke accessor hierboven op het ontsleutelde, gedecomprimeerde pakket
Waarom verliest een PDF/R-bestand zijn identiteit na een bewerking?
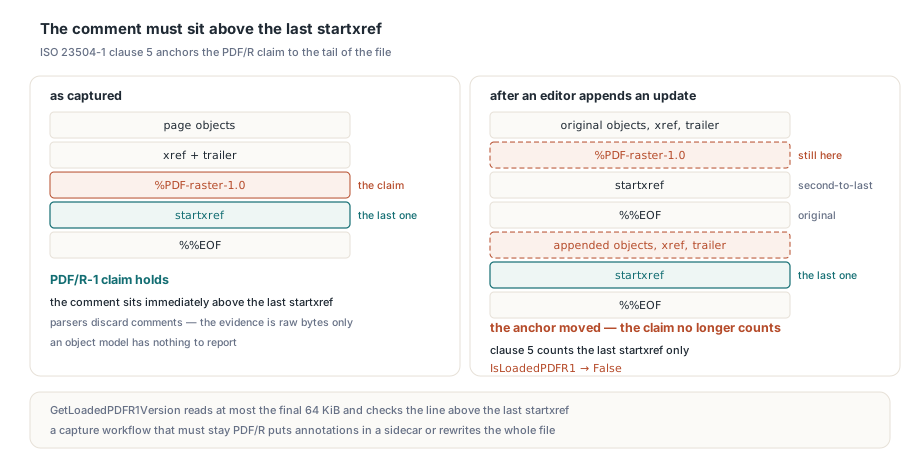
PDF/R-1 identificeert zich op een manier die geen enkele andere deelnorm doet. Clausule 5 van ISO 23504-1 vereist een commentaarregel met %PDF-raster-1.0 (of welke versie dan ook van toepassing) op de regel direct vóór de laatste regel die startxref bevat. Een PDF-parser gooit commentaar weg terwijl hij de kruisverwijsdata leest, dus een objectmodel heeft niets te melden; het bewijs bestaat alleen in de ruwe bytes aan het einde van het bestand. GetLoadedPDFR1Version gaat terug naar de bron waaruit het document is geladen, leest hooguit de laatste 64 KiB, vindt de laatste startxref en controleert de regel erboven. Volg nu een incrementele update. Een editor die een annotatie toevoegt plakt nieuwe objecten, een nieuwe kruisverwijssectie, een nieuwe trailer en een nieuwe startxref achter de oorspronkelijke %%EOF aan. De %PDF-raster-1.0-regel staat nog in het bestand, maar hij zit nu boven de voorlaatste startxref, en de standaard is ondubbelzinnig over welke telt. Verwacht: IsLoadedPDFR1 geeft na de bewerking False terug, tenzij de bewerkingstool het commentaar in zijn eigen update opnieuw schrijft. Een detector die het hele bestand op %PDF-raster- scant zou ja zeggen, en volgens de regel in clausule 5 is dat antwoord fout. Een capture-workflow die zijn bestanden PDF/R moet laten blijven zet annotaties in een sidecar-bestand of in een tool die het hele bestand als PDF/R herschrijft
Developer extensions: integer-niveaus, namen en arrays
PDF 2.0-documenten kondigen de ISO-technische specificaties die ze gebruiken aan (SHA-3-hashes uit ISO/TS 32001, ECC-handtekeningen uit ISO/TS 32002, glTF-assets uit ISO/TS 32007) via de /Extensions-dictionary van de catalog, gedefinieerd in ISO 32000-2 §7.12. Onder het geregistreerde prefix /ISO_ staat Tabel 48 ofwel één enkele developer extensions-dictionary toe ofwel, nieuw in PDF 2.0, een array ervan, en Tabel 49 maakt samen met §7.12.5 van /ExtensionLevel een integer. Een lezer die maar één van de twee containervormen aankan mist elk bestand dat de andere kant op is geschreven. HasLoadedISODeveloperExtension en GetLoadedISODeveloperExtensionLevels accepteren beide en lossen onderweg indirecte verwijzingen op, al zegt §7.12.1 dat deze dictionaries directe objecten moeten zijn:
procedure ReportISOExtensions(Pdf: THotPDF);
var
  Levels: THPDFIntegerArray;
  Revision, URL: AnsiString;
  I: Integer;
begin
  Levels := Pdf.GetLoadedISODeveloperExtensionLevels;
  for I := 0 to High(Levels) do
    Writeln('ISO_ extension level ', Levels[I]);

  if Pdf.HasLoadedISODeveloperExtension(32001, Revision, URL) then
    Writeln('ISO/TS 32001 revision ', Revision, ', documented at ', URL);
  // Verwacht voor een bestand geschreven met EnsureISO32001Extensions:
  //   ISO/TS 32001 revision :2022, documented at https://www.iso.org/standard/45874.html
  if Pdf.HasLoadedISODeveloperExtension(32007) then
    Writeln('glTF 3D assets per ISO/TS 32007');
end;
De eerste editie van ISO/TS 32007:2024 heeft in §4.8 een voorbeeld dat /ExtensionLevel /32007 als name schrijft; PDF Errata Issue #835 verbeterde dat naar de integer 32007, maar een producent die het oorspronkelijke voorbeeld overnam schrijft nog steeds de name. De lezer van HotPDF valt daarom terug op het parsen van een name- of stringwaarde, met of zonder de voorafgaande slash, wanneer de integer-opzoeking leeg komt, dus HasLoadedISODeveloperExtension(32007) vindt beide spellingen. Het andere erratum betreft /URL: Tabel 49 in ISO 32000-2:2020 vermeldt /URL als optioneel, en Issue #732 promoveert hem naar verplicht. Op de schrijfkant zendt HotPDF de integer-vorm en een /URL uit in elke EnsureISO…Extensions-aanroep; op de leeskant is een lege URL-out-parameter normaal voor bestanden geschreven naar de tekst van 2020, dus behandel hem als informatie en nooit als reden om de extensie te weigeren
Welke WTPDF-URI schreef de producent?
WTPDF 1.0- en ISO/TS 32005-claims zijn PDF Declarations: entries in een pdfd:declarations-bag in XMP, onder de namespace http://pdfa.org/declarations/ die de technische notitie PDF Declarations van de PDF Association definieert. Elke entry draagt een conformsTo-URI en optionele velden claimBy, claimDate, claimCredentials en claimReport, die GetLoadedPDFDeclarations teruggeeft als array van THPDFDeclarationEntry-records; op de schrijfkant stopt AddPDFDeclaration dezelfde vijf velden in het XMP-pakket, naast de identificatienamespaces van PDF 2.0, PDF/A-4 en PDF/UA-2. De bag met een kale tekstzoekopdracht in entries hakken heeft een eigen adder: splitst u op elke voorkoming van conformsTo, dan geldt de sluitingstag </pdfd:conformsTo> van de childelementvorm als begin van een nieuwe entry, wat de eerste declaratie voor zijn eigen einde afkapt. De HotPDF-lezer stapt over sluitingstags heen en accepteert beide serialisaties
De URI's zelf zijn het moeilijkste deel. Dezelfde claim bereikt u als http:// of https://, en WTPDF 1.0 Issue #395 veranderde of er een / vóór de # staat, dus bestanden geschreven vóór en na het erratum verschillen in dat ene teken; een kale stringvergelijking behandelt ze als verschillende standaarden. HasLoadedPDFDeclaration vergelijkt URI's ongevoelig voor hoofdletters, vouwt https:// terug naar http:// en laat een / direct vóór # aan beide kanten vallen, dus de vraag hieronder matcht met welke spelling de producent ook koos. Het fragment blijft intact: #accessibility1.0 en #accessibility1.0-validated zijn verschillende claims, waarvan de tweede beweert dat een validator het bestand controleerde, en u moet vragen om degene waar uw workflow om geeft. GetLoadedWTPDFVersion vouwt beide samen tot 'WTPDF 1.0 Accessibility' of 'WTPDF 1.0 Reuse' voor routering
procedure ReportDeclarations(Pdf: THotPDF);
var
  Decls: THPDFDeclarationEntryArray;
  I: Integer;
begin
  Decls := Pdf.GetLoadedPDFDeclarations;
  for I := 0 to High(Decls) do
    Writeln(Decls[I].ConformsTo, ' claimed by ', Decls[I].ClaimBy,
      ' on ', Decls[I].ClaimDate);

  // Matcht http of https, met of zonder de slash vóór '#'
  if Pdf.HasLoadedPDFDeclaration(
    'https://pdfa.org/declarations/wtpdf#accessibility1.0') then
    Writeln('WTPDF 1.0 Accessibility (unvalidated claim)');

  // Dekkt zowel de gewone als de -validated-varianten van Reuse en Accessibility
  Writeln('WTPDF profile: ', Pdf.GetLoadedWTPDFVersion);
end;
Voor een capture- of printrouter telt de volgorde van de bewerkingen zwaarder dan elke accessor op zich: toets IsLoadedPDFR1 op het bestand zoals het aankwam, voordat een annotatie- of stempelstap zijn update toevoegt, en routeer PDF/X op GetLoadedPDFXVersion, dat zowel de Info-dictionary van PDF/X-1a- en PDF/X-3-taken als de XMP van PDF/X-4-taken dekt, en /GTS_PDFXConformance alleen leest waar X-1a van gewone X-1 onderscheiden moet worden. Beide controles draaien op elk document dat in de HotPDF Delphi PDF component wordt geladen, inclusief versleutelde bestanden die met hun wachtwoord werden geopend