Zet een Windows-testbak op Duitse regionale instellingen, draai een routine die een schaal-en-verschuivingsmatrix vóór een pagina plakt, en dump de content stream. In plaats van 0.5 0 0 0.25 0.00001 12.75 cm krijg je 0,5 0 0 0,25 1E-5 12,75 cm. Een content parser leest dat als het getal 0, dan een token ,5 dat hij niet herkent, dan meer getallen die niet meer aansluiten op de zes operanden die cm verwacht, en de pagina tekent met een transformatie die je nooit hebt gevraagd. Getallen die een machine zal parsen hebben een vaste punt nodig, geen exponent en helemaal geen afhankelijkheid van FormatSettings, aan de schrijfkant en aan de leeskant
Waarom breekt een komma-decimale locale PDF-nummers?
Een komma-decimale locale breekt PDF-nummers omdat de standaard floatformatting van Delphi het bureaublad volgt, terwijl de PDF-nummersyntaxis vaststaat. FloatToStr gebruikt FormatSettings.DecimalSeparator, dus op een de-DE-, fr-FR- of pt-BR-machine komt elke fractie met een komma naar buiten. ISO 32000-1 §7.3.3 staat in een getal cijfers, één punt en een voorloopteken toe. Niets anders. De komma splitst dus één getal in een geldig geheel getal plus rommel, en het resultaat is een pagina die rendert, alleen verkeerd
Er schuilt een tweede valkuil achter de eerste, en die bijt ook op Amerikaanse machines. FloatToStr gebruikt het ffGeneral-formaat, dat omschakelt naar exponentnotatie zodra de grootte onder 1E-4 zakt, dus een piepkleine offset wordt geschreven als 1E-5. Dezelfde §7.3.3 zegt dat PDF de exponentvorm niet ondersteunt. Vanuit de gerenderde output een van beide problemen terugtraceren is een treurzaak, want een gedrifte matrix oogt exact als een layoutbug in je eigen code en wijst niets op de pagina naar de regionale instellingen
PDFlibPas, de losLab PDF Developer Library for Delphi, schrijft de operanden van AddPageMatrix via PLDoubleToStrConst met zes decimalen, en de call sites die namens jou paginacontent genereren volgen dezelfde regel. De goedkoopste regression test die we kennen zet binnen het proces het scheidingsteken op een komma, roept de API aan en scant het resultaat op kommas en exponenten:
uses
  System.SysUtils, PDFlibrary;

// je eigen controle, geen deel van de library. Bewust grof:
// tekststrings zoals (Hello, world) Tj bevatten ook kommas, dus draai hem
// op een testpagina die alleen vormen tekent
function HasLocaleDamage(const Content: AnsiString): Boolean;
var
  I: Integer;
begin
  Result := False;
  for I := 1 to Length(Content) do
  begin
    if Content[I] = ',' then
      Exit(True);
    if (Content[I] in ['E', 'e']) and (I > 1) and (I < Length(Content)) and
       (Content[I - 1] in ['0'..'9']) and (Content[I + 1] in ['0'..'9', '-', '+']) then
      Exit(True);
  end;
end;

var
  Lib: TPDFlib;
  OldSeparator: Char;
  Content: AnsiString;
begin
  Lib := TPDFlib.Create;
  try
    Lib.SetPageDimensions(300, 200);
    Lib.DrawBox(10, 10, 20, 20, 1);
    OldSeparator := FormatSettings.DecimalSeparator;
    try
      FormatSettings.DecimalSeparator := ',';   // doe alsof je een de-DE-bureaublad bent
      Lib.AddPageMatrix(0.5, 0.25, 1E-5, 12.75);
      Content := Lib.GetPageContentToString;
      // verwacht: 0.5 0 0 0.25 0.00001 12.75 cm
      // FloatToStr had geproduceerd: 0,5 0 0 0,25 1E-5 12,75 cm
      Writeln(Content);
      if HasLocaleDamage(Content) then
        Writeln('Locale leaked into the content stream');
    finally
      FormatSettings.DecimalSeparator := OldSeparator;
    end;
  finally
    Lib.Free;
  end;
end;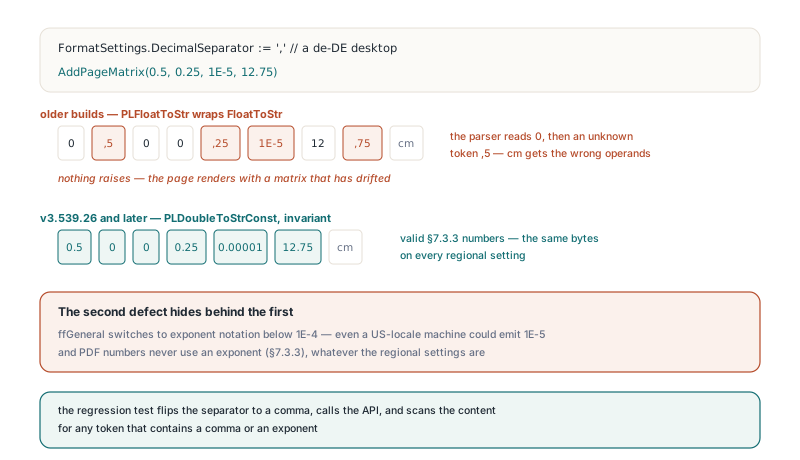
FormatSettings.DecimalSeparator binnen het proces omzetten is een shortcut. Hij oefent geen code uit die zijn eigen TFormatSettings vanuit het besturingssysteem bouwt, dus doet je applicatie dat, dan is een CI-agent met echte Duitse regionale instellingen de eerlijkere test
Twee soorten getallen, twee families helpers
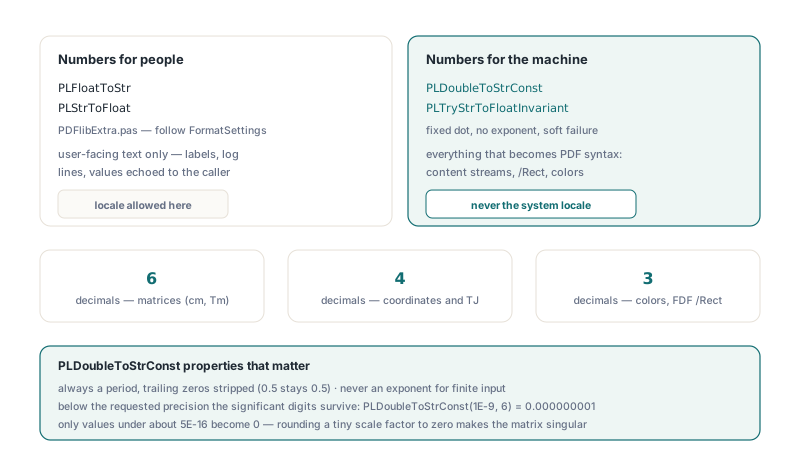
PDFlibPas splitst zijn getalhelpers op publiek: tekst die aan mensen wordt getoond mag de locale volgen, en alles wat voor een machine wordt geschreven doet dat nooit. PLFloatToStr en PLStrToFloat in PDFlibExtra.pas zijn dunne wrappers om FloatToStr en StrToFloat, en het comment bij hun declaratie zegt dat ze alleen voor menselijke leesbare tekst zijn. Machineoutput (PDF, FDF, XFDF, JSON, XML, CSV) gaat in plaats daarvan door de invariantfamilie: PLDoubleToStrConst voor schrijven, PLTryStrToFloatInvariant voor lezen, en PLInvariantFormatSettings wanneer je een TFormatSettings-record met punt-decimale nodig hebt voor je eigen TryStrToFloat-aanroepen
De precisie wordt per taak gekozen in plaats van globaal. Matrices krijgen zes decimalen, coördinaten en TJ-aanpassingen krijgen er vier, kleuren en FDF-rechthoeken drie. De machinegerichte kant dekt meer plekken dan het API-oppervlak doet vermoeden:
AddPageMatrix,ScalePageenDeskewPage, die allemaal eencmvóór de bestaande paginacontent plakken- De
Tm-resets,TJ-stapjes encm-transformaties die worden weggeschreven wanneer pagina-elementen worden gegenereerd - Glyphplaatsingsmatrices en outline-punten die ontstaan wanneer tekst naar paden wordt omgezet
- Het zwarte invulvak dat
RedactRegionvooraan plakt, de/Rect-waarden in de FDF-export en de kleuroperanden die recoloring schrijft
PLDoubleToStrConst is een met de hand gebouwde formatter, en dat was naar onze mening de juiste keuze boven het omwikkelen van FloatToStrF met een vaste TFormatSettings. ffFixed valt nog altijd terug op wetenschappelijke notatie zodra het gehele deel de precisie ontgroeit, en hij zou 0.500000 opleveren waar 0.5 korter en identiek is. De custom routine schrijft altijd een punt, haalt afsluitende nullen weg en schrijft nooit een exponent voor eindige invoer. Ze behoudt ook de significante cijfers van een niet-nul waarde die kleiner is dan de gevraagde precisie: PLDoubleToStrConst(1E-9, 6) geeft 0.000000001 terug, en alleen waarden onder ruwweg 5E-16 worden 0. Een piepkleine schaalfactor op nul afronden zou een geldige matrix in een singuliere veranderen, en dat is een ergere mislukking dan een misplaatste decimaal
Schrijf je unit tests tegen de formatter, kies dan je voorbeeldwaarden met binary floating point in je achterhoofd. De voor de hand liggende keuze voor "vier significante cijfers" is 0.000012345, maar vermenigvuldigd met 1E8 is die double 1234.4999…, dus het resultaat is 0.00001234 en de assertie faalt om een reden die niets met locales te maken heeft. Een waarde die duidelijk van het midden af zit, zoals 0.000012346, ontloopt de discussie helemaal:
uses
  PDFlibExtra;

// assert-aanroepen zijn controles die je in je eigen testproject toevoegt
procedure CheckNumberHelpers;
var
  V: Double;
begin
  // machineoutput: punt-decimaal, geen exponent, afsluitende nullen verwijderd
  Assert(PLDoubleToStrConst(1E-5, 6) = '0.00001');
  Assert(PLDoubleToStrConst(-0.5, 6) = '-0.5');
  Assert(PLDoubleToStrConst(0.000012346, 4) = '0.00001235');  // 4 significante cijfers behouden
  Assert(PLDoubleToStrConst(12345.25, 4) = '12345.25');

  // machineinvoer: False in plaats van EConvertError
  Assert(PLTryStrToFloatInvariant('0.5', V) and (V = 0.5));
  Assert(PLTryStrToFloatInvariant('  12.75 ', V) and (V = 12.75)); // invoer wordt getrimd
  Assert(not PLTryStrToFloatInvariant('0,5', V));   // contentnummers gebruiken nooit een komma
end;
Waarom is de parseerkant gevaarlijker dan de schrijfkant?
De parseerkant is gevaarlijker omdat een locale-gebonden parser geen iets te verkeerd getal produceert; hij gooit. StrToFloat gooit een EConvertError zodra de tekst niet matcht met het systeemscheidingsteken. Een recoloringpass die daarop bouwt zou afbreken op het moment dat hij een gewone 0.5 g-operator tegenkomt op een machine met komma-decimals, wat betekent dat hij op praktisch elke echte pagina faalt. Een clipstring zoals "10.5,20.5,50.5,40.5" zou ronduit worden geweigerd, en SVG-lengtes, SVG-kleuren, annotatievertexlijsten en output intent-waarden zouden worden geweigerd of stilletjes door defaults worden vervangen. Dat is code die elke test op de ontwikkelaarmachine haalt en faalt bij de eerste klant in München, dezelfde probleemfamilie als de gevallen in het artikel over Delphi-code die bij toeval werkt
Elke StrToFloat-achtige aanroep in de library wordt gesorteerd op waar zijn invoer vandaan komt. Content stream-operanden, SVG-attributen, painter-kleurstrings en komma-gescheiden clip- en vertexlijsten hebben allemaal een vaste puntsyntaxis, dus die gaan door PLTryStrToFloatInvariant. Die helper trimt de tekst, parst hem met PLInvariantFormatSettings en geeft False terug (met de waarde op 0) bij lege, misvormde, NaN- of oneindige invoer. Komma-gescheiden lijsten vragen helemaal geen discussie: een komma kan niet zowel lijstscheider als decimaalteken zijn, dus er is geen legacy-vorm om compatibel mee te blijven
Voor de recoloringpijplijn uit de gids voor het omzetten van een PDF naar één kleurruimte is het resultaat dat RecolorPage en RecolorDocument paginacontent op elke locale identiek parsen. Regelwaarden die een aanroeper in CheckDocumentPolicy intikt zijn het ene parseergeval dat de soepele route neemt, want een mens tikte die string en heeft wellicht het lokale decimaalteken gebruikt
Een getal dat via een string reist vraagt dat beide uiteinden het eens zijn
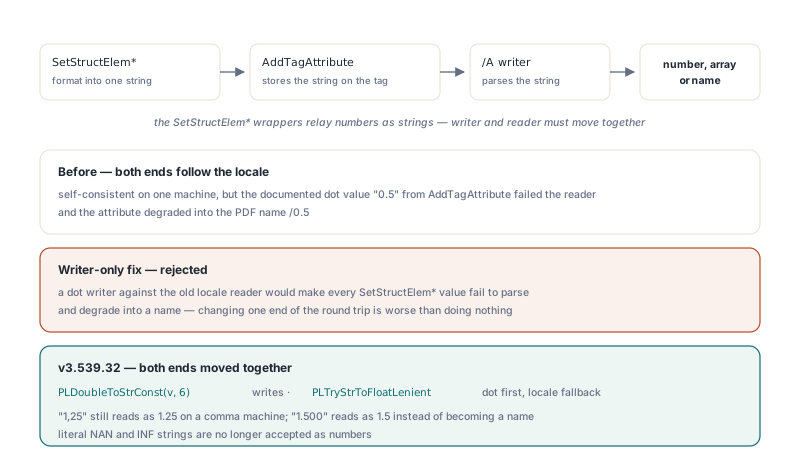
Wordt een getal door het ene deel van de code naar een string geschreven en door een ander deel teruggeparst, dan moeten schrijver en lezer dezelfde conventie volgen, en er maar één van beiden omzetten breekt de round-trip. Getagde PDF-structuurattributen werken precies zo. SetStructElemBBox formatteert vier waarden in één string en bewaart die via AddTagAttribute. Wanneer het /A-attributedictionary wordt weggeschreven, wordt die string opnieuw geparsed om te beslissen of hij een getal, een array of een naam wordt
Volgden beide uiteinden de systeem-locale, dan zou de trip op een Duitse machine zelfconsistent zijn. De moeilijkheid begint bij een aanroeper die de documentatie volgt en "0.5" aan AddTagAttribute doorgeeft: een locale-gebonden lezer kan hem niet parsen en zendt de PDF-naam /0.5 uit. PDF/VCR-placeholders treffen het spiegelbeeld, want hun GTS_BBox wordt met een punt gegenereerd en een locale-gebonden validatiestap vóór het opslaan zou hem afkeuren. En alleen de schrijver op een punt zetten maakt het erger, want elke SetStructElem*-waarde zou dan op systemen met komma-decimals in een naam veranderen
Dus de schrijvers gebruiken PLDoubleToStrConst(v, 6) en de lezer gebruikt PLTryStrToFloatLenient, die eerst de puntvorm probeert en terugvalt op de systeem-locale. Een aanroeper met komma-locale die "1,25" doorgeeft krijgt het getal 1.25. Er is een prijs, en we hebben hem bewust geaccepteerd: op een Duits systeem wordt "1.500" gelezen als 1.5 in plaats van vijftienhonderd, want de puntvorm wint. De API documenteert de punt als scheidingsteken, dus een Duitse duizendtalgroep in een attributestring is de invoer waar we bewust van af hebben gezien. Letterlijke NAN- en INF-strings worden niet als getallen behandeld
uses
  System.SysUtils, PDFlibrary;

var
  Lib: TPDFlib;
begin
  FormatSettings.DecimalSeparator := ',';   // aanroeper met komma-decimals
  Lib := TPDFlib.Create;
  try
    Lib.BeginTag('Figure', 'Sales chart', '');
    Lib.SetStructElemBBox(10.5, 20.25, 200.5, 100.75); // /BBox [ 10.5 20.25 200.5 100.75 ]
    Lib.AddTagAttribute('Layout', 'SpaceAfter', '0.5');   // /SpaceAfter 0.5 in plaats van /0.5
    Lib.AddTagAttribute('Layout', 'StartIndent', '1,25'); // /StartIndent 1.25 via de locale-terugval
    Lib.DrawText(20, 20, 'figure');
    Lib.EndTag;
    Lib.SaveToFile('tagged.pdf');
  finally
    Lib.Free;
  end;
end;
Onze aanbeveling voor je eigen code: geef punt-decimale strings door aan AddTagAttribute en houd de komma-terugval over voor waarden die je niet in de hand hebt, zoals strings die uit een ouder configuratiebestand komen. Hoe de structuurboom rond die attributen wordt gebouwd, staat in de tagged PDF-structuurgids
Waar NaN en oneindig worden tegengehouden
AddPageMatrix, ScalePage en RedactRegion wijzen NaN- en oneindige argumenten vooraf af en geven 0 terug, want geen enkel PDF-getal kan een van beide representeren. De controle moet expliciet zijn. NaN glipt langs een <= 0-test heen, dus een bereikcontrole op alleen een schaalfactor zou een NaN-schaal tot de formatter laten reizen, en Round op NaN aanroepen geeft een EInvalidOp op Win32, waar de x87-eenheid ongeldige bewerkingen standaard niet maskeert. PLDoubleToStrConst schrijft 0 voor NaN als laatste verdedigingslinie, maar een nul in een matrix is een singuliere transformatie, dus de controle op API-niveau is degene die de pagina echt beschermt. Test in je eigen code de returnwaarde: geeft ScalePage 0 terug voor een factor die je zelf hebt berekend, print dan eerst de factor voordat je iets anders doet, want een 0/0 ergens stroomopwaarts produceert precies deze NaN
Twee grenzen zijn bewust. Metafile state-strings worden binnen één proces met de locale geschreven en gelezen en bereiken nooit een bestand, dus die blijven locale-gebonden. En test je kleine waarden via het paginageneratiepad, lees de content dan direct na de aanroep: een operatie die later de paginacontent op de coördinaatprecisie van het document opnieuw uitzendt maakt van 1E-5 terecht 0, en dat is afronding, geen locale-lek
De gewoonte die de moeite waard is, is kort. Draai de PDF-producerende paden van je applicatie één keer met een komma als scheidingsteken, scant de output op kommas en exponenten, en houd FloatToStr weg bij alles wat een parser zal lezen. Getallen die uit een bestaand bestand worden gelezen volgen een verwante regel, behandeld in het artikel over het behouden van geparsde decimale precisie, waar de exacte brontekst een opslag overleeft. Trial-builds, de API-referentie en licentiedetails staan op de productpagina van de PDFlibPas Delphi PDF library