Dit is de fout die een handgeschreven JBIG2-lezer maakt op het eerste ongebruikelijke bestand dat hij tegenkomt. Hij parst de fileheader, parst de eerste segmentheader, leest de vier-byte datalengte en neemt zoveel bytes als segmentbody. Op de meeste .jb2-bestanden is dat precies goed. Op een bestand waarvan de flags-byte bit 0 gewist heeft, zijn die "body"-bytes in werkelijkheid de tweede, derde en vierde segmentheaders, en de arithmetic decoder maakt er een bitmap van ruis van of loopt voorbij het einde van de buffer. Het bestand is niet kapot. Het gebruikt de random-access-organisatie uit ITU-T T.88 Annex D.2, waarbij elke segmentheader eerst komt en alle segmentdata daarna volgt, in dezelfde volgorde
Random-access-bestanden zijn zeldzaam. Ze komen uit archivalisering- en document-imaging-systemen die willen dat een lezer elke pagina- en dictionary-afhankelijkheid ziet voordat hij een gecomprimeerde byte aanraakt. Als een conversiebaan bestanden van zo'n bron mengt met gewone scans, kan één random-access bestand midden in een batch zitten die verder volledig sequentieel is. De decoder die ze leest is dezelfde native Pascal-decoder die JBIG2 custom Huffman-tabellen en canonieke prefixcodes aankan, dus de codeerkant is onveranderd; alleen de volgorde waarin segmenten worden gevonden verschilt
Drie bestandslayouts achter één flags-byte
PDF Library for Delphi leest standalone JBIG2-bestanden via TPLJBIG2Decoder in de unit PDFlibJBIG2, en de decoder leidt de layout zelf af uit de fileheader. T.88 Annex D staat toe dat dezelfde segmenten op drie manieren zijn gerangschikt: sequentieel (D.1) zet elke header direct vóór zijn data, random-access (D.2) zet alle headers eerst en alle data daarna, en embedded (D.3) is de headerloze vorm die in andere containers wordt gebruikt. Een standalone bestand begint met de acht-byte identifier 97 4A 42 32 0D 0A 1A 0A, dan één flags-byte, dan een vier-byte pagina-aantal tenzij de flags zeggen dat het aantal onbekend is
Bit 0 van die flags-byte kiest de organisatie: 1 betekent sequentieel, 0 betekent random-access. Bit 1 gezet betekent dat het aantal pagina's onbekend is en het vier-byte aantal ontbreekt, zodat de eerste segmentheader op byte 9 begint in plaats van op byte 13. Bits 2 tot en met 7 zijn gereserveerd; de decoder accepteert bestanden die die zetten in plaats van ze te weigeren, want een verdwaalde gereserveerde bit zegt niets over de leesbaarheid van de segmenten zelf
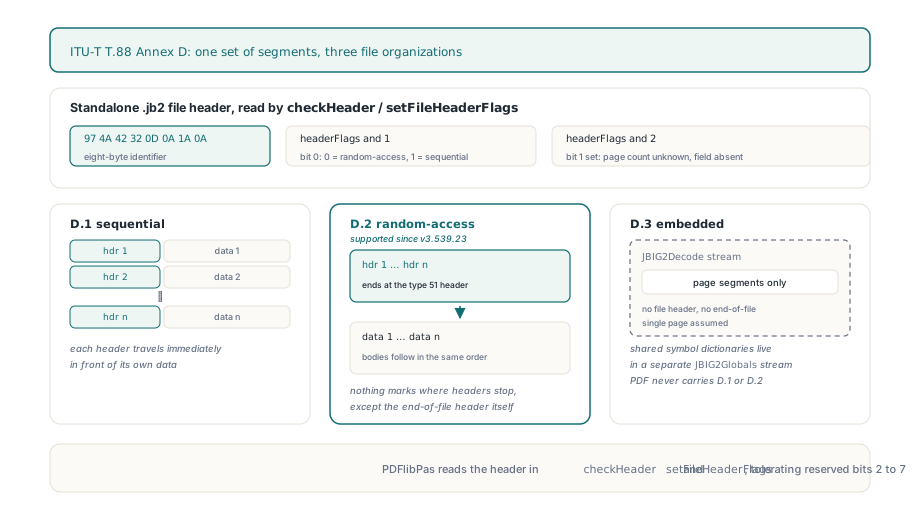
PDF zelf draagt de random-access-layout nooit. Een JBIG2Decode-imagestream, beschreven in ISO 32000-1 §7.4.7, bevat alleen paginasegmenten in embedded vorm, met gedeelde symbol-dictionaries verplaatst naar een aparte JBIG2Globals-stream en zonder fileheader, end-of-page- of end-of-file-segmenten. Vindt de decoder de acht-byte identifier niet, dan behandelt hij de invoer als precies dat soort stream: sequentieel, één pagina. De andere kant op: als PDF Library for Delphi een JBIG2Decode-afbeelding exporteert als native .jb2-bestand, schrijft hij de flags-byte $03 (sequentieel, pagina-aantal onbekend) en plakt hij een end-of-file-segmentheader aan. Random access komt dus alleen van buitenaf, als standalone bestand dat rechtstreeks aan TPLJBIG2Decoder wordt aangeboden, meestal op weg naar conversie of hercompressie voor PDF met de JBIG2-encoderbackends in PDFlibPas
Waarom kun je een random-access bestand niet in bestandsvolgorde lezen?
Omdat niets in de bytestroom markeert waar het headerblok eindigt en het datablok begint, behalve de end-of-file-segmentheader (type 51) zelf. JBIG2-segmentheaders hebben geen vaste grootte. Het referred-to segmentaantal is ofwel een driebits korte vorm ofwel een lange vorm gevolgd door een retention bitmap; elk referred-to segmentnummer kost één, twee of vier bytes afhankelijk van hoe groot het eigen nummer van het huidige segment is; het veld met de pagina-associatie is één byte of vier. Een lezer moet elk veld van een header parsen om alleen al te weten waar de volgende begint
Een sequentiële lezer die het bestand in volgorde doorloopt, krijgt de eerste header goed en alles daarna verkeerd. Erger nog: hij merkt het eventueel een tijdje niet, want een generic region decoder die headerbytes krijgt gevoerd produceert pixels, geen fout, totdat ergens een latere lengte- of referentiecontrole eindelijk af gaat. Onze opvatting is dat een decoder die niet eerst headers indexeert, random-access-bestanden ronduit zou weigeren. Een heldere weigering kost één bestand in een batch; een plausibel uitziende maar verkeerde bitmap kan in een archief belanden en daar blijven
Elke header indexeren vóór de eerste body
Als de flags-byte random-access zegt, maakt PDF Library for Delphi één doorgang over het headerblok voordat er iets wordt gedecodeerd. Elke header wordt volledig geparsd en daarna weggegooid; het enige wat bewaard blijft is zijn byte-offset in het bestand. De gecomprimeerde data wordt nooit gekopieerd naar een tweede, herschikte buffer, wat telt bij grote archiefscans waar het datablok het grootste deel van het bestand kan zijn. De doorgang stopt bij de eerste end-of-file-header, en op dat moment staat de leespositie precies op de eerste byte van de data van het eerste segment
Een random-access bestand heeft minder redundantie dan een sequentieel, dus de voorafscans zijn streng. Hij weigert het bestand als:
- een header door het einde van de buffer wordt afgeknipt, gemeld als
JBIG2 truncated random-access header at byte Nmet de offset waar die header begon - segmentnummers niet strijd toenemen (vergeleken als unsigned waarden), want twee headers die hetzelfde nummer claimen maken de referred-to-lijst van een later gebied dubbelzinnig
- een datalengte zijn bovenste bit gezet heeft, inclusief de marker
0xFFFFFFFFvoor "onbekende lengte"; in deze layout is er geen andere manier om te vinden waar de volgende body begint, dus de decoder weigert hem meteen in plaats van vooruit te scannen naar een eindmarkering - de end-of-file-header enige data claimt, of helemaal nooit verschijnt (
JBIG2 random-access file is missing its end-of-file header) - de opgegeven lengten samen meer opleveren dan de bytes die overblijven, of minder
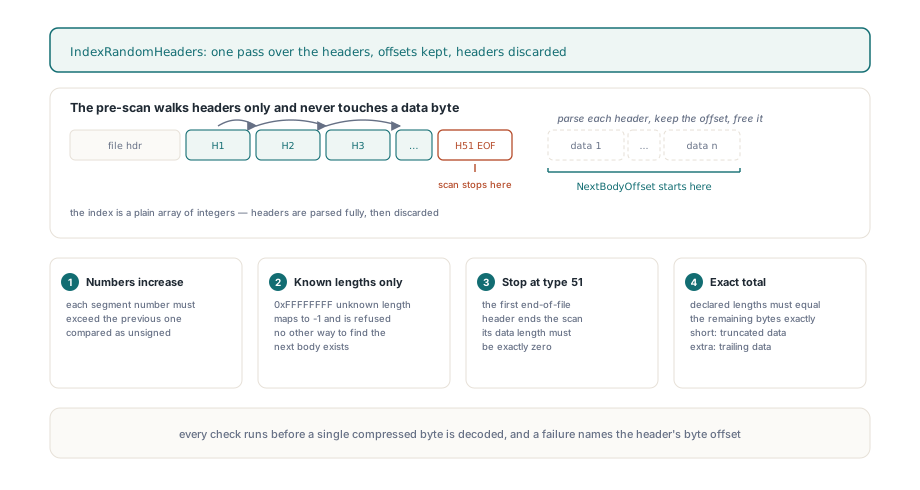
De laatste regel is waar mensen over struikelen. Eén enkele extra byte na de laatste body faalt met JBIG2 trailing random-access data. Dat oogt streng naast het sequentiële pad, waar het decoderen simpelweg stopt bij het end-of-file-segment en alles daarna wordt genegeerd. De asymmetrie heeft een reden. In sequentiële layout zit elke header direct naast zijn eigen data, dus rommel aan het eind kan niets hebben verschoven. In random-access layout zijn de headers de enige kaart van het datablok, en als de lengten niet opgaan, kan de decoder onschadelijke padding niet onderscheiden van een byte die veel eerder verloren ging of werd toegevoegd en elke body daarna heeft verschoven
Waarom laat een op byteaantal gestuurde lus het laatste end-of-page-segment vallen?
Een lus die draait "zolang er bytes over zijn", eindigt te vroeg op een random-access bestand, want de data raakt op voordat de headerindex op is. End-of-page- (type 49) en end-of-file-segmenten dragen nul bytes data en komen normaal als laatste. Zodra de laatste regio-body is verbruikt, staat de leespositie exact op het einde van de buffer; een op byteaantal gestuurde lus stopt daar, en het segment met nul lengte van end-of-page wordt nooit afgehandeld, waardoor de pagina onafgewerkt blijft
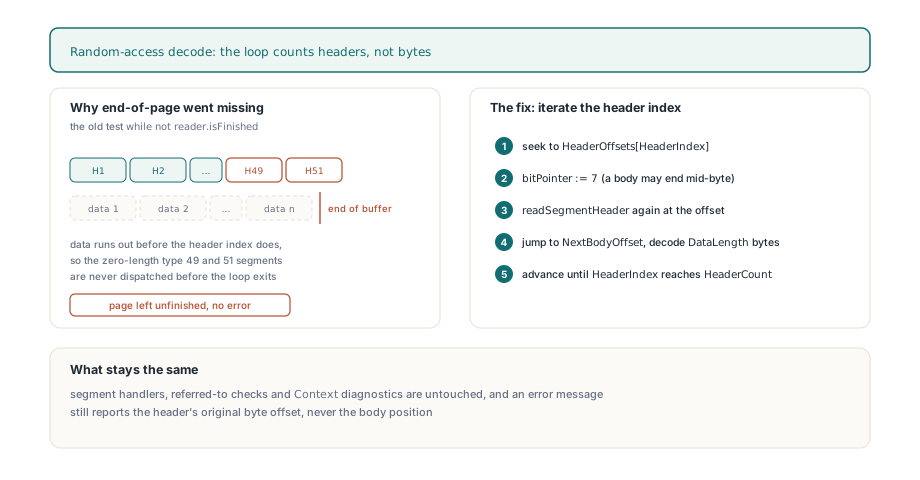
Dus voor random-access bestanden telt de decoder headers, geen bytes. Elke stap springt terug naar de volgende geïndexeerde header, lijnt weer uit op een bytegrens (een arithmetic-gecodeerde body kan midden in een byte eindigen), parst de header opnieuw, springt dan vooruit naar waar de volgende body begint en loopt daar doorheen tot de opgegeven lengte. Een body waarvan de decoder eerder klaar is, wordt overgeslagen tot zijn opgegeven einde; één die er voorbij leest wordt geweigerd. Vanaf daar gaat het segment door dezelfde handlers en referentiecontroles als in een sequentieel bestand. Fouten die tijdens het decoderen van een body ontstaan dragen de oorspronkelijke positie van de header, in de vorm JBIG2 segment N (type T) at byte B: ..., zodat de offset in LastError naar iets wijst dat je in een hex-editor kunt vinden
Een random-access .jb2-bestand laden in Delphi
Applicatiecode verandert niet met de organisatie. TPLJBIG2Decoder.LoadFromByteArray herkent de fileheader en de layout, geeft False terug bij elke geweigerde invoer met de reden in LastError, en stelt de gedecodeerde pagina bloot via Width, Height en GetScanline, die één byte per pixel vult met 1 voor zwart
uses
  SysUtils, Classes, PDFlibJBIG2;

function ReadJb2(const FileName: string): TJBIG2ByteArray;
var
  FS: TFileStream;
begin
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    SetLength(Result, FS.Size);
    if Length(Result) > 0 then
      FS.ReadBuffer(Result[0], Length(Result));
  finally
    FS.Free;
  end;
end;

function CountBlackPixels(const FileName: string): Integer;
var
  Decoder: TPLJBIG2Decoder;
  Row: TJBIG2ByteArray;
  X, Y: Integer;
begin
  Result := 0;
  Decoder := TPLJBIG2Decoder.Create;
  try
    // Sequentiële en random-access standalone-bestanden nemen dezelfde aanroep
    if not Decoder.LoadFromByteArray(ReadJb2(FileName)) then
      raise Exception.Create('JBIG2 rejected: ' + Decoder.LastError);
    for Y := 0 to Decoder.Height - 1 do
      if Decoder.GetScanline(Y, Row) then
        for X := 0 to Decoder.Width - 1 do
          if Row[X] = 1 then
            Inc(Result);
  finally
    Decoder.Free;
  end;
end;
Wil je weten welke layout een bestand gebruikt, voor logging of om een corpus te sorteren vóór een conversierun, lees dan zelf de flags-byte. De bibliotheek stelt de organisatie die hij detecteerde niet bloot, en negen bytes zijn alles wat je nodig hebt. De helper hieronder is iets om aan je eigen code toe te voegen; hij herhaalt simpelweg de T.88-headerregels:
type
  TJb2Layout = (jlNoFileHeader, jlSequential, jlRandomAccess);

// Eigen helper, geen onderdeel van PDFlibJBIG2: classificeert een buffer op zijn T.88-fileheader
function DetectJb2Layout(const Data: TJBIG2ByteArray;
  out PageCountKnown: Boolean): TJb2Layout;
const
  Signature: array[0..7] of Byte = ($97, $4A, $42, $32, $0D, $0A, $1A, $0A);
var
  I: Integer;
begin
  Result := jlNoFileHeader;          // bijvoorbeeld een ingesloten stream die uit een PDF is gelicht
  PageCountKnown := False;
  if Length(Data) < 9 then
    Exit;
  for I := 0 to 7 do
    if Data[I] <> Signature[I] then
      Exit;
  PageCountKnown := (Data[8] and 2) = 0;   // bit 1 gezet: geen vier-byte pagina-aantal
  if (Data[8] and 1) = 0 then
    Result := jlRandomAccess
  else
    Result := jlSequential;
end;
Batchbanen: gepolsterde buffers en geweigerde bestanden
De trailing-data-regel is waar batchcode meestal de mist ingaat, en als een bestand dat elders opent op deze manier wordt geweigerd, kijk dan eerst naar de buffer en pas daarna naar het bestand. Een .jb2 uit een database-BLOB-kolom, een netwerklezing met vaste grootte of een containerformaat met uitlijnpadding kan arriveren met een paar nullen na de echte einde. Een sequentieel bestand schudt dat van zich af. Een random-access bestand met dezelfde padding faalt met JBIG2 trailing random-access data, en een buffer die een paar bytes te kort is geknipt faalt net zo goed, als afgekapt. Geef exact de bytes van het bestand door, gemeten op de echte lengte van de bron, nooit op een chunkgrootte of capaciteit
Een geweigerd bestand laat ook niets achter. LoadFromByteArray zet Width, Height en de scanlines terug voordat hij begint met decoderen, dus een mislukte aanroep meldt nulmaten in plaats van de pagina van het vorige bestand, en dezelfde decoderinstantie kan direct door naar het volgende bestand:
procedure DecodeBatch(const Files, Log, Quarantine: TStrings);
var
  Decoder: TPLJBIG2Decoder;
  I: Integer;
begin
  Decoder := TPLJBIG2Decoder.Create;
  try
    for I := 0 to Files.Count - 1 do
      if Decoder.LoadFromByteArray(ReadJb2(Files[I])) then
        Log.Add(Format('%s: %d x %d', [Files[I], Decoder.Width, Decoder.Height]))
      else
      begin
        // Width en Height zijn hier 0; niets van het vorige bestand overleeft het
        Log.Add(Files[I] + ': ' + Decoder.LastError);
        if Pos('trailing random-access data', Decoder.LastError) > 0 then
          Quarantine.Add(Files[I]);   // controleer hoe de bytes zijn opgeslagen voordat je het bestand de schuld geeft
      end;
  finally
    Decoder.Free;
  end;
end;
Dit controleren in je eigen pipeline vraagt geen zeldzame voorbeeldbestanden. Herschik een sequentieel .jb2 naar random-access layout, houd elke header en elke gecomprimeerde byte vast, verplaats de end-of-page- en end-of-file-headers naar het einde van het headerblok, en de gedecodeerde pixels moeten exact matchen met het sequentiële origineel, zowel met als zonder het pagina-aantal-veld. Voer daarna elke afgeknipte prefix, een gedupliceerd segmentnummer, één extra byte aan het eind en een lengte 0xFFFFFFFF erin; elk zou False moeten teruggeven met Width en Height op nul
Wat de decoder teruggeeft, en wat hij verwacht
Random access is hier een eigenschap van de bestandslayout. TPLJBIG2Decoder geeft de bitmap van de eerste pagina terug welke organisatie het bestand ook gebruikt, en Width en Height beschrijven die pagina. Elk segment moet zijn datalengte opgeven; T.88 laat een immediate generic region de marker 0xFFFFFFFF gebruiken, en de decoder weigert die marker in beide layouts met unknown or oversized segment length is not supported. Custom Huffman-prefixlengtes en table-entry-aantallen zijn op dezelfde manier begrensd als in sequentiële bestanden
Het decoderen van JBIG2 is één stadium van een langere beeldroute die ook PDF-beeldextractie, hercompressie en JBIG2-encoding dekt; de productpagina van PDF Library for Delphi behandelt de rest van die pipeline en de ondersteunde beeldformaten