Dump een JBIG2 Tables-segment (type 53) byte voor byte en de eerste verrassing is wat het achterwege laat: de Huffman-codes zelf. Je krijgt een flags-byte, twee grenzen en een reeks kleine getallen, en die getallen zijn codelengtes. Encoder en decoder bouwen allebei de echte bitpatronen op uit de lengtes met de procedure uit ITU-T T.88 Annex B.3. Bouw ze in een net iets andere volgorde op en je krijgt nog steeds een geldige prefixcode, elk patroon decodeert nog steeds, en elke waarde komt uit aan het verkeerde patroon vastgeplakt
Op een pagina die met Huffman-symbool-ID's en door de encoder meegeleverde tabellen is gecodeerd, ziet die mismatch eruit als een slechte scan: glyphs een paar pixels verschoven, tekens opgebouwd uit de verkeerde symbolen, of plausibele getallen tot een width enkele segmenten later uit bereik raakt. Het meeste JBIG2 in PDF-bestanden is aritmetisch gecodeerd, en het meeste Huffman-gecodeerde JBIG2 houdt zich aan de standaardtabellen B.1 tot B.15. Bestanden die hun eigen tabellen meesturen zijn zeldzaam, en ze tenderen ernaar de tabelparser, Huffman-gecodeerde refinement en ongecomprimeerde collective bitmaps allemaal tegelijk uit te proberen
Wat een Tables-segment werkelijk bevat
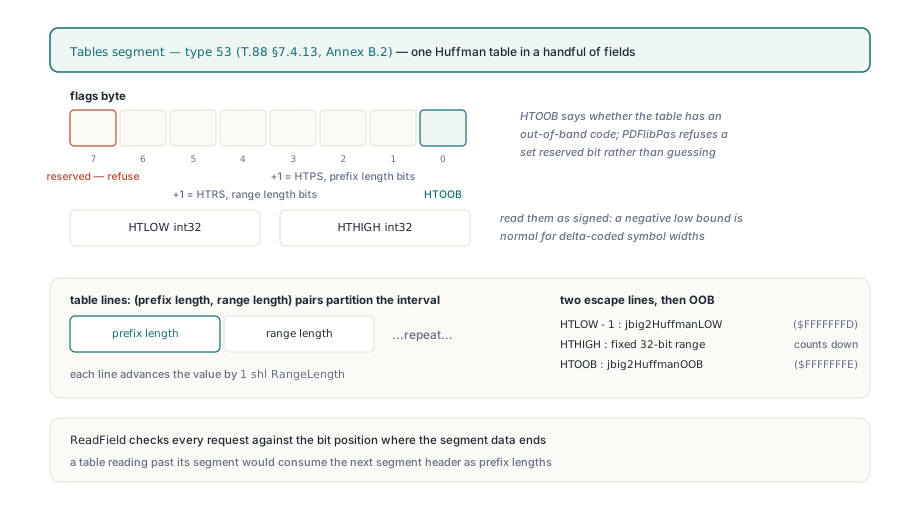
Een Tables-segment beschrijft exact één Huffman-tabel. T.88 §7.4.13 en Annex B.2 leggen hem uit als één flags-byte, een signed 32-bit HTLOW, een signed 32-bit HTHIGH, en daarna (prefixlengte, rangelengte)-paren die het interval van HTLOW tot HTHIGH tegelen. Bit 0 van de flags is HTOOB, die zegt of de tabel een out-of-band-code heeft. Bits 1 tot 3 plus één geven HTPS, de breedte van elk prefixlengteveld. Bits 4 tot 6 plus één geven HTRS, de breedte van elk rangelengteveld. Bit 7 is gereserveerd
De grenzen zijn waar een handgeschreven parser meestal als eerste struikelt. Lees HTLOW als unsigned en een tabel die op -2 begint, wat voor delta-gecodeerde symboolbreedtes en -hoogtes gebruikelijk is, beweert opeens net onder de 4,3 miljard te beginnen. PDF Library for Delphi leest beide grenzen als signed waarden, weigert een tabel waarvan HTLOW niet onder HTHIGH ligt of waarvan de rangelengte boven de 32 uitkomt, en controleert elke veldlezing op de bit waar de gedeclareerde data van het segment eindigt. Die laatste controle is belangrijker dan hij klinkt: een tabel die voorbij zijn segment leest, consumeert de volgende segmentheader als prefixlengtes en parst tot complete onzin. Een gezette bit 7 faalt met reserved custom Huffman table flag. Die weigering verkiezen we boven een gok, want een gegokte tabel produceert verkeerde pixels die niemand naar zijn oorzaak kan traceren
Na de gewone regels komen de escaperegels van Annex B.2. De low-range-regel begint bij HTLOW min één en telt af met een 32-bit offset, de high-range-regel begint bij HTHIGH met een 32-bit range, en de out-of-band-regel bestaat alleen als HTOOB gezet is. Deze regels dragen dezelfde markeringen die de ingebouwde standaardtabellen gebruiken, dus een eigen tabel en Tabel B.6 gaan door één decodeerloop. Een eigen tabel kan tot 65.536 regels bevatten
Waarom moeten prefixcodes in de volgorde van de tabelregels worden toegekend?
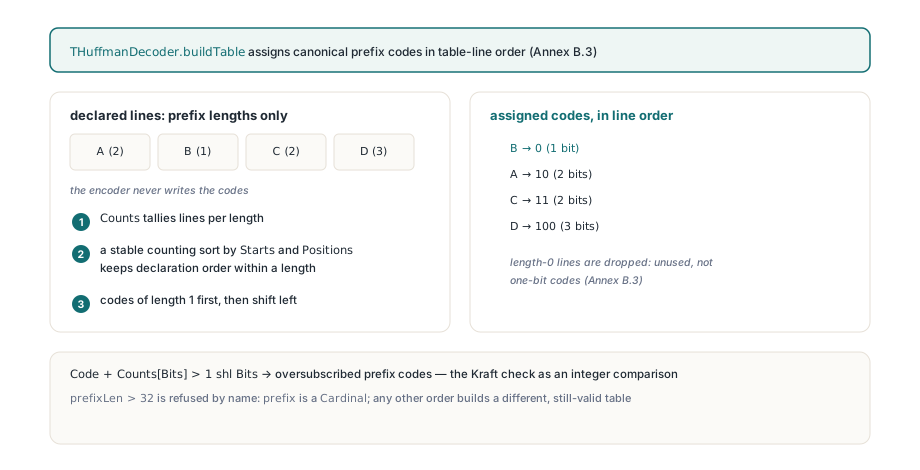
Want de declaratievolgorde is het enige dat een bitpatroon aan een waardebereik koppelt. Annex B.3 telt hoeveel regels elke prefixlengte gebruiken, deelt eerst codes van lengte 1 uit, schuift naar links om bij lengte 2 te komen, enzovoort; binnen één lengte gaan codes naar regels in de volgorde waarin ze in het segment staan. Een klein tabel maakt dit concreet. Zes regels, A tot F gelabeld in bestandsvolgorde, met deze prefixlengtes:
| Regel | Prefixlengte | Code (bestandsvolgorde aangehouden) | Code als B en D wisselen |
|---|---|---|---|
| A | 2 | 00 | 00 |
| B | 3 | 100 | 101 |
| C | 2 | 01 | 01 |
| D | 3 | 101 | 100 |
| E | 3 | 110 | 110 |
| F | 0 | ongebruikt | ongebruikt |
Beide kolommen zijn geldige prefixcodes. Alleen de linker is wat de encoder bedoelde: met B en D gewisseld levert het patroon 100 het waardebereik van D op en gaat de decoder verder met een getal uit het verkeerde interval. Regel F heeft lengte 0, wat B.3 als ongebruikt definieert; geef hem een code van één bit en elke latere toewijzing schuift op
De makkelijke manier om de rechterkolom te krijgen is een algemene sortering op prefixlengte. De TArray.Sort en TList<T>.Sort van Delphi zijn niet stabiel, dus gelijke lengtes kunnen in willekeurige volgorde terugkomen. Voor canonieke codes in je eigen gereedschap loop je de regels liever één keer per lengte in bestandsvolgorde na:
uses
  System.SysUtils;

type
  TCodeLine = record
    PrefixLen: Integer;   // zoals gelezen uit het Tables-segment
    Code: Cardinal;       // hieronder toegekend
  end;

// Canonieke toewijzing volgens Annex B.3, geschreven voor je eigen gereedschap.
// Gelijke lengtes houden hun bestandsvolgorde; lengte 0 krijgt geen code.
procedure AssignCanonicalCodes(var Lines: array of TCodeLine);
var
  LenCount: array[0..32] of UInt64;
  FirstCode: array[0..32] of UInt64;
  NextCode: UInt64;
  CurLen, I: Integer;
begin
  FillChar(LenCount, SizeOf(LenCount), 0);
  for I := 0 to High(Lines) do
  begin
    if (Lines[I].PrefixLen < 0) or (Lines[I].PrefixLen > 32) then
      raise Exception.Create('prefix length out of range');
    Inc(LenCount[Lines[I].PrefixLen]);
  end;
  LenCount[0] := 0;
  FirstCode[0] := 0;
  for CurLen := 1 to 32 do
  begin
    FirstCode[CurLen] := (FirstCode[CurLen - 1] + LenCount[CurLen - 1]) shl 1;
    // Kraft-check: meer codes dan deze lengte kan bevatten
    if FirstCode[CurLen] + LenCount[CurLen] > (UInt64(1) shl CurLen) then
      raise Exception.Create('oversubscribed prefix lengths');
    NextCode := FirstCode[CurLen];
    for I := 0 to High(Lines) do       // bestandsvolgorde is de tie-break
      if Lines[I].PrefixLen = CurLen then
      begin
        Lines[I].Code := Cardinal(NextCode);
        Inc(NextCode);
      end;
  end;
end;
Voer hem de zes regels hierboven en A krijgt 00, C krijgt 01, B krijgt 100, D krijgt 101 en E krijgt 110; F houdt geen code over. PDF Library for Delphi doet hetzelfde werk met een telpassage, die uit constructie stabiel is en voorkomt dat de tabel 32 keer opnieuw wordt doorgescand, en past dezelfde twee vangrails toe. Oversubscribed lengtes falen met oversubscribed Huffman prefix codes; laat ze door en één patroon kan op twee regels passen. Prefixes langer dan 32 bits falen ook bij naam, al staat T.88 ze op papier toe. Dat plafond is naar onze mening de juiste afweging: elke code past in één machine-woord, en een bestand dat meer nodig heeft is veel waarschijnlijker beschadigd dan slim
Waarden vragen dezelfde zorg. De low-range-regel decodeert als HTLOW min één min een 32-bit unsigned offset, en met een tussenstap in 32-bit Integer kan die subtractie omslaan in een onschuldig ogende positieve breedte. De decoder doet het in 64 bits en gooit Huffman value exceeds signed integer range als het echte resultaat niet past
Selectorvolgorde, en twee valkuilen die elkaar dekken
Een tekstregio of symbol dictionary noemt zijn tabellen niet. Hij draagt twee-bit-selectors, en elke selector die op custom staat pakt het volgende Tables-segment uit de referred-to-lijst, in referral-volgorde. T.88 §7.4.3.1.2 ordent tekstregio-selectors als FS, DS, DT, RDW, RDH, RDX, RDY en RSIZE; §7.4.2.1.1 ordent symbol dictionary-selectors als DH, DW, BMSIZE en AGGINST. Waarden 0 en 1 pakken standaardtabellen, 3 pakt een eigen tabel, en 2 is gereserveerd op velden met slechts twee standaardtabellen. PDF Library for Delphi weigert gereserveerde selectorwaarden, en faalt met missing custom Huffman table reference als de selectors meer eigen tabellen willen dan de regio aanwijst
Schrijf je zelf een decoder, dan zijn hier twee fouten makkelijk te maken, en elk verbergt de ander. De eerste bijt in Delphi, of FPC in Delphi-modus (objfpc-modus weigert de code als dubbele identifier): een flags-setter waarvan de parameter dezelfde naam draagt als het veld. De parameter schaduwt het veld, Flags := Flags wijst het aan zichzelf toe, en het veld blijft nul. Elke selector leest dan nul, een tekstregio gebruikt standaardtabellen B.6, B.8 en B.11 voor FS, DS en DT wat het bestand ook vroeg, en het eigen pad draait nooit
De tweede zit in de symbol dictionary. Een Huffman-dictionary kan zijn symbolen opslaan als ongecomprimeerde collective bitmap (BMSIZE nul), waarbij elke rij eindigt in een partiele byte. De padding-waarde is het aantal geldige bits in die byte, en het is verleidelijk om hem als de laagste geldige bitpositie te lezen:
// Laatste byte van één collective-bitmap-rij, bits gelezen MSB eerst.
// Padding := TotalWidth mod 8  -> aantal GELDIGE bits in deze byte

// Fout: behandelt Padding als de laagste bitindex om te kopiëren
for BitPos := 7 downto Padding do
  CopyPixel((LastByte shr BitPos) and 1);

// Goed: de laagste geldige bitindex is 8 - Padding (0 als Padding = 0)
for BitPos := 7 downto ((8 - Padding) and 7) do
  CopyPixel((LastByte shr BitPos) and 1);

// CopyPixel staat voor wat de pixel ook schrijft in je eigen decoder
Controleer de grensbreedtes. Een rij van 63 pixels heeft een padding van 7: de verkeerde loop kopieert één bit van de laatste byte, de goede zeven. Een rij van 9 pixels heeft een padding van 1: de verkeerde loop kopieert er zeven, de goede één. Op 64 pixels kopieert allebei alle acht, dus veelvouden van 8 leggen hem nooit bloot. Synthetische collective bitmaps van 7 en 9 pixels breed spelden beide kanten van de bytegrens vast. En de schade reist mee, want refinement gebruikt deze symbolen als referenties
Heeft je eigen decoder beide valkuilen, dan wordt debuggen een treurige aangelegenheid. Corrigeer alleen de setter en het eigen pad draait eindelijk, recht de gebroken collective bitmaps in, dus de pagina ziet er nog steeds verkeerd uit. Corrigeer alleen de padding en er verandert niets zichtbaars, want het eigen pad blijft onbereikbaar. Test allebei met synthetische invoer voordat je een van de twee wijzigingen vertrouwt. Eén verwant detail: een Huffman-symbool dictionary waarvan input en nieuwe symbolen samen één opleveren krijgt uit de log2-formule een symbol code length van 0, terwijl de Huffman-variant elk symbool-ID met ten minste één bit schrijft. PDF Library for Delphi verhoogt die lengte in Huffman-modus naar 1
Waar leest Huffman-refinement zijn bitmapgrootte?
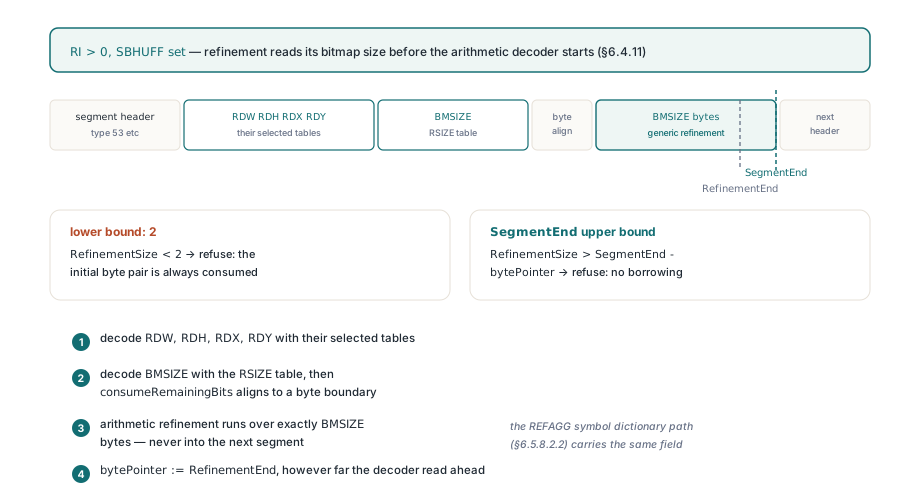
Uit een BMSIZE-veld dat alleen in Huffman-modus bestaat, gedecodeerd vóór de aritmetische refinementdata. Als een tekstregio-instantie refinement heeft (RI niet nul) en SBHUFF gezet is, laat T.88 §6.4.11 de decoder RDW, RDH, RDX en RDY met hun geselecteerde tabellen lezen, dan BMSIZE met de RSIZE-tabel, dan naar een bytegrens springen, en pas daarna generieke refinement-decodering draaien over precies BMSIZE bytes. Tekstregio's in aritmetische modus hebben zo'n veld niet, dus een decoder die één codepad tussen de modussen deelt slaat het over, start de aritmetische decoder vroeg, en verfijnt elk symbool tegen ruis. Het pad van de symbol dictionary met REFAGG en één refinement-instantie (§6.5.8.2.2) heeft hetzelfde veld
PDF Library for Delphi begrenst BMSIZE aan beide kanten. Het minimum is 2, het eerste bytepaar dat de aritmetische decoder altijd verbruikt. Het maximum is wat van het huidige segment resteert, bewust niet van de hele stream: een BMSIZE dat alleen past door bytes uit het volgende segment te lenen is misvormd, en een stream-lengtecontrole zou de aritmetische decoder in de volgende header laten lezen. Out-of-range-groottes falen met invalid refinement bitmap size. Daarna hervat de Huffman-reader exact BMSIZE bytes voorbij het veld, wat de aritmetische decoder ook alvast had gelezen
De gedeclarede segmentlengte is de grens
Elke segmentheader zegt hoeveel databytes volgen, en de decoder houdt het segment in beide richtingen aan dat getal: voorbij het einde lezen is een fout, vroeg klaar zijn is normaal, en de volgende header wordt altijd gelezen op de plek waar het bestand zegt dat hij begint. Kleinere regels volgen. De unknown data length van T.88 §7.2.7 wordt vooraf geweigerd in plaats van naar een terminator te zoeken. Referred-to-segmenten moeten kleinere nummers dragen dan het huidige en moeten al bestaan. END_OF_PAGE en END_OF_FILE moeten nul databytes declareren. Een Profiles-segment (type 52) moet exact 4 plus 4 keer zijn identifier-aantal groot zijn; hij wordt dan overgeslagen maar bewaard, zodat latere segmenten hem nog kunnen aanwijzen, en een onbekende profile-identifier stopt de decode niet
Het klassieke geval van vroeg klaar zijn is MMR. Een MMR-decoder is klaar zodra hij de laatste pixel van de laatste rij produceert, wat vóór de EOFB-terminator kan gebeuren die T.88 §6.2.5.7 aan het einde van de data zet. Een reader die aanneemt dat hij nu op de volgende header zit, parst de overgebleven EOFB-bytes als segmentnummer en faalt een paar bytes later, ver van de echte oorzaak. Naar het gedeclarede einde springen omzeilt de vraag. Dezelfde gewoonte loopt door in hoe PDF Library for Delphi in het algemeen niet-vertrouwde PDF-structuren parset
Een JBIG2-beeldstream vanuit Delphi decoderen
De decoder woont in de unit PDFlibJBIG2 als TPLJBIG2Decoder. LoadFromByteArray neemt de ingebedde JBIG2-data van een /JBIG2Decode-afbeelding en optioneel de data van zijn /JBIG2Globals-stream, wat doorgaans de plek is waar eigen tabellen en gedeelde symbol dictionaries wonen. Hij geeft False terug bij elke weigering en laat de reden in LastError achter; uitvoer van een eerdere aanroep wordt bij elke aanroep eerst gewist, dus een mislukte decode laat nooit oude pixels achter die de aanroeper voor een resultaat kan aanzien
uses
  System.SysUtils, PDFlibJBIG2;

// ImageBytes: de data van de beeldstream, met eventuele filters vóór
//   JBIG2Decode al verwijderd
// GlobalBytes: de data van de /JBIG2Globals-stream, of een lege array
function DecodeAndCountBlack(const ImageBytes, GlobalBytes: TJBIG2ByteArray;
  out BlackPixels: Int64): Boolean;
var
  Decoder: TPLJBIG2Decoder;
  Line: TJBIG2ByteArray;
  Row, Col: Integer;
begin
  BlackPixels := 0;
  Decoder := TPLJBIG2Decoder.Create;
  try
    Result := Decoder.LoadFromByteArray(ImageBytes, GlobalBytes);
    if not Result then
    begin
      // Vorm: 'JBIG2 segment <n> (type <t>) at byte <offset>: <reason>'
      Writeln('JBIG2 refused: ', Decoder.LastError);
      Exit;
    end;
    for Row := 0 to Decoder.Height - 1 do
    begin
      Decoder.GetScanline(Row, Line);   // één byte per pixel, 0 of 1
      for Col := 0 to Decoder.Width - 1 do
        Inc(BlackPixels, Line[Col]);    // 1 = zwart in JBIG2
    end;
  finally
    Decoder.Free;
  end;
end;
De telling van zwarte pixels is je eigen controle, een goedkope vingerprint om tegen een tweede renderer te vergelijken. Falingen op segmentniveau komen binnen met segmentnummer, type en byte-offset als prefix, dus (type 53) vóór oversubscribed Huffman prefix codes wijst rechtstreeks naar een Tables-segment. Houd de twee foutkanalen uit elkaar: TPLJBIG2Decoder.LastError is de diagnostische tekst van deze decoder, terwijl TPDFlib.LastErrorCode de numerieke code van de API op bibliothecasniveau is. Paginaselectie volgt de stream: de decoder geeft de bitmap van het eerste page-information-segment dat hij tegenkomt terug en zoekt paginakoppeling 0 niet op, want JBIG2 in PDF draagt één pagina en encoders nummeren hem routinematig 1
Renderers op deze bestanden vergelijken vraagt enige bescheidenheid, want onafhankelijke JBIG2-decoders zijn het op bestanden met eigen tabellen en Huffman-refinement niet altijd met elkaar eens. Twee decoders die het oneens zijn bewijzen niets. De formaatvelden wel: welke tabellen de selectors kozen, wat BMSIZE declareerde, waar elk segment eindigt
Encoding komt aan bod in het artikel over JBIG2-encoder-backends en hoe ze worden gelinkt. Het leespad moet nemen wat de encoder van een ander ook uitspuugt, en deelt zijn regels met de ingebouwde TIFF-decoder en zijn BigTIFF- en tiled-layout-controles: weiger bij naam, leen nooit bytes voorbij een gedeclareerde grens, houd tussenrekenen breed. Als een map vol gescande PDF's andere toolkits telkens laat struikelen, controleer dan of de afbeeldingen Huffman-gecodeerd JBIG2 met eigen tabellen zijn en probeer ze tegen het native Delphi- en C++Builder-leespad dat op de productpagina van PDF Library for Delphi wordt beschreven