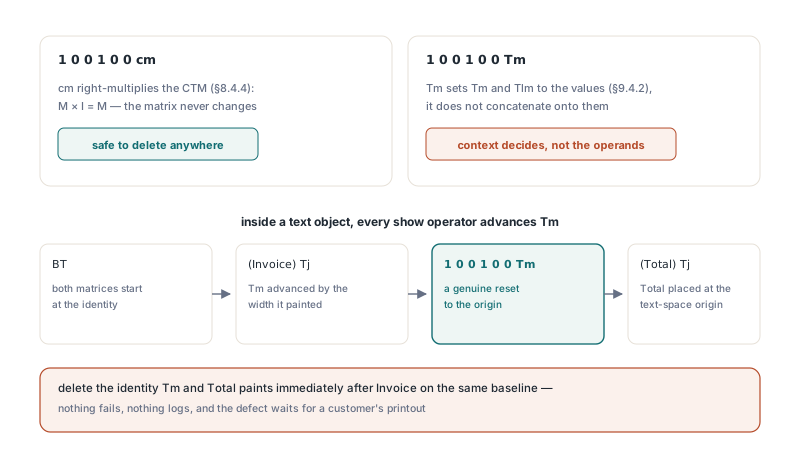
Neem een content stream zoals een rapportgenerator die zou schrijven, BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET, en strik de 1 0 0 1 0 0 Tm weg omdat zijn zes getallen de identiteitsmatrix spellen. Render het resultaat en "Total" begint niet meer in de tekstruimte-oorsprong. Hij begint waar "Invoice" eindigde, op dezelfde baseline. Een identity Tm is alleen overbodig zolang de tekstmatrix en de tekstregelmatrix al de identity vasthouden: direct na BT, of direct na een andere identity Tm
De verwijdering is verleidelijk omdat dezelfde zes getallen vóór cm echt dode last zijn. Een content-stream-optimizer die de twee operators gelijk behandelt krimpt heel wat streams terecht. Tot hij een generator tegenkomt die een identity Tm als wagenterugloop gebruikt, en dan schuift er tekst
Waarom is 1 0 0 1 0 0 Tm niet altijd een no-op?
De twee operators doen verschillende rekenkunde. ISO 32000-1 §8.4.4 definieert cm als het samenvoegen van zijn operand met de huidige transformatiematrix; vermenigvuldig elke matrix met de identity en je krijgt dezelfde matrix terug, dus 1 0 0 1 0 0 cm kan overal waar hij verschijnt worden verwijderd. Tm is een toekenning. Onder §9.4.2 zet hij zowel de tekstmatrix als de tekstregelmatrix op zijn operanden en gooit weg wat ze vasthielden, dus of hij iets verandert hangt volledig af van de operators vóór hem
§9.4.1 zegt dat BT beide matrices op de identity start. Vanaf daar verplaatst bijna alles binnen een tekstobject ten minste één van beide. Td, TD, T* en een niet-identity Tm herpositioneren de tekstregelmatrix. Elke tekst-tonende operator (Tj, TJ, ' en ") schuift de tekstmatrix op met de breedte van de glyphs die hij net schilderde, en de laatste twee beginnen eerst een nieuwe regel. Zodra één van die heeft gedraaid is een identity Tm een echte sprong terug naar de oorsprong. De factuurstream hierboven leunt op die sprong
Een stream met de hand natrekken beslecht het snel. Jaag het factuurvoorbeeld door de content-stream CTM- en tekstmatrix-statustracker en het verslag toont cm die samenvoegt op de CTM terwijl Tm beide tekstmatrices overschrijft — twee verschillende bijwerkregels achter identieke operanden
Hoe PDF Library for Delphi beslist welke identity Tm hij laat vallen
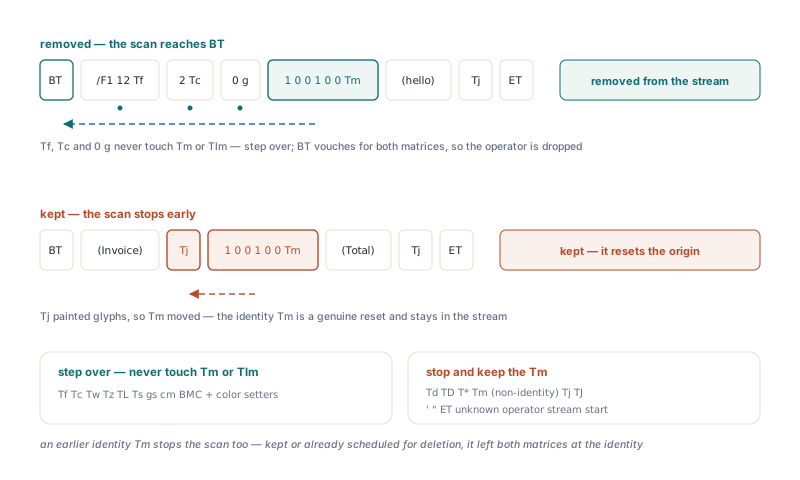
PDF Library for Delphi laat elke identity cm vallen tijdens zijn peephole-pas, en laat een identity Tm alleen vallen wanneer een achterwaartse scan vanaf die operator BT of een andere identity Tm bereikt voordat hij iets tegenkomt dat de tekstmatrices zou kunnen hebben verplaatst. De toets voor "identity" is numeriek: de operator heeft precies zes getaloperanden nodig die gelijk zijn aan 1, 0, 0, 1, 0, 0, dus 1.0 0 0 1.0 0 0 Tm kwalificeert ook. Achterwaarts wandelend stopt de scan elke operator die hij tegenkomt in één van twee groepen:
- Stoppen en de Tm houden:
Td,TD,T*, een niet-identityTm,Tj,TJ,',",ET, elke operator die de parser niet herkent, of het begin van de stream - Stap over en blijf scannen: operators die de tekstmatrix of de tekstregelmatrix nooit aanraken, zoals
Tf,Tc, kleursetters,gs, marked-content-operators,Doencm
Een eerdere identity Tm beëindigt de scan ten gunste van verwijdering, of de optimizer hem nu houdt of al voor verwijdering heeft aangemeld. In beide gevallen liet hij beide matrices op de identity achter, wat dezelfde toestand is die BT nalaten. Daarom klapt een reeks van drie identity Tm-operators direct na BT in elkaar tot niets
De conservatieve stops zijn met opzet. Een onbekende operator zou een vendor-extensie kunnen zijn die van alles doet, dus de scan weigert er langs te redeneren. Na ET is er geen open tekstobject, en een identity Tm die daar zit heeft geen BT die voor de matrixwaarden garant staat. De scan kijkt ook maar naar één content stream per keer. Dat telt voor pagina's waarvan de /Contents een array is: PDF laat een tekstobject in de ene stream beginnen en in de volgende doorgaan, dus een laag die middenin een tekstobject opent, zonder eigen BT, houdt zijn identity Tm, ook als de vorige laag hem overbodig zou hebben gemaakt
Wij vinden dat de juiste kant om in te fouten. Matrices over streamgrenzen heen volgen, of onbekende operators simuleren, zou misschien veertien bytes ongecomprimeerde tekst per rare bestand opleveren. Het verkeerd doen schuift een glyph op een geprinte factuur. De kosten en het risico zitten niet in dezelfde competitie
Eén neveneffect is het kennen waard omdat het verandert wat je in de uitvoer ziet. Dezelfde pas haalt ook tekstobjecten met niets erin weg, dus BT 1 0 0 1 0 0 Tm ET verdwijnt volledig: de identity Tm gaat eerst, en het BT/ET-paar dat hij achterlaat is leeg
De optimizer op een content-stream-snippet draaien
De optimizer werkt op hetzelfde geparsde TPDFContentProgram-model waarmee je paginatekst op instructieniveau bewerkt, zoals in de character-to-content-byte mapping-rondwandeling. Daarmee is het makkelijk om de regel op een string te proberen voordat je hem een heel document toevertrouwt. De helper hieronder parst een gedecodeerde stream, draait TPDFContentPeepholeOptimizer, en zendt het resultaat uit met één instructie per regel. CanonicalNumbers vóór Parse zetten spiegelt de save-pas, die elk getal herschrijft op een vaste precisie
uses
  PDFlibContentModel, PDFlibContentOptimize;

function OptimizeSnippet(const Source: AnsiString): AnsiString;
var
  Prog: TPDFContentProgram;
  Optimizer: TPDFContentPeepholeOptimizer;
begin
  Result := Source;
  Prog := TPDFContentProgram.Create;
  try
    Prog.CanonicalNumbers := True; // dezelfde getalafhandeling als de save-pas
    if not Prog.Parse(Source) then
      Exit; // grove structurele schade: laat de bytes met rust
    Optimizer := TPDFContentPeepholeOptimizer.Create(Prog);
    try
      Optimizer.Run; // geeft het aantal verwijderde instructies terug
    finally
      Optimizer.Free;
    end;
    Result := Prog.Emit; // één instructie per regel, gescheiden door #10
  finally
    Prog.Free;
  end;
end;

// Verwijderd: Tm direct na BT, de tweede van twee identity Tm op een rij
//   OptimizeSnippet('BT /F1 12 Tf 1 0 0 1 0 0 Tm (hello) Tj ET')
// Behouden: Tm na Td, na Tj, na een niet-identity Tm, of buiten BT
//   OptimizeSnippet('BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET')
Jaag de factuurstream erdoorheen en de identity Tm overleeft het, want de achterwaartse scan raakt Tj lang voordat hij BT bereikt. Zet /F1 12 Tf, 2 Tc en 0 g tussen BT en de identity Tm en hij gaat alsnog, want geen van die raakt aan de tekstmatrices. Het interessante geval is BT 10 20 Td 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm. Hij verliest exact één operator. De eerste identity Tm maakt de sprong van Td ongedaan, en alleen de tweede is overbodig
Parse geeft alleen False terug bij grove schade zoals een niet-afgesloten string of dictionary. Onbekende operators parsen prima en blijven in het programma, waar ze als harde stops voor de scan dienen
Wanneer draait de peephole optimizer werkelijk?
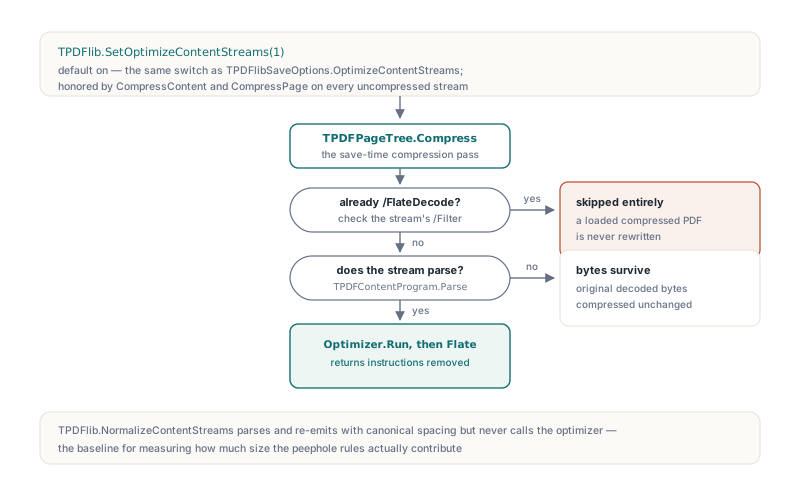
De optimizer draait alleen binnen de compressiepas, en alleen op pagina-contentstreams die nog niet Flate-gecomprimeerd zijn. TPDFlib.SetOptimizeContentStreams(1) is de default, en dezelfde schakelaar verschijnt als het veld OptimizeContentStreams van TPDFlibSaveOptions; CompressContent en CompressPage eren allebei. Een stream waarvan de /Filter al /FlateDecode is wordt helemaal overgeslagen, dus een typische gecomprimeerde PDF laden en opnieuw opslaan laat zijn operators exact zoals ze waren. Streams die ongecomprimeerd zijn opgeslagen worden gedecodeerd, geoptimaliseerd en daarna Flate-gecomprimeerd. Mislukt het parsen van een stream, dan worden zijn originele gedecodeerde bytes ongewijzigd gecomprimeerd
var
  Lib: TPDFlib;
  Options: TPDFlibSaveOptions;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('report.pdf', '') <> 1 then
      Exit;
    // Ongecomprimeerde paginastreams gaan door de peephole-regels, dan Flate
    Lib.SetOptimizeContentStreams(1);
    Lib.CompressContent;
    Lib.SaveToFile('report-optimized.pdf');

    // Dezelfde keuze via de meegeleverde save-opties; False opt out
    Options.CompressContent := True;
    Options.CompressFonts := True;
    Options.CompressImages := True;
    Options.Linearize := False;
    Options.KeepModDate := False;
    Options.OptimizeContentStreams := False;
    Options.GarbageCollect := False;
    Options.PackObjectStreams := True;
    Lib.SaveToFileOptions('report-plain.pdf', Options);
  finally
    Lib.Free;
  end;
end;
Laat de default aan. Elke transformatie in de pas is output-equivalent, en de identiteitsmatrixregel jaagt op een patroon dat veel generators uitzenden, die elk tekstobject openen met BT 1 0 0 1 0 0 Tm. Hem uitzetten is vooral zinvol als je je eigen ongecomprimeerde output wilt diffen tegen wat je schreef, of als je een baseline nodig hebt. Voor die baseline parst TPDFlib.NormalizeContentStreams en zendt hij content opnieuw uit met canonieke spatiëring en getallen maar roept hij de optimizer nooit aan, dus het grooteverschil tussen een genormaliseerde save en een geoptimaliseerde save is wat de peephole-regels bijdroegen. Reken op bescheiden, naast de grotere winsten uit PDF-bestandsgrootte optimaliseren met font subsetting
Een test die één vorm dekt definieert de regel niet
Een test die BT 1 0 0 1 0 0 Tm (hello) Tj ET aan een optimizer voert en asserteert dat er geen Tm overblijft, spelt één vorm vast: een identity Tm direct na BT wordt verwijderd. Hij zegt niets over een identity Tm na Td of na getoonde tekst. Die ene assertie lezen als "identity Tm is altijd verwijderbaar" is een makkelijke fout, en een dure, want het voorbeeld slaagt hoe dan ook. Tests voor elke regel zoals deze hebben de behouden vormen naast de verwijderbare nodig
De helper hieronder telt de Tm-operators die overleven en toetst dan een tabel met invoeren. Ruil ExpectTm in voor de assertie van je testframework; hij maakt geen deel uit van de library
uses
  SysUtils, PDFlibContentModel, PDFlibContentOps, PDFlibContentOptimize;

function TmCountAfterOptimize(const Source: AnsiString): Integer;
var
  Prog: TPDFContentProgram;
  Optimizer: TPDFContentPeepholeOptimizer;
  I: Integer;
begin
  Result := -1; // -1 signaleert een parse-mislukking
  Prog := TPDFContentProgram.Create;
  try
    if not Prog.Parse(Source) then
      Exit;
    Optimizer := TPDFContentPeepholeOptimizer.Create(Prog);
    try
      Optimizer.Run;
    finally
      Optimizer.Free;
    end;
    Result := 0;
    for I := 0 to Prog.Count - 1 do
      if Prog[I].Op = coTextMatrix then
        Inc(Result);
  finally
    Prog.Free;
  end;
end;

// Eigen check-helper, hier gesuggereerd; vervang door een echte assertie
procedure ExpectTm(const Source: AnsiString; Expected: Integer);
var
  Actual: Integer;
begin
  Actual := TmCountAfterOptimize(Source);
  if Actual <> Expected then
    raise Exception.CreateFmt('%s: expected %d Tm, got %d',
      [string(Source), Expected, Actual]);
end;

procedure CheckIdentityTmRule;
begin
  // Verwijderbare vormen
  ExpectTm('BT /F1 12 Tf 1 0 0 1 0 0 Tm (hello) Tj ET', 0);
  ExpectTm('BT 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm (a) Tj ET', 0);
  ExpectTm('BT /F1 12 Tf 2 Tc 0 g 1 0 0 1 0 0 Tm (a) Tj ET', 0);
  // Vormen die de identity Tm moeten houden
  ExpectTm('BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET', 1);
  ExpectTm('BT 10 20 Td 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm (a) Tj ET', 1);
  ExpectTm('BT 2 0 0 2 5 5 Tm (a) Tj 1 0 0 1 0 0 Tm (b) Tj ET', 2);
  ExpectTm('1 0 0 1 0 0 Tm (a) Tj', 1);    // geen omsluitende BT
  ExpectTm('BT ET 1 0 0 1 0 0 Tm', 1);     // na ET
end;
De laatste twee rijen ogen belachelijk totdat je bedenkt dat gelaagde /Contents-arrays precies die fragmenten produceren. Een stream die middenin een tekstobject begint heeft geen BT, en een identity Tm na ET behoort tot helemaal geen tekstobject. Allebei blijven staan. Het lege BT ET-paar in de laatste rij wordt verwijderd door de leeg-tekstobject-regel, wat de reden is dat de telling Tm-operators checkt in plaats van hele strings te vergelijken
Wat de regel opgeeft is de af en toe voorkomende identity Tm middenin een tekstobject, een paar bytes per pagina voordat Flate ze überhaupt ziet. Wat hij koopt is een garantie waarop het ontwerp van de optimizer rust: geen enkele transformatie in de pas verandert de zichtbare pagina. Een grootte-optimizer die tekst verplaatst is een renderbug met een goede compressieverhouding
Genereer of bewerk je PDF-content in Delphi of C++Builder, dan verscheept de PDF Library for Delphi en C++Builder de content-stream-parser, deze peephole-pas en de save-opties van hierboven, samen met NormalizeContentStreams voor het produceren van een schone, ongeoptimaliseerde baseline om tegen te vergelijken