Escape de opmerking van een klant netjes, zodat <b>urgent</b> als <b>urgent</b> in je HTML-template belandt, geef hem aan een renderer die de markup twee keer parst, en de PDF kan terugkomen met het woord urgent in het vet. De escaping was correct. De renderer decodeerde één keer per pass. Elk HTML-naar-PDF-pad dat parst, het resultaat als HTML terug uitschrijft en opnieuw parst, moet entities exact één keer decoderen over de hele reis
De helpdeskversie van dit verhaal is alledaags. Tickets worden naar PDF geëxporteerd, de klantenopmerking zit in een <p>, en iemand typt hoekhaken in het opmerkingenveld. Een onbekende tagnaam verdwijnt gewoon van de pagina. Een ge-escape anchor wordt een klikbare linkannotatie in een document waar je medewerkers op vertrouwen. Het bestand is geldig en opent overal; het zegt alleen iets anders dan de data
Waar ge-escape tekst weer terugvalt tot markup
Ge-escape tekst wordt markup op het punt waar een twee-pass-renderer al gedecodeerde tekst terug naar HTML uitschrijft zonder hem opnieuw te escapen. Wat de eerste pars heeft gedecodeerd is dan levende syntax voor de tweede
De twee passes in DrawHTMLText en DrawHTMLTextBox van PDF Library for Delphi (PDFlibPas) bestaan met een goede reden. De eerste pars splitst de invoer in tags en woorden. De renderer lost dan de stylesheet-cascade op: regels uit <style>-blokken worden tegen elke tag gematcht, samengevoegd met inline style-attributen, en de hele elementenlijst wordt als één genormaliseerde HTML-string teruggeschreven waarin elke tag zijn uiteindelijke stijl draagt. De lay-outpass parst die string. Selectormatching, flexbox, grid en de rest van de CSS-ondersteuning die in flexbox, CSS grid en voetnootlay-out in de HTML-rendering van PDFlibPas wordt beschreven, hangt allemaal van die tussenstap af
Het gevaar zit in hoe woorden terug naar buiten komen. Tags kunnen vanuit hun bronvorm worden teruggeschreven, maar woorden worden als gedecodeerde tekst vastgehouden, want dat is wat de regeleindebreker meet. Voeg het woord dat uit <unsafe> kwam ongewijzigd toe aan de genormaliseerde string, en bij de tweede pars komt <unsafe> binnen als element. Een ontwerp dat één keer decodeert moet ook drie kleinere lekkjes dichten:
- Als
&niet in de gedecodeerde set zit, wordtR&Dletterlijk geprint en is er helemaal geen manier om de spelling<als tekst op de pagina te krijgen - Als de tekenfase
ná de pars nog eens vervangt, verdwijnt een letterlijke entity-spelling alsnog op het laatste moment - Als een HTML-producent stroomopwaarts, zoals een Markdown-converter of een dataset-exporteur, alleen de hoekhaken escapet, wordt een entity-spelling in een codevoorbeeld of een celwaarde tot markup gedecodeerd
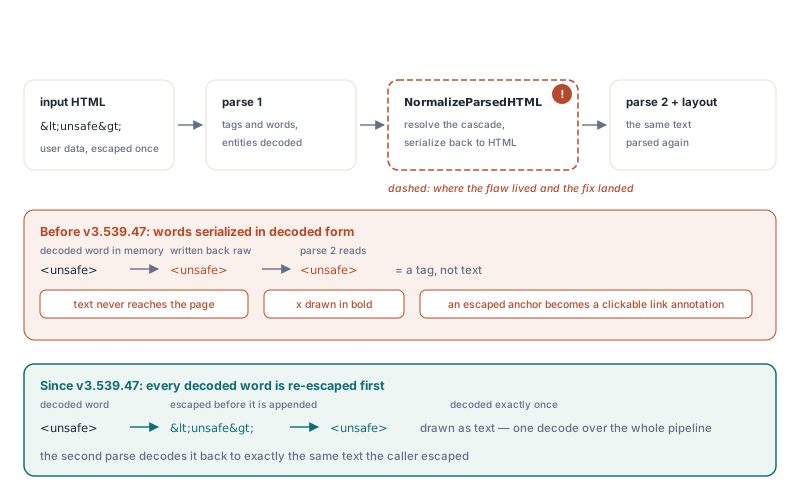
De tabel hieronder zet wat er voor een handvol invoeren op de pagina komt, en vergelijkt een naïeve twee-pass-renderer met de PDFlibPas-pijplijn
| Invoer die de renderer bereikt | Naïeve twee-pass-renderer | PDFlibPas |
|---|---|---|
<unsafe> | Geparst als tag, de tekst bereikt de pagina nooit | <unsafe> als tekst getekend |
<b>x</b> | x in het vet getekend | <b>x</b> als tekst getekend |
R&D | R&D letterlijk geprint | R&D |
&lt; | &lt; letterlijk geprint | < |
Markdown-codespan met | Een niet-brekende spatie | als tekst getekend |
Dataset-celwaarde < | < | < |
Hoe decodeert PDF Library for Delphi elke entity exact één keer?
PDF Library for Delphi decodeert elke entity exact één keer door drie regels tegelijk te volgen: de parser decodeert & als laatste, de tekenfase decodeert niets, en elke plek die gedecodeerde woorden terug naar HTML schrijft escapet ze eerst. Laat een van de drie vallen en één van de tabelrijen hierboven klapt naar de naïeve kolom
Begin bij wat er wordt gedecodeerd. In tekstinhoud herkent de parser <, >, & en . Numerieke referenties zoals A en benoemde entities zoals " blijven letterlijke tekst. Dat korte lijstje bepaalt hoe je je eigen invoer zou moeten escapen, wat verderop terugkomt
Volgorde binnen de decoder telt, zelfs binnen één pass. Decodeer & eerst en de invoer &lt; wordt <, en de allereerstvolgende vervanging maakt er < van: een dubbele decode zonder ook maar een tweede pars. Het 8-bit woordpad vervangt daarom eerst <, > en en & als laatste, zodat de ampersand die het produceert nooit meer wordt aangekeken. Het UTF-16-woordpad neemt een andere route naar hetzelfde resultaat — één scan van links naar rechts in twee-byte-stappen die elke match ter plekke herschrijft en erlangs gaat
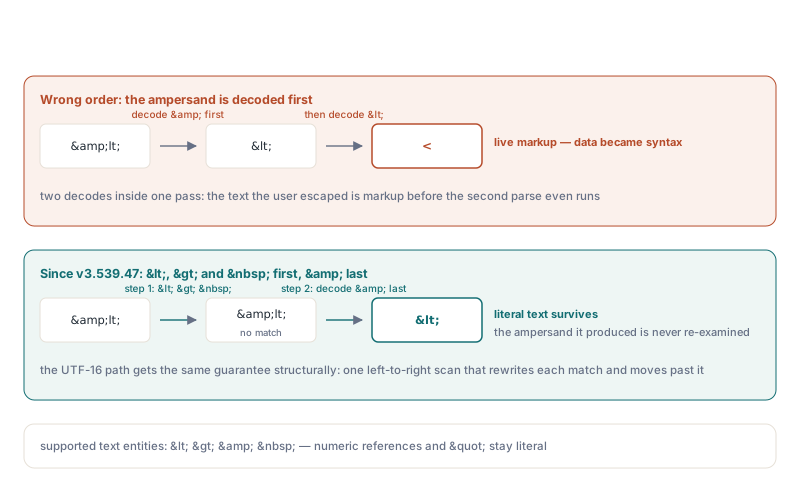
De tekenfase krijgt geen late -vervanging. Een woord dat de regeleindebreker bereikt is definitieve tekst, en decoderen woont in de parser en nergens anders
De grensregel weegt het zwaarst. Als de renderer de genormaliseerde HTML schrijft, escapet hij &, < en > in elk gedecodeerd woord voordat hij hem toevoegt, en de tweede pars decodeert hem terug naar dezelfde tekens. Netteffect over beide passes: één decode. De vervolgstring die DrawHTMLTextBox teruggeeft volgt dezelfde regel. Woorden die niet pasten worden ge-escaped voordat ze de rest in gaan, en de rest van de rest wordt uit de genormaliseerde HTML gekopieerd, die al ge-escaped is. Een box die alles neemt geeft een lege string terug
Waarom kan UTF-16BE-escaping geen replace op byteniveau gebruiken?
UTF-16BE-escaping kan geen replace op byteniveau gebruiken, want de twee bytes van een ampersand kunnen over twee ongerelateerde tekens heen spannen. De hele 16-bit code unit is de enige veilige werkeenheid
De renderer houdt Unicode-woorden vast als big-endian UTF-16 verpakt in bytestrings, hoge byte eerst, dus een ampersand is 00 26. Neem U+0100 (Latin capital A with macron, bytes 01 00) gevolgd door U+2603 (de sneeuwman, bytes 26 03). De buffer leest 01 00 26 03, en byte twee en drie spellen 00 26. Een bytezoektocht naar #0'&' vindt een ampersand die geen enkel teken bevat, plakt & midden in twee code points, en schuift elk later teken één byte op
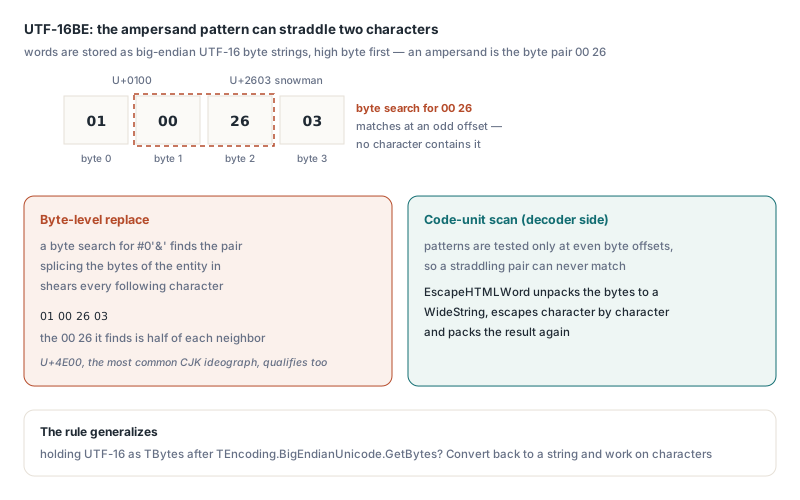
Dit is geen exotisch hoekje. Elk teken waarvan de lage byte nul is kan de eerste helft leveren, en U+4E00, een van de meest frequente CJK-ideogrammen, is zo'n teken. De hoekhaken liggen net zo bloot: 00 3C en 00 3E verschijnen telkens als zo'n teken gevolgd wordt door een uit U+3C00 tot U+3EFF in CJK Extension A. Daarom escapet PDFlibPas Unicode-woorden door ze naar een WideString uit te pakken, teken voor teken te escapen en het resultaat opnieuw in te pakken. De decoder is om dezelfde reden veilig: hij test patronen alleen op even offsets
Je eigen code kan tegen dezelfde muur oplopen. Zodra UTF-16-tekst in TBytes woont, bijvoorbeeld na TEncoding.BigEndianUnicode.GetBytes, is er een patroon in zoeken een bug die wacht op het juiste tekenpaar. Converteer terug naar een string en werk op tekens
Markdown-code en dataset-cellen: de ampersand gaat eerst
Beide HTML-producenten binnen PDFlibPas, de Markdown-converter en de dataset-exporteur, escapen de ampersand vóór de hoekhaken, zodat de ene decode in de renderer de originele tekst byte voor byte herstelt
In MarkdownToHTML mappen inline codespans en fenced of ingesprongen codeblokken & naar &, < naar < en > naar >. Spaties worden en een tab wordt er vier, wat inspringing intact houdt. Gewone proza escapet alleen de hoekhaken: rauwe HTML die in proza wordt getypt kan geen tags injecteren, terwijl een auteur die bewust & schrijft nog steeds een ampersand krijgt, zoals Markdown-auteurs verwachten. DrawMarkdownText en DrawMarkdownTextBox draaien dezelfde conversie, dus een codeblok verschijnt exact zoals getypt:
uses
System.SysUtils, PDFlibrary;
procedure RenderCodeSample;
var
Lib: TPDFlib;
Md, Html: WideString;
begin
Md := 'Comparison helper:' + sLineBreak + sLineBreak +
'```' + sLineBreak +
'if (A < B) and (Flags <> 0) then' + sLineBreak +
' WriteLn(''<tag> & R&D'');' + sLineBreak +
'```';
Lib := TPDFlib.Create;
try
// Bekijk de HTML: in code wordt '&' tot '&' en '<' tot '<'
Html := Lib.MarkdownToHTML(Md);
Lib.SetOrigin(1); // oorsprong linksboven, Y groeit naar beneden
Lib.SetMeasurementUnits(0); // punten
// De pagina toont de code exact zoals getypt, entity-spellingen inbegrepen
Lib.DrawMarkdownText(50, 50, 495, Md);
Lib.SaveToFile('code-sample.pdf');
finally
Lib.Free;
end;
end;De dataset-exporteur is waar de verleidelijke snelkoppeling woont. Zou een renderer & niet decoderen, dan zou het escapen van de ampersand in elke cel die er een bevat & printen, dus alleen de hoekhaken escapen lijkt de vriendelijkere keuze. Hij valt uit elkaar bij de eerste cel waarvan de waarde toevallig < bevat, die de pagina dan als < bereikt. Omdat de renderer & wél decodeert, escapet de exporteur achter PDFlibExportDataSet & eerst, en een waarde als R&D < & landt letterlijk in de PDF. De rest van die exporteur komt aan bod in een TDataSet naar een PDF-rapport exporteren in Delphi
Waarom eerst, en niet ergens in de keten? Escape < eerst en je krijgt <. Escape & als tweede en dat wordt &lt;, wat een correcte enkele decode toont als < in plaats van <. Een sequentiële vervangketen werkt alleen als het escape-teken zelf wordt afgehandeld vóór elke stap die hem introduceert
Hoe escapet u niet-vertrouwde tekst voor DrawHTMLTextBox?
Escape niet-vertrouwde tekstinhoud voor PDFlibPas door &, dan <, dan > te vervangen, exact één keer, en houd niet-vertrouwde data helemaal buiten attribuutwaarden. De helper hieronder voeg je zelf toe; het is kale RTL-code:
uses
System.SysUtils, PDFlibrary;
// Eigen helper (geen deel van de library): escapet niet-vertrouwde tekst
// voor PDFlibPas HTML-tekstinhoud. '&' moet eerst worden vervangen,
// anders wordt de ampersand in een vers geproduceerde '<'
// een tweede keer ge-escaped
function EscapeHTMLText(const S: string): string;
begin
Result := StringReplace(S, '&', '&', [rfReplaceAll]);
Result := StringReplace(Result, '<', '<', [rfReplaceAll]);
Result := StringReplace(Result, '>', '>', [rfReplaceAll]);
end;
procedure RenderTicket(const CustomerComment: string);
var
Lib: TPDFlib;
Html: WideString;
begin
Lib := TPDFlib.Create;
try
Lib.SetOrigin(1);
Lib.SetMeasurementUnits(0);
Html := '<p><b>Customer comment</b></p>' +
'<p>' + EscapeHTMLText(CustomerComment) + '</p>';
Lib.DrawHTMLText(50, 50, 495, Html);
Lib.SaveToFile('ticket.pdf');
finally
Lib.Free;
end;
end;Voer hem de opmerking Try <a href="https://example.com">this</a> & <b> en de pagina toont die tekens één op één. Onder een renderer die twee keer decodeert wordt dezelfde ge-escape invoer een levende linkannotatie. Dat is de stap van cosmetische glitch naar beveiligingsprobleem: een ticketopmerking mag nooit een klikbare URL kunnen planten in een PDF die naar je eigen medewerkers gaat
Let op wat de helper met rust laat. Algemene escapers zetten ook " om naar " en ' naar ', wat voor een browser goed is en hier fout — de tekstdecodering van PDFlibPas kent alleen de vier entities die eerder zijn opgesomd, dus die twee worden letterlijk geprint als " en '. Hergebruik een browser-escaper hier niet. Aanhalingstekens zijn ongevaarlijk in tekstinhoud; ze tellen alleen binnen attribuutwaarden, en de renderer decodeert in attributen helemaal geen entities. Voor attributen verkiezen we een regel boven een slimmere escaper, want daar wordt toch geen enkel escapingschema gecontroleerd: houd gebruikerswaarden buiten href, src en style. Moet een linkdoel echt uit gebruikersinvoer komen, valideer het dan zelf tegen een allow-list van schemes en tekens en wijs alles met aanhalingstekens of hoekhaken af
Twee gewoonten volgen direct uit single-pass decoderen:
- Escape
&altijd. Sla hem over, en gebruikerstekst met<verschijnt als<— ongevaarlijk, maar niet wat de gebruiker typte - Escape op één plek. Tekst die door twee escapers gaat rendert
<als de zichtbare spelling<, dus zoek de ene plek waar je data de HTML-string binnenkomt en escape daar
Pagineren met LeftOverText zonder escapes te breken
DrawHTMLTextBox geeft de HTML terug die niet paste, meestal LeftOverText genoemd, en die rest houdt letterlijke entity-spellingen en ge-escape hoekhaken intact wanneer hij in de volgende box gaat. Geef hem exact zoals je hem ontving terug
const
  BoxLeft = 50;
  BoxTop = 50;
  BoxWidth = 495;    // gemeten voor een A4-pagina in punten
  BoxHeight = 740;
  MaxPages = 500;    // je eigen veiligheidsgrens

procedure RenderLongHTML(Lib: TPDFlib; const Html: WideString);
var
  Rest: WideString;
  Pages: Integer;
begin
  Lib.SetOrigin(1);
  Lib.SetMeasurementUnits(0);
  Rest := Lib.DrawHTMLTextBox(BoxLeft, BoxTop, BoxWidth, BoxHeight, Html);
  Pages := 1;
  while (Rest <> '') and (Pages < MaxPages) do
  begin
    Lib.NewPage;
    Inc(Pages);
    // De rest is al ge-escape HTML: escapet of unescape hem nooit
    Rest := Lib.DrawHTMLTextBox(BoxLeft, BoxTop, BoxWidth, BoxHeight, Rest);
  end;
  if Rest <> '' then
    raise Exception.CreateFmt('Content still left after %d pages', [MaxPages]);
end;
Behandel de rest als opaak. Het is genormaliseerde HTML met stijlen al op elke tag geresolved, dus hem door je eigen escaper halen maakt van elke < een &lt;, en hem decoderen geeft de volgende box levende tags. Verse gebruikerstekst erin plakken heeft dezelfde twee falingmodi. De paginagrens kost één vergelijking: kan een element de box nooit passen, dan heeft een loop zonder grens geen natuurlijk einde
Markdown heeft zijn eigen vervolg. DrawMarkdownTextBox geeft een rest terug die begint met een markeringscomment, die de Markdown-ingangspunten vertelt de conversie bij de volgende aanroep over te slaan. Geef hem terug aan DrawMarkdownTextBox of DrawMarkdownText, op dezelfde manier waarop je LeftOverText teruggeeft aan DrawHTMLTextBox. Een Markdown-rest hoort bij de Markdown-ingangspunten, dus houd hem aan die kant en stuur alleen DrawHTMLTextBox-resten door de HTML-aanroepen
De vorm achter dit alles — parsen, terug in dezelfde syntax schrijven, opnieuw parsen — duikt ook op in template engines, HTML-sanitizers en Markdown-naar-HTML-naar-PDF-ketens, en de faling komt in twee richtingen. Te weinig hercoderen maakt van data syntax. Te veel coderen, of een decoder die twee keer draait, toont entity-spellingen aan de lezer of eet ze op. Eén richting alleen plakken breekt meestal de andere, en daarom behandelt de PDFlibPas-renderer &-decodering, hem als laatste decoderen, geen late decode en opnieuw escapen op elke grens als één pakket. De exportrichting volgt dezelfde regel in PDF naar Markdown- en DOCX-semantische export vanuit Delphi, waar elk letterlijk teken exact één keer voor de doelsyntax wordt ge-escaped
HTML- en Markdown-tekenwerk, de dataset-rapportexporteur en de rest van de lay-outengine komen als native Pascal-source in PDF Library for Delphi, voor zowel Delphi als Free Pascal. Edities, platformdekking en de proefdownload staan op de productpagina van PDF Library for Delphi