Een halve punt bepaalt het. In een rapport met 10-punts brontekst komt een sectietitel in 11-punts vet binnen als gewone alinea in Markdown, terwijl een 12-punts bijschrift op de omslag, in normaal gewicht, terugkomt als ### Quarterly figures. Dat lijkt achterstevoren totdat je bedenkt wat een PDF-pagina werkelijk bewaart: glyphs op coördinaten, een fontnaam en een grootte. Niets op de pagina zegt "kop". Elke kop die een converter uitzendt is een gis gebouwd uit die drie feiten, en de gis heeft drempels
Waarom een PDF-pagina geen alinea's heeft om te exporteren
Een PDF-pagina bevat tekst-tonende operators, geen alinea's. Elke operator zet een run glyphs op een positie, in welke volgorde de producerende toepassing ze ook toevallig uitzond, en ISO 32000-1 legt de producent geen enkele verplichting op om te zeggen dat twee runs bij dezelfde zin horen, laat staan bij hetzelfde lijstitem of dezelfde tabelcel. Het formaat beschrijft een gedrukte pagina exact, en het komt daar door de structuur weg te gooien die de pagina produceerde
Dus elke converter bouwt opnieuw wat de generator wegwierp. Regels komen uit gedeelde baselines en verticale spatiëring. Alineaeinden komen uit veranderingen in spatiëring en inspringing. Een lijst is een reeks blokken die beginnen met een opsommingsteken of een getalpatroon. Een tabel is een raster van tekstblokken waarvan de randen over rijen en kolommen uitlijnen. Op documenten die gewone typografische gewoonten volgen werkt dit goed; op een brochure die op visueel effect is ingedeeld heeft het weinig om vast te houden
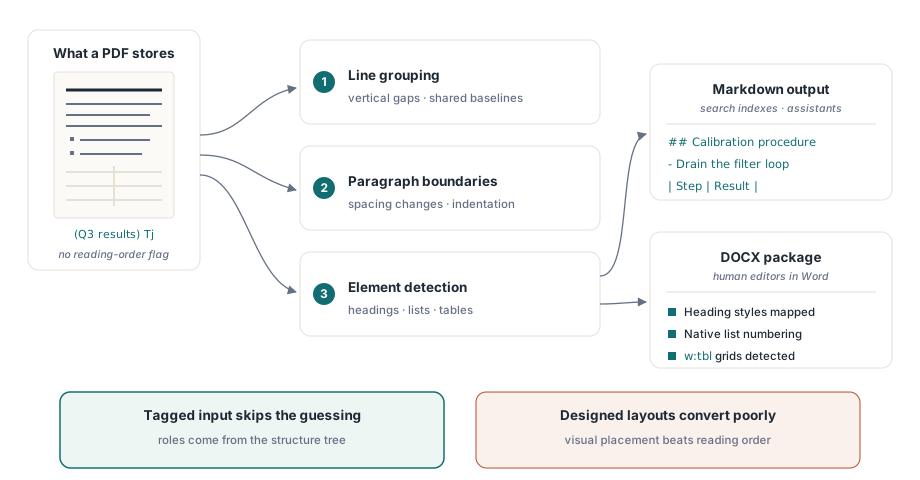
Getagde PDF's zijn de grote uitzondering. Draagt een document een structuurboom, dan worden de alinea-, kop-, lijst- en tabelrollen door de producent vastgelegd in plaats van achteraf gegist, wat de reden is dat het werk uit tagged PDF-toegankelijkheidsstructuur ook in conversiekwaliteit terugverdient. Beheer je de producent zelf, dan is de output taggen het goedkoopste wat je kunt doen voor wie hem later converteert
Waar de kopniveaus vandaan komen
PDF Library for Delphi beslist kopniveaus op twee manieren, afhankelijk van de invoer. Op een getagde pagina houdt een blok waarvan de structuurrol H1 tot H6 is dat niveau, en H of Title wordt niveau 1. Op een ongetagde pagina valt de export terug op fontgrootte ten opzichte van de brontekst van de pagina, en hij beschouwt dan alleen eenregelige alinea's van 200 tekens of minder
De grootteregel heeft zowel een verhouding als een absolute afstand nodig, gemeten tegen de dominante bodygrootte:
| Markdown-uitvoer | Grootste tekst op de regel | Bij een body van 10 pt |
|---|---|---|
# | minstens 1,6 keer de bodygrootte en minstens 4 pt groter | 16 pt en omhoog |
## | minstens 1,35 keer en minstens 2,5 pt groter | 13,5 pt en omhoog |
### | minstens 1,15 keer en minstens 1,25 pt groter | 11,5 pt en omhoog |
Daarmee is het openingsvoorbeeld verklaard. Een 11-punts vette titel bovenop 10-punts tekst mist de derde trede op een halve punt na, en gewicht speelt geen rol bij het niveau. Het omslagbijschrift op 12 punten haalt hem wel. De absolute afstand bestaat voor kleine bodygroottes: op 6-punts voetnoottekst zou een verhouding alleen een regel van 7 punten tot kop promoveren, en de extra eis van 1,25 pt houdt dat tegen
We vinden dit de juiste afweging. Vet is veel te gewoon binnen brontekst (inleidende zinnen, begripstermen, totalen in een samenvattingsregel) om op zichzelf een betrouwbaar kopsignaal te zijn, en een converter die elke vette regel promoveert produceert Markdown met tientallen loosde secties. Een paar koppen die alleen op vet leunen missen kost minder. Leunen jouw documenten op titels in vet op bodygrootte, dan zit de betrouwbare fix stroomopwaarts: tag ze, of zet de titelgrootte anderhalve punt hoger
Vet en cursief in de uitvoer worden uit de fontnaam gelezen. Een run waarvan de fontnaam Bold, Black of Demi bevat wordt **vet**; Italic of Oblique wordt *cursief*. Producenten die fonts subsetten onder opaaknamen als F3, of die vet simuleren door gewone glyphs te overtrekken, geven de export niets te lezen, en die tekst komt ongestyled aan
Markdown-export voor retrieval-pijplijnen
De Markdown-route is degene om te pakken wanneer de bestemming een tekstpijplijn is: een documentatiesite, een zoekindex, een gechunkt corpus voor een assistent. ExportPageMarkdown geeft één pagina terug als WideString, ExportDocumentMarkdown geeft een paginabereik terug, en SaveMarkdownToFile en SaveMarkdownToStream schrijven dezelfde tekst als UTF-8 zonder bytevolgordemarkering. De ontbrekende BOM is opzet; een aantal statische sitegeneratoren en diff-gereedschappen behandelen hem als inhoud
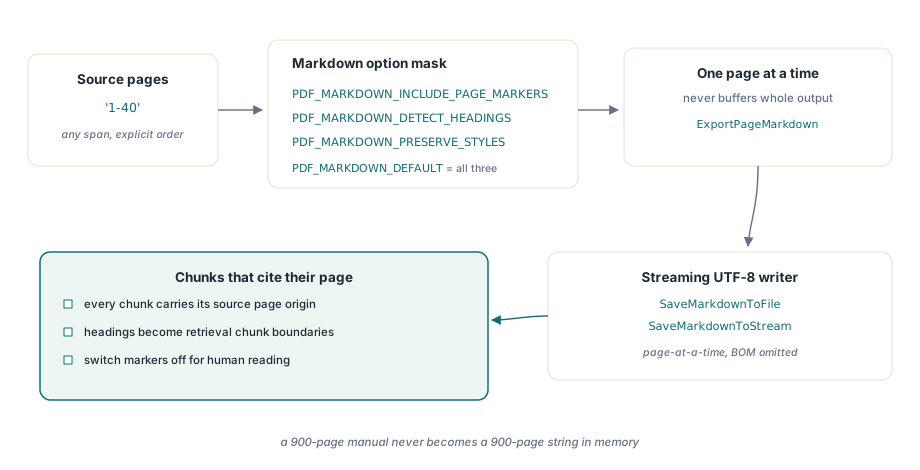
Opties zijn een bitmasker: PDF_MARKDOWN_INCLUDE_PAGE_MARKERS (1), PDF_MARKDOWN_DETECT_HEADINGS (2) en PDF_MARKDOWN_PRESERVE_STYLES (4), met PDF_MARKDOWN_DEFAULT dat alle drie combineert. Een tweede, documentbrede instelling stuurt de analyse zelf: SetStructuredTextOptions neemt de PDF_STRUCTURED_*-vlaggen, en zijn default detecteert kolommen, detecteert doorlopende kop- en voetteksten, en voegt tabellen die een paginagrens overschrijden samen
uses
  SysUtils, PDFlibrary;

var
  Pdf: TPDFlib;
  Exported: Integer;
begin
  Pdf := TPDFlib.Create;
  try
    if Pdf.LoadFromFile('handbook.pdf', '') = 0 then
      raise Exception.Create('Cannot open handbook.pdf');

    // Detectie van doorlopende kop- en voetteksten staat standaard aan;
    // EXCLUDE_FURNITURE toevoegen haalt ze ook uit de uitvoer
    Pdf.SetStructuredTextOptions(PDF_STRUCTURED_ADVANCED_DEFAULT or
      PDF_STRUCTURED_EXCLUDE_FURNITURE);

    // Paginamarkeringen en koppen, maar geen **- en *-nadruk
    Exported := Pdf.SaveMarkdownToFile('1-40',
      PDF_MARKDOWN_INCLUDE_PAGE_MARKERS or PDF_MARKDOWN_DETECT_HEADINGS,
      'handbook.md');
    if Exported = 0 then
      raise Exception.CreateFmt('Markdown export failed, error %d',
        [Pdf.LastErrorCode]);

    // JSON met één invoer per pagina: readingSource is tagged, mixed,
    // geometric of geometric-columns
    Writeln(Pdf.GetLastStructuredTextDiagnostics);
  finally
    Pdf.Free;
  end;
end;
Voor een retrievalcorpus laten wij PDF_MARKDOWN_PRESERVE_STYLES vallen. Nadruk wordt per run toegepast, dus een vette zin die over meerdere runs loopt komt als **Net** **revenue** uit de bus, wat op het scherm prima leest en ruis toevoegt aan elke embedding. Paginamarkeringen zijn het tegenovergestelde geval: houd ze vast. Elke markering is een HTML-comment, <!-- page: 12 -->, onzichtbaar zodra de Markdown wordt gerenderd en makkelijk te parsen wanneer je chunks splitst, zodat een opgehaalde passage de pagina kan citeren waar hij vandaan komt. Loopt een tabel door vanaf de vorige pagina, dan wordt de markering voor de nieuwe pagina weggelaten zodat de pipe-tabel in één stuk blijft
Twee gedragingen vangen mensen die pagina voor pagina in een lus exporteren. Ten eerste worden doorlopende koppen herkend aan herhaling: een alinea in de bovenste of onderste 12 procent van de pagina geldt als meubilair wanneer matchende tekst in dezelfde band op een andere pagina van dezelfde export zit, met genormaliseerde cijfers zodat "Page 3 of 40" matcht met "Page 4 of 40". Een aanroep voor één pagina heeft geen andere pagina om tegen af te zetten, dus een ongetagde doorlopende kop blijft in de tekst. Ten tweede worden afbeeldingen in Markdown inline ingebed als data:-URI's, wat het bestand zelfstandig houdt en betekent dat een pagina met een grote foto honderden kilobytes base64 aan het bestand kan toevoegen. Heeft je chunker een groottelimiet, dan stript u regels die met 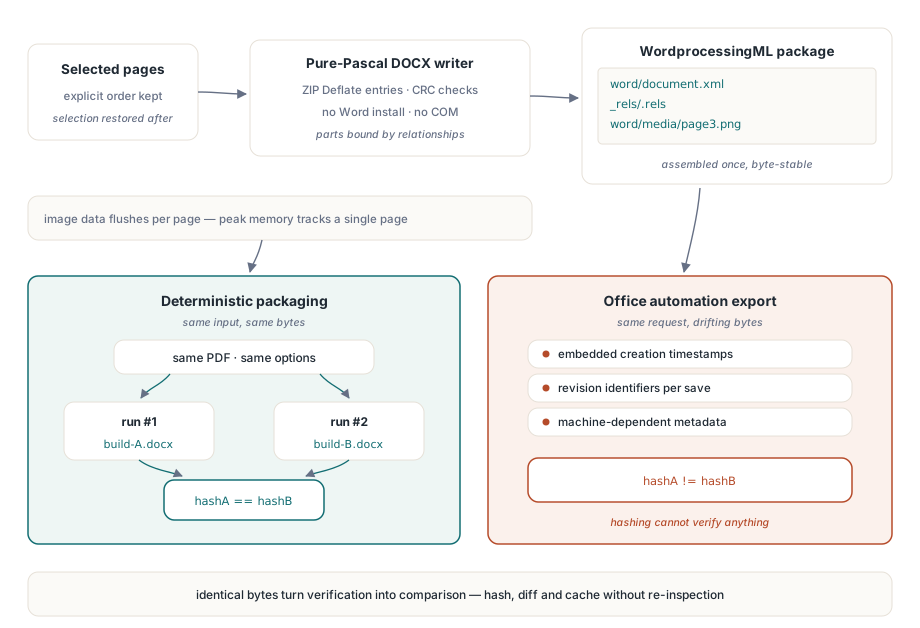
Twee keuzes maken dat mogelijk. Elke ZIP-invoer draagt dezelfde vaste DOS-datum, 1 januari 1980, in plaats van de tijd van de run, en het core properties-onderdeel heeft geen aanmaak- of wijzigingsdatums. Elke invoer wordt alleen met ruwe Deflate gecomprimeerd wanneer dat hem werkelijk kleiner maakt, dus PNG-media, al gecomprimeerd, worden ongecomprimeerd opgeslagen. Het eerste punt bevestig je met unzip -v handbook.docx: elke rij toont dezelfde datum
Office-automatisering kan je dat niet geven. Opslaan via Word stempelt de huidige tijd in de pakketmetadata en de ZIP-headers, dus hetzelfde document twee keer geconverteerd verschilt op manieren die een hash slopen. Dezelfde redenering zit achter de stabiele bestandsidentifiers in deterministische PDF-ID's voor reproduceerbare builds: zodra output reproduceerbaar is wordt verificatie een vergelijking
Welke invoer goed convergeert, en welke nooit
Conversiekwaliteit varieert meer met de invoer dan met de converter, en het loont dat je gebruikers dat vooraf vertelt. Getagde PDF's en netjes gegenereerde zakelijke documenten (facturen, rapporten, contracten) converteren goed: koppen landen als koppen, tabellen overleven het, lijsten hernummeren in Word. Tweekoloms academische indelingen komen in de juiste leesvolgorde door wanneer de kolomgeometrie regelmatig is, en de diagnostiek meldt geometric-columns voor die pagina's. Tabellen die over pagina's heen breken worden door inferentie weer samengevoegd, dus steekproef ze na. Zwaar vormgegeven marketingmateriaal, waarin tekst op effect is geplaatst in plaats van in leesvolgorde, geeft elke converter weinig om terug te halen; reken erop het resultaat met de hand bij te werken
Gescande documenten zijn een apart geval. Een pagina die één grote afbeelding is bevat geen tekstobjecten, dus er is niets te exporteren totdat er een tekstlaag bestaat, en OCR draaien is een vereiste voor beide formaten. Leg je je vast op een grote batch, sample dan een dozijn representatieve bestanden en som op wat hun pagina's bevatten, zoals beschreven in tekstzoeken en pagina-elementen opsommen; een pagina met afbeeldingen en geen textruns vertelt je in een seconde meer dan de geconverteerde uitvoer lezen zal
Kies het formaat op wat er daarna gebeurt. Markdown past bij machines en pijplijnen: koppen worden chunkgrenzen, tabellen blijven leesbaar als pipe-tabellen, en paginamarkeringen geven elke chunk een citatie. DOCX past bij mensen die het document moeten wijzigen, want wat ze terugwillen is een bewerkbaar bestand in Word, met echte lijsten en echte tabellen, en alleen de tekst geeft hen dat niet
PDF Library for Delphi verschijnt voor Delphi, C++Builder en Lazarus, met DLL- en ActiveX-edities die dezelfde Markdown- en DOCX-exportaanroepen blootleggen aan C#, C++ en scripting hosts. De referentie voor elke optievlag en een proefdownload staan op de PDF Library for Delphi-productpagina