첫 최상위 책갈피가 5페이지를 가리키는 40페이지 사용 설명서를 생각해 봅시다. "이 책갈피부터 다음 책갈피까지" 자르는 분할기는 챕터 파일들을 더하면 36페이지가 되게 만듭니다. 표지, 저작권 페이지, 두 페이지짜리 목차가 모든 아웃라인 항목 앞에 앉아 있어서 어느 파일에도 들어가지 못합니다. 아웃라인은 섹션이 어디서 시작하는지만 표시하고, 첫 항목 이전을 커버하지 않으며, 형식은 항목이 페이지 순서대로 나열되기를 전혀 요구하지 않습니다. 그래서 믿을 만한 분할기는 책갈피 페이지를 절단점으로 수집하고, 정렬하고, 명시적인 머리말 범위를 추가합니다
모든 분할 모드 뒤에는 하나의 루프가 있다
PDFium Component는 경계를 정하는 것이 무엇이든 두 번째 TPdf 위에서 같은 네 단계로 문서를 분할합니다. CreateDocument가 메모리에 빈 PDF를 시작하고, ImportPages가 소스에서 페이지 범위를 복사해 넣고, SaveAs가 파일을 기록하고, Active := False가 출력을 다시 닫습니다. 페이지별 분할, 고정 크기 청크, 책갈피 섹션은 ImportPages에 넘기는 범위 문자열만 다릅니다
각 패스 끝의 리셋은 선택 사항이 아닙니다. CreateDocument는 아직 활성인 컴포넌트 위에서는 실행을 거부하고 메시지가 "Cannot perform this operation on an active"로 시작하는 EPdfError를 일으킵니다. 그래서 Active := False를 잊은 루프의 두 번째 반복은 정확히 하나의 파일이 기록된 뒤 예외로 멈춥니다. 리셋을 finally 블록에 두면 실패한 임포트나 저장이 다음 패스를 위해 출력을 열어 둔 채 남기는 일이 없습니다. 하나의 TPdf 인스턴스가 실행 전체를 맡고, 메모리에 들려지는 출력 문서는 언제나 하나뿐입니다
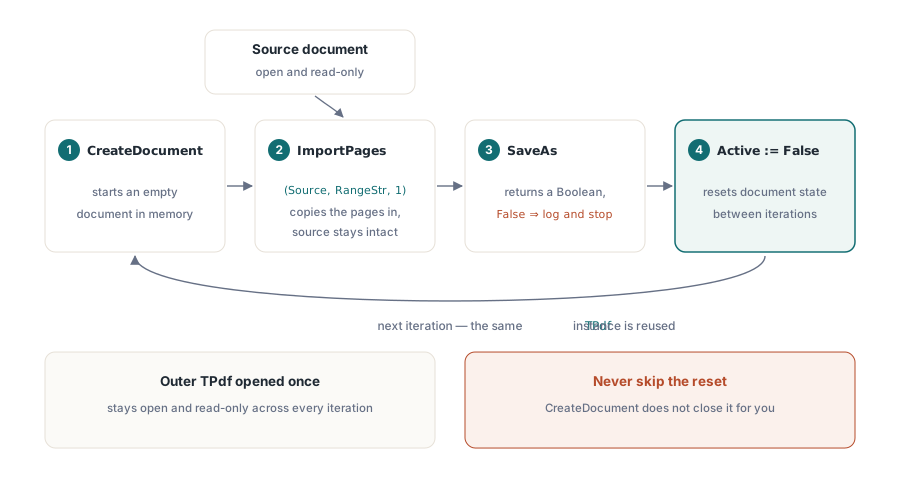
소스 열기에는 자체 점검이 필요합니다. Active := True 대입은 결코 일으키지 않습니다. 파일이 없거나 손상되었거나 제공되지 않은 암호를 필요로 할 때, TPdf는 로드 오류를 잡아 Active를 False로 남깁니다. ImportPages도 소스를 스스로 활성화하려 하므로, 열리지 않은 소스는 첫 페이지에서 False 반환으로만 나타나고 원인에 대한 힌트는 없습니다. 명시적으로 열고 Active를 검사하면 그것이 출력이 존재하기 전에 파일 이름을 밝히는 오류가 됩니다:
procedure SplitIntoPages(const SourceFile, OutputDir: string);
var
  Source, PdfOut: TPdf;
  I: Integer;
  OutFile: string;
begin
  Source := TPdf.Create(nil);
  PdfOut := TPdf.Create(nil);
  try
    Source.FileName := SourceFile;
    Source.Active := True;               // 로드 실패는 Active = False로 남깁니다
    if not Source.Active then
      raise Exception.Create('Cannot open ' + SourceFile);

    for I := 1 to Source.PageCount do
    begin
      PdfOut.CreateDocument;             // PdfOut이 아직 활성인 동안은 일으킵니다
      try
        // Range는 1 기반; 위치 1은 빈 문서의 시작입니다
        if not PdfOut.ImportPages(Source, IntToStr(I), 1) then
          raise Exception.CreateFmt('Cannot import page %d', [I]);
        OutFile := IncludeTrailingPathDelimiter(OutputDir) +
          Format('page_%.4d.pdf', [I]);
        if not PdfOut.SaveAs(OutFile) then
          raise Exception.Create('Cannot save ' + OutFile);
      finally
        PdfOut.Active := False;          // 다음 패스 전에 출력을 닫습니다
      end;
    end;
  finally
    PdfOut.Free;
    Source.Free;
  end;
end;ImportPages의 세 번째 인자는 첫 임포트 페이지가 앉을 대상 문서의 1 기반 위치입니다. 빈 문서에서는 1이 유일한 위치입니다. 범위 문법 자체(단일 페이지, '5-10' 같은 닫힌 구간, 쉼표 목록)와 병합 번들을 뒤집는 위치 실수는 여러 PDF 파일을 하나의 문서로 병합하기에서 다루는데, 같은 API를 반대 방향으로 쓰는 것입니다
고정 크기 청크와 호출자 제공 범위
문서를 N페이지마다 자르는 것은 세기 문제이며, 주의가 필요한 경우는 꼬리 하나뿐입니다. 230페이지 스캔을 25페이지 부분으로 나누면 완전한 아홉 부분과 5페이지의 열 번째 부분이 나오므로, 각 구간의 끝은 Source.PageCount로 갑힙니다:
procedure SplitEvery(Source: TPdf; ChunkSize: Integer; const OutputDir: string);
var
  PdfOut: TPdf;
  FirstPage, LastPage, Part: Integer;
  Range, OutFile: string;
begin
  if ChunkSize < 1 then
    raise Exception.Create('ChunkSize must be at least 1');
  PdfOut := TPdf.Create(nil);
  try
    Part := 0;
    FirstPage := 1;
    while FirstPage <= Source.PageCount do
    begin
      LastPage := FirstPage + ChunkSize - 1;
      if LastPage > Source.PageCount then
        LastPage := Source.PageCount;    // 마지막 부분은 보통 더 짧습니다
      if FirstPage = LastPage then
        Range := IntToStr(FirstPage)     // 한 페이지짜리 꼬리는 그냥 숫자로
      else
        Range := Format('%d-%d', [FirstPage, LastPage]);
      Inc(Part);

      PdfOut.CreateDocument;
      try
        if not PdfOut.ImportPages(Source, Range, 1) then
          raise Exception.Create('Cannot import pages ' + Range);
        OutFile := IncludeTrailingPathDelimiter(OutputDir) +
          Format('part_%.3d.pdf', [Part]);
        if not PdfOut.SaveAs(OutFile) then
          raise Exception.Create('Cannot save ' + OutFile);
      finally
        PdfOut.Active := False;
      end;
      FirstPage := LastPage + 1;
    end;
  finally
    PdfOut.Free;
  end;
end;
사용자가 입력한 범위는 다른 문제입니다. ImportPages는 나쁜 범위를 반환값으로 보고합니다. Source.PageCount를 넘는 페이지 번호, 0, 뒤집힌 구간, 파싱되지 않는 텍스트는 호출을 False로 만들고 그 문자열의 어느 페이지도 복사되지 않습니다. 루프 안에서는 그 실패가 세 개의 섹션 파일이 이미 디스크에 놓인 뒤 네 번째 항목에서 도착합니다. 첫 CreateDocument 전에 모든 항목을 Source.PageCount와 대조하는 데는 파싱 몇 줄이 들고, 네 번째 항목의 오타가 아무것도 쓰지 않게 만드는데, 작업을 다시 돌리는 사람이 기대하는 동작이 바로 그것입니다
선택이 이미 정수 배열에 있을 때, 예컨대 썸네일 뷰에서 고른 페이지라면, ImportPagesByIndex(Source, PageIndices, InsertAt)가 문자열 단계를 건너뜁니다. 인덱스와 InsertAt 모두 0 기반이므로 범위로는 '1,3-5'로 읽히는 같은 선택이 [0, 2, 3, 4]가 됩니다
책갈피 섹션은 왜 짧게 나오거나 사라지는가
책갈피 섹션은 코드가 아웃라인이 반듯하다고 믿을 때 잘못됩니다. TPdf.Bookmarks는 저자가 배열한 순서의 최상위 항목을 돌려주며, 각각은 Title과 1 기반 PageNumber를 지닌 TBookmark 레코드입니다. 실제 파일에는 "이 항목부터 다음 항목까지" 규칙을 깨는 것이 네 가지 있습니다:
- 아웃라인 항목은 대상을
/Dest항목이나/A의 GoTo 액션으로 실을 수 있습니다(ISO 32000-1 §12.3.3과 §12.6.4.2).PageNumber는/Dest에서 채워지고, 액션 기반 항목은0으로 남으며 페이지는ActionPageNumber에 있습니다 - 아웃라인 순서는 저자가 본 읽기 순서입니다. 두 번째 자리에 놓인 "색인" 항목이나 챕터 앞에 나열된 부록은 "다음 책갈피 빼기 1"을 현재 시작보다 작게 만들고, 그 섹션은 사라집니다
- 최상위 항목 둘이 같은 페이지를 가리킬 수 있습니다. 보통 부 제목과 그 첫 챕터입니다
- 페이지를 아웃라인을 건드리지 않은 도구로 삭제한 경우 항목이 마지막 페이지를 넘어 가리킬 수 있습니다
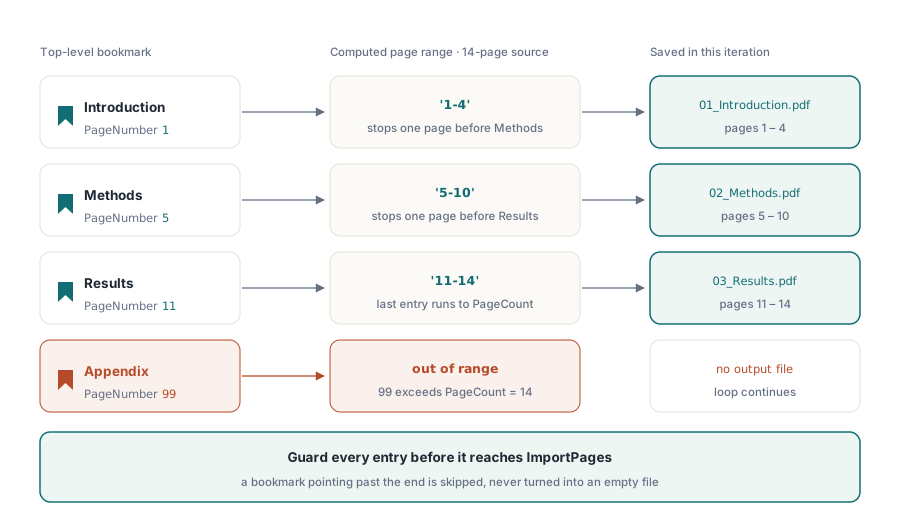
아래 버전은 아웃라인을 절단점의 원천으로 취급합니다. 각 항목의 페이지를 해석하고, 어디도 가리키지 않거나 끝을 넘는 항목은 버리고, 공유 페이지의 첫 제목을 유지하고, 페이지 번호로 정렬하고, 첫 절단이 1페이지 뒤일 때 "머리말" 섹션을 추가합니다. 머리말이 여기서는 챕터 1에 붙는 대신 자기 파일을 받는데, 챕터 1을 받는 사람은 목차가 아니라 책갈피가 이름 지은 페이지에서 열리기를 기대하기 때문입니다
procedure SplitByBookmarks(Source: TPdf; const OutputDir: string);
var
  Bm: TBookmarks;
  Starts: array of Integer;
  Titles: array of string;
  I, J, K, N, P, EndPage: Integer;
  Known: Boolean;
  PdfOut: TPdf;
  OutFile: string;
begin
  Bm := Source.Bookmarks;                // 최상위 항목만
  if Length(Bm) = 0 then
    Exit;                                // 잘를 기준이 없음
  SetLength(Starts, Length(Bm) + 1);     // +1은 머리말을 위한 자리
  SetLength(Titles, Length(Bm) + 1);
  N := 0;
  for I := 0 to High(Bm) do
  begin
    P := Bm[I].PageNumber;               // /Dest에서 해석됨
    if P < 1 then
      P := Bm[I].ActionPageNumber;       // /A의 GoTo 액션에서 해석됨
    if (P < 1) or (P > Source.PageCount) then
      Continue;                          // 해석 안 됨, 또는 마지막 페이지를 넘음
    Known := False;
    for J := 0 to N - 1 do
      if Starts[J] = P then
        Known := True;                   // 한 페이지의 첫 제목이 이깁니다
    if Known then
      Continue;
    J := N;                              // 페이지 번호로 삽입 정렬
    while (J > 0) and (Starts[J - 1] > P) do
    begin
      Starts[J] := Starts[J - 1];
      Titles[J] := Titles[J - 1];
      Dec(J);
    end;
    Starts[J] := P;
    Titles[J] := Bm[I].Title;
    Inc(N);
  end;
  if N = 0 then
    Exit;
  if Starts[0] > 1 then                  // 표지, 목차와 그 앞의 모든 것
  begin
    for J := N downto 1 do
    begin
      Starts[J] := Starts[J - 1];
      Titles[J] := Titles[J - 1];
    end;
    Starts[0] := 1;
    Titles[0] := 'Front matter';
    Inc(N);
  end;

  PdfOut := TPdf.Create(nil);
  try
    for K := 0 to N - 1 do
    begin
      if K < N - 1 then
        EndPage := Starts[K + 1] - 1
      else
        EndPage := Source.PageCount;
      PdfOut.CreateDocument;
      try
        if not PdfOut.ImportPages(Source,
          Format('%d-%d', [Starts[K], EndPage]), 1) then
          raise Exception.CreateFmt('Cannot import pages %d-%d',
            [Starts[K], EndPage]);
        // SafeFileName은(아래에서 보임) 이 루틴 전에 선언하세요
        OutFile := IncludeTrailingPathDelimiter(OutputDir) +
          Format('%.2d_%s.pdf', [K + 1, SafeFileName(Titles[K])]);
        if not PdfOut.SaveAs(OutFile) then
          raise Exception.Create('Cannot save ' + OutFile);
      finally
        PdfOut.Active := False;
      end;
    end;
  finally
    PdfOut.Free;
  end;
end;
정렬 뒤에는 시작이 엄격히 증가하므로, 계산된 모든 구간은 유효하고 읽을 수 있는 소스에서는 ImportPages의 가드가 발화할 이유가 없습니다. 책갈피가 없는 문서는 이 모드에서 그저 파일을 만들지 않으며, 청크로 폴백할지는 호출자가 결정합니다. 한 레벨 더 깊이, 예컨대 부 안의 챕터에서 자르려면 BookmarkChildren[Bm[I]]이 최상위 항목의 자식들을 같은 TBookmarks 형태로 돌려주고, 같은 절단점 논리가 합쳐진 목록에 적용됩니다
각 출력 파일이 실어 나르는 것
각 출력 파일은 페이지들 자체와 페이지 딕셔너리가 참조하는 모든 것을 실어 나릅니다. 콘텐츠 스트림, 폰트, 이미지, 각 페이지의 주석 목록입니다. 폼 위젯은 주석으로 따라오지만, 새 파일에는 AcroForm이 없으므로 더 이상 동작하는 필드가 아닙니다. 소스는 읽히기만 합니다. ImportPages는 오브젝트를 새 문서로 복사하고 열려 있는 소스를 건드리지 않으므로, 같은 Source 인스턴스가 모든 반복을 먹입니다
아웃라인은 뒤에 남습니다. 책갈피는 문서 카탈로그의 /Outlines(ISO 32000-1 §7.7.2) 아래, 어느 페이지 밖에 살므로, 임포트된 페이지로 만든 파일은 책갈피 없이 시작합니다. 챕터 파일에는 대개 그것으로 충분합니다. 각 부분에 자기 내비게이션이 필요하면 아웃라인을 새 페이지 번호에 맞춰 만들어야 하는데, 그것이 PDF 아웃라인 편집과 페이지 리매핑의 주제입니다. 내부 링크도 같은 방식입니다. 12페이지의 "7장 참조" 링크는 다른 파일로 들어간 페이지를 가리키고, 이 파일에서는 앉을 곳이 없습니다
암호화된 소스에는 루프가 시작하기 전에 암호가 필요합니다. 컴포넌트가 비활성인 동안 Source.Password를 대입한 뒤 Active := True를 설정하세요. 암호가 틀리면 컴포넌트는 비활성으로 남고, SplitIntoPages의 점검이 그것을 오류로 바꿉니다. SaveAs가 쓰는 출력은 암호화 딕셔너리 없는 새 문서입니다. 서로 다른 수신자에게 갈 분할 파일에는 그것이 맞고, 각 부분이 다시 보호되어야 할 때는 SaveAsEncrypted(FileName, Options)가 자체 사용자 및 소유자 암호를 지닌 TPdfEncryptOptions 레코드를 받습니다
파일 이름, 실패한 저장과 재실행
책갈피 제목은 PDF 텍스트 문자열이라 무엇이든 담을 수 있는데, Windows가 파일 이름에서 거부하는 문자도 포함됩니다. 규칙은 PDF가 아니라 파일 시스템에서 옵니다. < > : " / \ | ? *와 제어 문자는 유효하지 않고, 뒤따르는 공백과 점은 Win32 파일 API가 떼어 버리며, CON, PRN, COM1 같은 이름은 예약된 장치입니다. SplitByBookmarks의 번호 접두사가 이미 장치 이름을 처리하고, 디렉터리 목록에서 파일을 읽기 순서로 유지하며, 둘 다 "Summary"라는 제목인 두 챕터가 서로를 덮어쓰는 일을 막습니다. 나머지는 직접 쓰는 작은 함수입니다:
// 리더 쪽 헬퍼, PDFium Component 일부가 아닙니다
function SafeFileName(const Title: string): string;
const
  Forbidden = '<>:"/\|?*';
var
  I: Integer;
begin
  Result := Title;
  if Length(Result) > 80 then
    SetLength(Result, 80);               // 전체 경로를 MAX_PATH 안에 잘 머물게 합니다
  for I := 1 to Length(Result) do
    if (Ord(Result[I]) < 32) or (Pos(Result[I], Forbidden) > 0) then
      Result[I] := '_';
  while (Result <> '') and
    ((Result[Length(Result)] = '.') or (Result[Length(Result)] = ' ')) do
    SetLength(Result, Length(Result) - 1);
  if Result = '' then
    Result := 'section';
end;
파일 이름을 받는 SaveAs는 대상 폴더의 임시 파일에 기록하고 저장이 성공한 뒤에만 제자리로 바꿔치기합니다. 따라서 대상은 이전 파일이거나 완전한 새 파일이며 절반 쓰인 상태는 없으므로, 기존 출력 폴더 위에서 분할을 다시 돌리는 것은 무해합니다. 실패는 두 가지 길로 돌아옵니다. 문서를 직렬화할 수 없으면 SaveAs가 False를 돌리고 임시 파일은 제거됩니다. 존재하지 않는 출력 폴더, OS가 거부하는 경로, 뷰어가 잠근 대상 같은 파일 시스템 문제는 파일 계층에서 예외를 일으킵니다
배치가 그 실패들에 반응하는 방식은 선택이며, 분할에서는 병합과 다릅니다. 부분이 빠진 병합 번들은 잘못된 문서이므로 거기서는 멈추는 것이 옳습니다. 분할 출력은 서로 독립적입니다. 동료가 section_147.pdf를 열어 둔 탓에 그 파일을 못 써도 나머지 섹션들은 여전히 옳습니다. 분할 작업에서는 루프 안에서 파일별 예외를 잡고, 파일 이름과 메시지를 기록하고, 계속 가서, 루프가 끝났을 때 쓰인 파일 수를 계획된 범위 수와 비교하세요. 위의 예제들은 짧게 유지하려고 첫 실패에서 일으키는 것일 뿐입니다. 200개 중 199개가 쓰였다고 말하고 잠긴 하나의 이름을 대는 로그는 재실행 한 번으로 해결되지만, 147에서 중단된 실행은 53개 중 무엇이 빠졌는지 누군가 머리로 풀게 만듭니다
여기서 쓴 분할 루프, 책갈피 레코드, 암호화 저장은 Delphi와 C++Builder용 PDFium 기반 PDF 라이브러리인 PDFium Component와 함께 제공됩니다