호출할 때마다 삽입 위치로 1을 넘기는 병합 루프는 페이지 수는 맞고 문서 순서가 거꾸로인 파일을 만들어 낸다. 목록의 마지막 파일이 1페이지에 앉는다. 위치 1은 "현재 첫 페이지 앞에 삽입"을 뜻하고 새 소스가 들어올 때마다 앞선 것들이 더 뒤로 밀리기 때문이다. 아무것도 잃지 않는다. 그래서 이 실수는 페이지 수 검사를 통과하고, 누군가 실제로 번들을 읽을 때야 비로소 드러난다
ImportPages로 페이지마다 돌리는 루프
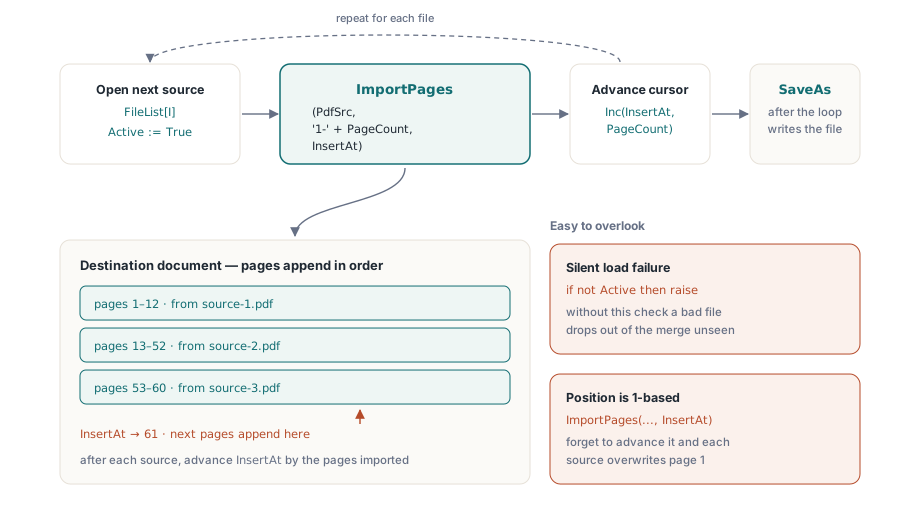
PDFium Component는 Delphi에서 두 개의 TPdf 인스턴스로 병합 PDF를 만든다. CreateDocument로 빈 채 만들어진 목적지 하나와, 입력 파일을 차례로 여는 소스 하나다. TPdf.ImportPages(Pdf, Range, PageNumber)는 Range가 가리키는 페이지들을 Pdf에서 목적지로 복사하고 성공 시 True를 반환한다. PageNumber는 1 기반이고 기본값은 1이다. 첫 임포트 페이지가 떨어질 목적지 위치를 지명하므로 1은 맨 앞에 넣고 PageCount + 1은 맨 뒤에 덧붙인다
파일을 목록 순서로 유지하는 가장 깨끗한 방법은 커서 추적을 아예 접고 목적지에게 끝이 어디인지 묻는 것이다. 흘러가는 InsertAt 카운터도 되긴 한다. 하지만 실제 임포트된 페이지 수만큼 진행해야 하고, 범위가 개입하는 순간 그 수는 틀리기 쉽다. PdfDest.PageCount + 1은 항상 옳다:
procedure MergeFileList(const FileList: TStrings; const OutputPath: string);
var
  PdfDest, PdfSrc: TPdf;
  I: Integer;
begin
  PdfDest := TPdf.Create(nil);
  PdfSrc  := TPdf.Create(nil);
  try
    PdfDest.CreateDocument;
    for I := 0 to FileList.Count - 1 do
    begin
      PdfSrc.FileName := FileList[I];
      PdfSrc.Active   := True;            // 실패 시 예외를 던지지 않는다
      if not PdfSrc.Active then
        raise Exception.CreateFmt('Cannot open %s', [FileList[I]]);

      // 1 기반 위치: PageCount + 1은 마지막 페이지 뒤에 덧붙인다
      if not PdfDest.ImportPages(PdfSrc,
        '1-' + IntToStr(PdfSrc.PageCount), PdfDest.PageCount + 1) then
        raise Exception.CreateFmt('Page import failed for %s', [FileList[I]]);

      PdfSrc.Active := False;             // FileName은 비활성 상태에서만 바뀔 수 있다
    end;

    if not PdfDest.SaveAs(OutputPath) then
      raise Exception.Create('Cannot write ' + OutputPath);
  finally
    PdfSrc.Free;
    PdfDest.Free;
  end;
end;
이 루프의 두 검사가 실질적인 무게를 진다. Active := True 설정은 절대 예외를 던지지 않는다. 파일이 없거나 깨졌거나 암호를 필요로 하면 TPdf가 로드 오류를 받아 내고 Active를 False에 둔다. 컴포넌트는 일관된 닫힌 상태를 유지하고 나쁜 파일 때문에 폼이 크래시하지 않는다. 다만 그 검사를 건너뛰는 병합 루프는 그저 더 짧은 출력을 만들어 낼 뿐이다. 두 번째 검사는 ImportPages의 불리언 결과다. 범위 문자열이 파싱되지 않으면 False가 돌아오고, 위치가 PageCount + 1을 넘어도 마찬가지다. FileName과 Password는 컴포넌트가 비활성일 때만 할당할 수 있다는 점도 유념하라. 각 패스의 끝에서 소스를 닫는 이유다
범위 문자열: 파서가 받아들이는 것
범위 인수는 쉼표로 구분된 단일 페이지와 닫힌 스팬의 목록이며 소스 문서에서 1부터 매겨진다. '1-3'은 처음 세 페이지를, '2,4,6'은 지정한 세 페이지를, '1,3-5'는 표지와 세 페이지짜리 요약을 가져온다. 숫자는 언제나 소스를 가리킨다. 그 페이지들이 목적지의 어디에 떨어지는지는 위치 인수만이 결정한다
끝이 열린 스팬이 사람들을 넘어뜨린다. '7-' 같은 문자열은 "7페이지부터 끝까지"처럼 보이지만 PDFium 범위 파서는 스팬의 양 끝을 요구하며 문자열 전체를 거부한다. 뒤집힌 스팬('5-3'), 0페이지, 소스 페이지 수를 넘는 페이지도 마찬가지다. 나쁜 항목 하나가 호출 전체를 실패시킨다. ImportPages는 False를 반환하고 그 문자열의 페이지는 하나도 복사되지 않는다. 위 루프가 '1-' + IntToStr(PdfSrc.PageCount)를 만드는 이유다. '1-'을 그대로 쓰지 않기 위해서다
페이지 인덱스를 이미 배열로 들고 있다면 ImportPagesByIndex(Source, PageIndices, InsertAt)가 문자열 단계를 건너뛴다. 다만 관례가 바뀐 것을 주의하라. 인덱스와 InsertAt 둘 다 거기서는 0 기반이므로 덧붙이기는 InsertAt = PdfDest.PageCount가 되고 표지 더하기 요약 선택은 [0, 2, 3, 4]가 된다. 빈 배열을 넘기면 모든 페이지를 임포트한다
파일 목록을 한 번의 호출로 병합할 수는 없을까?
있다. TPdf.MergeFiles(Sources, Options, Report)는 TPdfBatchMergeSource 레코드 배열을 받는다. 각 레코드는 TPdfBatchMergeSource.FromFile(FileName, PageRange, Password)로 만들고, 하나씩 열며, 무슨 일이 있었는지 TPdfBatchMergeReport를 채운다. 빈 PageRange는 모든 페이지를 뜻한다. 범위 구문은 같은 쉼표와 스팬 형식이고, 기형 범위는 조용히 건너뛰는 대신 보고서의 파일별 오류가 된다
TPdfBatchMergeOptions.Default의 기본값들은 하나를 바꾸기 전에 알아 둘 만하다. CreateDestination은 True라서 비활성 목적지가 대신 만들어진다. InsertAt는 -1로, 덧붙이기를 뜻한다. 다른 값은 0 기반 인덱스로, ImportPagesByIndex와 맞는 값이지 ImportPages와 맞는 게 아니다. ErrorPolicy는 bmepStop이고 RollbackOnCancelOrFailure는 True라서, 읽을 수 없는 파일 하나가 실행을 끝내고 그 실행이 추가했던 모든 페이지를 걷어 낸다. CopyViewerPreferences는 성공적으로 임포트된 첫 소스의 뷰어 환경설정을 복사한다
procedure BuildBundle(const OutputPath: string; Log: TStrings);
var
  Dest: TPdf;
  Sources: TPdfBatchMergeSources;
  Options: TPdfBatchMergeOptions;
  Report: TPdfBatchMergeReport;
  I: Integer;
begin
  SetLength(Sources, 3);
  Sources[0] := TPdfBatchMergeSource.FromFile('cover.pdf');
  Sources[1] := TPdfBatchMergeSource.FromFile('annual-report.pdf', '1,3-5');
  Sources[2] := TPdfBatchMergeSource.FromFile('appendix.pdf', '', 'user-password');

  Options := TPdfBatchMergeOptions.Default;
  Options.ErrorPolicy := bmepSkip;        // 읽을 수 없는 파일을 지나 계속 간다

  Dest := TPdf.Create(nil);               // 비활성: MergeFiles가 만들어 준다
  try
    if not Dest.MergeFiles(Sources, Options, Report) then
      raise Exception.Create('Merge failed: ' + Report.ErrorMessage);

    for I := 0 to High(Report.Issues) do
      Log.Add(Format('%s: %s',
        [Report.Issues[I].FileName, Report.Issues[I].MessageText]));
    Log.Add(Format('%d pages from %d of %d files',
      [Report.ImportedPageCount, Report.ImportedSourceCount, Report.SourceCount]));

    Dest.SaveAs(OutputPath);
  finally
    Dest.Free;
  end;
end;
어느 오류 정책을 쓸지는 빠진 파일이 출력에 무슨 의미인지에 달려 있다. 계약서 꾸러미나 송장 실행에서 부품 하나가 빠진 번들은 잘못된 문서다. 기본값인 bmepStop과 롤백을 유지하라. bmepSkip으로 갈아타는 것은 주간 리포트 요약 같은 노력 기반 모음에 한해서고, 그때 bmrsCompletedWithErrors를 Report.Status에서 사람이 반드시 봐야 할 것으로 취급하라. 무엇을 택하든 Report.Issues를 읽어라. 항목마다 소스 인덱스와 파일 이름, 메시지가 담겨 있다. 손으로 짠 루프가 자기 예외로 답해야 했던 "범인은 어느 파일이었나"라는 질문에 대한 답이다
긴 실행에서는 두 옵션이 더 중요하다. OnProgress와 CancellationToken은 UI가 현재 파일을 보여 주고 실행을 멈출 수 있게 하며, 취소된 실행은 실패한 실행처럼 롤백된다. ResourcePolicy의 기본값은 bmrpSourceScoped로, 소스별 선택 페이지를 네이티브 호출 한 번에 임포트하므로 그 페이지들이 공유하는 폰트와 이미지는 한 번만 복사된다. bmrpChunked는 PageChunkSize 페이지 배치로 임포트한다. 공유 자원이 배치마다 다시 복사되는 대가로 더 촘촘한 취소 지점을 얻는다
임포트된 페이지가 가지고 오는 것, 소스에 남는 것
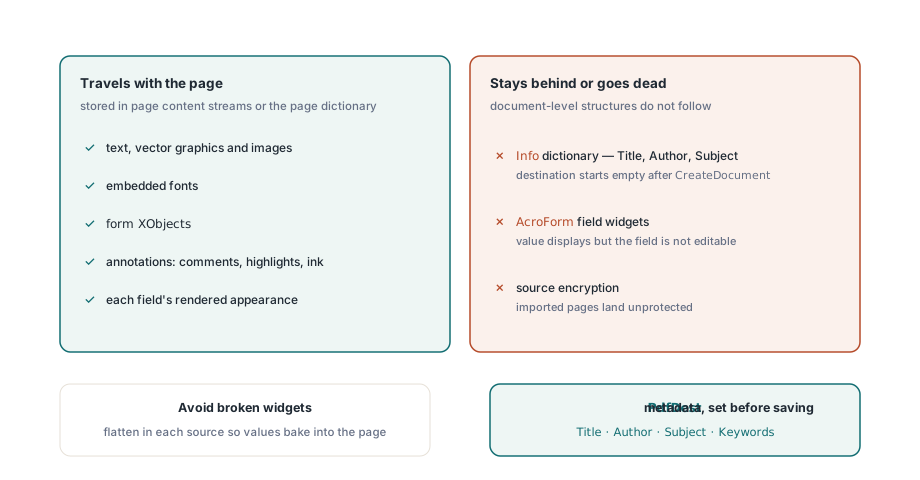
임포트된 페이지는 페이지 딕셔너리에서 닿을 수 있는 모든 것을 가지고 온다. 콘텐츠 스트림, 리소스 안의 폰트와 이미지, 폼 XObject, 그리고 코멘트와 하이라이트, 잉크를 포함한 주석이 그 대상이다. 소스에서 문서 수준에 사는 것은 따라오지 않는다. ISO 32000-1이 그것을 페이지 트리 바깥에 두기 때문이다
- 문서 정보 딕셔너리(ISO 32000-1 §14.3.3)는 뒤에 남는다. 병합 파일에는 소스들의 Title, Author, Keywords가 하나도 없다.
Title과Author속성은TPdf에서 읽기 전용이라 닫기 전에 각 소스가 선언한 것을 로그로 남기기에 딱 좋다 - 아웃라인(§12.3.3)은 기본
OutlinePolicy인bmopDiscard아래에서 버려진다.bmopReject는 아웃라인이 있는 소스를 파일별 오류로 돌린다. 북마크를 살려야 한다면FPdfMerge유닛이MergeFilesWithNavigation을 제공한다. 아웃라인을 재구축하고, 부딪치는 명명된 목적지를 기본값으로Imported_접두어를 붙여 이름을 바꾸고, 페이지 사이 링크를 재사상한다. 아웃라인 편집과 페이지 재사상 문서가 그 목적지들이 어떻게 다시 쓰이는지 다룬다 - 암호화(§7.6)는 소스 파일의 것이다. 보호된 소스는 자기
Password로 열리지만,CreateDocument가 만든 목적지는 암호화되지 않았고 거기로 복사된 페이지들도 마찬가지다. 병합 파일을 보호해야 한다면SaveAsEncrypted를SaveAs대신 써라
병합 뒤 폼 필드가 왜 동작을 멈추는가?
폼 필드는 PDF의 두 수준에 갈라져 있다. 텍스트 상자를 그리는 위젯 주석은 페이지 위에 앉고, 필드 그 자체는 이름과 값을 갖고 카탈로그의 대화형 폼 딕셔너리(ISO 32000-1 §12.7.2)의 /Fields 배열에 등록된다. 네이티브 페이지 임포트는 위젯을 다른 페이지 주석과 함께 복사하지만, 그것을 목적지의 필드 트리에 넣어 주는 것은 아무것도 없다. 상자는 마지막 모습을 여전히 그린다. 그러나 /AcroForm에서 폼 모델을 만드는 뷰어에게는 위젯을 붙일 필드가 없어서 값을 편집할 수 없고, 필드 트리를 걷는 어떤 폼 작업도 그것을 건너뛴다
TPdfBatchMergeOptions.FormPolicy는 평범한 병합에 세 가지 답을 준다. 기본값인 bmfpPreserveNative는 위에서 말한 네이티브 임포트 결과를 유지한다. bmfpFlatten은 appearance를 생성하고 폼을 가진 소스 각각의 선택 페이지를 임포트 전에 메모리에서 평면화하므로 값은 평범한 페이지 콘텐츠가 된다. 디스크의 소스 파일은 수정되지 않는다. bmfpReject는 AcroForm이나 XFA 폼을 가진 소스를 파일별 오류로 돌린다
필드가 채울 수 있는 상태로 남아야 한다면 MergeFilesWithForms를 써라. FPdfFormMerge 유닛의 것이다. 페이지 콘텐츠를 임포트하고, 각 소스의 필드 트리에서 위젯을 재구축하며, 그 필드들을 목적지 폼에 접붙인다. 필드 이름이 어려운 부분이다. §12.7.3.2 아래에서 같은 완전 수식 이름을 가진 두 필드는 같은 필드이고 하나의 값을 공유하므로, 송장의 Total 필드와 배달증의 Total 필드는 서로를 덮어쓴다. 기본 CollisionPolicy는 pagcpReject로, 첫 부딪힘에서 병합을 멈춘다:
uses
  PDFium, FPdfCompress, FPdfFormMerge;

procedure MergeFillableForms(Dest: TPdf;
  const Sources: TPdfBatchMergeSources; Log: TStrings);
var
  Options: TPdfFormMergeOptions;
  Report: TPdfFormMergeReport;
begin
  Options := TPdfFormMergeOptions.Default;
  // 부딪치는 이름은 RenamePrefix를 받는다(바꾸지 않으면 'Imported_')
  Options.GraftOptions.CollisionPolicy := pagcpRename;

  if Dest.MergeFilesWithForms(Sources, Options, Report) then
    Log.Add(Format('%d fields grafted, %d renamed',
      [Report.GraftedFieldCount, Report.RenamedFieldCount]))
  else
    Log.Add('Form merge failed: ' + Report.ErrorMessage);
end;pagcpNamespace는 대신 각 소스의 필드를 자기 접두어(Imported에 소스 번호를 더한 것) 아래에 놓고, pagcpMergeCompatible은 타입과 옵션이 일치할 때만 같은 이름의 필드를 합친다. MergeFilesWithForms는 서명 필드가 없는 AcroForm 소스와 목적지에서 동작한다. XFA 폼과 서명된 파일은 그저 거부한다. 서명된 파일을 다시 쓰면 ISO 32000-1 §12.8.1이 기술하는 서명 바이트 범위가 무효화되기 때문이다. 열려 있는 목적지는 암호화되지 않아야 하기도 하다. 암호로 보호된 파일로의 병합은 실패하므로, 보호는 그 뒤에 SaveAsEncrypted로 추가하라. 한 소스에서 '1,1'처럼 한 페이지를 두 번 선택한 경우에는 명시적인 RepeatedPagePolicy가 필요하다
목적지 문서는 준비된 결과를 다시 열어 검사한 뒤에야 교체된다. 필드 이름과 값, 타입이 페이지별로 비교되고, 실패한 폼 병합은 Dest를 원래대로 둔다. 충돌 처리의 깊은 이야기는 AcroForm 접붙이기 문서에 있다
병합된 문서 저장하기
SaveAs에는 파일 오버로드와 TStream 오버로드가 있고, 둘 다 선택적인 TSaveOption(기본값 saNone)과 TPdfVersion(기본값 pvUnknown으로, 헤더를 라이브러리에 맡긴다)을 받는다. 둘 다 불리언을 반환하며 배치 작업에서 그 결과는 Active와 똑같은 검사를 받을 자격이 있다. 버전을 pv17 같은 것으로 고정하는 것은 하류 시스템이 특정 헤더를 고집할 때뿐이다
거꾸로의 작업, 곧 하나의 파일을 여러 개로 자르기는 같은 범위 문자열과 같은 1 기반 위치를 쓴다. 분할 문서가 그 과정을 짚어 준다
ImportPages와 MergeFiles, 그리고 여기서 말한 폼 인지 병합은 PDFium Component와 함께 제공되며, 이 컴포넌트가 Delphi와 C++Builder 애플리케이션에 이런 페이지 작업을 가져다 준다