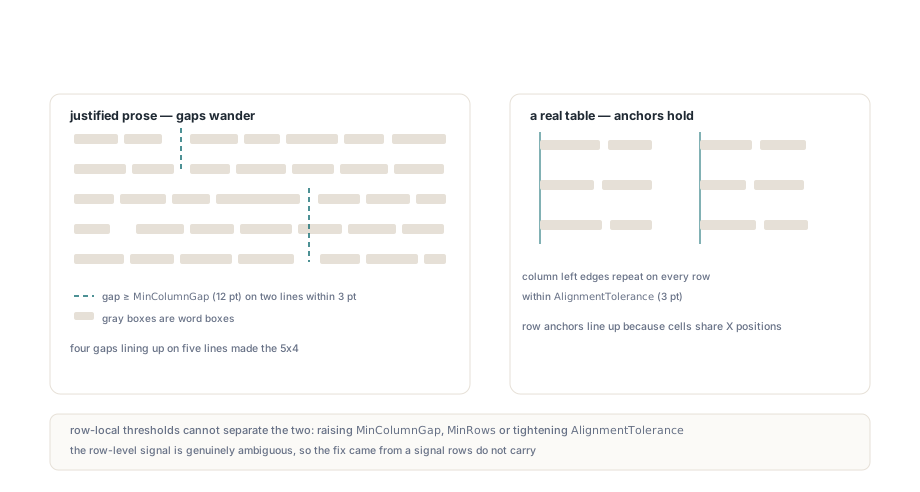
양끝 정렬된 본문 텍스트 한 페이지가 공백 표 탐지기를 거치면 여러 열의 격자로 돌아올 수 있습니다. 모든 셀에 반쪽짜리 문장이 담겨 있고 신뢰도 점수는 감히 설정할 법한 어떤 임계값보다도 높습니다. 그 페이지에는 표가 없습니다. 탐지기가 열 구분자로 통과할 만큼 넓은 단어 간격과, 그 간격이 거의 같은 X 위치에 놓인 연속된 몇 줄을 발견했고, 정렬만 놓고 보면 그것이 정확히 표의 모습입니다. 답은 열 경계를 한 번에 한 행씩 판정하는 것을 멈추고, 열들 사이로 백지 띠가 페이지를 따라 내려가는지 물어보는 것입니다
양끝 정렬 텍스트는 왜 공백 표 검사를 통과할까요?
양끝 정렬 텍스트가 통과하는 이유는 정렬된 줄이 레이아웃 엔진이 늘려 놓은 간격으로 갈라진 단어들의 행이고, 늘어난 간격이 일단 열 임계값을 넘으면 그 한 줄 안에서는 배수구와 구별할 것이 없기 때문입니다. PDFium Component의 공백 전략은 대부분의 공백 탐지기처럼 동작합니다. TPdf.ExtractTables는 단어 상자들을 시각적 행으로 묶고, 한 단어에서 다음 단어까지의 수평 거리가 MinColumnGap(TPdfTableExtractionOptions.Default에서 12포인트) 이상인 곳마다 행을 자르고, 생겨난 단어 그룹들의 왼쪽 모서리를 AlignmentTolerance(기본값 3포인트) 안에서 열 앵커로 묶습니다. 앵커는 최소 MinRows개 행에서 재등장할 때만 살아남고, 후보의 모든 행은 서로 다른 앵커를 최소 MinColumns개는 쳐야 합니다. 진짜 정렬된 표에 대해 이 규칙은 옳으며, 표 탐지 개요에서 설명한 그 규칙입니다
산문 쪽의 산수는 보기보다 무자비합니다. 180포인트 뉴스레터 열의 10포인트 줄이 다음 단어가 들어가지 않아 오른쪽 여백에 30포인트 모자라게 끝나고, 단어들이 길어서 줄이 단어 사이 공백 세 개만 담고 있다고 해 봅시다. 정렬 엔진은 그 30포인트를 세 공백에 펼쳐서 각각이 대략 2.5포인트에서 12.5포인트로 자라 기본 MinColumnGap을 넘습니다. 두 번째 줄은 첫 줄의 것에서 3포인트 안에서 시작하는 단어를 가진 늘어난 간격 하나만 있으면 되고, 탐지기는 두 행 두 열짜리 후보를 갖게 됩니다
늘어남이 어떻게 인코딩되었는지는 중요하지 않습니다. ISO 32000-1 §9.3.3은 단어 간격(Tw)을 단일 바이트 문자 코드 32에만 적용하므로, 멀티바이트 폰트를 쓰는 제작자들은 보통 TJ 배열(§9.4.3)의 숫자 조정으로 단어를 배치합니다. 어느 쪽이든 단어 상자는 동일하게 나옵니다. 각 문단의 마지막 줄은 러기드로 조판되어 평범한 공백을 지니므로, 오탐이 문단의 몸통을 커버하고 끝에서 한 줄 모자라게 멈추는 경향의 이유입니다
자기 코퍼스를 빠르게 검사하는 방법은 편지나 보도자료처럼 산문뿐임을 아는 문서들에 탐지기를 돌려 보고서가 보고하는 모든 공백 모드 표를 인쇄하는 것입니다. 그런 문서에서 기대되는 출력은 아무것도 없음입니다
uses
  SysUtils, PDFium;

// 적재된 문서의 모든 공백 정렬 표를 나열해서
// 산문뿐인 줄 아는 페이지를 빠르게 검사할 수 있게 합니다
procedure ReportWhitespaceTables(Pdf: TPdf; MinRows: Integer = 2);
var
  Options: TPdfTableExtractionOptions;
  Tables: TPdfTables;
  I: Integer;
begin
  Options := TPdfTableExtractionOptions.Default;  // MinColumnGap 12, AlignmentTolerance 3
  Options.MinRows := MinRows;
  Tables := Pdf.ExtractDocumentTables(Options);   // 활성 페이지를 복원합니다
  for I := 0 to High(Tables) do
    if Tables[I].DetectionMode = ptdmWhitespace then
      Writeln(Format('page %d: %dx%d whitespace table, confidence %.2f, ' +
        'first cell "%s"',
        [Tables[I].PageNumber, Tables[I].RowCount, Tables[I].ColumnCount,
         Tables[I].Confidence, Tables[I].Cells[0].Text]));
end;
각 임계값의 대가
행 수준 임계값은 모두 한 부류의 문서를 다른 부류와 바꾸는 거래이고, 이 문제에 대해서는 그것들을 손대지 않을 이유입니다. MinColumnGap을 20포인트로 올리면 촘촘한 재무제표의 좁은 열들이 떨어져 나갑니다. 레이블 열과 값 열 사이의 배수구는 기본값보다 조금 넓은 정도인 경우가 흔합니다. MinRows를 3으로 올리면 진짜 두 행 표가 버려지고 긴 문단에 대한 확률만 낮아집니다. 산문 한 페이지는 세 줄이 나란히 서는 기회를 여럿 제공하기 때문입니다. AlignmentTolerance를 3포인트 아래로 조이면 왼쪽 모서리가 조금씩 흐드는 진짜 열들이 갈라지기 시작합니다. OCR 텍스트 레이어가 얹힌 스캔 페이지가 그렇습니다
MinConfidence는 자연스러운 필터처럼 보이지만 넷 중 가장 무력합니다. PDFium Component의 공백 표는 0.58에 비어 있지 않은 셀의 비율 × 0.30을 더해 0.88에서 한도가 걸리므로, 점수는 격자가 얼마나 찼는지를 잽니다. 문단 조각은 모든 셀을 채우므로 산문 오탐이 범위의 꼭대기 근처에서 점수를 받는 반면, 빈 셀을 가진 진짜 표는 더 낮게 나옵니다
양끝 정렬 산문 두 줄과 두 열 표의 두 행은 같은 앵커에서 동일한 단어 그룹을 만들어 낼 수 있습니다. 둘을 가르는 증거는 행들 사이에 있습니다
진짜 열 경계는 세로 통로입니다
진짜 열 경계는 자신이 가르는 모든 행에서 텍스트가 없는 채로 유지되는 페이지의 세로 띠입니다. 표는 구조상 열 쌍마다 하나를 갖습니다. 셀들이 공유된 X 위치에 맞춰 놓였기 때문입니다. 양끝 정렬 문단은 줄마다 다른 수평 위치에서 공백을 늘이므로, 한두 줄 이상 살아남는 띠가 없습니다. PDFium Component는 후보의 단어 그룹들이 앵커 열에 배정된 뒤 정확히 이것을 검사합니다. 인접한 열 쌍마다, 양쪽 셀에 콘텐츠가 있는 행마다 왼쪽 셀 단어들의 가장 오른쪽 모서리부터 오른쪽 셀 단어들의 가장 왼쪽 모서리까지 구간이 나오고, 그 구간들이 행에 걸쳐 교집합됩니다. 교집합이 MinColumnGap의 절반보다 좁으면 후보 전체가 거부됩니다 — 기본값에서 절반은 6포인트입니다
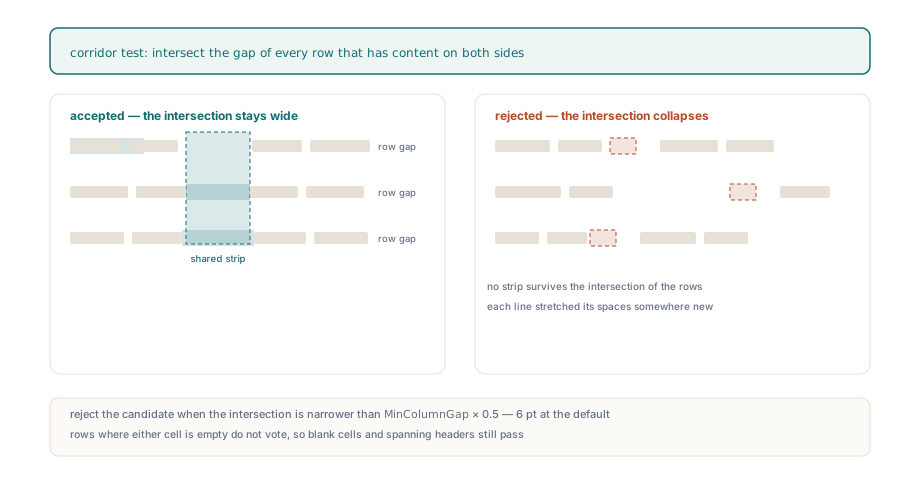
까다로운 실제 표에서 중요한 디테일이 둘 있습니다. 어느 한쪽 셀이 비어 있는 행은 표에 없는 행입니다. 그래서 빈 셀을 가진 표나 본문보다 적은 열을 차지하는 헤더 행도 통과합니다. 그리고 통로 폭은 별도 옵션이 아니라 MinColumnGap에서 유도됩니다. 두 값이 같은 물리적 대상, 즉 디자이너가 열 사이에 남겨 두는 공간을 묘사하기 때문입니다. 절반으로 낮추면 왼쪽 열의 긴 항목이 다음 열에 바짝 붙는 행을 위한 여유가 남습니다
이 검사는 여러분 자체 레이아웃 코드에서 재현할 만큼 작습니다. 아래의 셀 목록은 여러분 자체 구조이고, 행 우선 순서로 셀마다 단어 인덱스 배열 하나입니다
uses
  Math, PDFium;

type
  TIndexList = array of Integer;
  TCellIndexes = array of TIndexList;   // 여러분 자체 구조. Row * ColumnCount + Column

// 인접한 열 쌍이 그것을 쓰는 행에 걸쳐 최소 MinColumnGap / 2 너비의
// 텍스트 없는 세로 통로를 갖지 못하면 False를 반환합니다
function HasTextFreeCorridors(const Words: TPdfWordBoxes;
  const Cells: TCellIndexes; RowCount, ColumnCount: Integer;
  MinColumnGap: Double): Boolean;
var
  Col, Row, I, LeftCell, RightCell, Supported: Integer;
  CorridorLeft, CorridorRight, RowLeft, RowRight: Double;
begin
  for Col := 0 to ColumnCount - 2 do
  begin
    CorridorLeft := -MaxDouble;
    CorridorRight := MaxDouble;
    Supported := 0;
    for Row := 0 to RowCount - 1 do
    begin
      LeftCell := Row * ColumnCount + Col;
      RightCell := LeftCell + 1;
      if (Length(Cells[LeftCell]) = 0) or (Length(Cells[RightCell]) = 0) then
        Continue;                             // 빈 셀은 투표하지 않습니다
      RowLeft := -MaxDouble;
      RowRight := MaxDouble;
      for I in Cells[LeftCell] do
        RowLeft := Max(RowLeft, Words[I].Rect.Right);
      for I in Cells[RightCell] do
        RowRight := Min(RowRight, Words[I].Rect.Left);
      CorridorLeft := Max(CorridorLeft, RowLeft);
      CorridorRight := Min(CorridorRight, RowRight);
      Inc(Supported);
    end;
    if (Supported > 0) and
       (CorridorRight - CorridorLeft < MinColumnGap * 0.5) then
      Exit(False);
  end;
  Result := True;
end;
선이 있는 표를 공백 패스에서 가려 두기
공백 패스가 페이지의 모든 단어를 본다면 선이 있는 표는 두 번 발견됩니다. 깨끗한 선 표는 구조상 완벽하게 정렬된 공백 표이기도 하기 때문입니다. 그 자체로는 절반을 넘는 겹침 규칙이, 선 표의 아래 행들과 그 밑의 정렬된 텍스트 몇 줄을 결합한 후보가 비율 아래에 머물러 이웃으로 스며드는 더 큰 두 번째 표로 나오는 것을 막아 주지 못합니다
DetectRuledTables와 DetectWhitespaceTables가 모두 켜져 있을 때(기본값입니다) ExtractTables는 공백 패스가 시작하기 전에 선 패스를 먼저 돌리고, 선 표 경계 안에 중심점이 들어가는 모든 단어를 떼어 냅니다. 전체 포함 대신 중심을 쓰는 이유는 경계를 소수점 이하로 가로지르는 단어가 시각적으로 속한 표를 따라가게 하기 위해서입니다. 공백 전략은 그다음 자유로운 단어들만 보고, 선 격자 바로 아래에 앉은 작은 무선 표는 자기 행들로 판정됩니다
"Purpose of Request:"가 왜 "of Purpose Request:"로 나올까요?
셀 안의 단어들이 잘못된 순서로 나오는 경우는 "같은 줄"을 판정하는 코드가 수직 중심을 비교할 때입니다. 글리프 상자에서 만든 단어 상자는 베이스라인을 공유해도 중심을 공유하지 않기 때문입니다. FPDFText_GetCharBox는 각 글리프 잉크의 타이트한 상자를 페이지 공간에서 돌려주지, 폰트의 어센트와 디센트만큼 여유를 둔 상자가 아닙니다. 그리고 단어 상자는 그 문자들의 상자 합집합입니다. "Purpose of Request:" 같은 폼 레이블에서 "Purpose"와 "Request:"는 디센더를 지니고 "of"는 그렇지 않으므로, "of"의 상자는 더 짧고 중심이 몇 포인트 높습니다. 1포인트 같은 줄 허용오차로 중심 Y를 정렬한 뒤 왼쪽 모서리로 정렬하는 루틴은 "of"를 다른 둘 위의 별도 줄로 올려 먼저 출력합니다
PDF는 지름길을 주지 않습니다. ISO 32000-1 §9.4.4는 글리프를 베이스라인을 따른 변위로 놓고, 파일 안의 수직 메트릭은 폰트별로 존재합니다. 폰트 디스크립터(§9.8.1)의 Ascent, Descent, FontBBox입니다. 두 글리프가 한 줄을 공유한다고 말하는 것은 아무것도 없습니다. PDFium char 상자로 텍스트 줄 선택하기에서 다룬, 선택 강조를 자연스럽게 만들어 주는 그 타이트한 상자들이 중심 거리 비교에는 나쁜 입력입니다
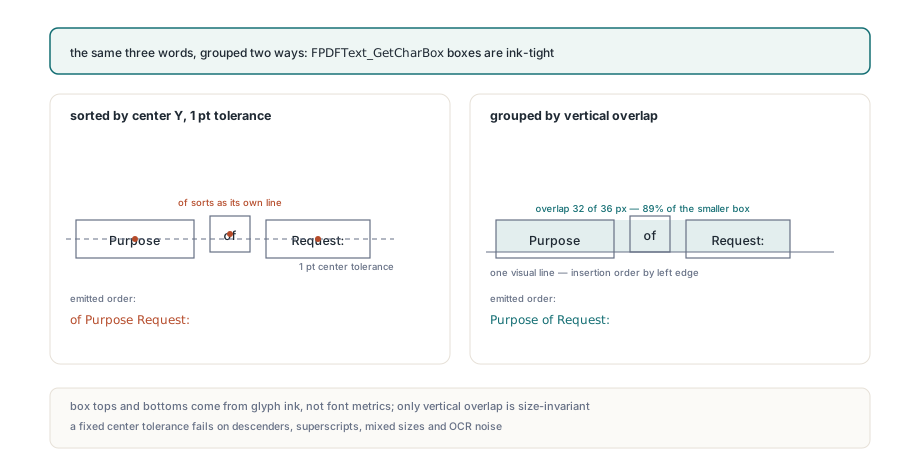
PDFium Component는 셀 텍스트를 대신 겹침으로 만듭니다. 단어는 그 수직 겹침이 두 높이 중 작은 것의 최소 25퍼센트이거나 두 중심이 서로 1포인트 안에 있을 때 시각적 줄에 합류하고, 각 줄은 왼쪽 모서리순으로 정렬된 뒤 CR LF 쌍으로 연결됩니다. "Purpose"와 "of"는 x-높이 전체에 걸쳐, 짧은 상자의 4분의 1을 훨씬 넘게 겹치므로 한 줄에 놓이고 순서대로 읽힙니다
자체 코드에서 텍스트 줄을 겹침으로 묶기
같은 함정이 고정 허용오차로 중심을 비교해 "같은 줄"을 판정하는 모든 PDF 레이아웃 코드에서 기다립니다. 디센더가 가장 온화한 유발자입니다. 더 작은 값 옆의 굵은 레이블, 위첨자 각주 표식, 시끄러운 OCR 상자 모두 12포인트 리딩의 10포인트 텍스트 인접 줄들을 여전히 가르는 어떤 허용오차보다 크게 중심을 움직입니다. 겹침 비율은 크기를 신경 쓰지 않습니다. 한 베이스라인의 두 상자는 공유된 x-높이만큼 겹치고 인접 줄의 두 상자는 전혀 겹치지 않습니다
TPdf.PageWordBoxes는 활성 페이지의 모든 단어를 페이지 공간 사각형을 Rect에 담아 돌려주므로, 페이지를 시각적 줄로 묶는 일은 술어 하나와 짧은 루프면 됩니다
uses
  Math, PDFium;

function SameVisualLine(const A, B: TPdfRectangle): Boolean;
var
  Overlap, MinHeight: Double;
begin
  Overlap := Min(A.Top, B.Top) - Max(A.Bottom, B.Bottom);
  MinHeight := Min(A.Top - A.Bottom, B.Top - B.Bottom);
  Result := (MinHeight > 0) and (Overlap >= MinHeight * 0.25);
end;

procedure GroupPageIntoLines(Pdf: TPdf; out Lines: TArray<TPdfWordBoxes>);
var
  Words: TPdfWordBoxes;
  Bounds: TArray<TPdfRectangle>;   // 줄별 누적 합집합
  I, J, Found: Integer;
begin
  Words := Pdf.PageWordBoxes;            // 활성 페이지가 필요합니다(Pdf.PageNumber)
  Lines := nil;
  Bounds := nil;
  for I := 0 to High(Words) do
  begin
    Found := -1;
    for J := High(Lines) downto 0 do
      if SameVisualLine(Bounds[J], Words[I].Rect) then
      begin
        Found := J;
        Break;
      end;
    if Found < 0 then
    begin
      SetLength(Lines, Length(Lines) + 1);
      SetLength(Bounds, Length(Bounds) + 1);
      Found := High(Lines);
      Bounds[Found] := Words[I].Rect;
    end;
    SetLength(Lines[Found], Length(Lines[Found]) + 1);
    Lines[Found][High(Lines[Found])] := Words[I];
    Bounds[Found].Left := Min(Bounds[Found].Left, Words[I].Rect.Left);
    Bounds[Found].Right := Max(Bounds[Found].Right, Words[I].Rect.Right);
    Bounds[Found].Top := Max(Bounds[Found].Top, Words[I].Rect.Top);
    Bounds[Found].Bottom := Min(Bounds[Found].Bottom, Words[I].Rect.Bottom);
  end;
  // 읽기 전에 각 줄을 Rect.Left순으로 정렬하세요. PageWordBoxes는
  // 콘텐츠 스트림 순서의 단어를 돌려주며, 시각 순서와 다를 수 있습니다
end;
복사할 가치가 있는 부분은 술어입니다. 빠른 덤프를 넘어서는 일이라면 블록과 줄, 읽기 순서 소스를 이미 갖춘 구조화 텍스트 모델에서 시작하세요. 읽기 순서가 있는 구조화 PDF 텍스트 추출에 설명되어 있습니다
표 호출자가 여전히 직접 다루는 것
표 호출자는 옵션을 건드리지 않고도 통로 검사와 선 우선 단어 필터, 겹침 기반 셀 텍스트를 받습니다. 통로 임계값은 MinColumnGap의 절반으로 고정되어 있으므로, 배수구 폭을 위해 조정하는 그 한 값이 양쪽을 다스립니다. 공백 전략은 MinRows가 1로 설정되어도 두 행의 하한을 유지합니다. 한 행 격자를 받는 것은 선 전략뿐이며, ExtractDocumentTables가 페이지 맨 위에서 이어지는 표 조각에 그것을 씁니다. 같은 옵션 레코드가 TPdfReflowOptions.TableOptions로도 넘어가므로, DetectTables가 켜져 있으면 리플로우 출력이 같은 결정을 물려받습니다
통로 검사는 경계 양쪽에 콘텐츠가 있는 행들로 판정하므로, 두 행 후보는 그런 행 둘로 판정됩니다. 대부분 산문이고 진짜 두 행 표가 드문 아카이브 — 계약서, 서신, 에세이 — 라면 MinRows를 3으로 놓고 잃는 두 행 표를 감수하세요. 재무·폼 중심 문서는 기본값 2를 유지하세요. 짧은 진짜 표가 흔한 곳입니다. 러기드 라이트 텍스트는 평범한 공백 하나를 유지하고 12포인트에 근접한 간격을 거의 만들지 않습니다
PDF에는 범용 표 객체가 없습니다. ISO 32000-1 §14.8.4.3.4가 Table 구조 요소를 정의하지만 Tagged PDF만 그것을 실으므로, 그 외의 모든 것에서 격자는 기하학에서의 추론이고 공백 표의 Confidence는 0.88을 넘지 않습니다
탐지 옵션과 TPdfTable.ToCsv, ToJson 직렬화, Delphi·C++Builder·Lazarus용 TableExtractionLab 데모는 PDFium Component for Delphi 제품 페이지에 정리되어 있습니다