워드 프로세서에서 'tagged PDF' 상자를 놔두고 내보낸 계약서는 화면에서 여전히 구조적으로 보입니다. 24포인트 굵은 제목, 번호 매긴 조항, 선 그은 요금표죠. 리플로우 가능한 HTML로 바꾸면 요금표는 제대로 된 <table>로 돌아오지만 제목은 각주와 정확히 같은 신분의 <p>입니다. 그 출력은 옳습니다. ISO 32000-1 §14.8은 PDF에 '이 텍스트 나열은 제목이다'라고 말할 자리를 정확히 하나, 구조 트리만 주는데 태그 없는 파일에는 그것이 없습니다. 글자 크기와 굵기는 조판 선택이고, 크고 굵은 줄을 전부 <h1>으로 승격시키는 변환기는 인용구와 표 합계, 편지지의 회사명도 승격시킵니다
그렇다면 PDF-to-HTML 파이프라인에 던질 만한 질문은 출력의 각 제목과 목록 항목, 표가 어디서 왔고, 휴대폰 레이아웃이나 스크린 리더, 검색 인덱서가 각각을 얼마나 신뢰할 수 있느냐입니다. 제목과 표는 다른 답을 줍니다. 내보내기 단계는 줄 바꿈과 문자 인코딩, 메모리에 관해 자체 선택을 더합니다
제목과 목록은 어디서 오나
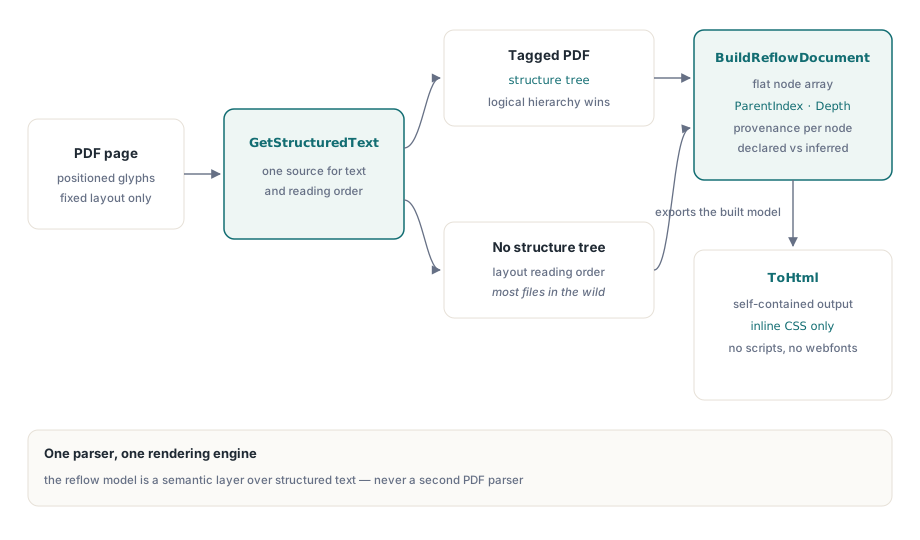
PDFium Component는 TPdf.BuildReflowDocument로 리플로우 모델을 만들고, 그 메서드는 구조 텍스트 블록과 읽기 순서에서 서술한 바로 그 구조 텍스트 계층인 GetStructuredText에서 모든 단어와 블록, 시맨틱 힌트를 가져옵니다. 그 뒤에 두 번째 파서도 두 번째 텍스트 추출기도 없습니다. 요청된 범위의 각 페이지에 대해 물리 배치 순서로 블록을 수집합니다. GetStructuredText는 이미 각 블록을 겹치는 면적으로 페이지의 태그 콘텐츠와 맞춰 봤고, BuildReflowDocument는 찾은 역할을 블록에 복사합니다. H부터 H6는 수준을 갖춘 제목이 되고, LI, Lbl, LBody는 목록 항목이 되며, Figure는 대체 설명을 텍스트로 갖는 그림이 되고, Caption은 캡션이 됩니다
결과가 둘 따르고 둘 다 관찰하기 쉽습니다. 블록 순서는 태그 파일에서도 언제나 페이지 배치를 따르므로, 태그는 블록이 무엇인지 정하고 지오메트리는 어디로 가는지 정합니다. 그리고 태그 없는 페이지의 모든 블록은 문단입니다. 제목과 목록은 글자 크기로부터 추측되지 않습니다
모든 노드는 TPdfReadingOrderSource형 Source 필드를 실어 나릅니다. 역할이 구조 트리에서 왔으면 rosStructure, 배치만으로 왔으면 rosHeuristic입니다. 내보낸 HTML은 이를 모든 요소의 data-source="structure"나 data-source="inferred"로 반복하고, 문서 수준 TPdfReflowDocument.Source는 범위의 모든 페이지가 태그됐을 때만 rosStructure입니다. 표는 언제나 rosHeuristic인데, Table 태그가 아니라 기하 탐지에서 오기 때문입니다. 하류 단계가 제목을 탐색 랜드마크로 다룬다면 그 필드를 먼저 확인하세요. 태그된 문서는 저자가 고른 랜드마크를 줍니다
객체 트리 대신 평평한 노드 배열
TPdfReflowDocument.Nodes는 전위 순회로 평탄화된 트리입니다. TPdfReflowNode 레코드의 동적 배열 하나이고 각각이 ParentIndex와 Depth를 쥡니다. 페이지 노드는 깊이 0에 부모 인덱스 -1로 앉습니다. 문단과 제목, 그림, 캡션, 목록, 표는 깊이 1에서 페이지에 매달리고, 목록 항목은 목록 아래 깊이 2에, 표 셀은 행 아래 깊이 3에 닿습니다. 연달아 오는 목록 항목들은 하나의 목록 노드를 공유하고, 그사이의 다른 블록이나 표는 새 목록을 시작합니다
평평한 배치는 이식성 결정입니다. 자기 자신의 동적 배열을 담은 재귀 레코드는 Delphi, C++Builder, Free Pascal에서 컴파일되지만 셋은 패키지나 DLL 경계를 넘는 재귀 관리 타입을 다르게 다룹니다. 평범한 레코드의 평평한 배열은 셋에서 똑같이 동작하고 재귀 없이 for 루프 하나로 스트리밍됩니다
uses
  SysUtils, PDFium;

var
  Pdf: TPdf;
  Options: TPdfReflowOptions;
  Doc: TPdfReflowDocument;
  Node: TPdfReflowNode;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'contract.pdf';
    Pdf.LoadDocument;

    Options := TPdfReflowOptions.Default;   // 모든 페이지, 표 켬, CSS 켬
    Doc := Pdf.BuildReflowDocument(Options);

    for I := 0 to High(Doc.Nodes) do
    begin
      Node := Doc.Nodes[I];
      case Node.Kind of
        prnkHeading:
          Writeln(Format('%sH%d [%s] %s', [StringOfChar(' ', Node.Depth * 2),
            Node.HeadingLevel,
            BoolToStr(Node.Source = rosStructure, True), Node.Text]));
        prnkTable:
          // 표 노드에서 RowSpan/ColumnSpan은 표의 행과 열 개수를 담습니다
          Writeln(Format('%stable %dx%d, page %d, confidence %.2f',
            [StringOfChar(' ', Node.Depth * 2), Node.RowSpan, Node.ColumnSpan,
             Node.PageNumber, Node.Confidence]));
      end;
    end;

    Writeln(Format('%d node(s), %d table(s), %d character(s), pages %d-%d',
      [Length(Doc.Nodes), Doc.TableCount, Doc.CharacterCount,
       Doc.FirstPage, Doc.LastPage]));
  finally
    Pdf.Free;
  end;
end;
서두의 태그 없는 계약서에서 그 루프는 H 줄을 하나도 찍지 않고 감지된 요금표마다 표 줄 하나를 찍습니다. 같은 문서의 태그된 사본에서 돌리면 제목들이 옆에 True를 붙인 채 나타납니다. 옵션의 FirstPage와 LastPage는 기본 0인데 문서의 첫 페이지와 마지막 페이지를 뜻하고, 페이지 수를 벗어나는 범위는 어떤 페이지도 읽기 전에 EPdfError를 발생시킵니다
표 텍스트는 왜 두 번 나타나지 않을까?
표 탐지는 구조 텍스트가 수집된 뒤 각 페이지에서 돌므로 표 안의 단어는 두 번 존재합니다. 텍스트 블록으로 한 번, 셀로 한 번이죠. 둘 다 내보내면 HTML의 모든 표 뒤에 자기 내용이 느슨한 문단들로 다시 따라옵니다. '텍스트에 표를 더한다'는 순진한 병합이 내는 정확히 그 결과입니다
모델은 이를 기하학적으로 풉니다. 경계 상자의 절반 이상이 감지된 표의 범위 안에 놓인 텍스트 블록은 버려지고 표 노드가 그 자리를 대신합니다. 표는 그다음 남은 블록들과 세로 위치로 섞입니다(페이지에서 더 높은 것 먼저, 위 가장자리가 반 포인트 안이면 왼쪽부터 오른쪽이 동률 처리). 그래서 표는 페이지 끝에 덧붙여지는 대신 위 문단과 아래 문단 사이에 착지합니다
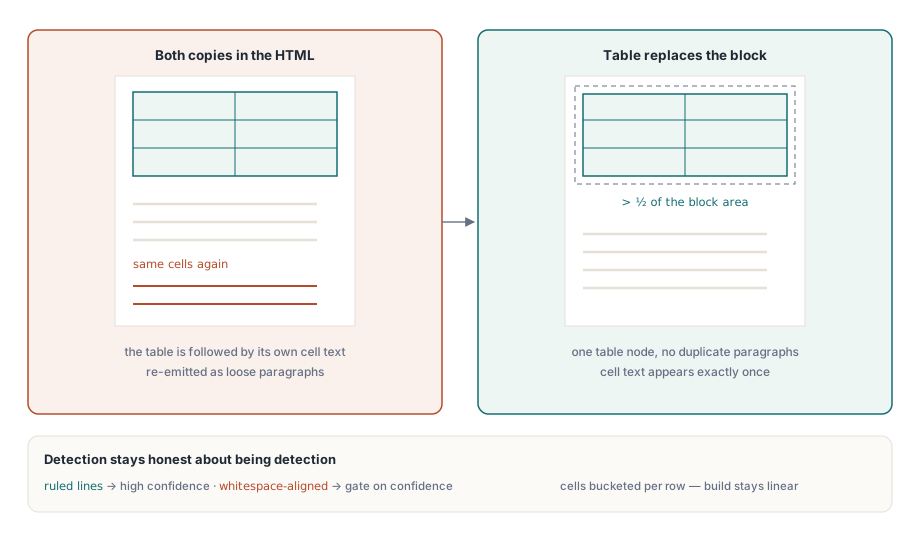
절반 면적 임계값에는 눈에 보이는 가장자리가 있습니다. 표 경계를 걸치고 대부분 밖에 앉은 블록은 온전히 살아 남으므로, 한 줄의 텍스트가 가끔 마지막 행과 뒤따르는 문단 양쪽에 나타날 수 있습니다. 그게 맞는 쪽으로 실수하는 것입니다. 겹치는 모든 블록을 지울 만큼 낮은 임계값은 표의 경계 상자에 스치기만 하는 본문 텍스트도 지워 버립니다. 겹친 줄 한 개는 없어진 문장보다 알아차리고 용서하기 훨씬 쉽습니다
감지된 표는 신뢰도도 달고 두 탐지 전략은 서로 다른 대역에 착지합니다. 선을 그어 찾은 표는 텍스트를 담은 셀의 비율에 따라 0.88에서 1.0 사이입니다. 공백 정렬만으로 추론한 표는 0.58에서 0.88 사이입니다. 표 노드의 Confidence가 그 점수를 쥐고 각 셀 노드가 반복하며, HTML은 <table> 요소에 data-confidence로 기록합니다. TableOptions.MinConfidence(기본 0.5) 아래의 표는 만들어지지 않고, 표가 거부되면 그 단어들은 그냥 평범한 문단으로 모델에 남습니다
검색 인덱서나 모바일 읽기 뷰라면 틀린 표는 값이 싸고 올바르게 감지된 표는 큰 개선이므로 기본값을 두세요. 두 열짜리 주소 블록 주위에 지어낸 격자가 격자 없음보다 나쁜 아카이브 변환은 탐지를 선 그은 표로 제한하세요:
Options := TPdfReflowOptions.Default;
Options.DetectTables := True;
Options.TableOptions.DetectWhitespaceTables := False; // 선 그은 표만
Options.TableOptions.MinConfidence := 0.9;            // 성긴 선 그리드도 떨어뜨림
Options.TableOptions.MaxTables := 200;                // 문서 전체 천장
Options.TableOptions.MaxCells := 50000;               // 문서 전체 천장

Doc := Pdf.BuildReflowDocument(Options);
if Doc.TableCount = 0 then
  Writeln('No ruled tables; all page text is emitted as paragraphs');
리플로우 빌드 안에서 MaxTables와 MaxCells는 페이지별이 아니라 페이지 범위 전체에서 셉니다. 매 페이지에 선 그은 표가 있는 300페이지 명세서는 MaxTables 300 이상이 필요하고, 아니면 빌드는 한도를 넘는 첫 표에서 EPdfError로 멈춥니다. 기본값은 표 1,000개와 셀 100,000개입니다
테두리로 그린 얇은 채운 직사각형과 페이지에 걸친 연속 같은 탐지 쪽 자체는 표 탐지와 추출을 보세요
아무것도 더 필요 없는 HTML 내보내기
TPdfReflowDocument.ToHtml은 이미 만들어진 모델을 걷고 PDFium을 다시 만지지 않으므로 같은 모델의 두 번 내보내기는 같은 문자열을 냅니다. FullDocument가 설정되면(기본) 결과는 완전한 페이지입니다. doctype, <meta charset="utf-8">, 뷰포트 메타 태그, 문서 Title 항목에서 가져온 <title>(비어 있으면 "PDF document"), 문서 언어의 lang 속성입니다. FullDocument를 끄면 자체 템플릿에 넣을 <div class="pdf-reflow"> 조각 하나를 얻습니다
IncludeCss의 선택적 스타일시트는 인라인 <style> 블록 하나입니다. 72rem 읽기 단, IncludePageSections가 켜지면 흰 카드로서의 각 PDF 페이지, 무너뜨린 표 테두리, 40rem 아래에서 카드 패딩을 지우고 표 텍스트를 줄이는 미디어 쿼리입니다. 스크립트도 웹 폰트도 외부 URL도 없으므로 파일이 이메일 안이나 CHM식 도움말 뷰어, 샌드박스 브라우저 컨트롤 안에 앉을 수 있습니다. 1부터 6 밖의 제목 수준은 h2로 기록되고 헤더 셀은 th가 되며, 1 위의 RowSpan이나 ColumnSpan을 가진 셀은 rowspan과 colspan을 얻습니다. IncludeGeometry를 켜면 PDF 포인트의 data-left, data-top, data-right, data-bottom이 더해지는데, 검색 히트를 렌더링된 페이지 위에 강조하는 데 요긴합니다
PreserveLineBreaks는 의도적인 선택이 필요합니다. PDF 문단 안의 줄 바꿈은 하나의 고정된 단 폭을 위해 만들어졌습니다. 그것을 360픽셀 화면에 유지하면 모든 줄이 두 번 감겨 리플로우가 없애려던 삐죽한 패턴이 돌아옵니다. 산문에는 끄세요(기본). 주소나 시, 코드 목록처럼 줄 바꿈이 의미를 실는 문서에는 켜면 <br>을 공백 대신 씁니다
긴 문서에서 페이지 전체를 WString 하나로 만든 뒤 인코딩하면 메모리 최고점이 두 배가 됩니다. WriteHtml은 같은 마크업을 대신 TPdfReportWriter로 스트리밍하며, 모든 비 ASCII 문자를 숫자 문자 참조로 써 ASCII로 기록하므로 받는 쪽이 인코딩을 어떻게 추측하든 바이트는 유효합니다:
uses
  Classes, SysUtils, PDFium, FPdfAsync, FPdfReport;

procedure ExportReflowHtml(Pdf: TPdf; const FileName: string;
  const Token: IPdfCancellationToken);
var
  Options: TPdfReflowOptions;
  Doc: TPdfReflowDocument;
  Limits: TPdfReportLimits;
  Stream: TFileStream;
  Writer: TPdfReportWriter;
begin
  Options := TPdfReflowOptions.Default;
  Options.MaxNodes := 500000;
  Options.MaxCharacters := 20000000;
  Doc := Pdf.BuildReflowDocument(Options, Token);   // 페이지 상태는 나중에 복원됩니다

  Limits := TPdfReportLimits.Default;
  Limits.MaxCharacters := 64 * 1024 * 1024;  // 출력 바이트 천장, 최대 64 MiB
  Limits.MaxItems := Options.MaxNodes;       // 노드당 항목 하나, 최대 1048576

  Stream := TFileStream.Create(FileName, fmCreate);
  try
    Writer := TPdfReportWriter.Create(Limits, Stream);  // 스트림은 호출자 소유로 유지됩니다
    try
      Doc.WriteHtml(Writer);
    finally
      Writer.Free;
    end;
  finally
    Stream.Free;
  end;
end;WriteHtml은 ToHtml보다 더 검사합니다. Options.MaxNodes보다 많은 노드의 모델을 거부하고, 쓰는 텍스트에 Options.MaxCharacters를 강제하며, 중첩을 MaxDepth 인수(기본 64)로 제한하고, 모든 ParentIndex가 더 이른 노드를 가리키는지 검증합니다. 마지막 검사는 여러분 코드가 내보내기 전에 Nodes를 걸러내거나 재작성할 때 중요합니다. 앞선 부모 인덱스를 가진 편집된 배열은 태그가 어긋난 마크업을 내는 대신 EPdfReportLimit를 발생시킵니다
예산, 취소, 현재 페이지
PDF는 신뢰할 수 없는 입력이고 망가졌거나 적대적인 파일은 잘게 쪼갠 텍스트의 수천 페이지를 선언할 수 있습니다. BuildReflowDocument는 노드가 추가되기 전에 문자, 노드, 표, 셀 예산을 검사하므로 넘는 파일은 EPdfError와 예산을 이름 대는 메시지(이를 테면 "Reflow node budget exceeded")로 멈추고 메모리 사용은 여전히 경계 안에 있습니다. MaxCharacters와 MaxNodes는 둘 다 양수여야 하고 기본값은 문자 10,000,000개와 노드 1,000,000개입니다
선택적 IPdfCancellationToken은 각 페이지 전과 블록 사이, 각 표 전과 각 표 행 전에 검사됩니다. 폼이 소유한 TPdfCancellationTokenSource의 Token을 넘기고 버튼 핸들러에서 Cancel을 부르면 빌드는 그 체크포인트들 중 다음에서 EPdfOperationCancelled를 발생시킵니다. 사용자의 취소가 망가진 파일로 기록되지 않게 EPdfError와 갈라 잡으세요. 빌드가 어떤 예외로 끝나든 부분 결과는 반환되지 않습니다. 실패가 WriteHtml 안쪽 나중에 일어나면 목적지 파일은 잘린 페이지를 쥐므로 자체 예외 핸들러에서 지우세요
페이지 상태는 GUI 코드가 의지하는 세부입니다. 빌드는 PageNumber를 움직여 범위의 모든 페이지를 방문하고 try/finally가 성공에서도, 예산 실패에서도, 취소에서도 똑같이 호출자의 페이지를 되돌려 놓습니다. 사용자가 340페이지를 읽는 동안 내보내기를 시작한 뷰어는 내보내기가 돌아왔을 때 여전히 340페이지입니다
리플로우가 맞는 자리
리플로우 출력은 검색 인덱싱과 접근 가능한 읽기 뷰, 휴대폰 표시, CMS로의 콘텐츠 이전 입력으로 잘 씁니다. 선택적 data-* 좌표를 빼면 절대 위치와 정확한 폰트, 벡터 아트, 페이지 지오메트리를 의도적으로 버립니다. 페이지가 동일하게 보여야 하는 작업은 렌더링하고, 단어가 다른 어딘가에서 읽혀야 하는 작업은 리플로우하세요
제목과 목록이 태그에서만 오므로 HTML의 품질은 상류 태깅의 품질을 좇습니다. PDF/UA 구조 트리 검증의 검사를 통과하는 문서는 진짜 제목 위계를 갖춘 모델을 내고, 같은 태그 콘텐츠가 접근 가능한 리더 빌드하기의 읽기 기능을 끕니다
리플로우와 구조 텍스트, 표 추출, 렌더링은 모두 Delphi, C++Builder, Lazarus에서 같은 TPdf 객체를 상대로 돕니다. 옵션 레코드와 예외, 보고서 라이터는 Delphi용 PDFium Component 제품 페이지에 문서화돼 있습니다